前言
8G显存最常见的玩法,通常是跑一个量化大模型,然后继续回到聊天框里打字。但如果把语音识别、TTS、音色克隆、数字人口型和大模型串起来,同一块显卡还能做出更接近“面对面交流”的本地AI数字人。
这次部署的是Voice Companion Bundle,运行环境是Windows + WSL2。整合包把Faster-Whisper、Qwen3-TTS、LiveTalking、Wav2Lip以及大模型接口放到了一套流程里,安装完成后可以直接用浏览器麦克风和数字人进行实时语音对话。
前半段先按默认方式接入DeepSeek在线API,验证语音输入、模型回复、TTS输出和人物口型都能正常工作;后半段再用LM Studio加载本地模型,把负责回答的LLM也切回本机。
这篇和单纯“本地跑一个模型”的体验也不太一样。真正占用资源、影响交互感的并不是某一个组件,而是语音识别、LLM生成、语音合成和数字人口型要连续衔接起来,任何一环太慢,最后的对话体验都会被拖住。
最后继续把这套数字人页面开放给手机和平板访问,并增加HTTP Auth,形成一套完整的远程使用入口。整篇真正跑的是8G显存 → 本地数字人 → 实时语音 → 本地LLM → 远程访问这条链,而不只是单纯测试一个大模型能不能跑起来。
1 项目介绍
Voice Companion Bundle 是一套面向 Windows + WSL2 的本地 AI 数字人语音交互整合包,把语音识别、大模型对话、音色克隆、TTS 语音合成和数字人口型同步放进了同一套使用流程。
部署完成后,可以直接通过浏览器麦克风与 AI 进行实时语音对话。系统会识别语音内容,交给大模型生成回复,再通过 TTS 合成对应声音,并同步驱动数字人口型。
从使用链路来看,项目主要包含以下几部分:
项目整体以本地部署为主,模型、人物、音色、API Key 和运行日志都保存在自己的电脑中。
2 下载部署启动整合包
打开项目的 GitHub Release页面,下载最新版本的 Voice Companion Bundle 整合包。
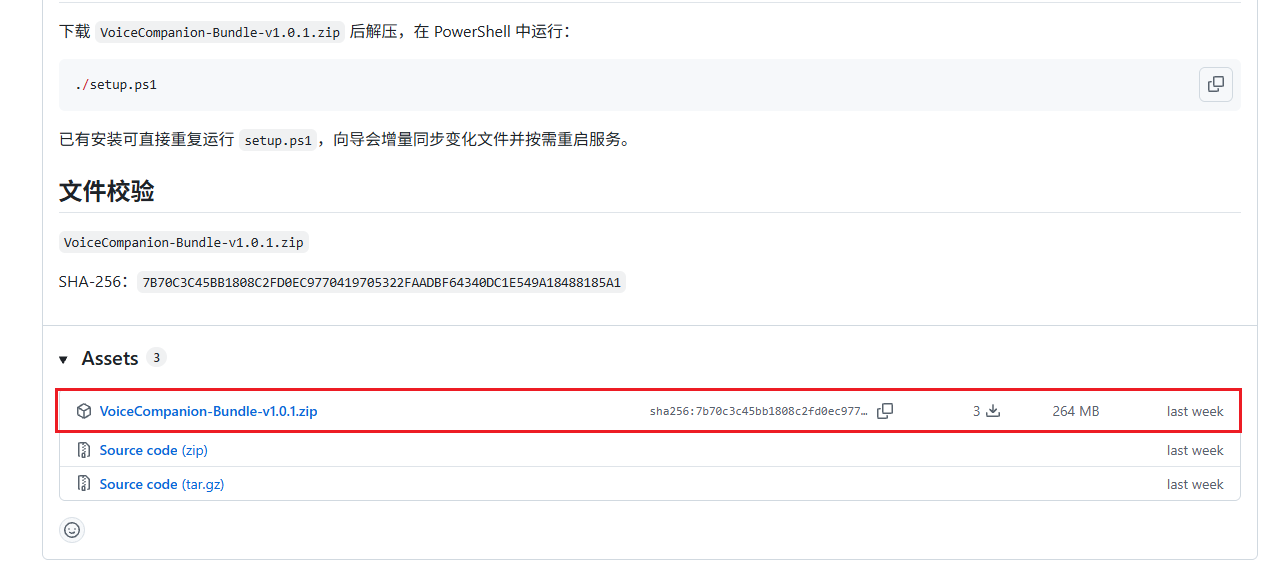
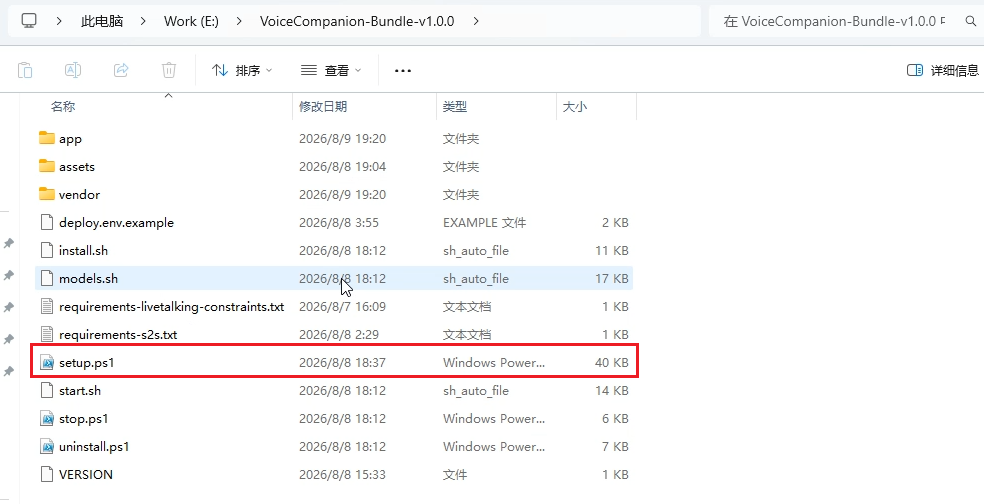
下载完成后,将压缩包解压到本地目录,解压后进入目录,可以看到一个名称为【setup.ps1】的脚本:
在当前文件夹空白处按住 Shift 键并点击鼠标右键,选择【在此处打开 PowerShell 窗口】: 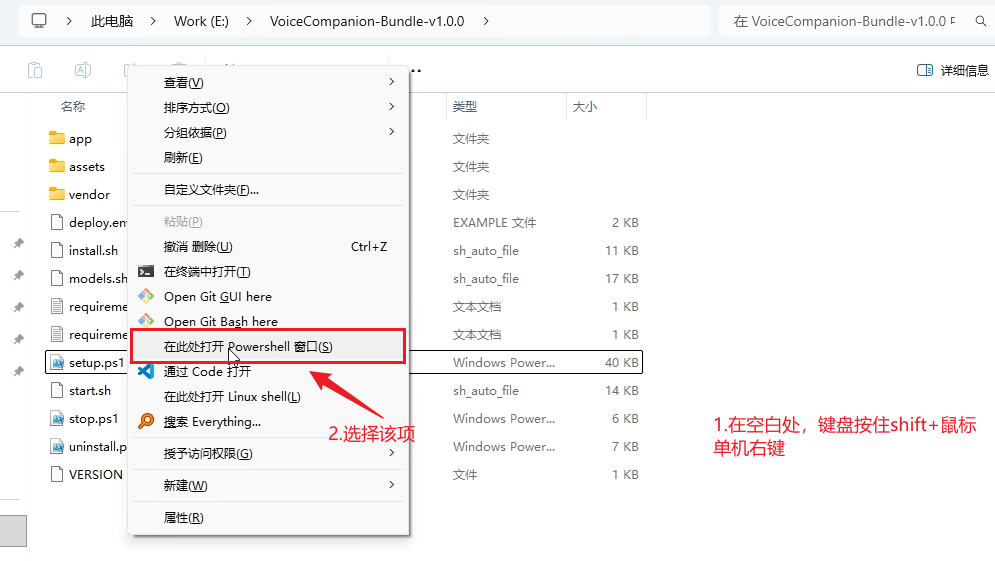
接着,在PowerShell窗口中,输入【./setup.ps1】命令回车,按照提示完成剩下步骤,如下图: 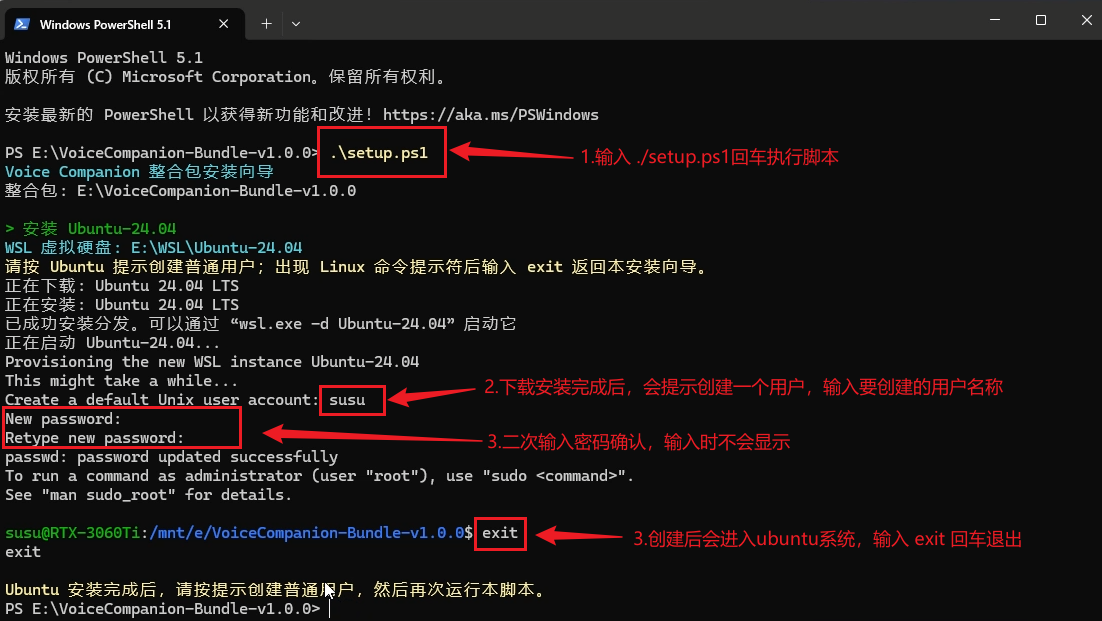
首次执行setup.ps1脚本会下载安装ubuntu系统和创建好用户,接着再次执行setup.ps1脚本: 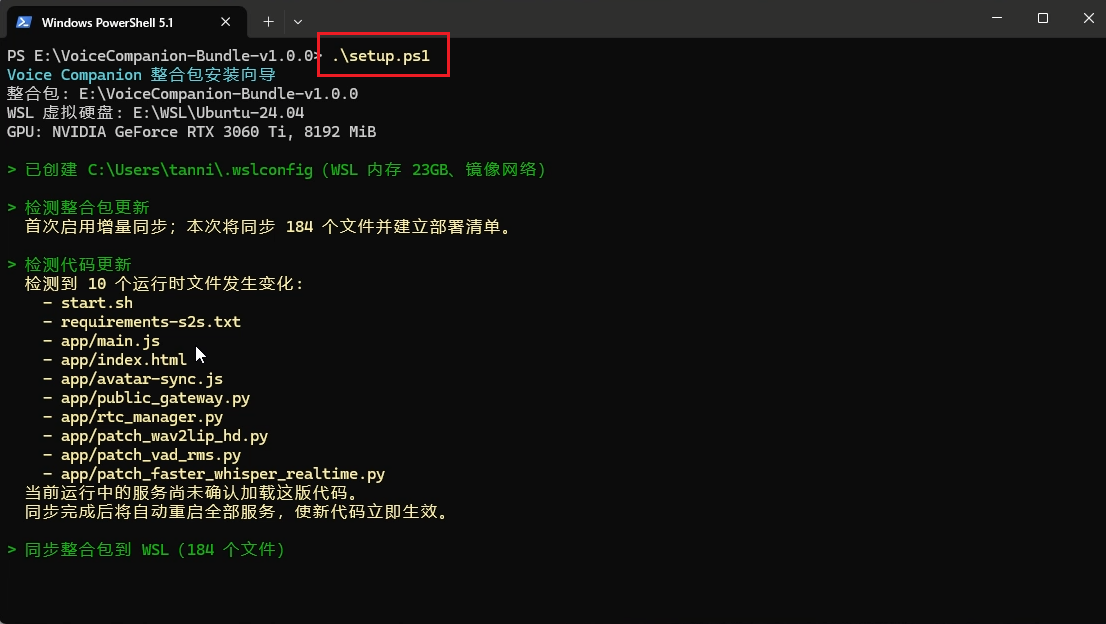
接着会根据显卡默认推荐对应档位,以及自动测试推荐更快的下载源,默认回车即可: 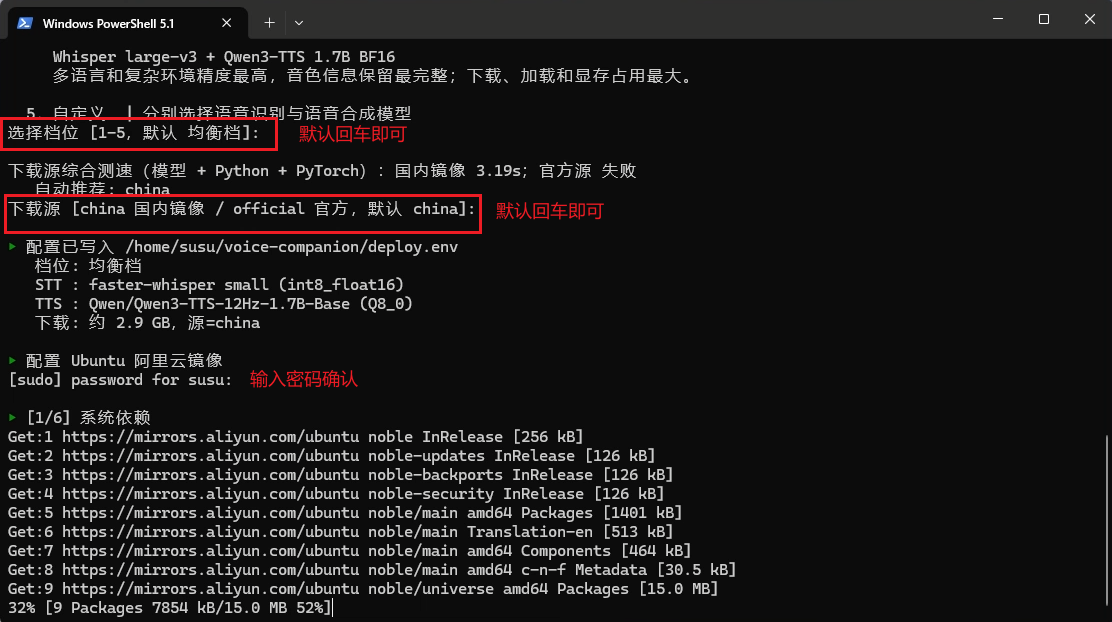
这个部分会下载系统依赖,还会下载 Python 包管理环境、开源项目所需资源、数字人相关资源以及Qwen TTS 语音合成资源等,下载完成后如下图: 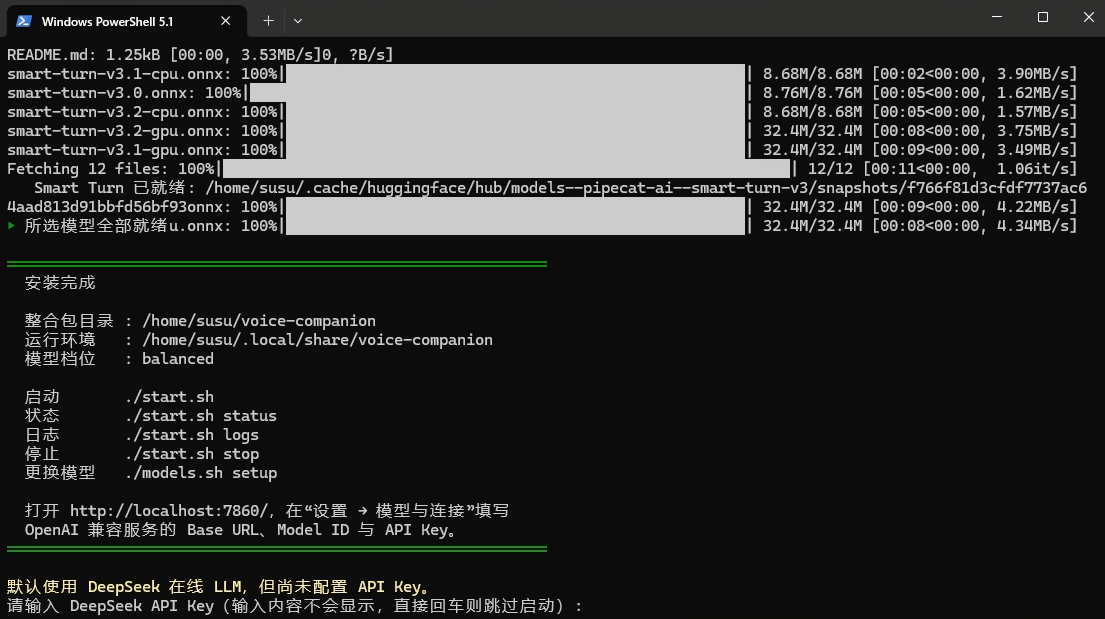
这里会要求填写一个DeepSeek API的key,默认使用在线的LLM来进行驱动,减少对显卡的资源占用,前往DeepSeek官方创建一个key即可:
https://platform.deepseek.com/api_keys
如下图: 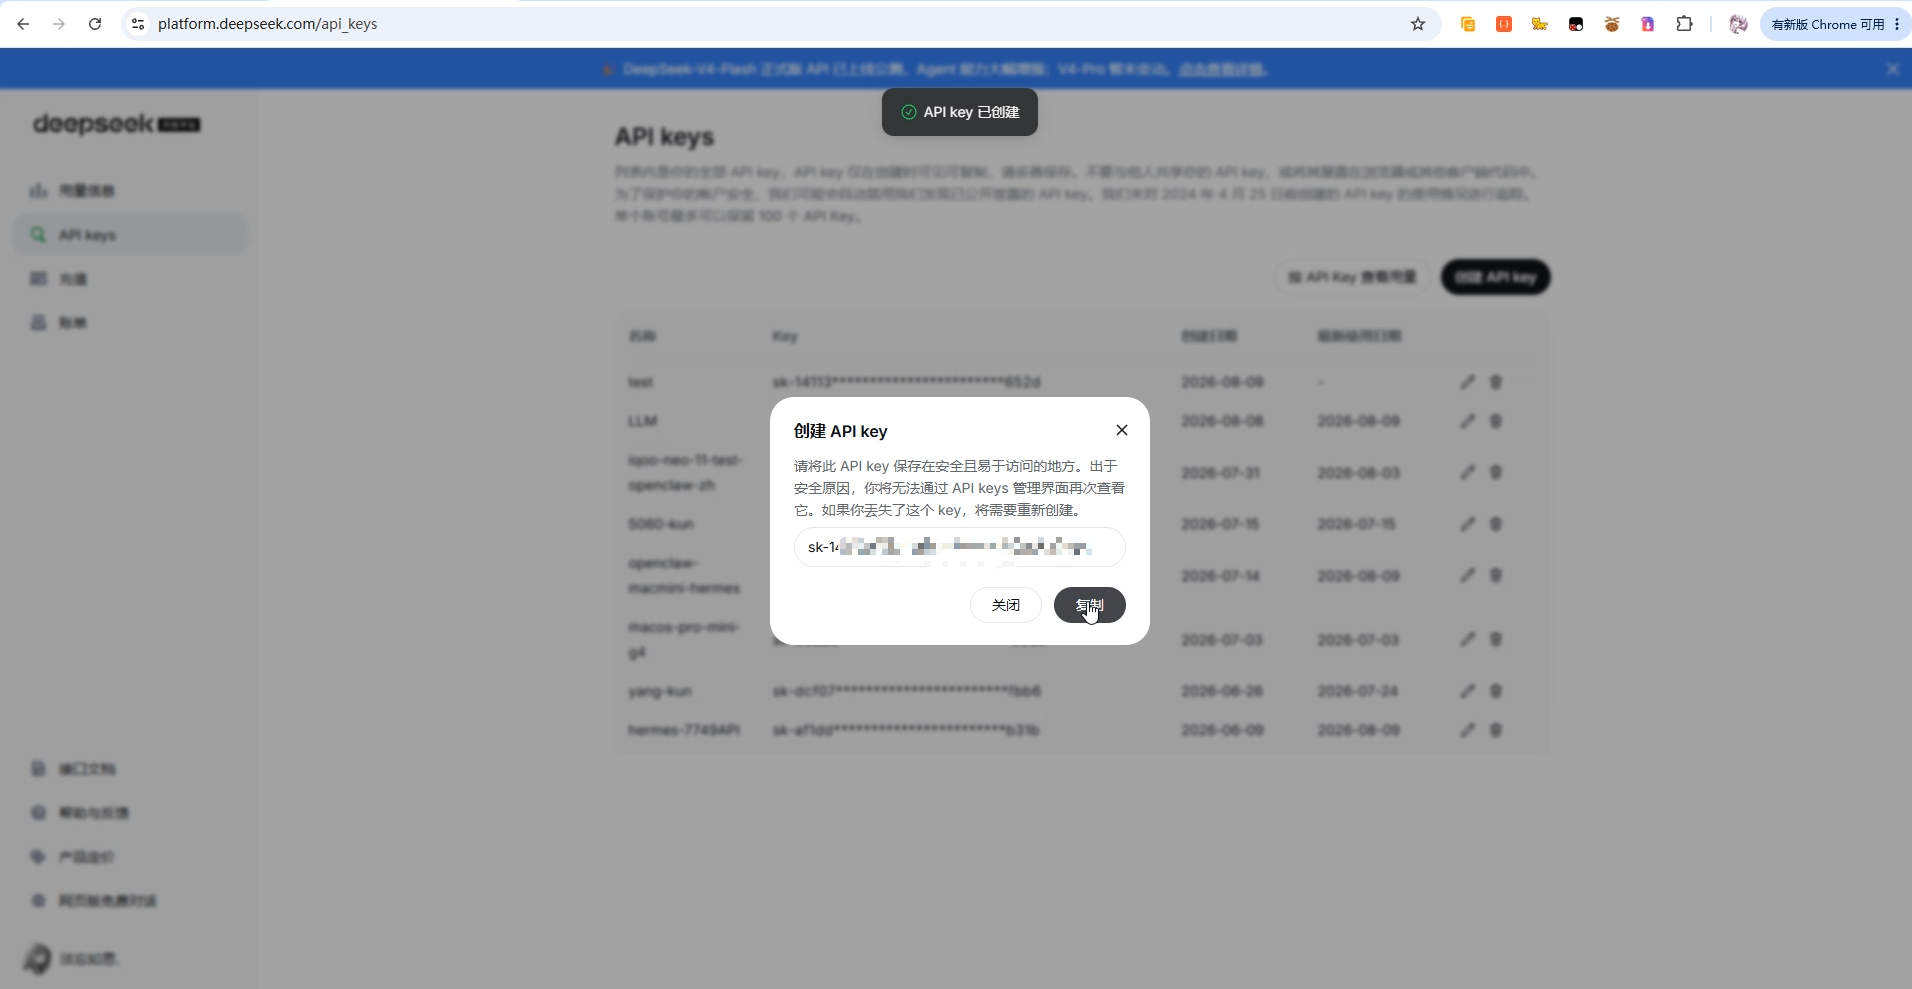
接着回填到终端中,填写后会进行启动数字人服务,启动完成后会自动浏览器打开页面,如下图所示:
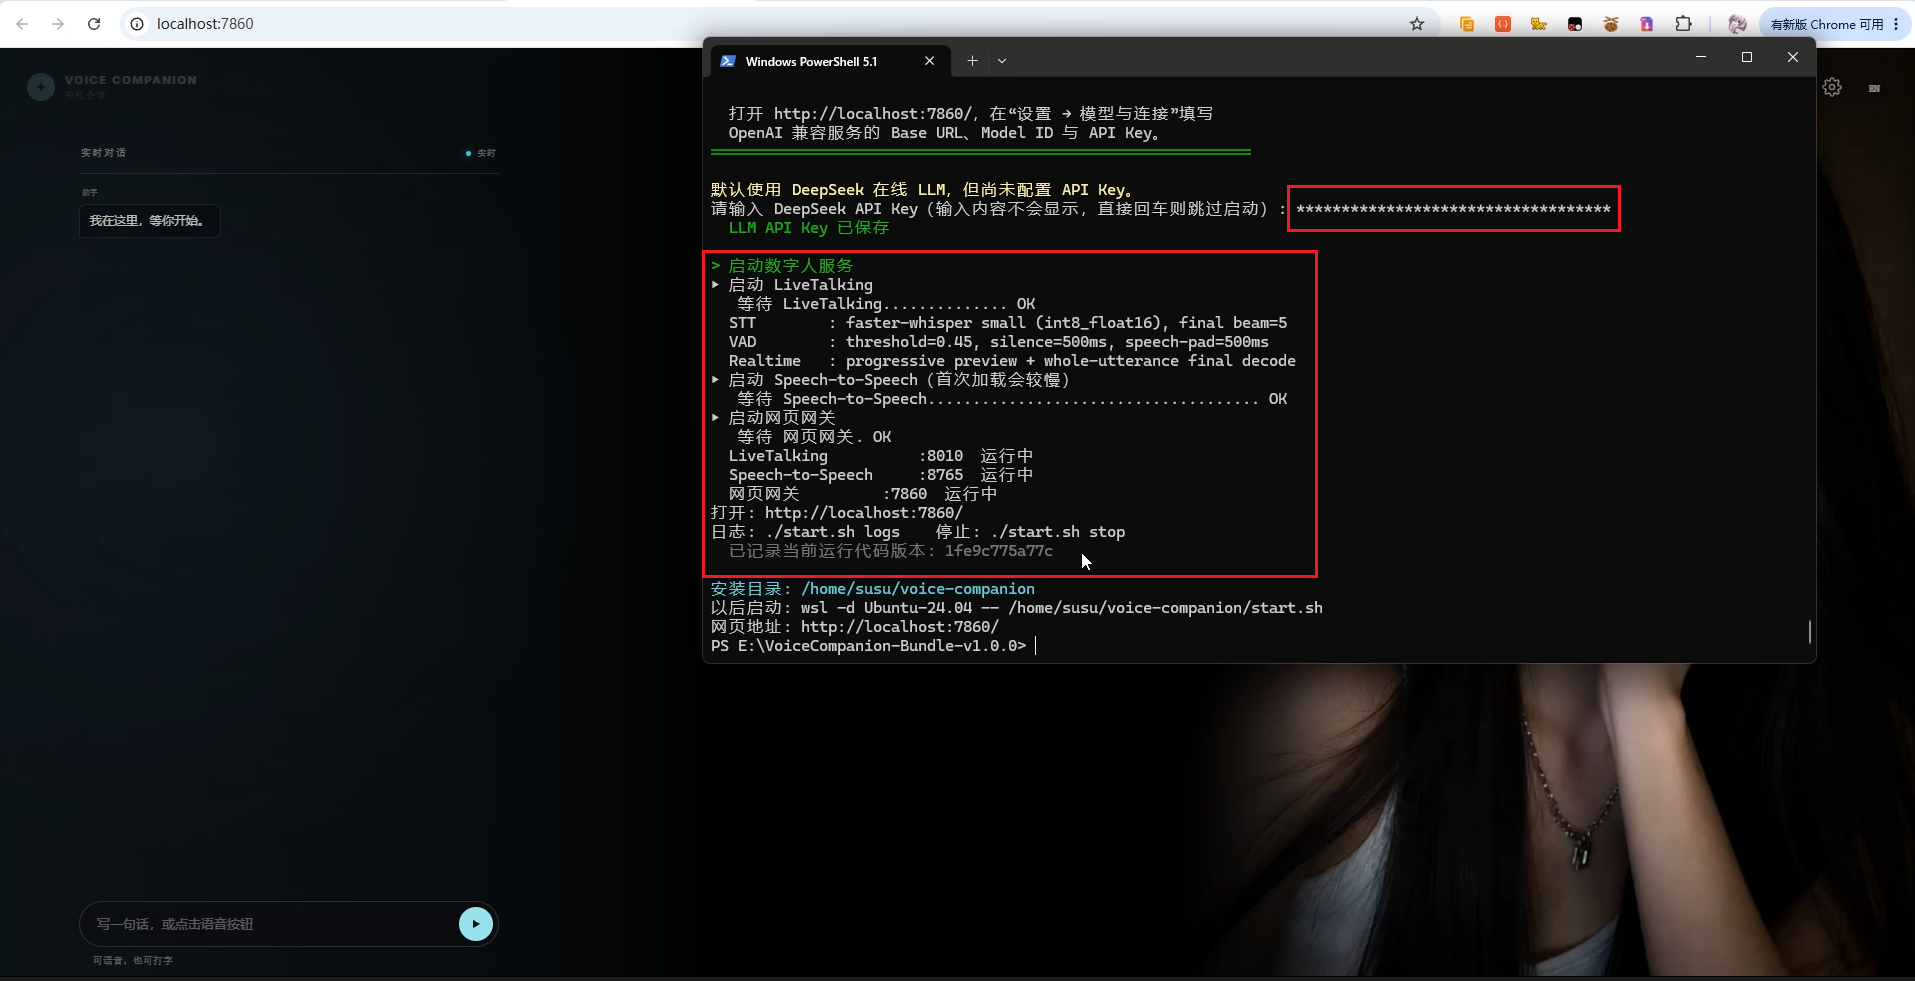
到这里,Voice Companion已经完成首次部署并启动。
3 对话测试与功能介绍
项目启动后,先从最基础的语音对话开始验证。
首先点击页面左上角的设置图标,选择当前使用的麦克风设备:
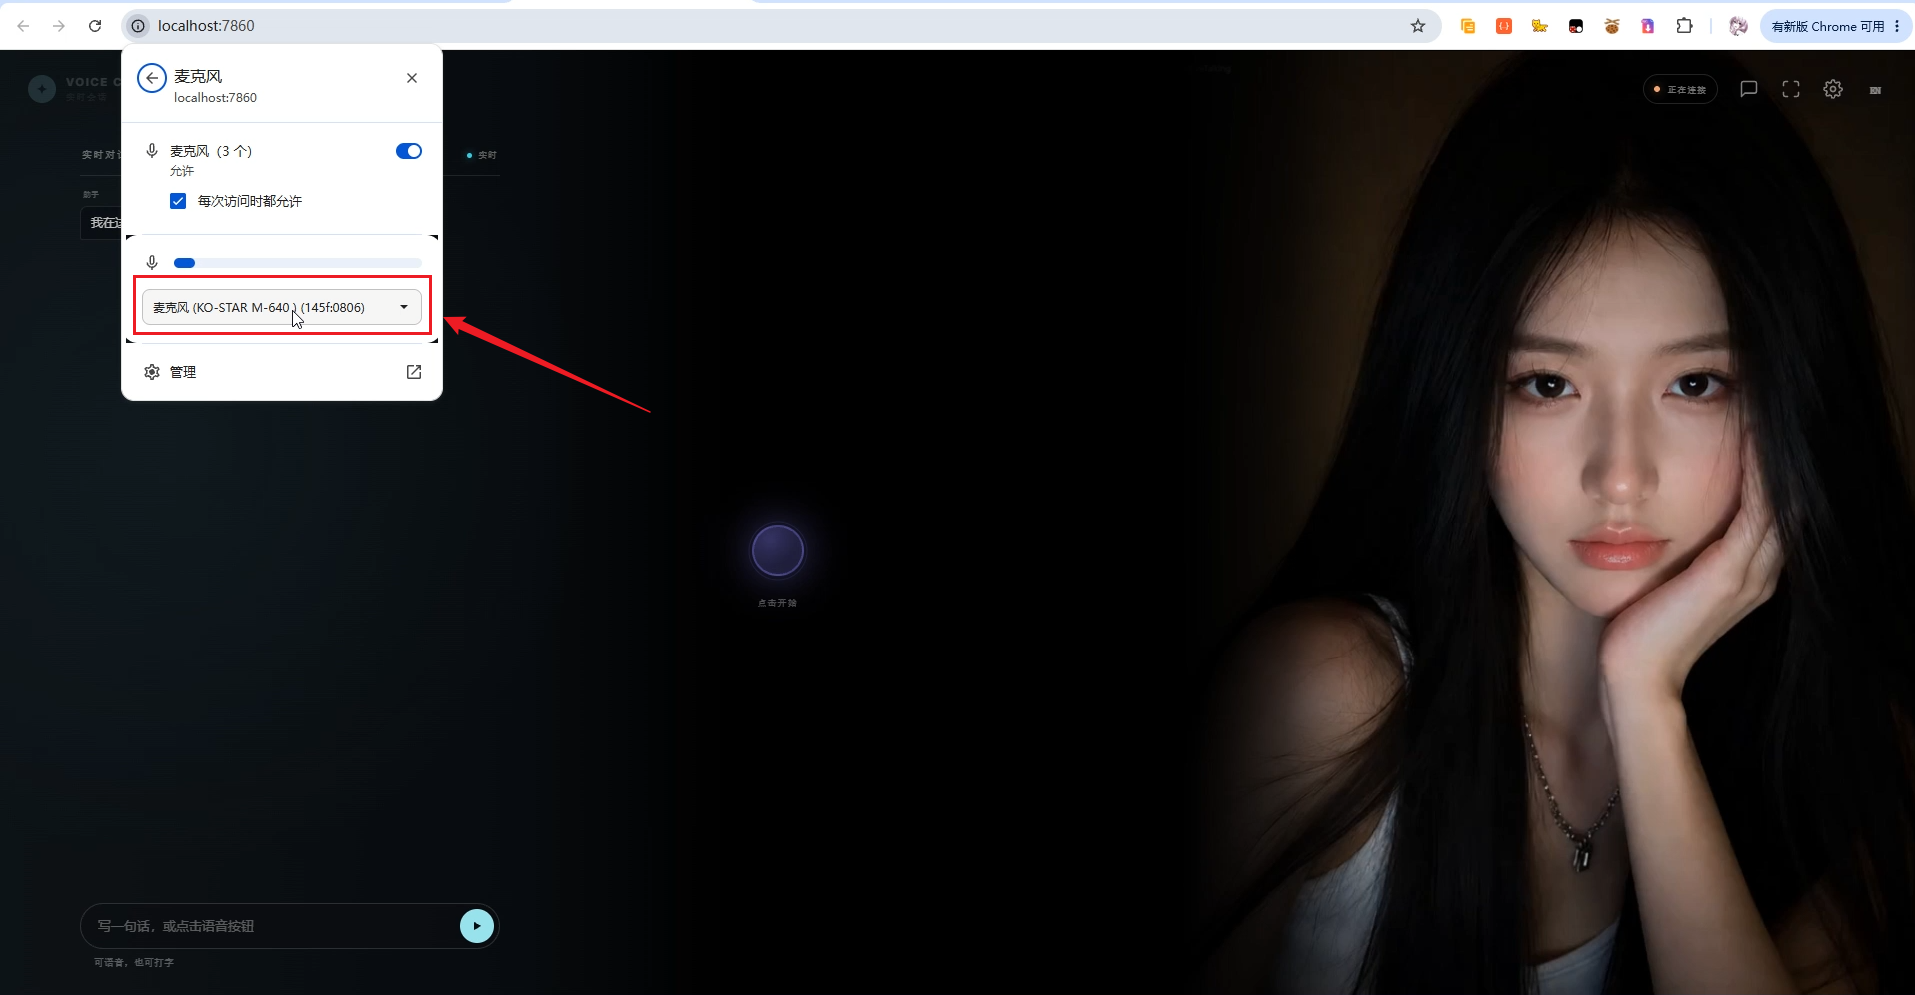
然后点击【开始】按钮。稍等片刻,数字人会先进行一次语音回应,同时可以看到人物口型也会跟随声音同步变化。
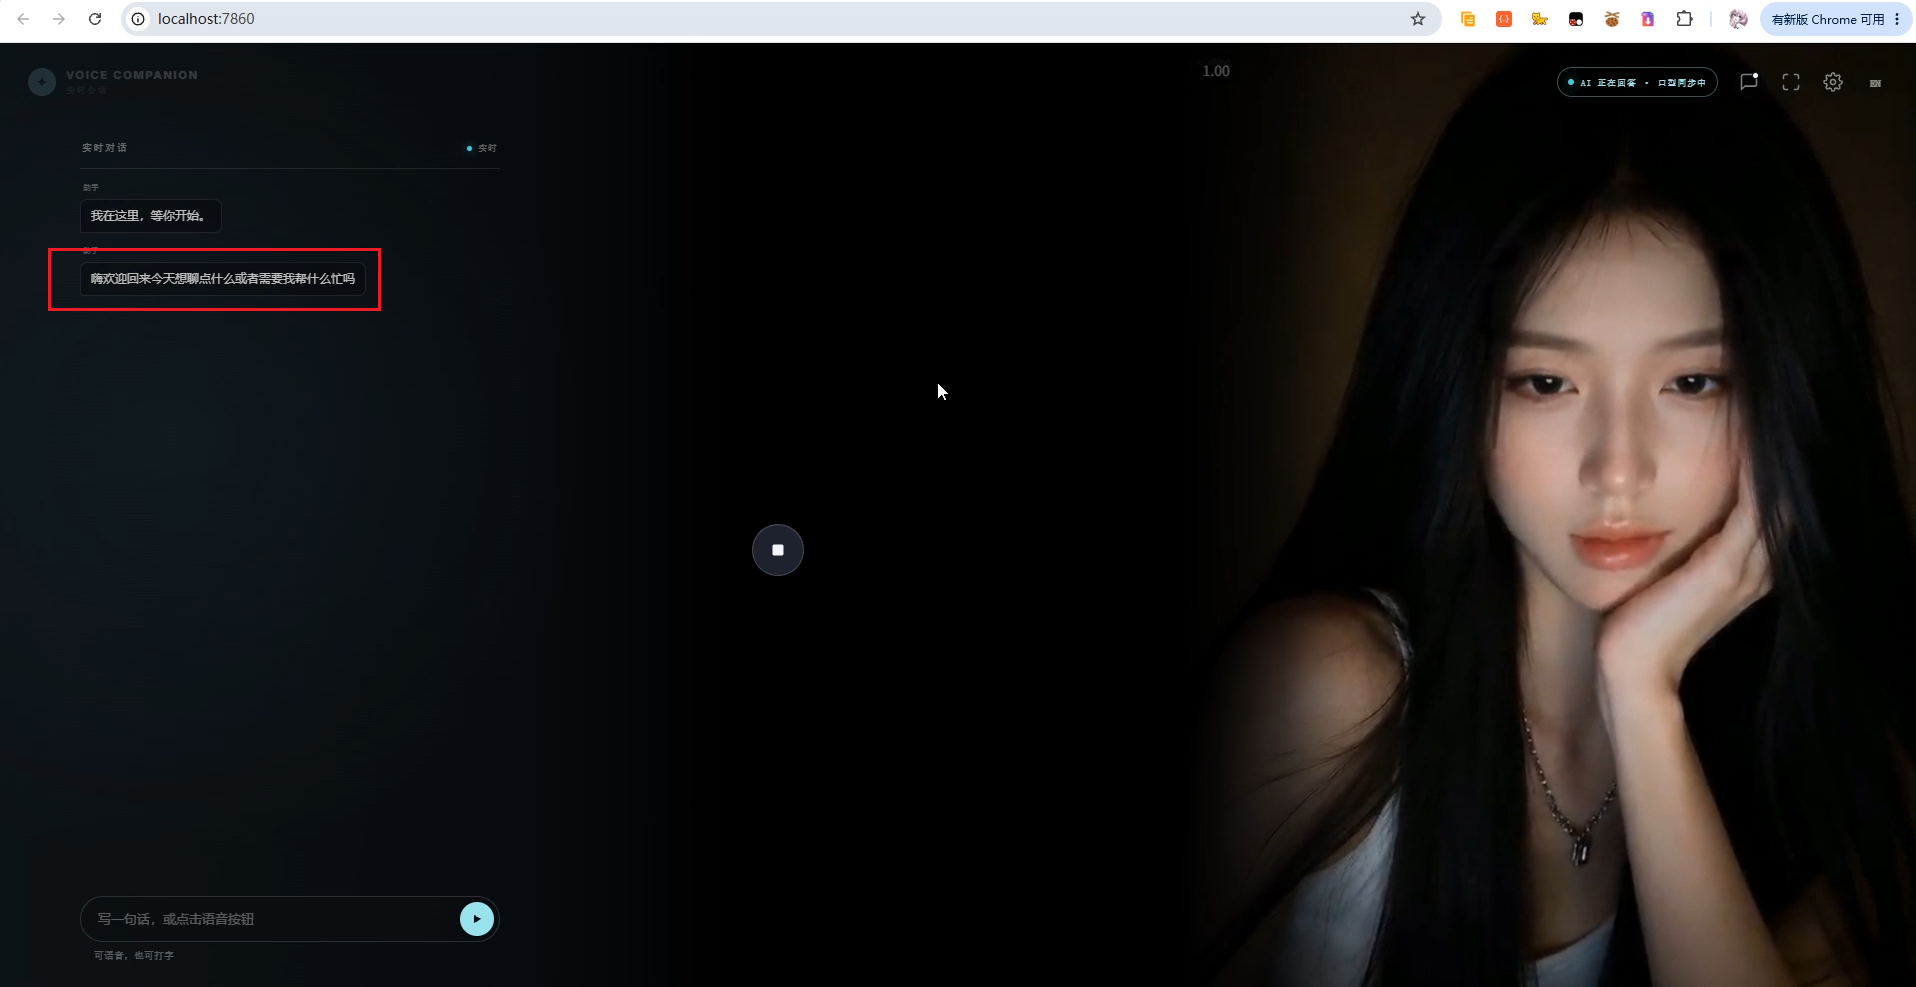
等数字人回答完成后,会出现麦克风,此时可以进行说话,如果环境太嘈杂,可以在设置中设置麦克风的噪声门限: 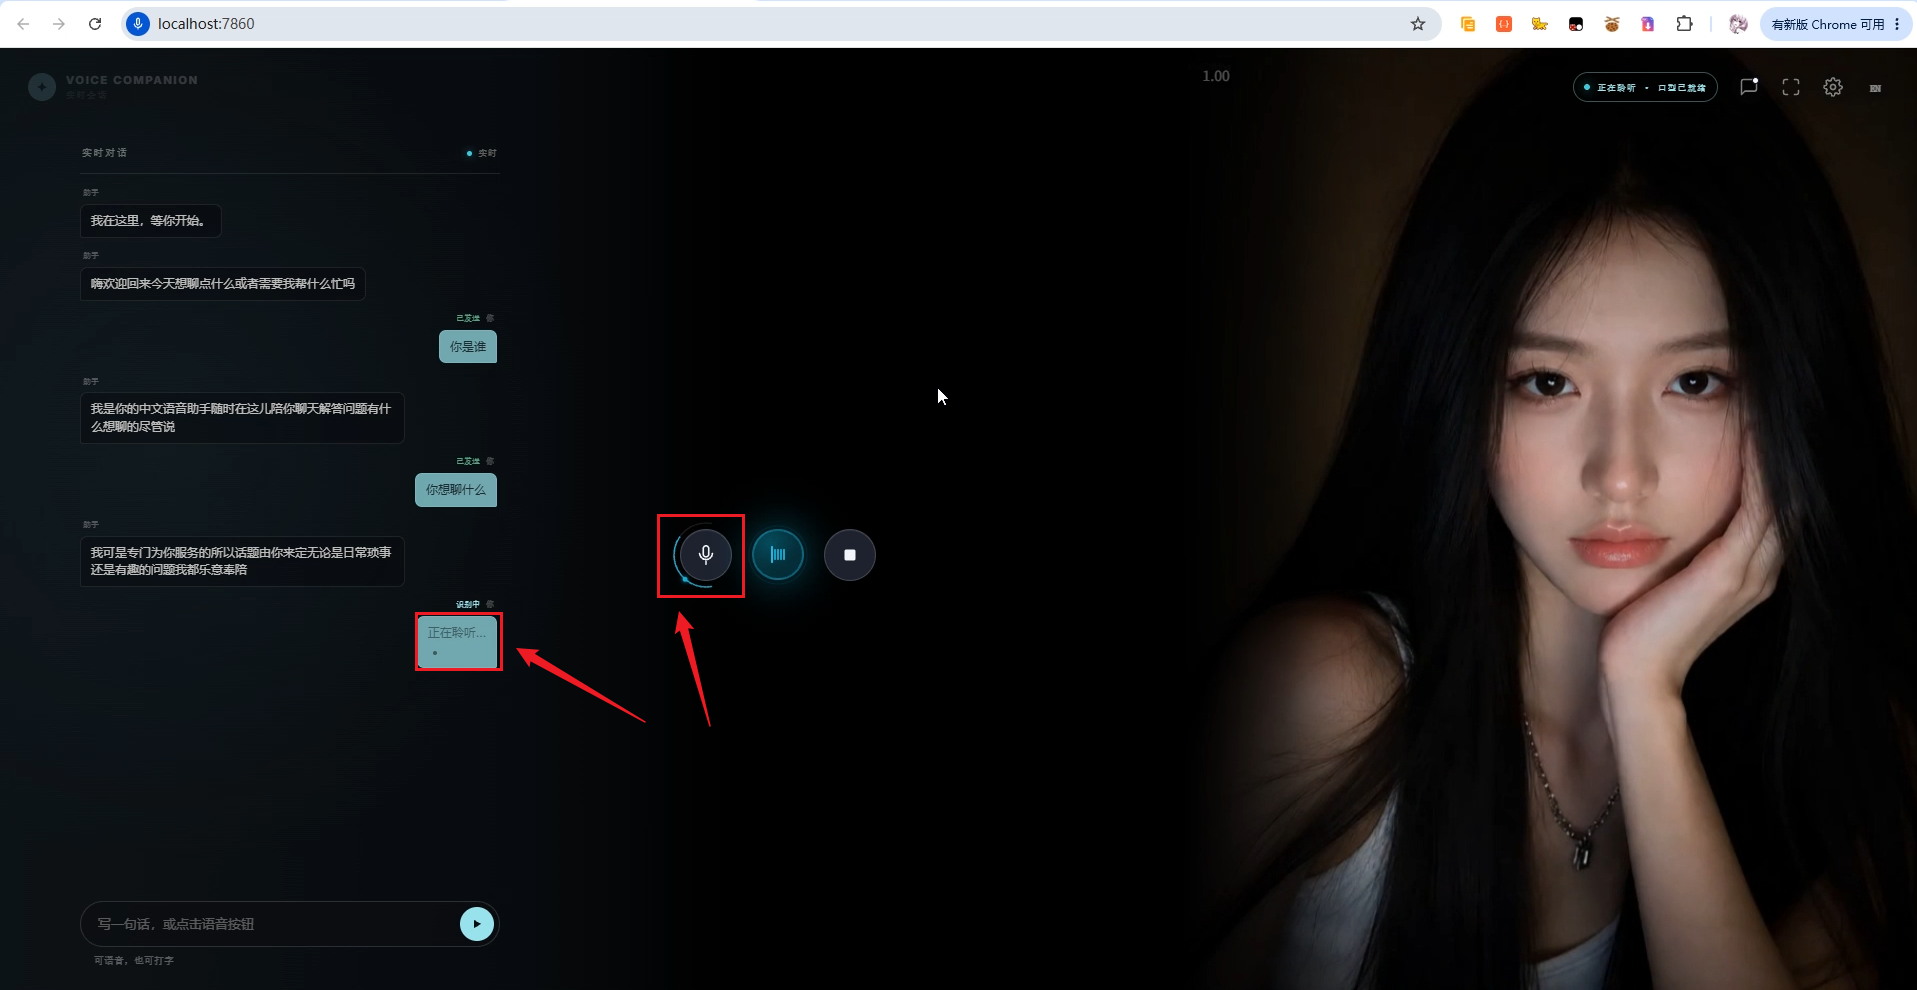
接着介绍一下功能设置,点击右上角的设置按钮,可以看到助手页面,可以在该页面进行自定义人设: 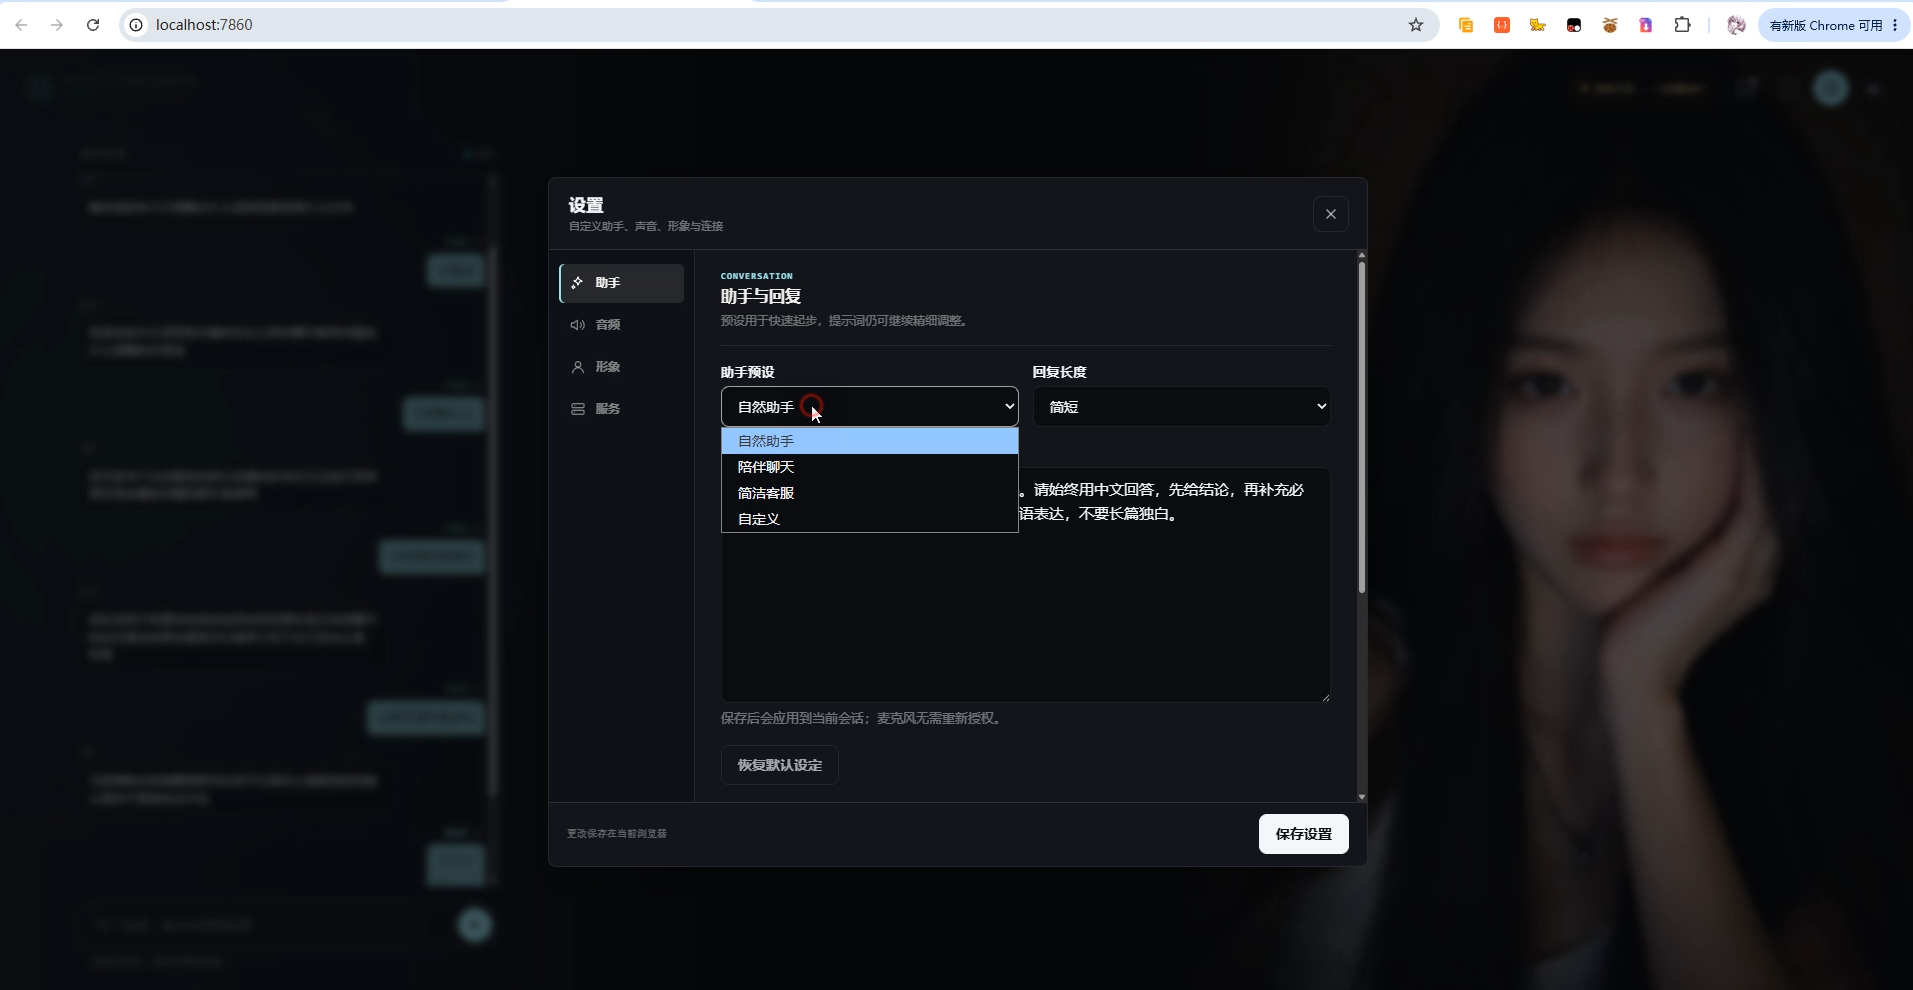
其次是音频页面,可以上传一段其他的参考音频,进行音色克隆。还有前面提到的噪声门限就是在这里设置: 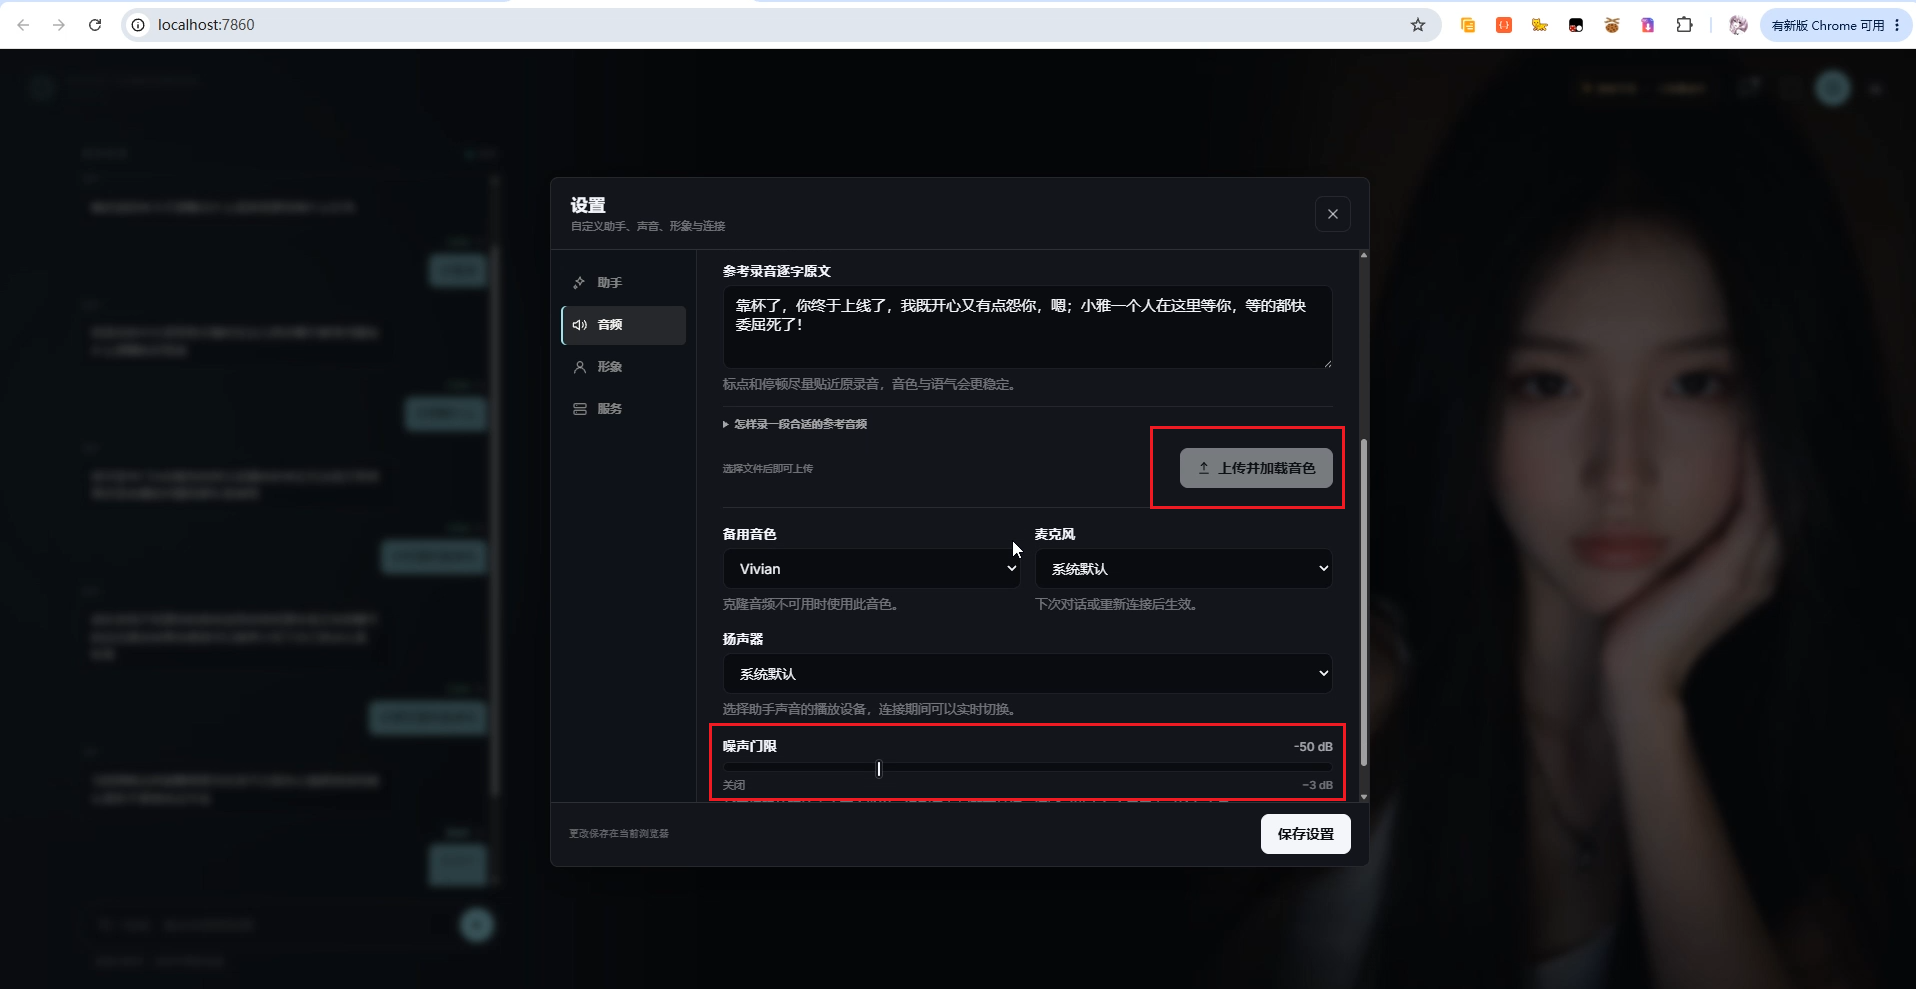
接着来到形象页面,可以上传一段人物视频,生成新的人物形象,数字人形象稍微吃显存,可以根据需要调整画质:
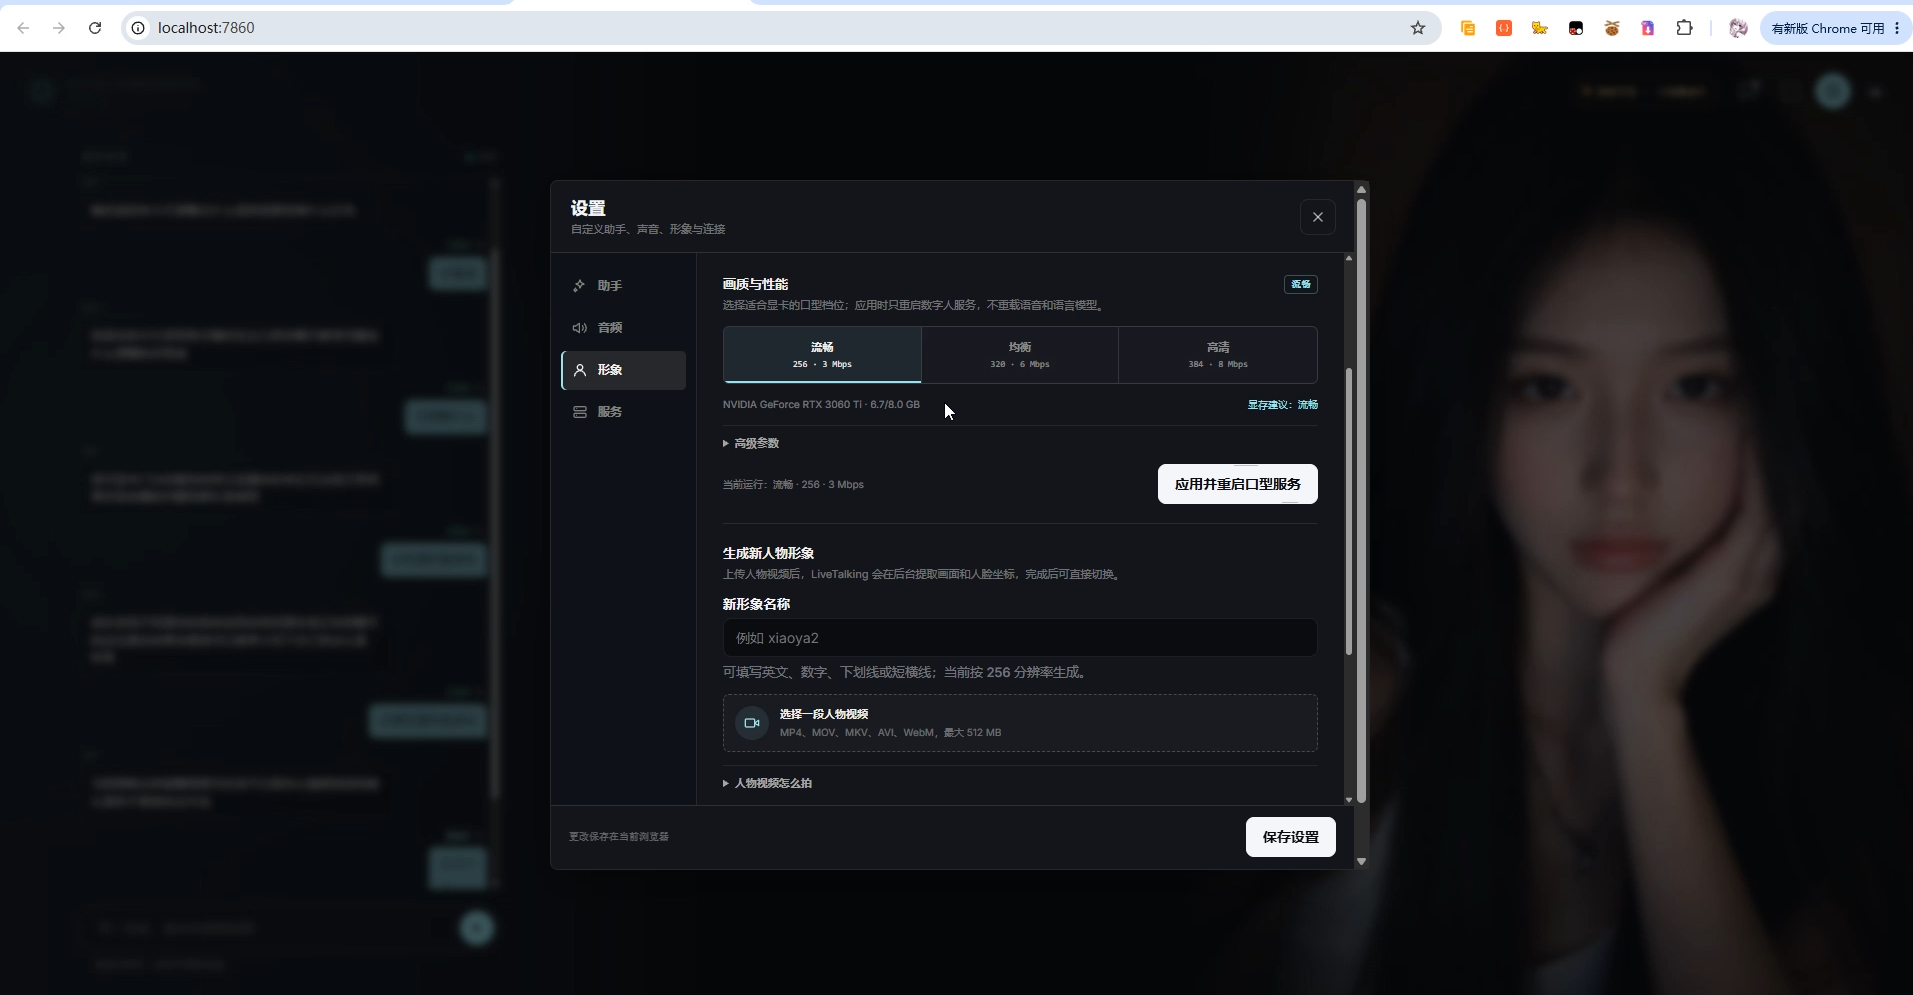
最后是【服务】页面,这里主要用于配置负责对话的 LLM。项目默认使用 DeepSeek 在线 API,也支持添加其他 OpenAI 兼容服务,后面还可以通过 LM Studio 接入运行在本机的大模型: 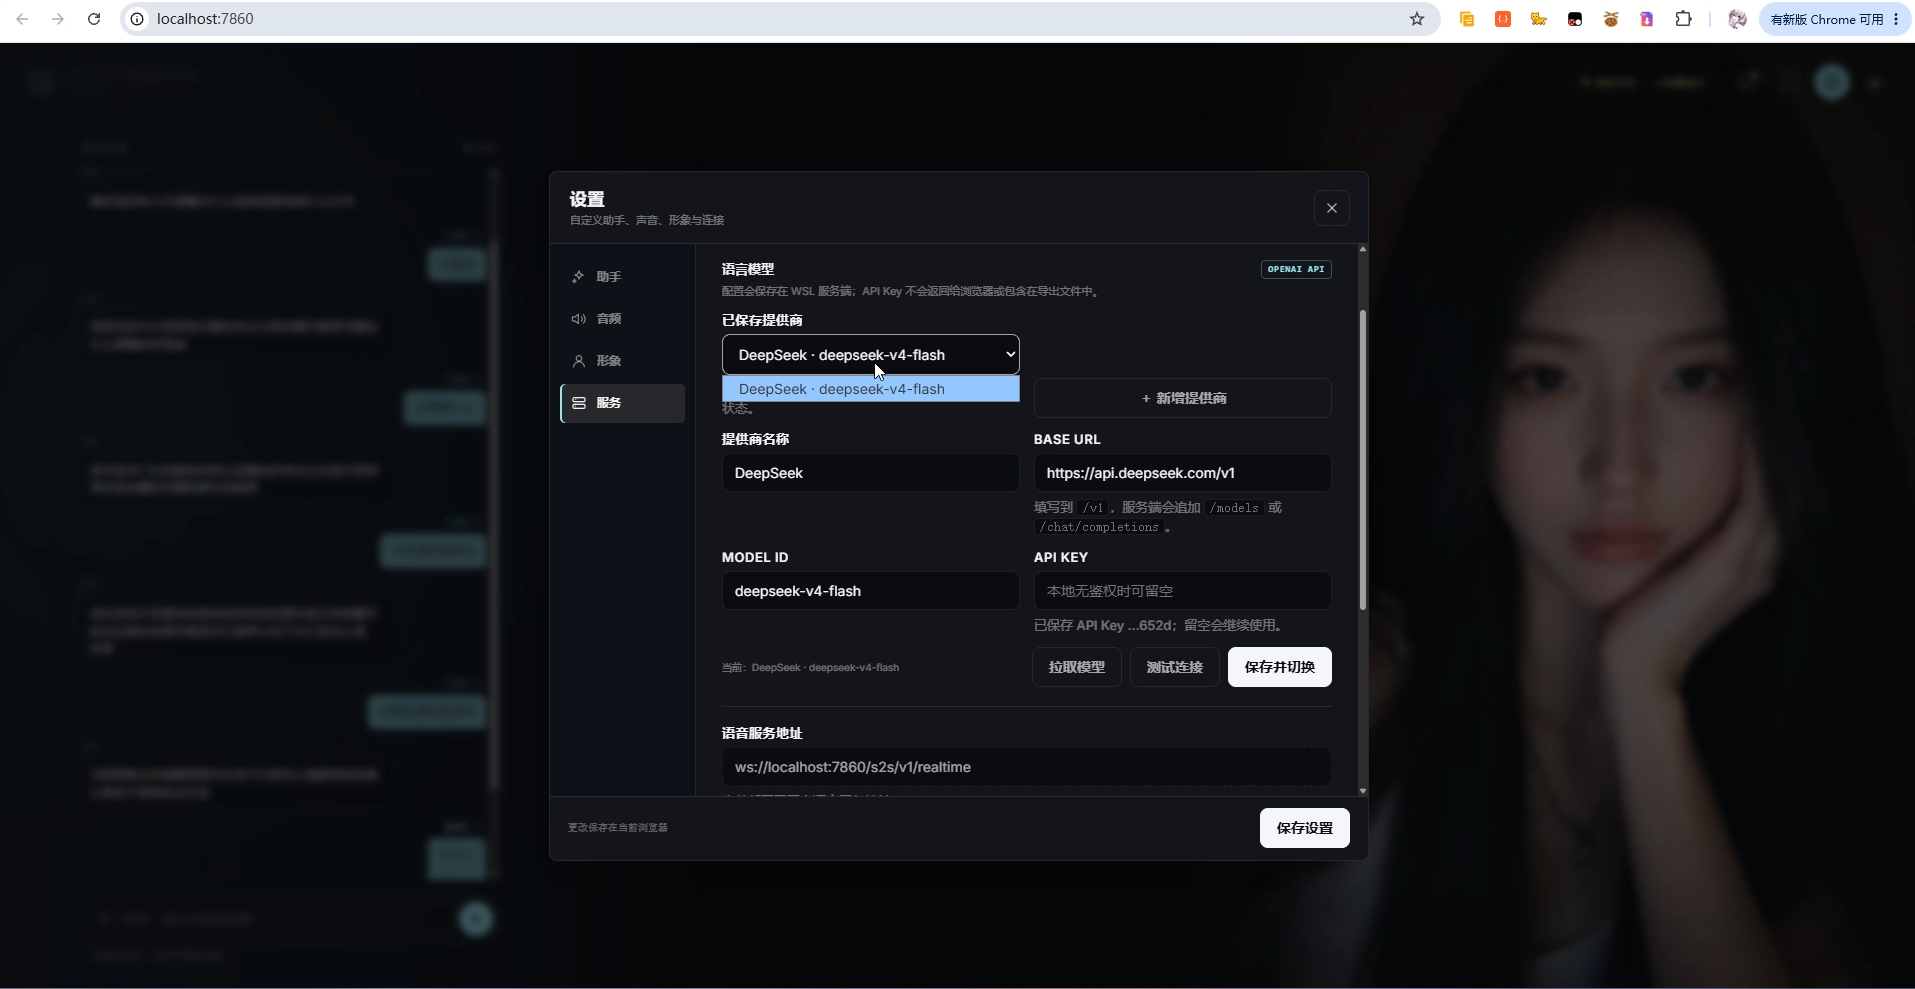
到这里,Voice Companion 的基础对话、人物形象、音色和服务配置已经走过一遍。默认在线大模型已经能够完成对话,下一步继续把负责回答的 LLM 换成本地模型,让整套交互链路进一步本地化。
4 使用 LM Studio 部署本地大模型
前面使用的是 DeepSeek 在线 API,虽然使用起来比较方便,但 Voice Companion 同样支持接入运行在本机的大模型。
这里使用 LM Studio 来部署本地模型。它提供了图形化的模型下载、加载和运行界面,不需要手动配置复杂的推理环境,比较适合直接在 Windows 上运行本地大模型。
打开 LM Studio 官网,下载并安装 Windows 版本:
LM Studio 官网:https://lmstudio.ai/download
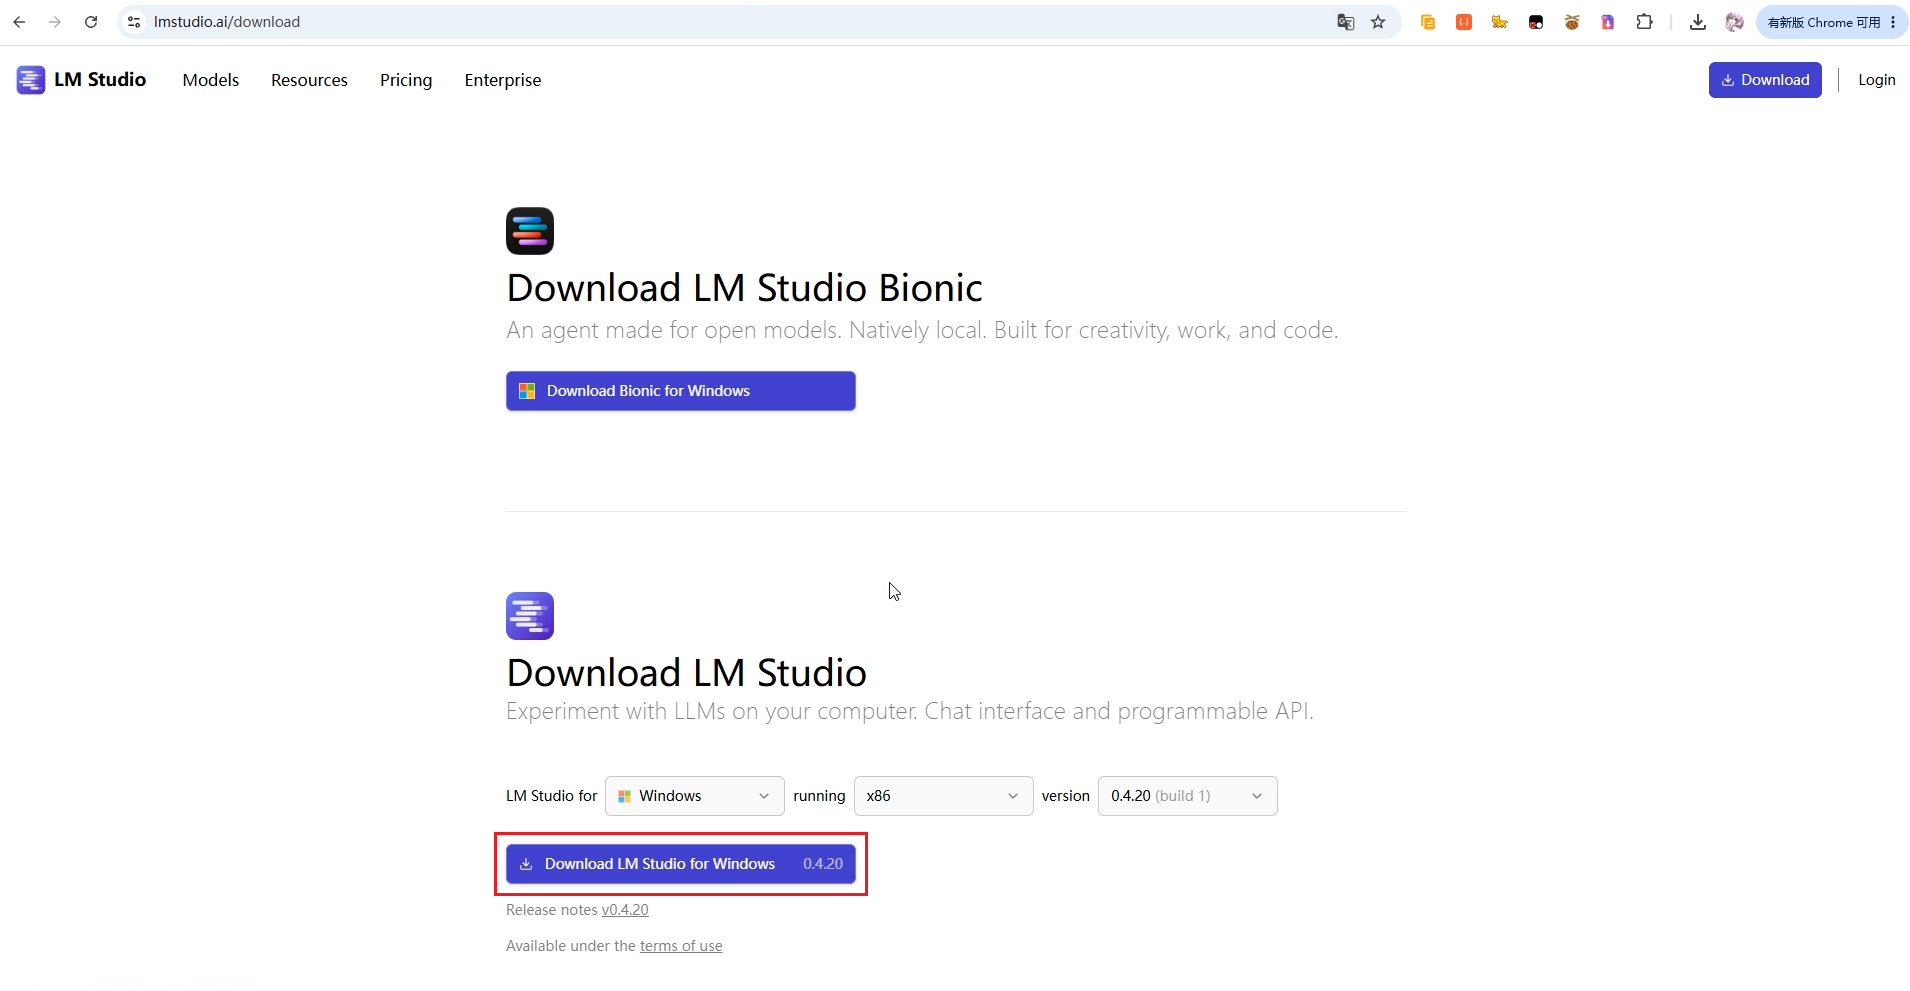
下载下来后,双击安装,然后进入界面后,点击左下角设置,可以先将语言改为中文: 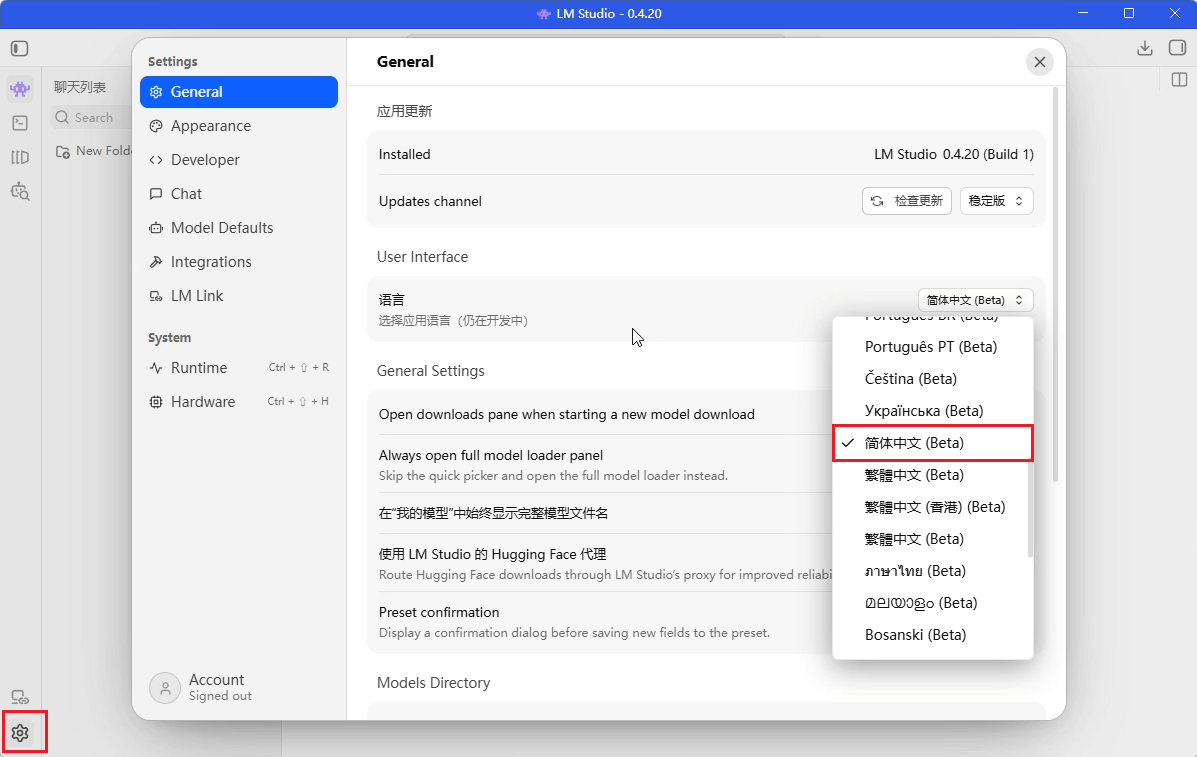
接着,点击左侧边第4个,这里以 gemma 4模型为例,选择一个点赞较多的无审查版本: 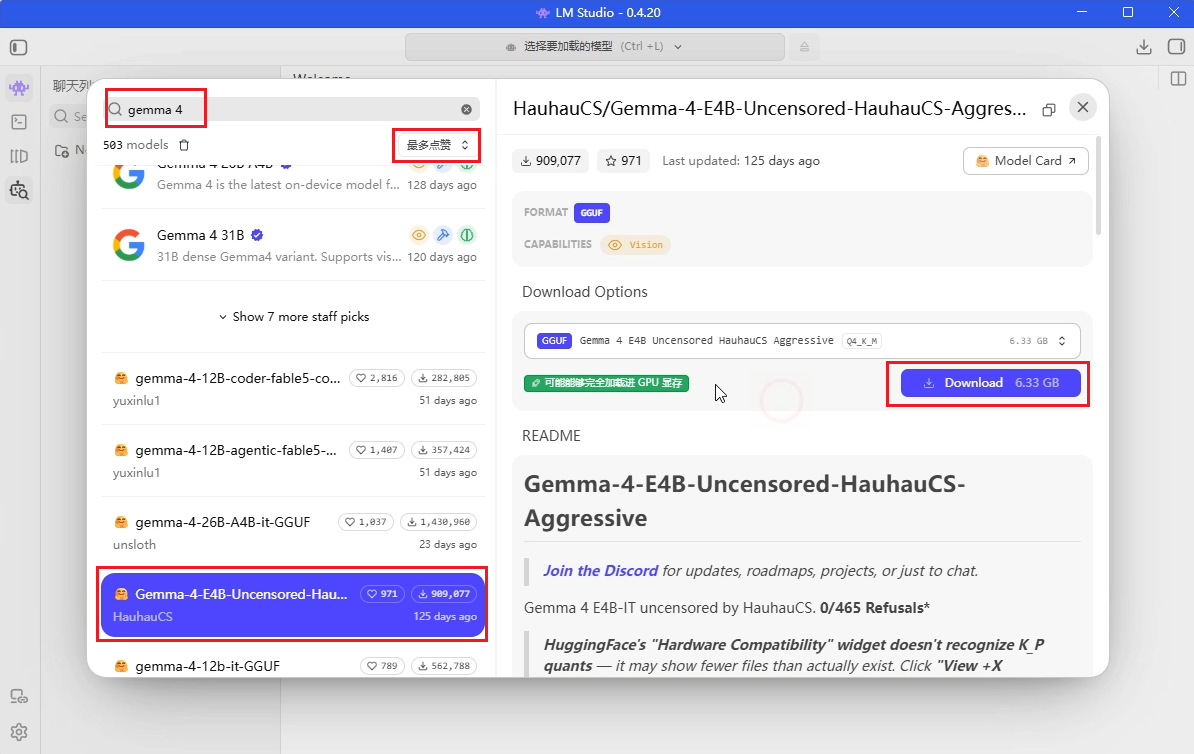
可以看到提示【可能能够完全加载进 GPU 显存】,代表这个模型可以完整的加载进你的显卡显存中,跑起来的速度一般会比较快的,点击侧边按钮下载即可:
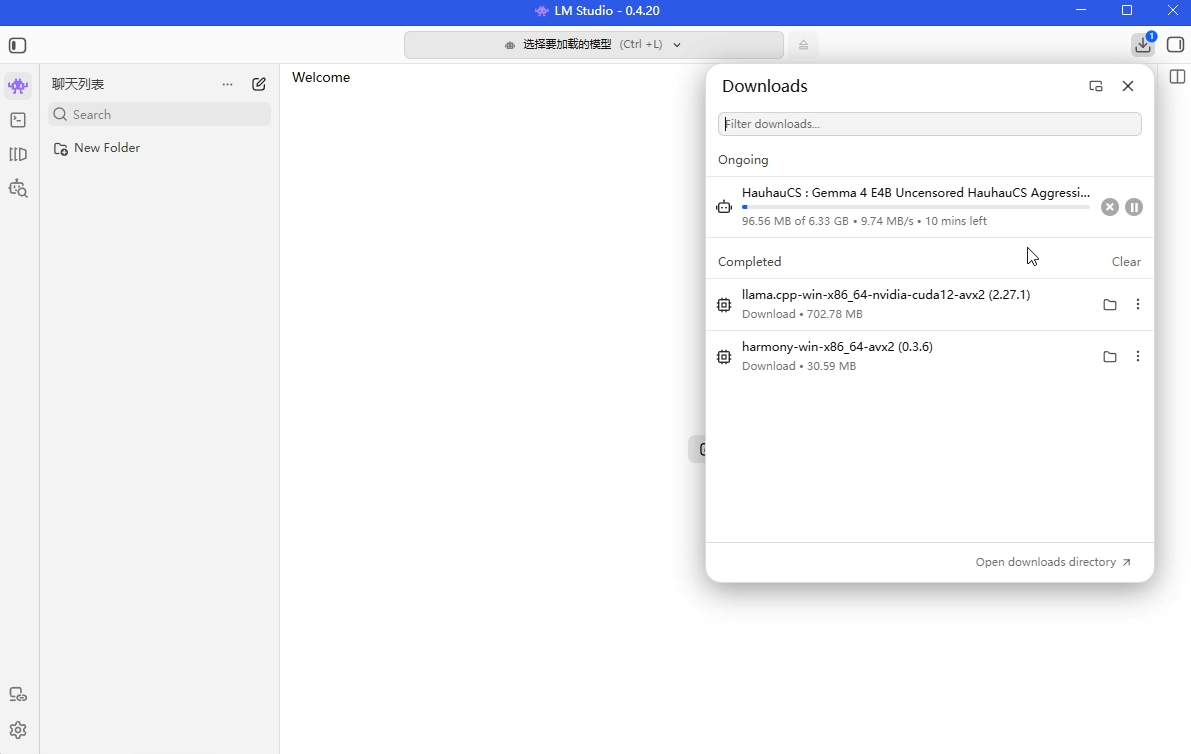
下载完成后,在顶部选择要加载的模型,进行加载: 
加载完成后,就可以进行对话测试了,这里发了一句【你好】进行测试: 
页面已经能够正常输出回答,并显示约34 token/s的速度。到这里,本地模型已经完成加载和对话测试。
5 启用LM Studio的API服务并修改数字人走本地模型
点击左侧边栏的第二个,在Server Settings中,修改端口为一个未被windows保留的端口,如12345,然后任务栏右键LM Studio图标,点击启动服务(也可以点击Server Settings左侧的按钮启动服务): 
启动后,可以从日志中看到,服务启动成功: 
LM Studio服务启动以后,就可以继续通过它的API接口接入Voice Companion,Base URL如下:
http://localhost:12345
接着回到数字人服务页面,右上角设置按钮,进入服务页面,然后点击新增提供商,提供商名称自定义即可,BaseURL填写上面的地址,模型ID先输入任意字符,然后点击拉取模型,再删除刚才输入的任意字符,下拉框选择前面下载好的本地模型,点击测试,测试成功后点击保存并切换:

切换成功后,返回主页,点击开始按钮,等待数字人回答或主动对话测试(可以打开任务管理器查看GPU占用): 
可以看到,在数字人生成回答时,GPU 占用会明显上升,说明当前对话已经成功切换到本地 LLM 进行推理。至此,Voice Companion 的语音识别、数字人口型、TTS 以及大模型对话就已经可以在本地协同运行。
6 下载安装cpolar
前面已经完成 Voice Companion 的本地部署,也分别验证了在线大模型和本地大模型的接入方式。
此时页面仍然主要运行在本地电脑上。下一步继续把Web入口提供给外部设备,让手机、平板或另一台电脑也能打开同一套语音交互页面。这里使用 cpolar 内网穿透 完成网络入口。
6.1 什么是cpolar?

- cpolar 是一款内网穿透工具,可以将你在局域网内运行的服务(如本地 Web 服务器、SSH、远程桌面等)通过一条安全加密的中间隧道映射至公网,让外部设备无需配置路由器即可访问。
- 广泛支持 Windows、macOS、Linux、树莓派、群晖 NAS 等平台,并提供一键安装脚本方便部署。
6.2 下载安装cpolar
打开cpolar官网的下载页面点击立即下载 64-bit按钮,下载cpoalr的安装包:

下载下来是一个压缩包,解压后执行目录种的应用程序,一路默认安装即可,安装完成后,打开cmd窗口输入如下命令确认安装:
cpolar version

出现如上版本即代表安装成功!
6.3 注册及登录cpolar web ui管理界面
访问cpolar官网,点击免费注册按钮,进行账号注册

进入到如下的注册页面进行账号注册: 
注册完成后,在浏览器中输入如下地址访问 web ui管理界面:
http://127.0.0.1:9200

输入刚才注册好的cpolar账号登录即可进入后台页面:

7 使用cpolar穿透 Voice Companion
首先,点击【隧道管理】下的【创建隧道】进入创建隧道页面,自定义一个隧道名称,本地地址填写Voice Companion项目的访问端口,然后点击创建即可:

接着,来到状态下的在线隧道列表,可以看到同一隧道2条不同协议的公网地址:

这里以https进行访问测试:

通过公网地址访问以后,页面里的语音对话、数字人口型和模型回复仍然可以继续工作,说明这套Web入口已经能够从外部网络使用。
8 固定二级子域名
前面通过 cpolar 已经可以生成公网地址并正常访问 Voice Companion,不过免费生成的随机域名可能会发生变化。如果希望长期保存一个固定的访问地址,可以继续配置 cpolar 的固定二级子域名。
8.1 保留二级子域名
首先登录 cpolar 官网后台,进入【预留】页面:
https://dashboard.cpolar.com/reserved
选择与当前隧道相同的地区,然后填写一个未被占用的二级子域名并保存:
| 地区 | 选择和前面隧道一致的地区,如:China Top |
| 名称 | 自定义二级子域名,例如 voice01,注意:该项不能重复,二级子域名名称是唯一的 |
| 描述 | 填写任意方便辨识的备注即可 |
如下图:  填写完成后,点击【保留】按钮。保留成功后,会得到一个固定的二级子域名。
8.2 修改隧道为子域名方式
接着,回到【隧道管理>隧道列表】下,点击编辑7860这条隧道:

将域名类型修改为【二级子域名】,并填写刚才在官网后台保留的二级子域名,然后点击更新按钮:

更新完成后,点击左侧菜单【状态>在线隧道列表】,可以看到 7860 隧道已经变成固定公网地址:

复制生成的固定公网地址,在浏览器中访问:

可以看到,通过固定公网地址同样可以正常访问 Voice Companion。这样后续就不需要担心随机地址发生变化,无论是在电脑还是手机上,都可以通过同一个固定地址远程进行语音对话。
9 配置HTTP Auth添加访问认证
通过前面的配置,Voice Companion 已经可以通过固定公网地址进行远程访问。
不过,与只在本地电脑上使用不同,配置公网访问后,任何知道公网地址的人都有可能尝试打开 Voice Companion 页面。如果只是自己使用,可以继续通过 cpolar 的 HTTP Auth 功能增加一层账号密码认证,避免其他人直接访问。
首先,进入 cpolar Web UI 的【隧道管理 > 隧道列表】,找到前面创建的 7860 隧道,然后点击右侧的【编辑】:

在隧道编辑页面中展开【高级】设置,找到【HTTP Auth】配置项,按照下面的格式填写用户名和密码:
注意:HTTP Auth 属于公网隧道的访问保护,并不是 Voice Companion 本身的用户系统。建议设置一个不容易被猜到的独立密码,并优先使用 HTTPS 公网地址访问。
用户名:密码
如下图所示,设置好后点击更新:

接着重新打开 Voice Companion 的 HTTPS 公网地址,此时浏览器会弹出身份验证窗口:

到这里,公网入口又增加了一层账号密码验证。以后访问Voice Companion页面时,会先经过这层HTTP Auth。
总结
这次真正完成的是一条完整的本地AI数字人交互链:先通过Voice Companion Bundle把语音识别、TTS、音色、数字人口型和大模型接口集中到同一套环境里,再用麦克风实际完成语音输入、模型回复和人物口型同步。
模型部分先使用DeepSeek在线API降低本地资源压力,随后再通过LM Studio加载本地模型,并把Voice Companion的LLM提供商切换到本机。这样就能直观看到同一套数字人前端在“在线模型”和“本地模型”两种方式下的区别。
后面的公网访问并没有改变数字人的工作方式,只是给原本局限在本地电脑上的Web页面增加了外部入口。再配合固定二级子域名和HTTP Auth,手机、平板或其他电脑都可以继续打开同一套页面进行语音交互。
所以这篇更值得关注的不是“8G显卡能塞下多大的模型”,而是8G显存条件下,语音识别、大模型、TTS和数字人口型能不能一起协同工作。把这些环节串起来以后,AI才真正从聊天框走到了可以听、可以说、还有人物形象的数字人形态。