文章目录
-
- 1. 为什么每个做 AI 的人都绕不开 Faiss
- 2. Faiss 到底能做什么:功能全景
-
- 2.1 相似性检索:从精确到近似
- 2.2 压缩表示:单机内存撑起数十亿向量
- 2.3 GPU:即插即用的算力放大器
- 2.4 一张表看懂六大能力域
- 3. 架构总览:一张图看懂分层与模块
-
- 3.1 分层架构
- 3.2 代码模块
- 4. 核心索引家族全解
-
- 4.1 索引速查表
- 4.2 Flat 系列:最纯粹的\”老实人\”
- 4.3 IVF 系列:空间分区 + 倒排(cell-probe 方法)
- 4.4 HNSW 系列:把向量连成图
- 4.5 LSH:哈希的世界,但 Faiss 做了改良
- 4.6 PQ 系列:乘积量化,大规模检索的主力
- 4.7 残差量化:逐级逼近
- 4.8 RaBitQ:极致压缩的新选项
- 5. 选型方法论:两轴决策,告别瞎调参
-
- 5.1 轴一:精度与内存约束
- 5.2 轴二:数据集规模决定聚类方式
- 5.3 一个容易忽略的捷径
- 6. 核心运行流程与关键代码
-
- 6.1 数据准备:矩阵约定
- 6.2 建索引、加向量、搜索
- 6.3 用一句话构建复杂索引
- 6.4 参数调优有工具,不必手撸网格
- 7. 揭开盖子:一次 IVF 检索是怎么跑起来的
- 8. GPU 加速完全指南
-
- 8.1 即插即用与自动拷贝
- 8.2 转换 API
- 8.3 GpuResources:显存与流的管家
- 8.4 已实现的索引与存储选项
- 8.5 GPU 的限制与避坑
- 8.6 多 GPU:复制还是分片?
- 8.7 性能预期与硬件门槛
- 9. 安装与部署:conda 到源码的完整路径
-
- 9.1 首选:conda(推荐)
- 9.2 从源码构建(CMake)
- 9.3 跑通官方示例
- 10. 避坑清单与最佳实践(付费专栏重点)
- 11. 结语:一条清晰的学习路径
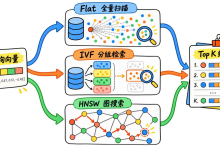
做推荐、搜索、RAG、去重、聚类……只要涉及\”向量找相似\”,你几乎一定会撞上同一个名字:Faiss。 一个由 Meta 基础人工智能研究团队主导、长期开源的 C++ 向量检索库,用一套 API 同时搞定精确检索、近似检索、量化压缩、聚类训练与 GPU 加速。 本文把它的能力边界、索引家族、选型方法、运行机制、GPU 玩法、安装部署与避坑要点一次性讲透——这是一份可以直接放进\”工具箱\”的实战地图。
1. 为什么每个做 AI 的人都绕不开 Faiss
先给结论:Faiss 不是\”某一个算法\”,而是一整套\”相似性检索的工业级工具箱\”。
它要解决的问题非常朴素——把海量对象表示成向量,用整数给每个对象一个编号,然后用 L2(欧氏)距离或内积来衡量\”像不像\”:
- 与查询向量 L2 距离最小的,或者内积最大的,就是最相似的邻居;
- 由于归一化向量上的内积就等于余弦相似度,所以余弦相似度也被天然支持。
听起来简单,难点在于\”海量\”两个字。Faiss 的看家本领在于:
- 能检索任意规模的向量集合,甚至大到单机内存都装不下;
- 自带