/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
很多肿瘤AI工作只解决一个切口:诊断、分期、疗效预测或预后分层。Oncoformer想处理的是整段诊疗过程,把患者每次就诊积累的常规化验、生命体征和胸片,转成一个可持续更新的纵向表征。
它的核心设定是:不额外增加昂贵检测,而是从医院已经采集的连续数据中,提取癌症发生、进展和治疗反应的时间信号。
这篇最有意思的地方在于,作者没有把诊断、早筛、分期、疗效和复发拆成五个互不相关的模型,而是用一个多模态时序Transformer学习患者全程的临床轨迹。
文献信息
| 标题 | Advancing cancer detection and treatment using longitudinal routine clinical data |
| 中文理解 | 本研究构建Oncoformer,将纵向电子健康档案、常规实验室检查、生命体征和胸部X光片整合为统一患者表征,用于泛癌诊断、诊断前风险预测、肿瘤分期、疗效轨迹预测及无复发生存分层。 |
| 期刊 | Cell |
| 论文类型 | Resource |
| 发表时间 | 2026年9月17日;189(19):5995-6011.e8 |
| 研究方向 | 临床AI、纵向EHR、多模态Transformer、肿瘤早筛与精准治疗 |
| 核心队列 | COMPASS与UK Biobank |
| 数据规模 | 3672989人、17748334次临床就诊;UK Biobank 502665人 |
| 模型 | Oncoformer |
| DOI | 10.1016/j.cell.2026.07.009 |
| PMID | 42508404 |
| 代码 | https://github.com/kaiwang13/Oncoformer |
这篇文章解决了什么问题
癌症的发生并不是一次检查就能解释的事件。患者在确诊前数月甚至数年,可能已经出现缓慢但分散的全身性变化:血常规、生化、炎症指标、生命体征、影像表现和就诊频率都可能留下痕迹。
难点在于,真实世界临床数据具有时间间隔不规则、检查项目缺失、医院间分布差异大等特点。简单把一次化验单或一张胸片送入分类器,容易把“检查习惯”误当成疾病信号。
Oncoformer把每次就诊编码为一个多模态事件,再按时间顺序输入因果Transformer。模型在预测某一时点时,只能读取此前数据,因此它可以随着新增就诊不断更新风险评估,而不是只能给出一次性静态分数。
文章摘要
作者基于中国肿瘤多模态预测与监测研究队列COMPASS训练统一多模态模型Oncoformer。模型整合纵向电子健康档案、常规实验室检查、生命体征和胸部X光片,在同一患者表征上开展癌症诊断、诊断前风险预测、肿瘤分期、治疗反应预测和无复发生存分层。
在泛癌诊断任务中,Oncoformer报告AUROC 0.956;在确诊前1年的预测任务中,AUROC为0.869。模型对主要癌种的分期推断平均AUROC超过0.90,并将预测分数与术后病理表型及肿瘤相关基因通路进行独立对应。
在治疗部分,模型利用治疗前数据预测不同癌种-治疗组合中的反应轨迹,并在十个癌种中完成无复发生存分层。这些结果支持其作为风险分层和临床决策辅助的候选框架,但并不等同于已证明可用于人群筛查或替代病理分期。
方法设计亮点
材料与方法
| 发现队列 | COMPASS-Main:2810742人、11934576次就诊 |
| 验证队列 | COMPASS-Replication 862247人;UK Biobank 502665人,其中44275人有癌症诊断 |
| 输入模态 | 纵向实验室检查、生命体征、电子健康档案、胸部X光片 |
| 表格编码 | 数值共享token嵌入与变量类型嵌入;BERT式就诊编码器 |
| 影像编码 | DINOv2预训练Vision Transformer提取胸片特征 |
| 时序建模 | 因果Transformer解码器;以距首次就诊天数进行时间位置编码 |
| 训练策略 | 自监督掩码重建与下一次就诊预测预训练,随后开展多任务微调 |
| 去偏策略 | 缺失模式与队列对抗学习,降低真实世界数据分布差异影响 |
| 可复现性 | 官方代码含790例去标识化演示数据和简化checkpoint;完整COMPASS数据未随代码公开 |
研究结果
从三套队列建立癌症纵向临床图谱
研究使用281万人的COMPASS-Main进行模型开发,并在86万人的COMPASS-Replication和50万人的UK Biobank中验证泛化能力。模型追踪诊断前、初诊、分期、治疗、复发和随访等连续阶段,而不是把患者压缩为单一标签。
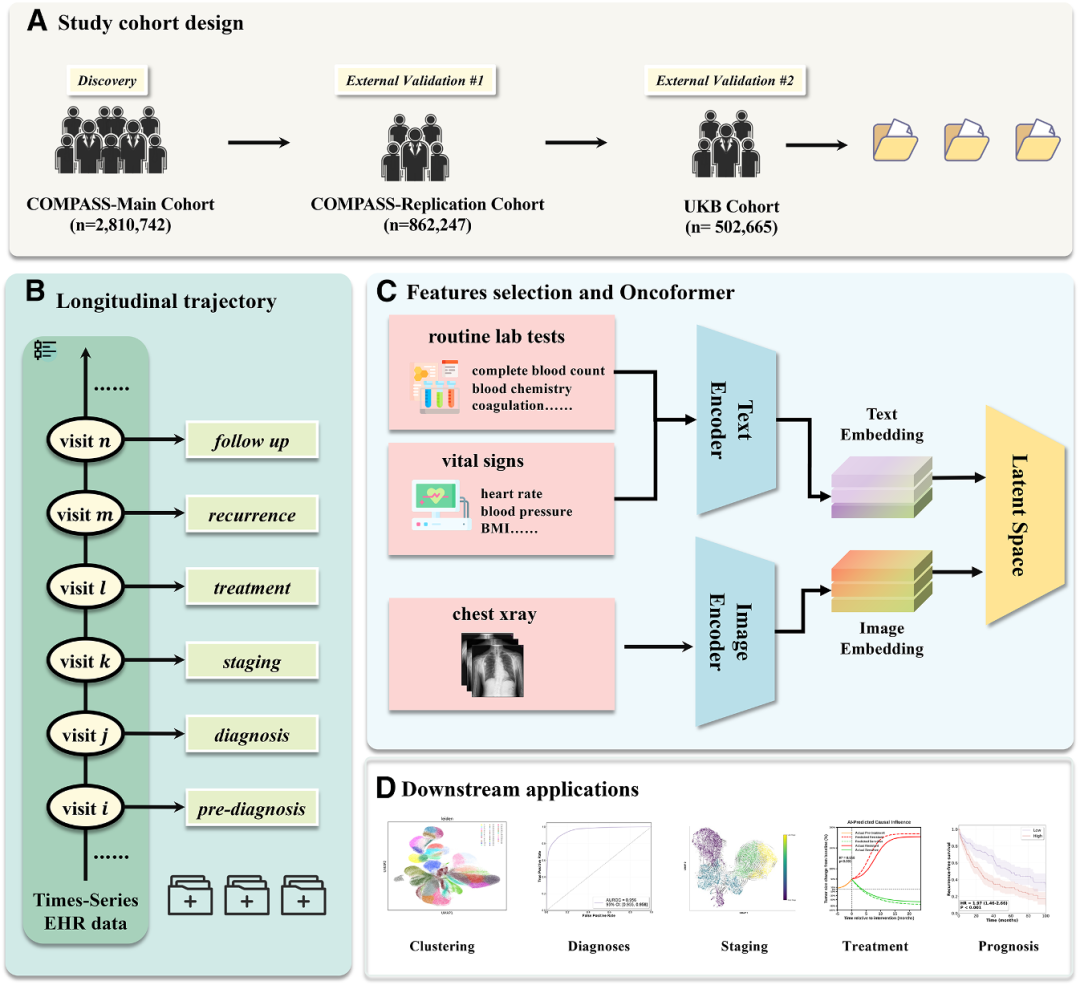
这里最关键的不是样本量本身,而是每位患者由多次临床访问组成。1775万次就诊使模型能看到疾病发生前后不断累积的时间信息。
实验室与胸片表征被对齐到同一患者空间
模型将常规检查和胸片分别编码,再映射到共同隐空间。作者展示了仅用实验室指标、仅用胸片及联合输入时,患者表征在隐空间中的对齐情况。
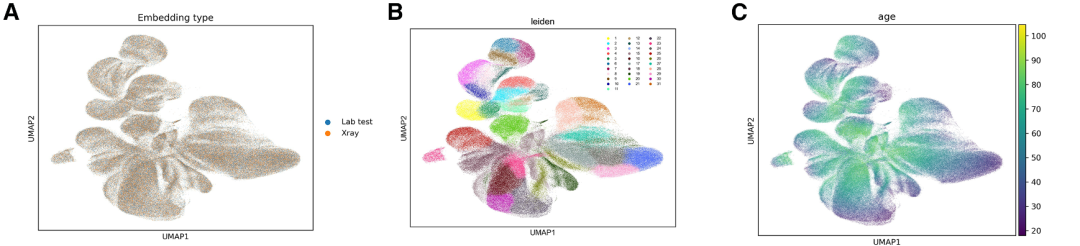
这一步避免了多模态模型常见的“两套特征各自有效、融合后却不可解释”的问题。共享表征为后续的诊断、分期和疗效任务提供了共同基础。
无监督患者亚群已携带癌种风险差异
在统一患者表征上进行Leiden聚类后,不同亚群与未来癌症风险存在关联。妇科肿瘤富集亚群倾向伴随乳腺癌和卵巢癌风险升高,消化系统肿瘤富集亚群则与胃癌、结直肠癌风险相关。
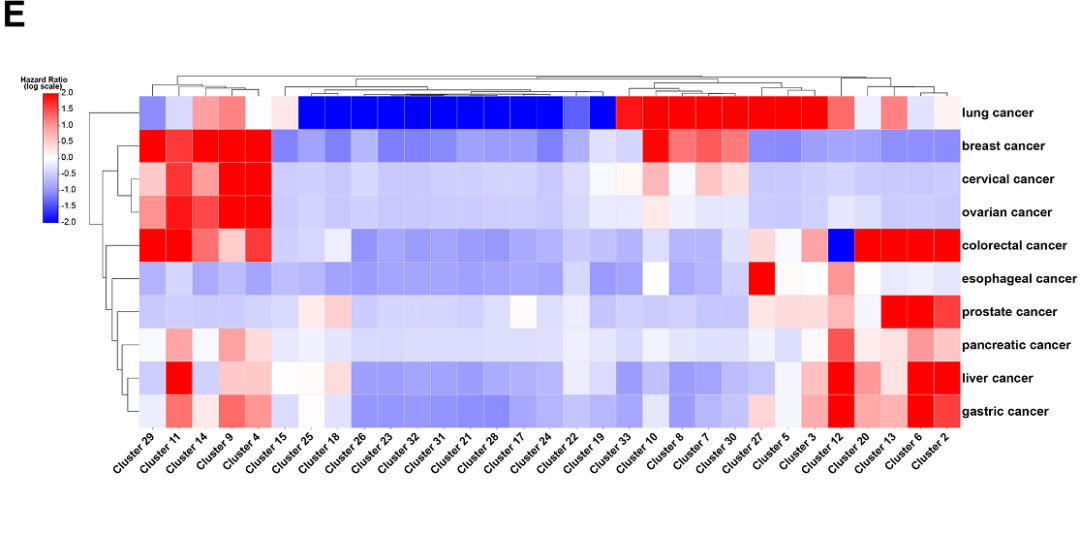
这说明模型并非只记住某个癌种标签,还在患者级隐空间中学习到跨癌种的系统性临床表型。不过,这仍属于风险关联,不应直接解释为特定癌种的病因机制。
就诊次数与病史长度决定诊断前预测能力
模型的表现随着可用就诊次数和纵向病史跨度增加而提升。泛癌诊断AUROC为0.956;在严格排除诊断前短期记录后,提前1年预测的AUROC为0.869。
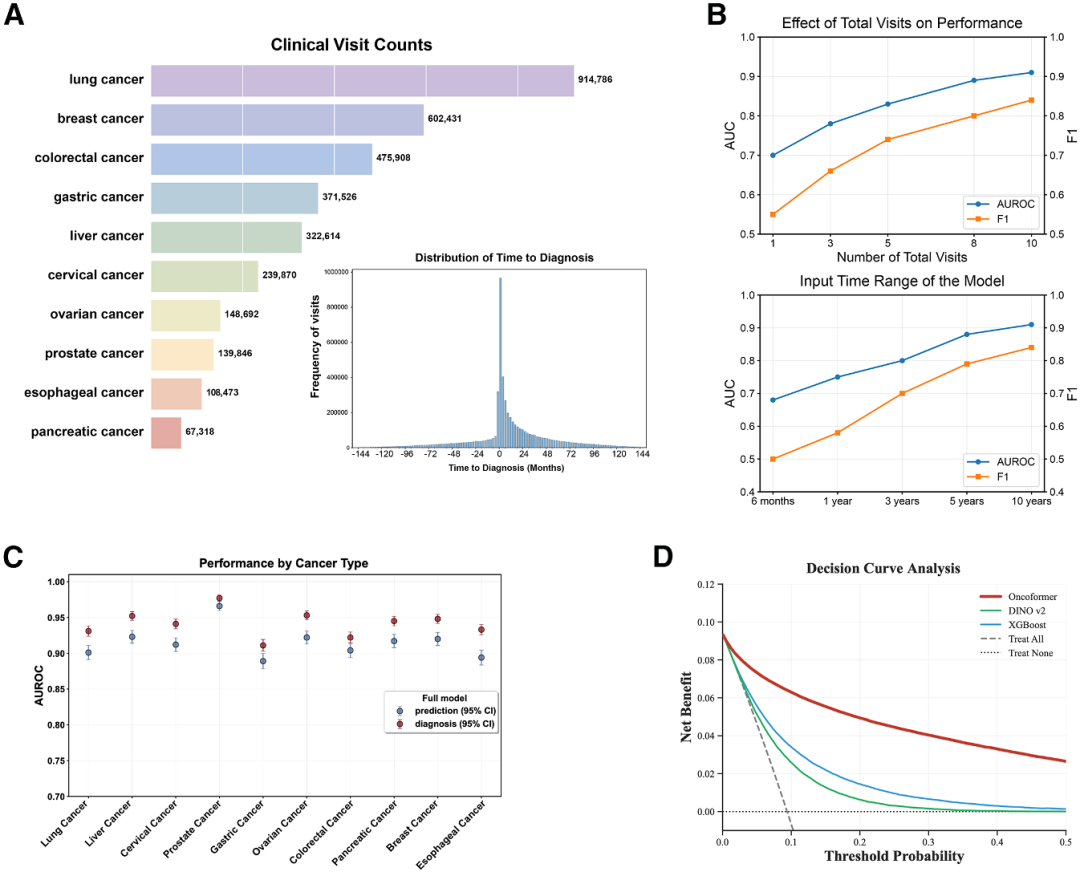
这个结果提示,模型利用的可能不只是确诊前最后一次异常检查。更长的随访轨迹能够帮助模型识别长期、微弱且跨指标的变化模式。
仅用诊断前常规数据也可推断肿瘤侵袭性
作者进一步只使用确诊前的数据预测临床TNM分期。多数癌种的总体分期预测AUROC超过0.90,并将患者的连续就诊轨迹投影为从健康状态到恶性状态的演进路径。
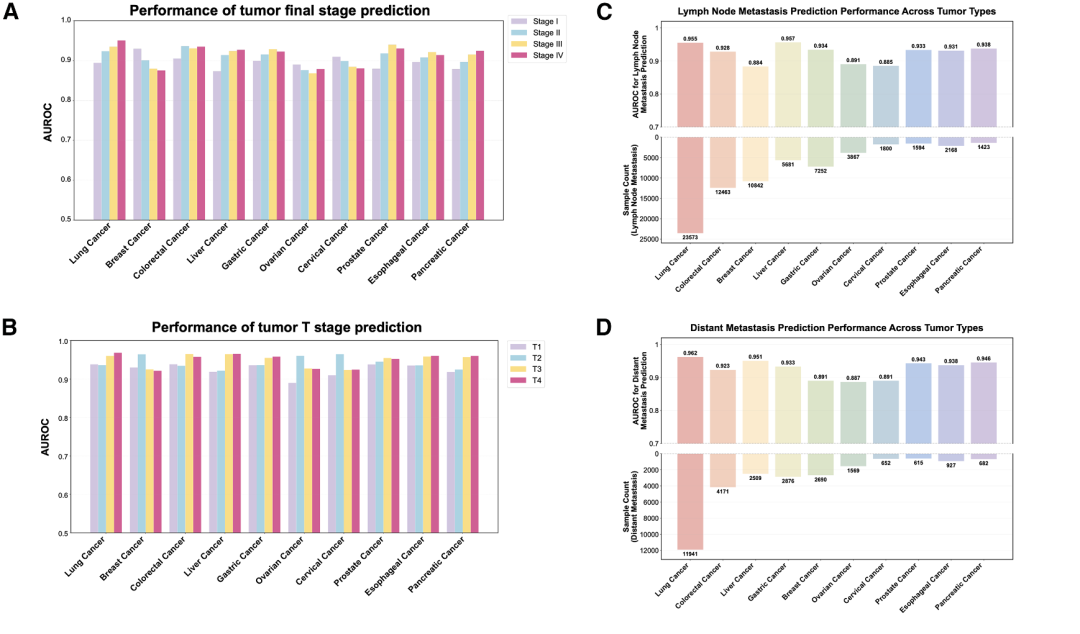
这部分适合被理解为诊断前侵袭性风险分层。它提供的是对未来临床分期的统计推断,不是用常规化验直接替代影像、内镜或病理分期。
病理和通路层面的独立对应增强了分期解释
分期预测分数与术后病理肿瘤大小、浸润深度、淋巴结负荷、脉管侵犯及既有病理分级存在关联。作者还将分期推断结果与肿瘤通路层面的突变负荷相对照。
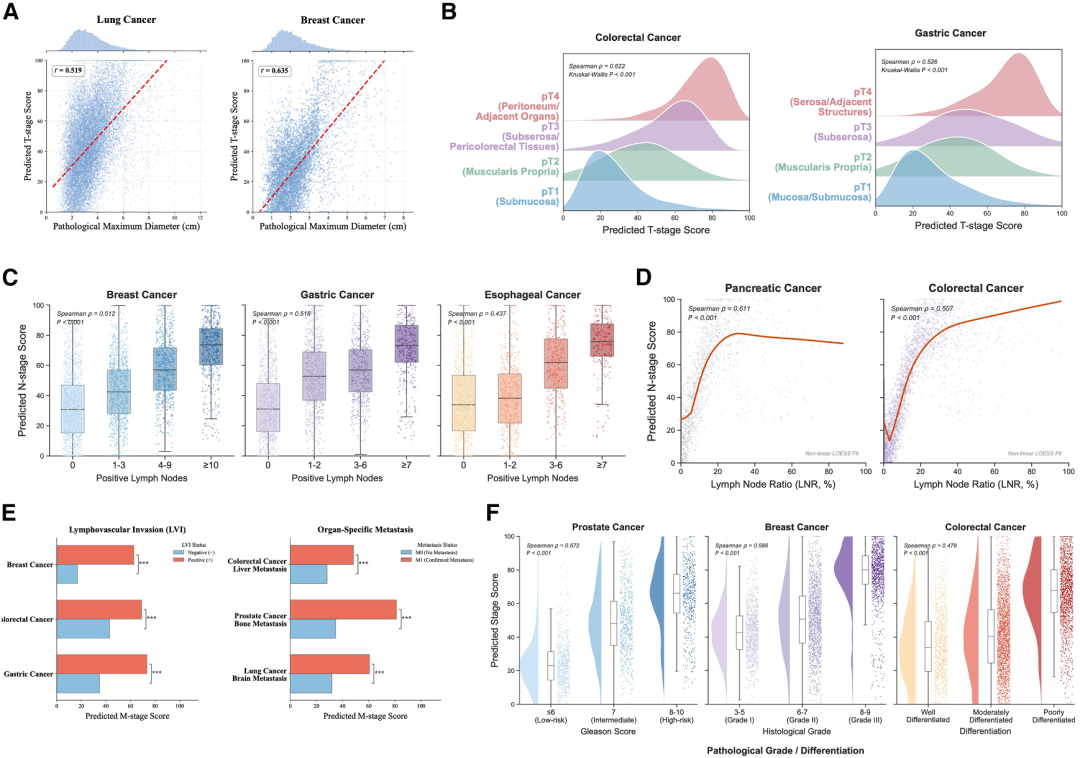
在通路层面,细胞周期、TP53和DNA损伤修复等程序与预测分期分数具有较高一致性。这一层验证使模型输出不再只是“高分或低分”,而是和肿瘤侵袭性相关表型形成了外部对应。
治疗前数据可预测不同方案下的反应轨迹
作者在非小细胞肺癌EGFR抑制剂、乳腺癌内分泌治疗、结直肠癌西妥昔单抗、前列腺癌雄激素剥夺、卵巢癌奥拉帕利和肝癌索拉非尼等场景中,预测治疗后的肿瘤负荷或血清标志物变化。
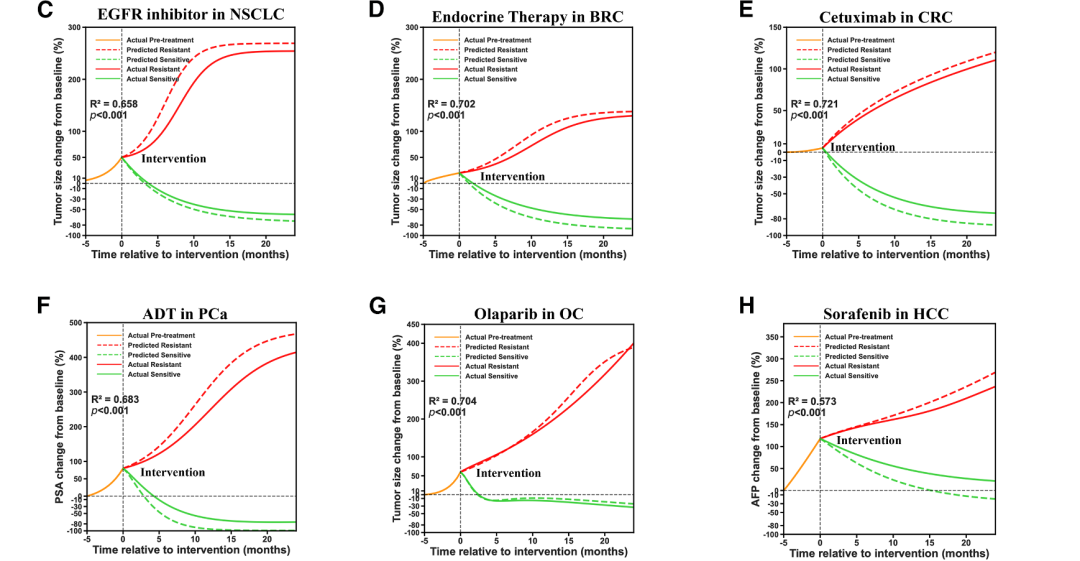
不同癌种-治疗组合的轨迹预测R2约为0.573-0.721。这里的临床定位应当是治疗前分层与随访辅助,而不是据此直接替代现有的疗效评估标准。
给做临床AI课题的启发
先把纵向结构做对。 很多EHR预测研究的最大问题不是模型浅,而是患者记录、就诊时间、诊断窗口和治疗起点没有严格对齐。Oncoformer的因果掩码给出了一条清晰原则:任意预测时点只能使用此前真实可见的信息。
缺失值不能只做插补。 在医院数据中,“有没有做某项检查”本身就与医生决策、病情严重度和医院流程有关。将缺失模式显式建模并进行对抗去偏,值得迁移到多中心临床队列中。
临床转化不只看AUROC。 这篇文章同时报告了校准、决策曲线、外部队列、术后病理对应和前瞻性筛查试点。对于真正面向投稿或落地的临床AI研究,患者级切分、时间泄漏控制、跨中心验证和临床终点验证比单一模型指标更重要。
可复现性需要如实表述。 官方GitHub开放了模型实现、简化checkpoint和790例演示数据;完整COMPASS数据并未直接公开。复用时可验证模型流程,但不能把演示数据的表现等同于论文规模结果。
总结
真正值得带走的是:Oncoformer把常规临床数据由一张张静态检查单,转成了能够随就诊持续更新的患者轨迹;其临床价值将取决于后续多中心、前瞻性研究能否证明这种轨迹确实改善筛查和治疗决策。
参考文献
Liu F, Wang K, Xu H, et al. Advancing cancer detection and treatment using longitudinal routine clinical data. Cell. 2026;189(19):5995-6011.e8. doi:10.1016/j.cell.2026.07.009.
- PubMed: https://pubmed.ncbi.nlm.nih.gov/42508404/
- 期刊页面: https://www.cell.com/cell/fulltext/S0092-8674(26)00807-X
- ScienceDirect: https://www.sciencedirect.com/science/article/pii/S009286742600807X
- Oncoformer代码: https://github.com/kaiwang13/Oncoformer
- UK Biobank: https://www.ukbiobank.ac.uk/