本文属于第三册“内核抽象:dma-mapping 接口的设计原则”,回答第 0 篇提出的问题 12:
- 一次 DMA 映射调用如何被分发至 direct、iommu、swiotlb 等不同后端
第 8 至 11 篇讨论的是驱动如何使用 dma-mapping 接口:映射契约的选择、所有权的交接、分散内存的表示与寻址能力的协商,立足点都是驱动可见的 API。这些调用在驱动看来形式各异,进入内核后却会收敛到同一套分发与后端代码。本篇转入接口背后的实现,说明一次映射调用从驱动入口到最终执行要经过哪些层次,以及内核据以在不同后端之间分发的依据。
本文首先给出 dma-mapping 子系统的分层结构;然后分析分发层选择后端的判断条件,以及 dma_map_ops 在当前内核中的地位;接着说明这些判断条件在设备初始化的哪些阶段建立;最后讨论 SWIOTLB 在这一结构中的位置。
1. 问题回顾
前几篇多次出现同一段分发代码:第 6 篇 §4 给出了 dma_map_phys() 选择直接映射或 IOMMU 的片段,第 8 篇 §3.2、第 9 篇 §4.2 与第 10 篇 §4 分别给出了分配、同步与 scatterlist 映射的分发。第 11 篇则表明,SWIOTLB 中转既可能发生在直接映射路径上,也可能发生在 IOMMU 路径上。
这些片段说明了“分发”的存在,但没有回答以下问题:驱动调用的接口与具体实现之间有几个层次;分发依据存储在何处,在何时设置;dma_map_ops 与直接映射、IOMMU 是什么关系;SWIOTLB 是否是一个独立的后端。
2. 分层结构
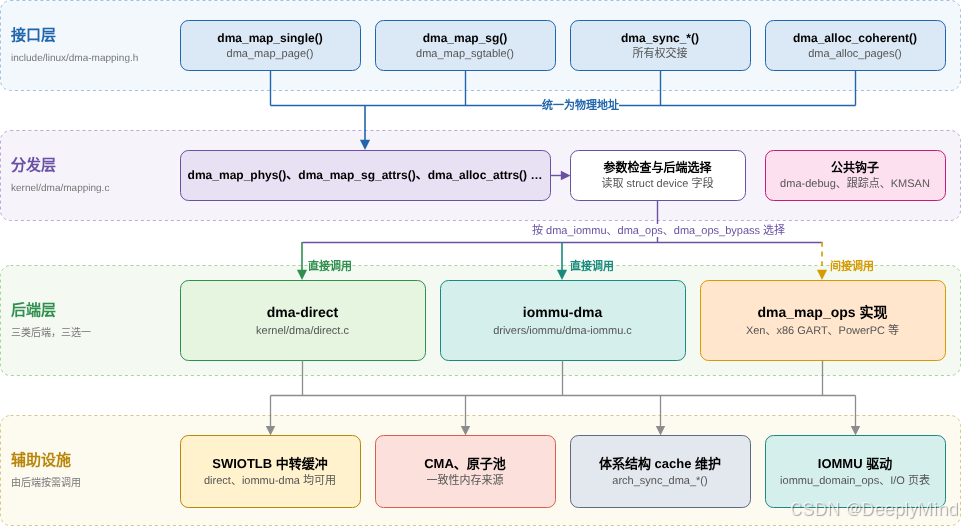
图 1: DMA 驱动的分层实现结构
2.1 接口层
驱动使用的接口定义在 include/linux/dma-mapping.h 中,多为内联函数,作用是将不同形式的参数统一为物理地址:
static inline dma_addr_t dma_map_single_attrs(struct device *dev, void *ptr,
size_t size, enum dma_data_direction dir, unsigned long attrs)
{
if (dev_WARN_ONCE(dev, is_vmalloc_addr(ptr),
"rejecting DMA map of vmalloc memory\\n"))
return DMA_MAPPING_ERROR;
debug_dma_map_single(dev, ptr, size);
return dma_map_page_attrs(dev, virt_to_page(ptr), offset_in_page(ptr),
size, dir, attrs);
}
dma_map_single() 将内核虚拟地址转换为页与页内偏移,dma_map_page_attrs() 再将其转换为物理地址,最终都进入 dma_map_phys()。scatterlist、同步与分配接口也各自汇聚到少数几个入口函数。调用形式的多样性由此被吸收在接口层:无论驱动传入的是虚拟地址、页加偏移还是 scatterlist,分发层与后端只需面对物理地址这一种输入,不必为每种调用形式各写一套处理逻辑。接口层只做“参数形式到物理地址”的轻量换算,将物理地址翻译为设备可用的 DMA 地址则留给后端(§2.3)。
2.2 分发层
入口函数位于 kernel/dma/mapping.c,承担三项工作:
- 检查参数,例如方向是否合法、设备是否设置了掩码;
- 选择后端;
- 调用与后端无关的公共钩子,包括 CONFIG_DMA_API_DEBUG 的检查、跟踪点与 KMSAN 的标记。公共钩子集中在分发层,因此无论设备使用哪个后端,调试检查都同样生效。
2.3 后端层
后端负责将物理地址转换为设备可用的 DMA 地址,并完成必要的 cache 维护。当前内核有三类后端:
- dma-direct(kernel/dma/direct.c):DMA 地址由物理地址按固定规则换算得到,用于未启用 IOMMU 或 IOMMU 处于直通模式的设备。
- iommu-dma(drivers/iommu/dma-iommu.c):分配 IOVA 并建立 I/O 页表,用于挂接到 DMA 类型 domain 的设备。
- dma_map_ops 的实现:由体系结构或虚拟化平台提供的一组回调,用于前两者无法覆盖的场景。
2.4 辅助设施
SWIOTLB、CMA 与原子内存池、设备专用的一致性内存区域、体系结构的 cache 维护函数以及 IOMMU 驱动都位于后端之下,由后端按需调用,分发层并不直接选择它们。
3. 后端的选择
3.1 判断条件
dma_map_phys() 的分发部分如下:
static bool dma_go_direct(struct device *dev, dma_addr_t mask,
const struct dma_map_ops *ops)
{
if (use_dma_iommu(dev))
return false;
if (likely(!ops))
return true;
#ifdef CONFIG_DMA_OPS_BYPASS
if (dev->dma_ops_bypass)
return min_not_zero(mask, dev->bus_dma_limit) >=
dma_direct_get_required_mask(dev);
#endif
return false;
}
...
if (dma_map_direct(dev, ops) || ...)
addr = dma_direct_map_phys(dev, phys, size, dir, attrs, true);
...
else if (use_dma_iommu(dev))
addr = iommu_dma_map_phys(dev, phys, size, dir, attrs);
else if (ops->map_phys)
addr = ops->map_phys(dev, phys, size, dir, attrs);
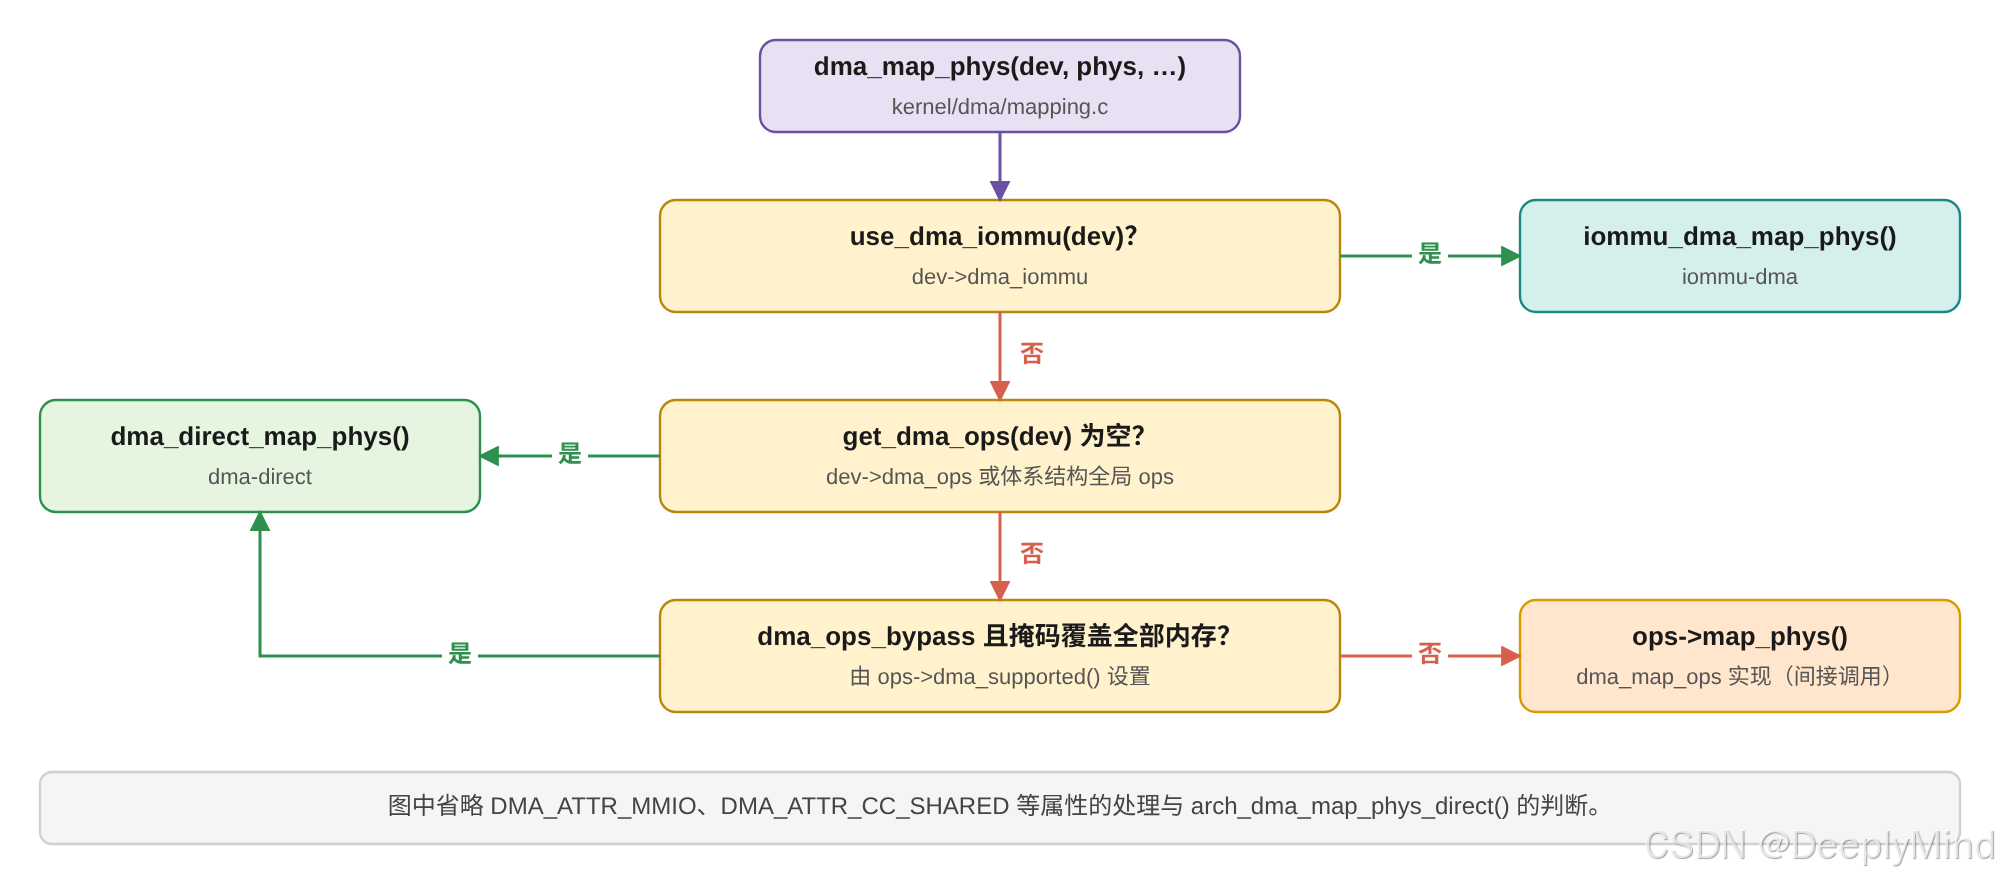
图 2: 后端选择逻辑
判断依据是 struct device 中的三项内容:
- dev->dma_iommu 为真时使用 iommu-dma;
- 否则,get_dma_ops() 返回空时使用 dma-direct;
- 返回非空时使用其回调,但若 ops 设置了 dma_ops_bypass 且掩码足以覆盖全部内存,仍使用 dma-direct。
dma_map_direct() 与 dma_alloc_direct() 分别以流式映射掩码与一致性分配掩码调用 dma_go_direct(),因此同一设备的映射与分配可能走不同的后端。
get_dma_ops() 的实现取决于配置:
#ifdef CONFIG_ARCH_HAS_DMA_OPS
static inline const struct dma_map_ops *get_dma_ops(struct device *dev)
{
if (dev->dma_ops)
return dev->dma_ops;
return get_arch_dma_ops();
}
#else
static inline const struct dma_map_ops *get_dma_ops(struct device *dev)
{
return NULL;
}
#endif
(include/linux/dma-map-ops.h,节选)
未选择 CONFIG_ARCH_HAS_DMA_OPS 的配置中,get_dma_ops() 恒为空,编译器可以删除 ops 分支,分发只剩直接映射与 IOMMU 两条路径。x86 仅在启用 AMD GART 或 Xen 时选择该选项,此时以全局变量 dma_ops 作为体系结构默认值。
3.2 dma_map_ops 的地位
struct dma_map_ops 包含分配、映射、scatterlist、同步与能力查询等回调,与驱动可见的接口一一对应。它曾是所有非直接映射路径的统一抽象,iommu-dma 也曾以一组 dma_map_ops 的形式接入。当前内核将 iommu-dma 改为由 dev->dma_iommu 标志选择、由分发层直接调用,与 dma-direct 的处理方式一致。这一改动消除了 IOMMU 路径上的间接调用开销,也使许多常见配置完全不再需要 dma_map_ops。
因此,dma_map_ops 现在只用于前两类后端无法覆盖的场景,在本文所用的内核树中,实现主要有以下几类:
| 虚拟化 | xen_swiotlb_dma_ops、xen_grant_dma_ops | Xen 客户机的物理地址不等于机器地址,或须经授权表共享内存 |
| 早期 IOMMU | x86 gart_dma_ops,PowerPC、SPARC、PA-RISC、Alpha 的 IOMMU | 尚未迁移到通用 IOMMU 框架的平台 |
| 特殊用途 | dma_dummy_ops | 固件声明设备不支持 DMA 时,使所有映射失败 |
驱动不应直接使用 dma_map_ops:头文件 dma-map-ops.h 开头即说明它只供后端实现及相关代码包含。
3.3 绕过 ops
部分平台的 IOMMU 可以为设备提供覆盖全部物理内存的直通窗口或固定映射,掩码足够宽的设备因而可以绕过 IOMMU 的逐次映射。PowerPC 的 dma_iommu_dma_supported() 在驱动设置掩码时检查这一能力,满足时将 dev->dma_ops_bypass 置为真,此后该设备的映射走 dma-direct。这说明 dma_set_mask() 的结果可以改变分发路径,第 11 篇 §2.2 中 dma_set_mask() 末尾调用 dma_setup_need_sync(),正是为了按新的路径重新判断同步能否跳过。
4. 分发依据的建立
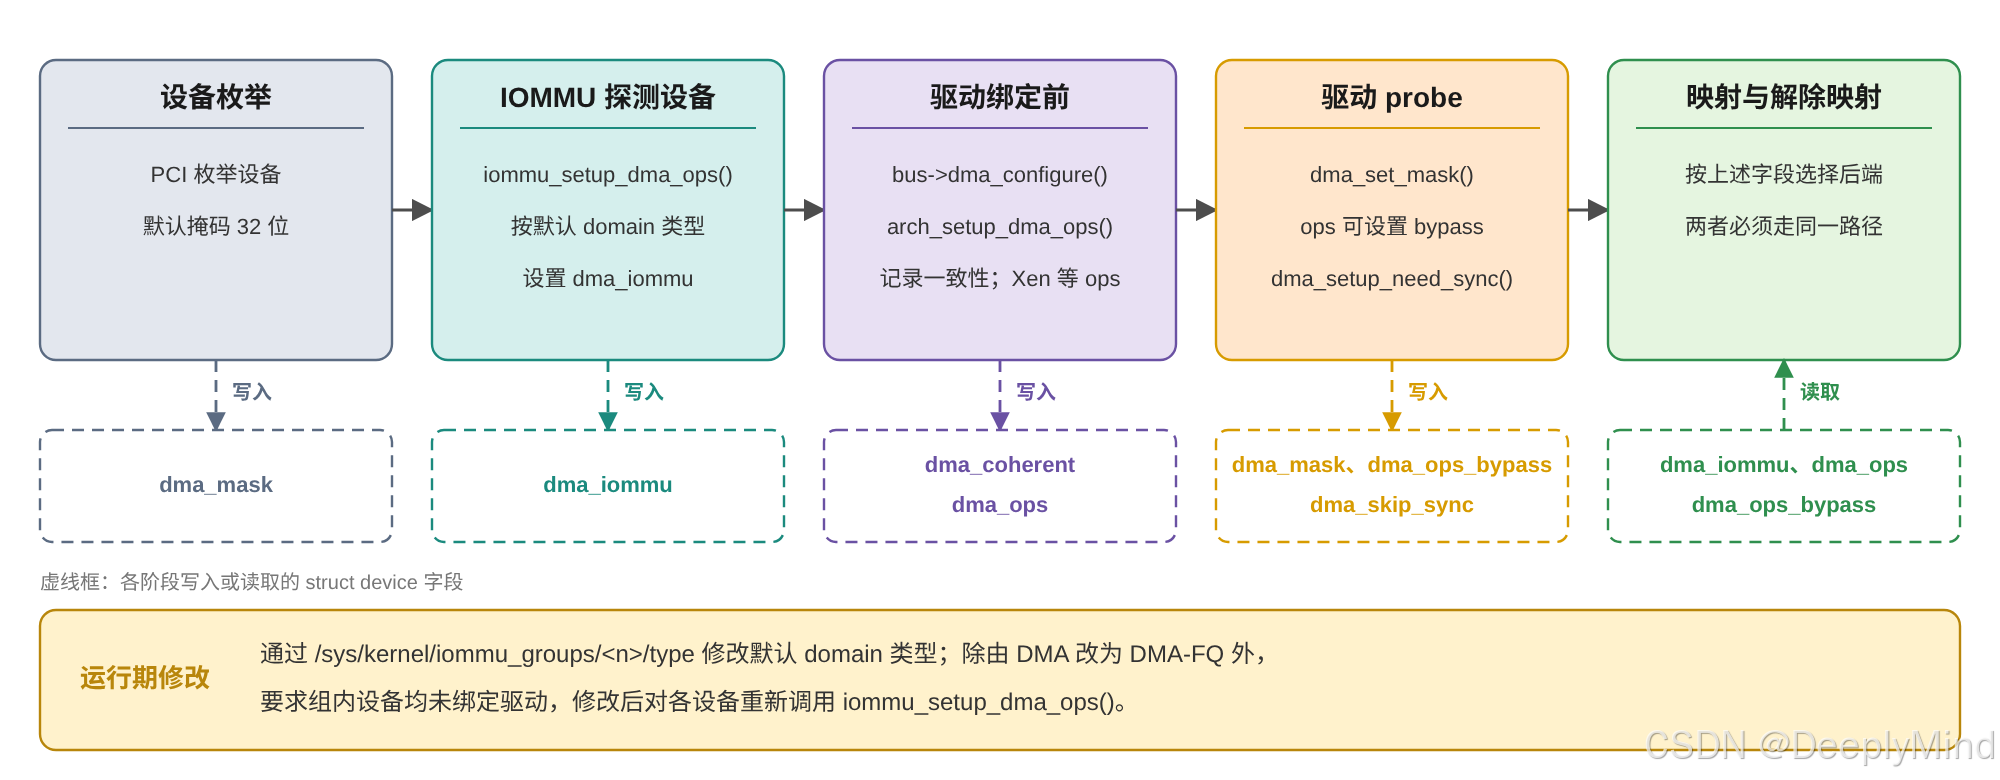
图 3: 判断分发依据
分发依据在驱动开始映射之前已经确定,各项在以下阶段设置:
IOMMU 探测设备时。 IOMMU 核心为设备所在的组确定默认 domain 后,调用:
void iommu_setup_dma_ops(struct device *dev, struct iommu_domain *domain)
{
if (dev_is_pci(dev))
dev->iommu->pci_32bit_workaround = !iommu_dma_forcedac;
dev->dma_iommu = iommu_is_dma_domain(domain);
if (dev->dma_iommu && iommu_dma_init_domain(domain, dev))
goto out_err;
return;
out_err:
pr_warn("Failed to set up IOMMU for device %s; retaining platform DMA ops\\n",
dev_name(dev));
dev->dma_iommu = false;
}
只有 DMA 与 DMA-FQ 类型的 domain 使 dma_iommu 为真;IDENTITY 类型(第 6 篇 §5.1)使其为假,设备随即走直接映射。初始化失败时同样回退到直接映射或平台的 ops。
驱动绑定之前。 驱动核心在调用驱动的 probe 函数之前调用总线的 dma_configure 回调。PCI 总线的实现 pci_dma_configure() 按主桥的固件描述调用 of_dma_configure() 或 acpi_dma_configure(),后者处理 IOMMU 的关联,并调用 arch_setup_dma_ops() 记录设备是否一致;arm64 在此为 Xen 客户机安装 Xen 的 ops。ACPI 声明设备不支持 DMA 时,设备被设置为 dma_dummy_ops。
驱动 probe 时。 驱动设置掩码,ops 可能借此设置绕过标志(§3.3),dma_setup_need_sync() 按最终路径设置 dma_skip_sync。
映射与解除映射必须走同一后端,否则解除映射时无法找到对应的 IOVA 或 SWIOTLB 槽位。因此分发依据在驱动工作期间不应改变。管理员可以通过 /sys/kernel/iommu_groups/<n>/type 修改组的默认 domain 类型,但除了从 DMA 改为 DMA-FQ 以外,内核要求组内设备均未绑定驱动,修改后再对各设备重新调用 iommu_setup_dma_ops()。
5. SWIOTLB 的位置
问题 12 将 swiotlb 与 direct、iommu 并列,但在分发层面,SWIOTLB 并不是一个独立的后端:
- dma-direct 在地址超出掩码、平台强制中转或 kmalloc 缓冲区不满足 cache 行对齐要求时调用 swiotlb_map();
- iommu-dma 在不受信任的设备或需要对齐的 kmalloc 小缓冲区映射未对齐 IOMMU 页的区域时调用 iommu_dma_map_swiotlb();
- Xen 的 xen_swiotlb_dma_ops 是一组以 SWIOTLB 为核心的 ops,但它作为 dma_map_ops 被选择,而非因为 SWIOTLB。
if (dev_use_swiotlb(dev, size, dir) &&
iova_unaligned(iovad, phys, size)) {
...
phys = iommu_dma_map_swiotlb(dev, phys, size, dir, attrs);
...
}
...
iova = __iommu_dma_map(dev, phys, size, prot, dma_mask);
将 SWIOTLB 设计为后端可调用的设施,而不是与之并列的后端,原因在于中转与地址翻译相互独立:数据先复制到中转缓冲区,中转缓冲区的地址再按后端的规则转换为 DMA 地址,可以直接使用物理地址,也可以再经 IOMMU 翻译。若作为独立后端,就无法与 IOMMU 组合使用。
6. 常见误区
6.1 认为启用 IOMMU 硬件后所有设备都走 iommu-dma
决定后端的是设备所在组的默认 domain 类型,而非 IOMMU 是否存在。以 iommu.passthrough=1 或 iommu=pt 启动,或将组设为 IDENTITY 时,设备走直接映射;VFIO 等声明 driver_managed_dma 的驱动绑定后,pci_dma_configure() 不再为设备启用默认 domain,设备的地址空间由驱动自行管理。
6.2 认为 dma_map_ops 是所有 DMA 映射的必经之路
在 x86 与 arm64 的常见配置中,设备通常没有 ops,映射由分发层直接调用 dma-direct 或 iommu-dma。以 ops 作为分析的起点,会在这些平台上找不到实际执行的代码。
6.3 在驱动中直接调用后端函数
dma_direct_map_phys()、iommu_dma_map_phys() 等函数假设调用者已经完成路径选择,绕过分发层也会绕过调试检查与跟踪点。驱动应只使用 dma-mapping.h 中的接口;需要了解后端的能力时,使用 dma_get_merge_boundary()、dma_max_mapping_size() 等查询接口。
7. 小结
本文回答了问题 12,要点如下:
- dma-mapping 分为四层。 接口层将参数统一为物理地址;分发层检查参数、选择后端并调用公共钩子;后端层由 dma-direct、iommu-dma 与 dma_map_ops 的实现组成;SWIOTLB、CMA、cache 维护与 IOMMU 驱动作为辅助设施由后端调用。
- 分发依据存储在 struct device 中。 dma_iommu 为真时使用 iommu-dma;否则无 ops 时使用 dma-direct;有 ops 时调用其回调,设置了绕过标志且掩码足够宽时仍使用 dma-direct。
- dma_map_ops 已退居次要地位。 iommu-dma 改为由分发层直接调用,ops 主要服务于 Xen 与尚未迁移的早期 IOMMU。
- 分发依据在驱动开始映射之前确定。 IOMMU 探测、总线的 dma_configure 与驱动设置掩码依次建立这些字段;映射与解除映射必须走同一后端,因此驱动工作期间不改变。
- SWIOTLB 是辅助设施而非后端。 它由 dma-direct 与 iommu-dma 按需调用,因而可以与地址翻译组合使用。
至此,第三册讨论的都是单个驱动与单个设备之间的映射。相机采集的帧需要交给 GPU 处理、再交给编码器压缩时,同一块内存须同时被多个驱动映射给各自的设备。不同设备如何以零拷贝方式共享同一块内存,即为问题 13。
系列导航:
- 上一篇《第 11 篇 DMA 掩码与寻址能力协商:dma_set_mask 与 SWIOTLB》
- 下一篇《第 13 篇 DMA-BUF:跨驱动、跨设备的缓冲区共享》