摘要:本篇聚焦 InnoDB 锁与事务核心机制,系统讲解了各种锁机制,解析脏读、不可重复读等并发问题及应对方案。同时深入剖析事务 ACID 特性的底层实现(Redo Log、Undo Log)、隔离级别差异。
第六章 锁
6.3 InnoDB 存储引擎中的锁
6.3.1 S和X锁
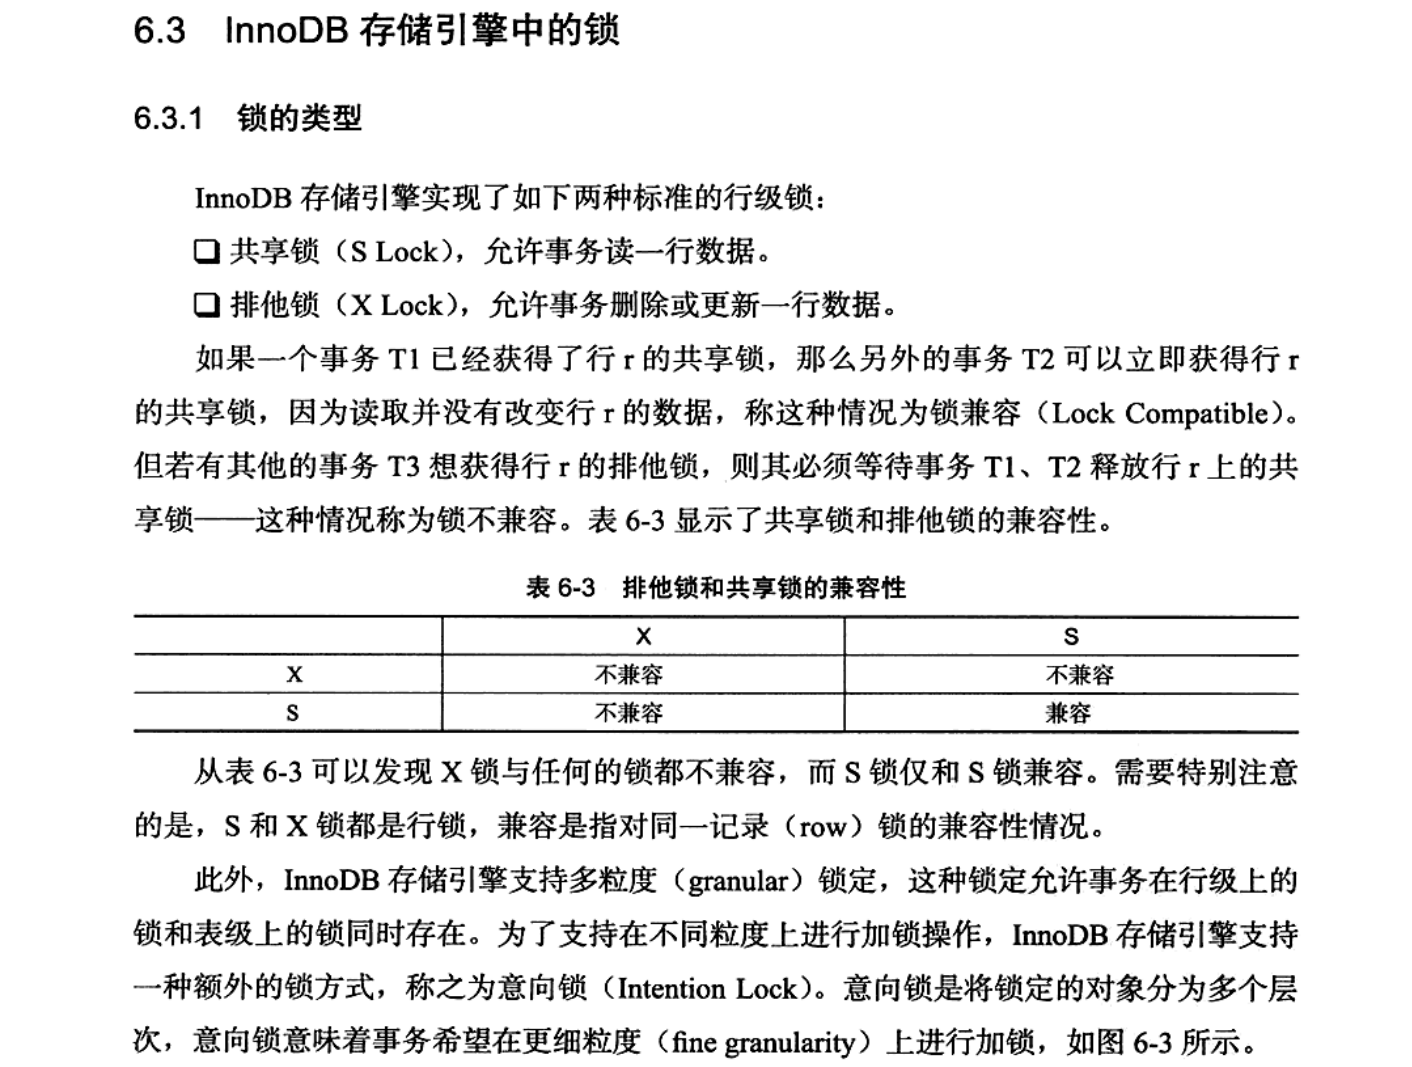
意向锁是 InnoDB 为支持多粒度锁而设计的一种 "预告性" 锁机制。它的核心作用是在不同粒度的锁之间建立协作关系,避免冲突,从而提升并发性能。
简单来说,当事务需要对某一行(细粒度)加锁时,会先在表(粗粒度)层面加上意向锁,就像提前 "打个招呼",告诉其他事务:"我准备在这张表里的某一行加锁了"。
它的主要作用体现在两点:
避免锁冲突,提升并发效率:
意向锁让数据库可以快速判断 "表级锁" 和 "行级锁" 是否冲突。例如,当一个事务想给整张表加排他锁时,只要检查表上是否存在意向锁,就能立刻知道是否有其他事务正在操作表中的行,不用逐行去检查,大幅提升了锁判断的效率。
支持多粒度锁共存:
意向锁让表锁和行锁可以安全地共存,满足不同业务场景的需求。如一个事务可以对表加意向锁,同时对行加行锁;另一个事务也可以对表加意向锁,对其他行加行锁,实现更细粒度的并发控制。
常见的意向锁有两种:意向共享锁(IS)和意向排他锁(IX)。当事务要对行加共享锁(S 锁)时,会先加 IS 锁;要对行加排他锁(X 锁)时,会先加 IX 锁。
6.3.2 一致性非锁定读
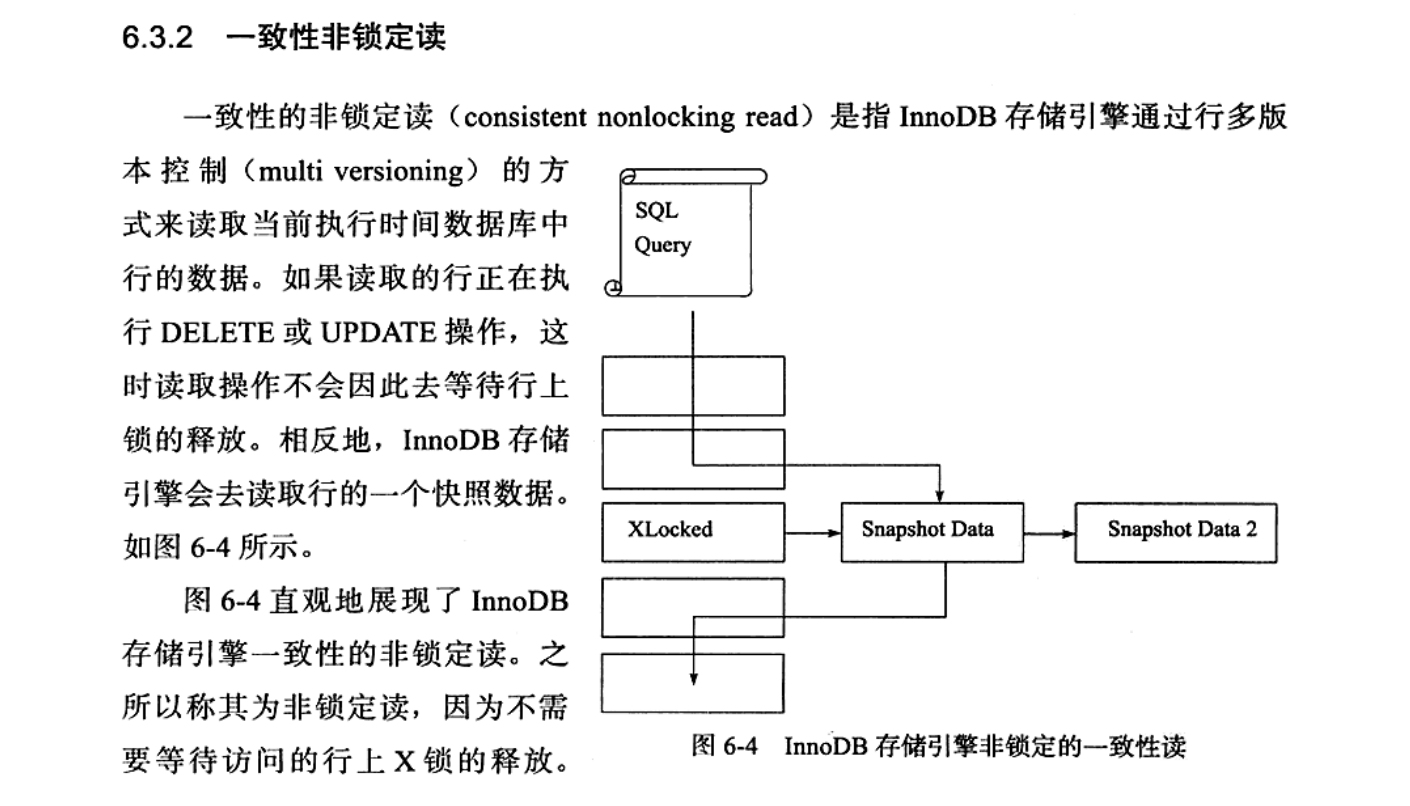
前提:
为什么加了 X 锁还能读?
-
锁的作用对象不同:X 锁是加在当前正在修改的数据行上的,用来阻止其他事务对这一行做写操作(如 UPDATE/DELETE),也阻止加 S 锁。但 InnoDB 的一致性非锁定读,读的并不是这个被 X 锁锁住的 "当前行",而是从回滚段(Undo Log)里读取这一行的历史快照版本。这个历史版本本身没有被加任何锁,所以可以直接读取。
-
MVCC 的核心思想:它通过为每行数据维护多个历史版本,让读操作可以 "绕开" 被锁住的当前行,去读历史快照,从而实现了 "读写不阻塞"。
读的时候不加读锁吗?
这要分两种读场景来看:
-
一致性非锁定读(默认读)也就是普通的 SELECT 语句,InnoDB 默认不会加任何读锁(S 锁),而是直接读取快照数据。这是 InnoDB 默认的读方式,目的就是为了提升并发性能。
-
锁定读(显式加读锁)如果你用 SELECT … FOR SHARE 或 SELECT … FOR UPDATE 这类语句,InnoDB 就会对读取的行加 S 锁或 X 锁,这时候才会和其他锁产生互斥。这种场景一般用于需要保证 “读 – 写” 原子性的业务逻辑。
一致性非锁定读是 InnoDB 实现高并发读的核心机制,它通过行多版本控制(Multi-Versioning)来避免读操作被写操作阻塞。
工作原理
无锁读机制:当读取的数据行正在被执行 DELETE 或 UPDATE 操作时,读操作不会等待行上的排他锁(X 锁)释放,而是直接读取该行的历史快照数据。
快照数据来源:这些快照数据存储在 InnoDB 的回滚段(Undo Log)中,是数据修改前的版本,保证了读操作的一致性和非阻塞性。
隔离级别关联:
在 READ COMMITTED 隔离级别下,每次读取都会获取最新的快照;
在 REPEATABLE READ(InnoDB 默认)隔离级别下,整个事务内只会在第一次读时获取快照,后续读操作都基于同一个快照,避免了不可重复读问题。
主要作用
提升并发性能:读写操作不再互相阻塞,读操作无需等待写锁释放,写操作也无需等待读锁释放,大幅提升了数据库的并发处理能力。
保证数据一致性:通过多版本快照,确保读操作能看到符合事务隔离级别的一致数据,避免了脏读。
MVCC(Multi-Version Concurrency Control,多版本并发控制)是 InnoDB 实现高并发读写的核心技术,它通过为数据行维护多个历史版本,让读写操作可以互不阻塞,同时保证事务的隔离性。
核心原理
多版本存储:InnoDB 会为每一行数据保存多个历史版本,这些版本存储在回滚段(Undo Log)中。每次对数据进行 UPDATE 或 DELETE 时,旧版本不会立即删除,而是被保留下来作为快照。
版本可见性判断:每个事务在启动时会获得一个唯一的事务 ID(Transaction ID)。当事务读取数据时,InnoDB 会根据事务的隔离级别,判断哪个历史版本对当前事务是可见的。例如在 REPEATABLE READ 级别下,事务只会看到启动时已提交的数据版本。
读写不阻塞:写操作(UPDATE/DELETE)会对当前数据行加锁,但读操作可以直接读取历史快照,无需等待锁释放。这就避免了传统锁机制中 "读写互斥" 的问题,大幅提升了并发性能。
关键作用
-
提升并发性能:读写操作不再互相阻塞,读无需等写,写也无需等读。
-
保证事务隔离性:通过版本可见性规则,实现了 READ COMMITTED 和 REPEATABLE READ 隔离级别,避免了脏读、不可重复读等问题。
-
避免幻读:在默认的 REPEATABLE READ 级别下,MVCC 配合间隙锁可以有效防止幻读。
6.3.3 一致性锁定度读
一致性锁定读是 InnoDB 提供的一种显式加锁的读取方式,用于在需要保证 "读 – 写" 原子性的场景中,通过加锁来确保数据逻辑的一致性。它和默认的一致性非锁定读相对,是一种主动加锁的读操作。
两种锁定读的具体行为
| 语句类型 | 加锁类型 | 作用与互斥规则 | 典型应用场景 |
| SELECT … FOR UPDATE | 排他锁 | 对读取的行加 X 锁,阻止其他事务对这些行加任何锁,也阻止其他事务修改这些行。 | 读取数据后要立即进行更新操作,比如扣减库存、转账等,防止数据在读取和修改之间被其他事务篡改。 |
| SELECT … LOCK IN SHARE MODE | 共享锁 | 对读取的行加 S 锁,允许其他事务加 S 锁,但阻止其他事务加 X 锁。 | 多个事务需要共同读取同一数据且不希望被修改的场景,比如查询商品当前库存并确保在事务期间不被修改。 |
关键注意事项
必须在事务中执行:这两种锁定读语句必须在事务(BEGIN/START TRANSACTION 或关闭自动提交 SET AUTOCOMMIT=0)中执行,锁会在事务提交或回滚后释放。
与非锁定读的兼容性:即使某行被 SELECT … FOR UPDATE 加了 X 锁,其他事务依然可以通过一致性非锁定读读取该行的历史快照,不会被阻塞。
隔离级别关联:在默认的 REPEATABLE READ 隔离级别下,锁定读的行为会配合间隙锁等机制,进一步防止幻读。
6.4 行锁的3种类型
InnoDB 提供了三种核心的行锁算法,以实现不同粒度的并发控制。
Record Lock :最基础的行锁,它会对索引上的单个行记录进行锁定,仅作用于目标行;若表没有显式索引,InnoDB 会使用隐式主键索引来完成锁定,典型场景是精准更新或锁定某一行数据,例如执行 SELECT * FROM t WHERE id=10 FOR UPDATE 时,就会对 id=10 的行加 Record Lock。
Gap Lock:主要是为了防止插入型幻读,它会锁定一个索引范围但不包含边界记录本身,目的是阻止其他事务在该间隙中插入新数据。比如表中已有 id=5, 10, 15,执行 SELECT * FROM t WHERE id BETWEEN 5 AND 15 FOR UPDATE 时,会对 (5,10) 和 (10,15) 这两个间隙加 Gap Lock,避免插入 id=7 或 12 这类新数据。
Next-Key Lock: Record Lock 与 Gap Lock 的组合,既锁定索引范围,也锁定范围边界的记录本身,是 InnoDB 在可重复读隔离级别下的默认行锁算法,可彻底防止幻读(防止插入型幻读和修改型幻读)。例如上述相同的范围查询,Next-Key Lock 会锁住 (5,10] 和 (10,15] 两个区间,既锁定了现有记录,也阻止了间隙插入新数据。
6.5 锁问题
6.5.1 脏读
脏读的定义与危害
-
定义:一个事务读取到另一个事务尚未提交的数据(即脏数据),这就是脏读。
-
危害:脏读会破坏数据库的隔离性,导致读取到的数据可能被回滚,从而引发业务逻辑错误。例如:事务 A 修改了用户余额但未提交,事务 B 读取到这个未提交的余额并执行了扣款操作,之后事务 A 回滚,事务 B 的扣款就会基于错误的数据。
如何避免脏读
脏读可以通过设置合适的事务隔离级别来避免:
-
在 READ COMMITTED 及更严格的隔离级别(REPEATABLE READ、SERIALIZABLE)下,InnoDB 会通过 MVCC 或锁机制,确保事务只能读取到已提交的数据,从而避免脏读。
6.5.2 不可重复读
不可重复读是数据库并发场景下的典型问题,指在同一个事务内,多次读取同一数据时,由于其他已提交事务的修改,导致前后两次读取结果不一致的现象。
不可重复读与脏读的关键区别
| 问题类型 | 读取的数据状态 | 核心差异 |
| 脏读 | 读取到其他事务未提交的数据 | 数据是未确认的中间态,可能被回滚 |
| 不可重复读 | 读取到其他事务已提交的数据 | 数据是已确认的终态,但破坏了当前事务的一致性 |
不可重复读的危害
它违反了事务的一致性要求。在同一个事务内,业务逻辑依赖的同一数据发生变化,会导致计算或判断结果出现偏差。例如:
事务 A 第一次读取商品库存为 100 件。
事务 B 修改库存为 50 件并提交。
事务 A 再次读取库存时发现变为 50 件,这会导致基于第一次读取结果的下单逻辑出现错误。
如何避免不可重复读
在 InnoDB 中,可以通过事务隔离级别来解决:
-
REPEATABLE READ(InnoDB 默认级别):通过 MVCC 机制,事务在启动时会获取一个数据快照,整个事务期间都基于该快照读取,从而保证同一事务内多次读取结果一致。
-
SERIALIZABLE:通过强制加锁实现完全串行化,彻底避免不可重复读,但会大幅降低并发性能。
6.5.3 丢失更新
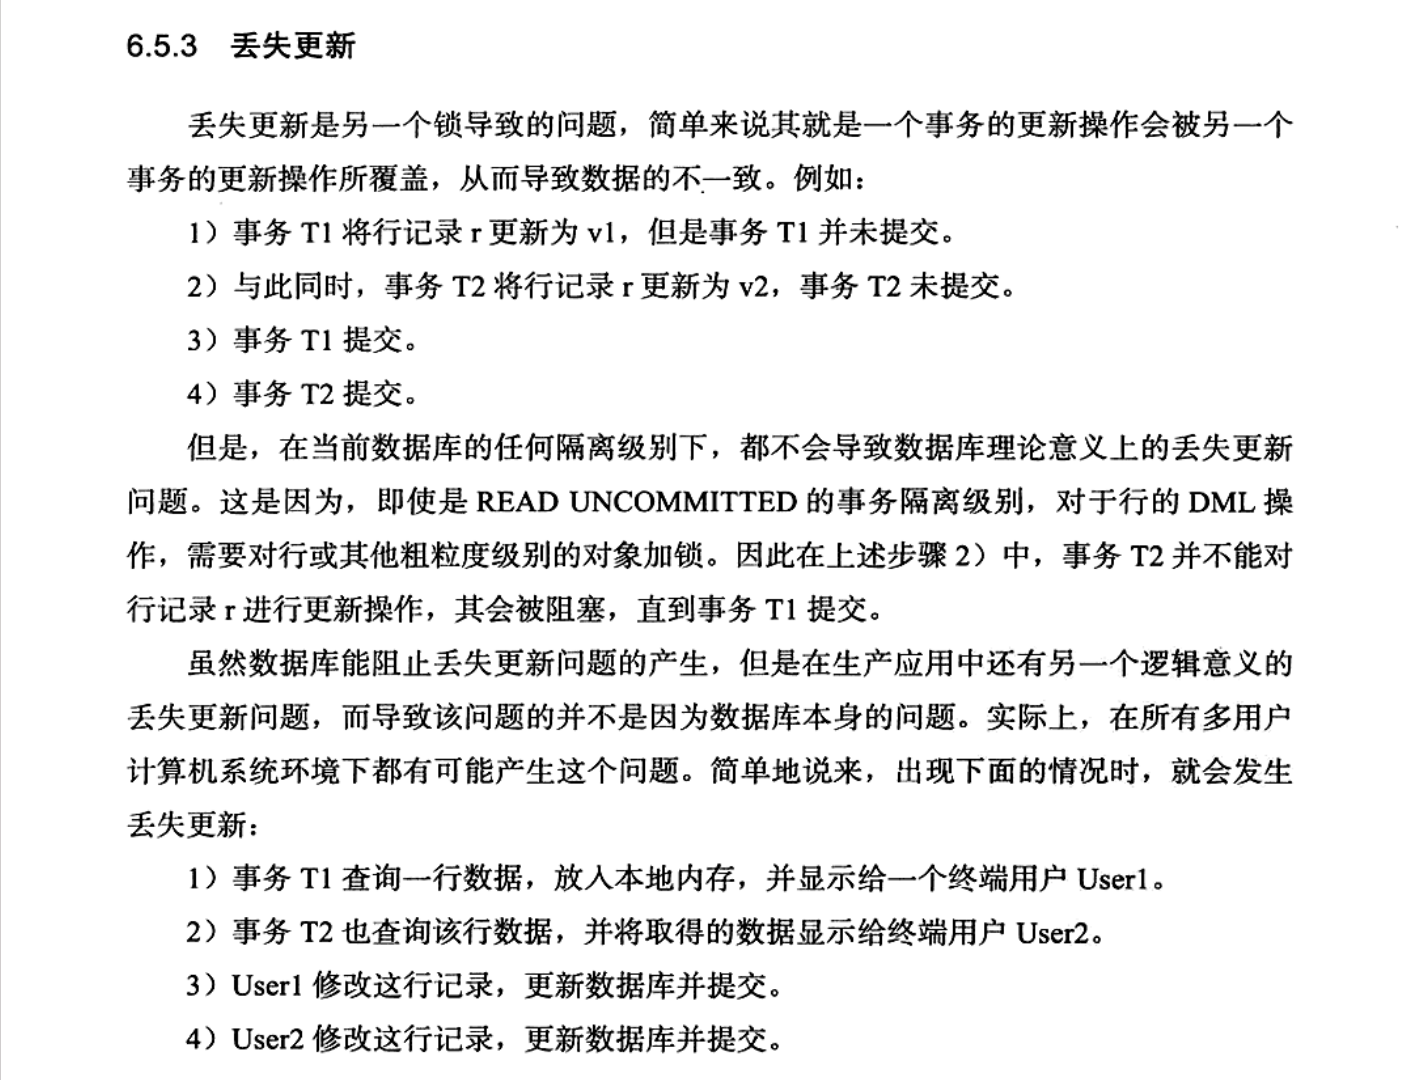
丢失更新是指一个事务的更新操作被另一个事务的更新覆盖,导致数据不一致的问题,它分为数据库理论意义上的丢失更新和逻辑意义上的丢失更新两类。
数据库理论意义上的丢失更新
-
发生场景:两个事务同时对同一行数据执行更新操作,后提交的事务覆盖先提交事务的修改。
-
数据库的防护机制:在任何隔离级别下,InnoDB 都会通过行锁(X 锁)来阻止这类问题。当事务 T1 对行加 X 锁后,事务 T2 的更新操作会被阻塞,直到 T1 提交或回滚,因此理论上的丢失更新不会发生。
逻辑意义上的丢失更新
-
发生场景:这是生产中更常见的问题,源于 "读取 – 修改 – 提交" 的业务流程存在时间差:
-
事务 T1 和 T2 先后读取同一行数据到本地内存。
-
用户 1 基于 T1 的数据修改并提交。
-
用户 2 基于 T2 的旧数据修改并提交,覆盖了用户 1 的更新。
-
-
本质原因:这类问题不是数据库锁机制能直接解决的,因为读取操作默认是无锁的,两个事务都能读到初始数据,最终导致后提交的修改覆盖了先提交的内容。
如何解决逻辑意义上的丢失更新
-
使用锁定读:在读取数据时用 SELECT … FOR UPDATE 加 X 锁,确保在修改前独占该行数据,阻止其他事务读取和修改。
-
乐观锁:在表中增加版本号或时间戳字段,更新时校验版本号,例如:
UPDATE t SET value = new_value, version = version + 1 WHERE id = ? AND version = old_version
-
如果版本号不匹配,说明数据已被其他事务修改,需要重新读取并尝试更新。
6.8 锁升级
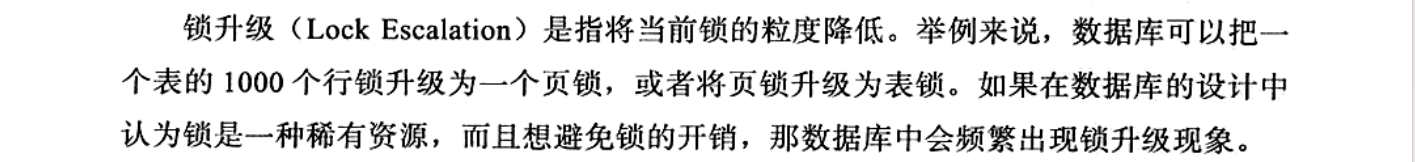
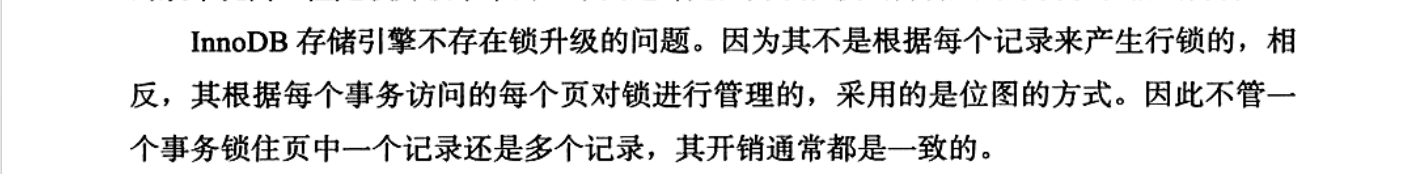
这段内容解释了 InnoDB 为什么不存在锁升级(Lock Escalation)问题,这是它与其他数据库(如 MySQL 的 MyISAM、SQL Server)的一个重要区别。
什么是锁升级?
锁升级是指当一个事务在同一对象上持有大量细粒度锁(如行锁)时,数据库为了降低锁的管理开销,会自动将这些细粒度锁升级为粗粒度锁(如表锁)。这虽然减少了锁的管理成本,但会大幅降低并发性能,因为表锁会阻塞其他事务对整个表的操作。
InnoDB 为什么没有锁升级?
-
锁的管理方式不同:InnoDB 不是为每一行记录单独维护锁,而是以数据页(Page)为单位,用位图(Bitmap)来管理锁。
-
开销一致:无论一个事务在一个数据页中锁住 1 条记录还是 100 条记录,InnoDB 只需要修改该页对应的位图标记,锁的管理开销是一致的。
-
因此,InnoDB 没有必要通过锁升级来降低开销,行锁可以一直保持细粒度,从而保证了高并发性能。
第七章 事务
7.1 认识事务
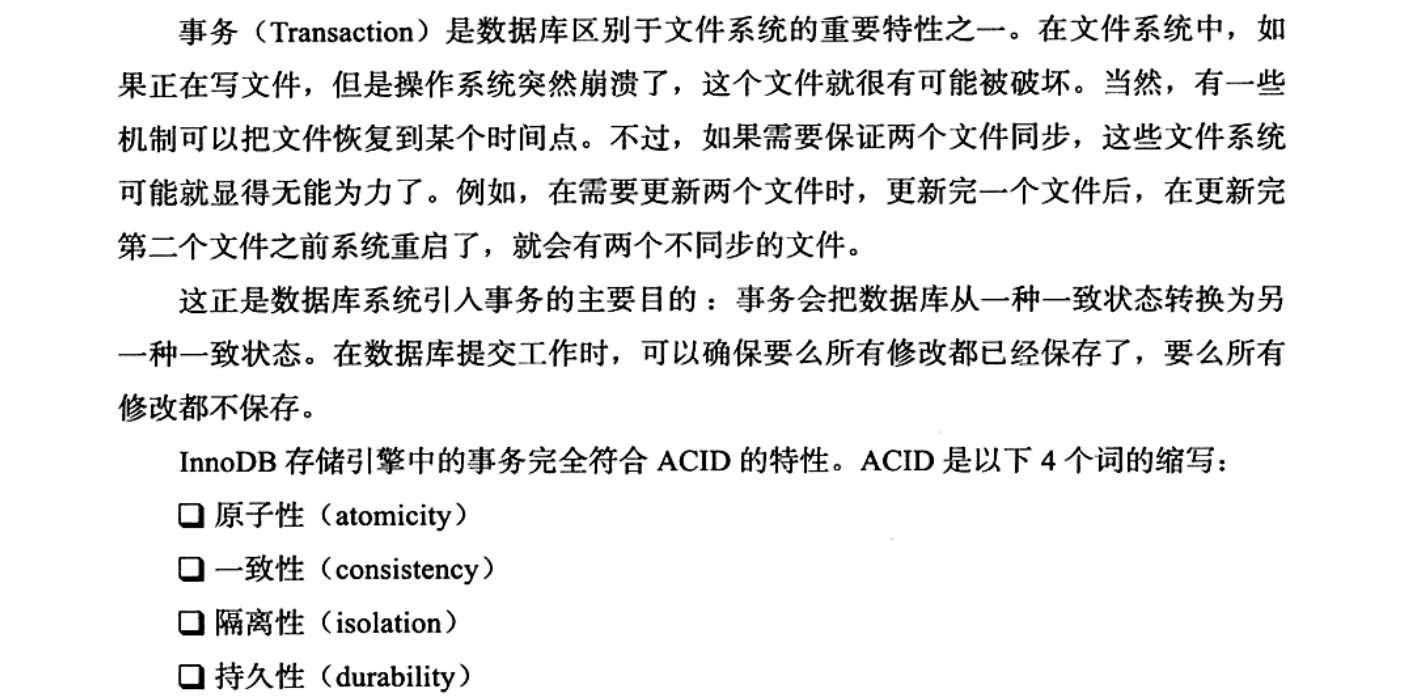
核心概念解读
事务是数据库区别于文件系统的核心特性,它的本质是保证一系列操作的原子性与一致性,避免文件系统中 “部分更新导致数据不一致” 的问题。InnoDB 的事务完全遵循 ACID 四大特性。
事务的核心价值
在文件系统中,如果更新两个文件时中途系统崩溃,会导致文件状态不一致。事务的引入就是为了解决这个问题:它确保数据库从一个一致状态,原子性地转换到另一个一致状态。简单来说,就是 "要么所有修改都成功提交,要么所有修改都回滚到初始状态"。
ACID 四大特性详解
| 特性 | 含义 | InnoDB 实现方式 |
| 原子性 | 事务中的所有操作是一个不可分割的整体,要么全部执行成功,要么全部失败回滚。 | 依赖 Undo Log 记录操作的反向逻辑,事务失败时通过 Undo Log 回滚到初始状态。 |
| 一致性 | 事务执行前后,数据库的完整性约束(如主键唯一、外键关联等)始终保持有效。 | 由原子性、隔离性、持久性共同保证,同时依赖业务逻辑的正确性。 |
| 隔离性 | 多个事务并发执行时,一个事务的执行不能被其他事务干扰,每个事务都感觉不到其他事务在并发执行。 | 通过锁机制和 MVCC(多版本并发控制)实现,不同隔离级别对应不同的并发控制策略。 |
| 持久性 | 一个事务一旦提交,它对数据库中数据的修改就应该是永久性的,接下来的其他操作或故障不应该对其执行结果有任何影响。 | 依赖 Redo Log 确保已提交的修改在系统崩溃后可以恢复,并且会异步刷盘保证数据持久化。 |
7.2 事务的实现
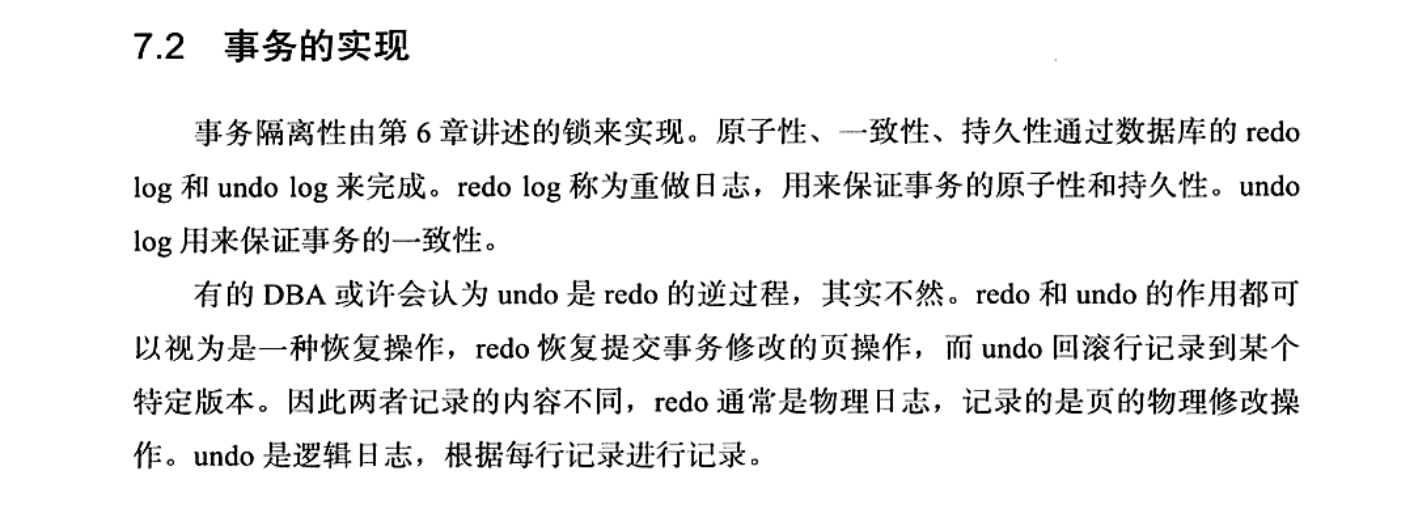
这段内容揭示了 InnoDB 事务四大特性(ACID)的底层实现机制,核心是通过锁、Redo Log、Undo Log这三大组件来分工协作。
事务特性与底层实现的对应关系
| 事务特性 | 实现机制 |
| 隔离性 | 通过第 6 章所述的锁机制(行锁、间隙锁、临键锁等)实现,防止并发事务之间的干扰。 |
| 原子性 | 通过 Redo Log 和 Undo Log 共同保证:Redo Log 确保已提交的修改不会丢失,Undo Log 确保未提交的修改可以回滚。 |
| 一致性 | 通过 Undo Log 回滚未提交的修改,结合锁机制保证并发下的数据状态一致。 |
| 持久性 | 通过 Redo Log 实现,已提交的修改会被记录到 Redo Log 并持久化到磁盘,即使系统崩溃也能通过 Redo Log 恢复数据。 |
Redo Log 与 Undo Log 的本质区别
| 特性 | Redo Log | Undo Log |
| 日志类型 | 物理日志,记录数据页的物理修改操作(如 "将页 X 的偏移 Y 处的值从 A 改为 B")。 | 逻辑日志,记录每行数据的逻辑修改操作(如 "对 id=10 的行,将 value 从 100 改回 50")。 |
| 核心作用 | 恢复已提交事务的修改,保证原子性和持久性 | 回滚未提交事务的修改,保证一致性;同时为 MVCC 提供历史快照数据。 |
| 触发时机 | 事务提交时刷盘,系统崩溃后重启时恢复。 | 事务回滚时触发,或事务提交后被异步清理。 |
7.2.1 redo log
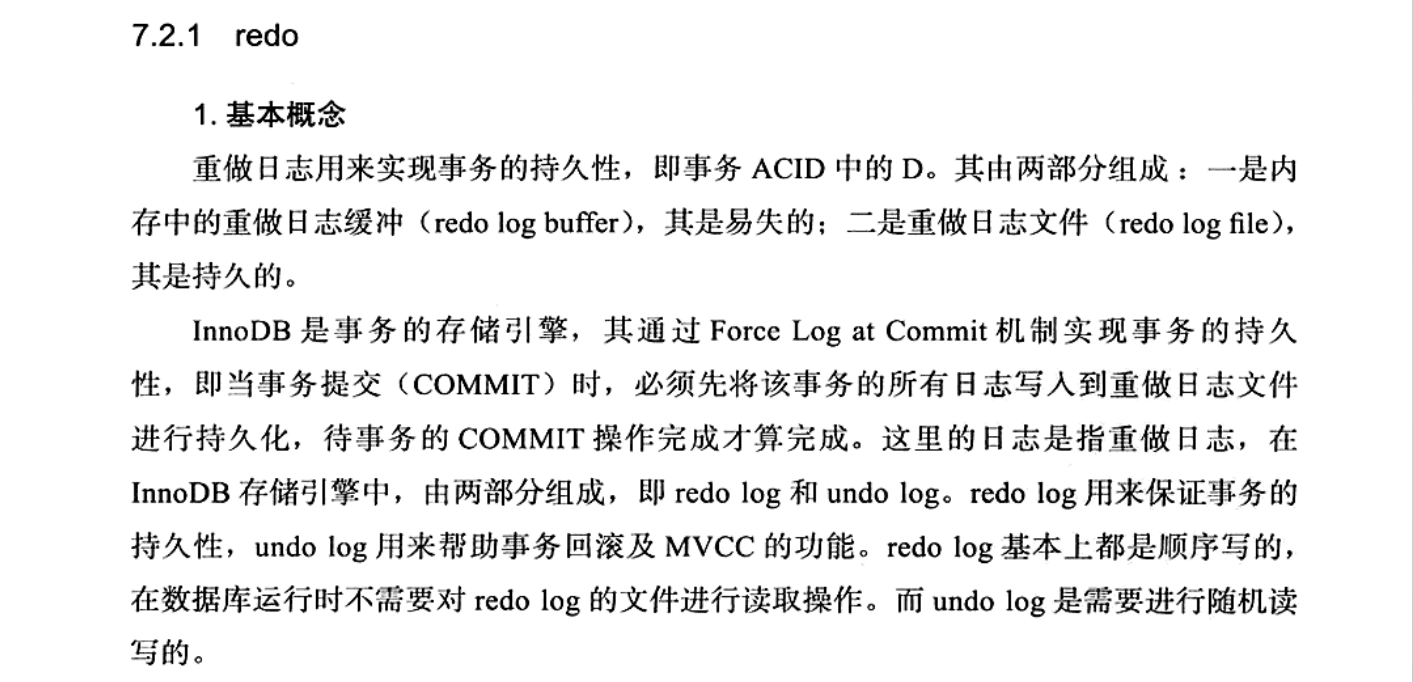
这段内容详细介绍了 Redo Log(重做日志)的组成、作用和核心机制,它是 InnoDB 保证事务持久性(Durability)的关键组件。
Redo Log 的组成
Redo Log 由两部分构成,分别对应内存和磁盘:
-
Redo Log Buffer:存在于内存中,是易失性的,事务执行过程中产生的 Redo Log 会先写入这里。
-
Redo Log File:存在于磁盘上,是持久化的,事务提交时日志会从缓冲刷入文件。
核心机制:Force Log at Commit
InnoDB 通过 Force Log at Commit 机制保证事务的持久性:
当事务执行 COMMIT 时,必须先将该事务的所有 Redo Log 从缓冲写入到磁盘上的 Redo Log File。
只有当日志写入完成后,COMMIT 操作才算成功。
这个机制确保即使系统崩溃,已提交事务的修改也能通过 Redo Log 恢复,不会丢失。
Redo Log 与 Undo Log 的关键区别
| 特性 | Redo Log | Undo Log |
| 核心作用 | 保证事务的持久性,恢复已提交的修改。 | 支持事务回滚和 MVCC,回滚未提交的修改。 |
| 写入方式 | 顺序写,性能极高。 | 随机读写,因为需要定位到具体行的历史版本。 |
| 读取时机 | 仅在系统崩溃后重启时读取,用于恢复数据 | 在事务回滚或 MVCC 读取历史版本时读取。 |
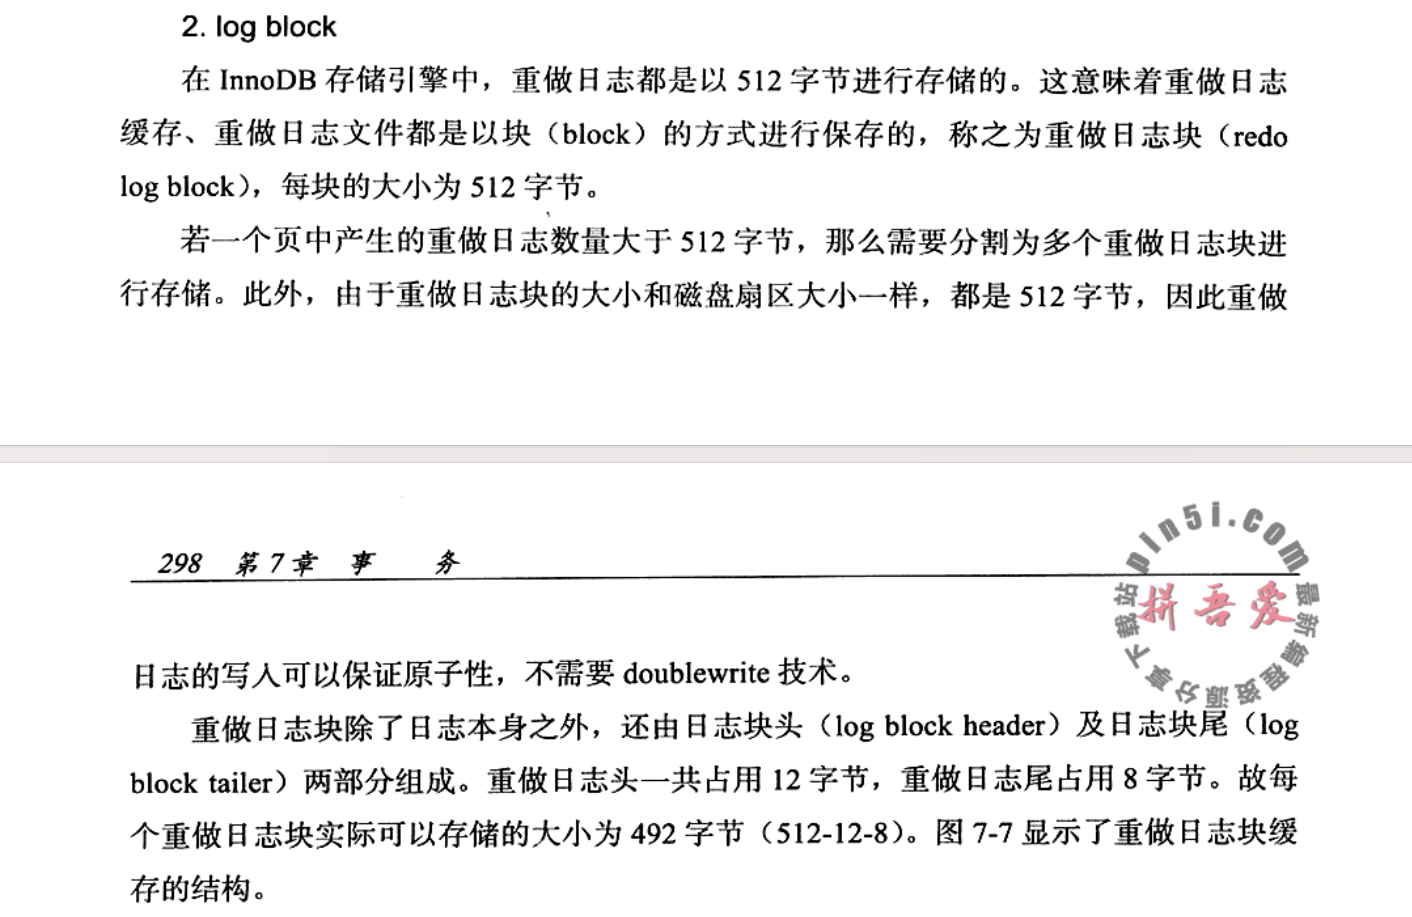
这段内容详细说明了 InnoDB 中 Redo Log 的存储单元 ——Redo Log Block(重做日志块) 的设计细节,它的大小和结构是为了保证日志写入的原子性和高效性。
Redo Log Block 的核心设计
-
固定大小:每个日志块的大小为 512 字节,与磁盘扇区的物理大小完全一致。
-
结构组成:每个日志块由三部分组成:
-
日志块头(log block header):12 字节,用于存储块的元信息(如块编号、校验等)。
-
日志内容:实际可存储的日志数据为 492 字节(512 – 12 – 8)。
-
日志块尾(log block tailer):8 字节,用于校验块的完整性。
-
-
自动分割:如果一条日志的长度超过 492 字节,会自动分割到多个日志块中存储。
512 字节设计的关键优势
-
原子写入保证:因为一个日志块的大小和磁盘扇区完全一致,写入时可以保证整个块的原子性,不会出现 "部分写入" 的情况。
-
无需 Doublewrite:普通数据页(16KB)的写入需要依赖 Doublewrite 技术来避免部分写失效,但 Redo Log Block 因与扇区大小一致,天然保证了原子性,因此不需要 Doublewrite。
-
高效顺序写:固定大小的块结构让 Redo Log 可以以极高的效率进行顺序写入,这也是 InnoDB 事务提交性能高的关键原因之一。
7.2.2 undo log
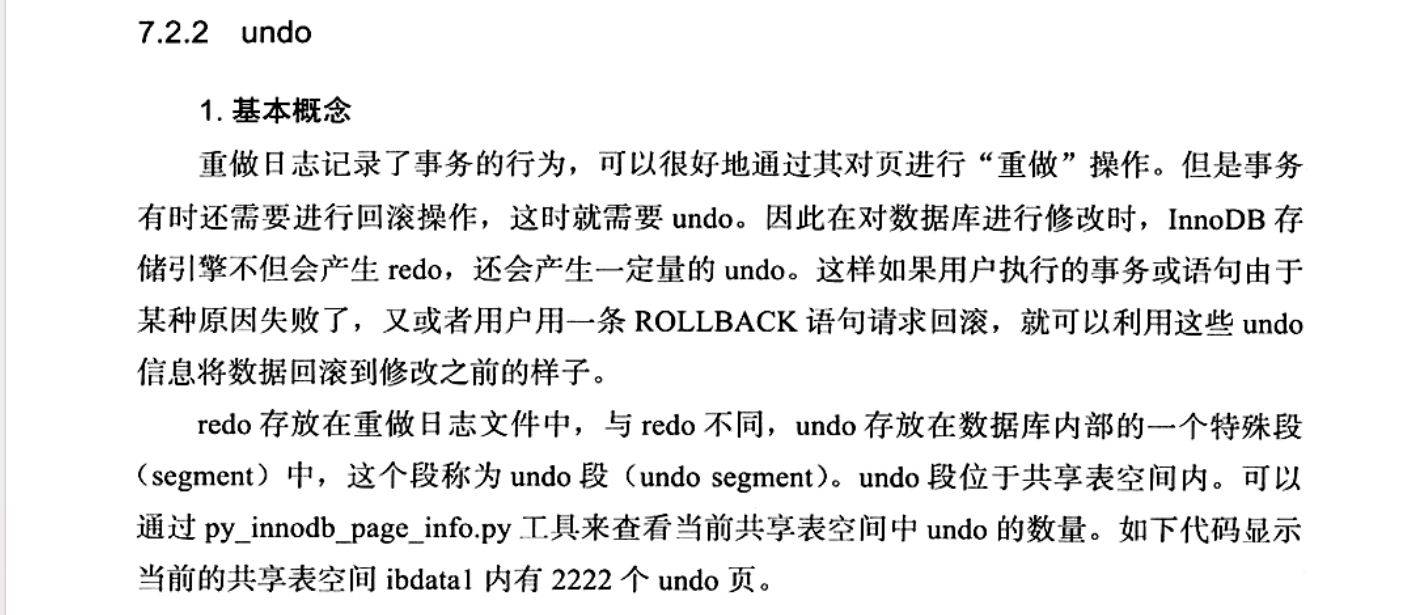
这段内容解释了 Undo Log(回滚日志)的基本概念、作用和存储方式,它是 InnoDB 实现事务原子性、一致性以及 MVCC 的基础。
Undo Log 的核心作用
-
事务回滚:当事务执行失败或用户执行 ROLLBACK 时,Undo Log 会记录数据修改前的状态,让数据可以回滚到修改前的样子,保证事务的原子性。
-
支持 MVCC:为读操作提供数据的历史版本,让事务可以读取到已提交的快照数据,实现 “读写不阻塞” 的并发性能。
Undo Log 与 Redo Log 的本质区别
| 特性 | Undo Log | Redo Log |
| 存储位置 | 存储在数据库内部的 Undo 段 | 存储在独立的 Redo Log 文件(如 ib_logfile0) |
| 日志类型 | 逻辑日志,记录数据的逻辑修改(如 "将 id=10 的 value 从 100 改为 50")。 | 物理日志,记录数据页的物理修改(如 "将页 X 的偏移 Y 处的值从 A 改为 B")。 |
| 核心价值 | 保证事务回滚和 MVCC 功能。 | 保证事务的持久性,崩溃后恢复已提交的修改。 |
| 生命周期 | 事务提交后不会立即删除,会保留一段时间供 MVCC 读取,之后被异步清理。 | 事务提交后刷入磁盘,日志被覆盖后会被循环使用。 |
7.6 事务隔离级别
InnoDB 默认隔离级别的独特优势
InnoDB 默认使用 REPEATABLE READ,但与标准 SQL 不同:
-
避免幻读:通过 Next-Key Lock(临键锁) 算法,既锁定记录本身,也锁定记录之间的间隙,彻底防止新数据插入导致的幻读。
-
达到 SERIALIZABLE 级别的一致性:在 REPEATABLE READ 级别下,InnoDB 已经能完全保证事务的隔离性要求,达到了 SQL 标准中 SERIALIZABLE 级别的效果。
-
无性能损失:根据 Jim Gray 在《Transaction Processing》中的观点,REPEATABLE READ 与 SERIALIZABLE 的开销几乎一致,甚至 SERIALIZABLE 可能更优,因此选择默认级别不会带来性能损失。
隔离级别与性能的关系
-
隔离级别越低:事务请求的锁越少,或持有锁的时间越短,理论上并发性能越高。
-
实际性能差异:在 InnoDB 中,REPEATABLE READ 和 READ COMMITTED 的性能差异很小,降低隔离级别并不会带来性能的大幅提升。
这段内容揭示了在 MySQL 主从复制架构下,事务隔离级别与二进制日志格式如何共同影响主从数据一致性,并给出了具体的解决方案。
主从数据不一致的两大原因
原因 1:READ COMMITTED 隔离级别缺少间隙锁
-
在 READ COMMITTED 级别下,InnoDB 不会使用 Gap Lock(间隙锁)。
-
这会导致在主库的事务执行期间,其他会话可以在锁定范围内插入新数据。
-
从库回放日志时,会出现与主库不一致的数据。
原因 2:STATEMENT 格式二进制日志的逻辑顺序问题
-
STATEMENT 格式记录的是主库执行的 SQL 语句本身。
-
如果主库执行顺序是 "先删后插",日志可能会记录为 "先插后删",导致逻辑顺序错乱。
-
从库按错误的顺序执行 SQL,会产生数据不一致。