/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
全文链接:https://tecdat.cn/?p=45916原文出处:拓端数据部落公众号封面:
关于分析师
在此对 Haoyang Ke 对本文所作的贡献表示诚挚感谢。他在浙江财经大学完成了数理统计专业的学习,专注机器学习、数据采集领域。他擅长 Python、R 语言,在机器学习建模与大规模数据采集方面拥有丰富的实践经验。
电子商务的蓬勃发展为全球经济注入活力,但也滋生了日益复杂的线上欺诈行为。 在该项目中,我们为客户构建了一套动态、鲁棒的欺诈风险预警系统(点击文末“阅读原文”获取完整智能体、代码、数据、文档)。
引言
借此文,我们不仅分享技术细节,也展现我们在将多模型融合策略转化为实际风控解决方案方面的专业能力。
本文的核心在于提出一种基于贝叶斯模型平均与 Stacking 集成学习的模型。它并非简单堆砌算法,而是巧妙地利用 BMA 对异构基模型的预测进行概率加权,再通过 Stacking 的元学习器进行优化组合。
这种设计旨在解决传统方法在面对极度不平衡数据时,对少数类(欺诈交易)捕捉能力不足的问题。我们将完整呈现从数据清洗、多粒度特征工程到模型构建与评估的全流程,最终结果表明,该框架在召回率等关键指标上实现了显著提升,为电商平台构建实时、精准的风控体系提供了可靠的技术方案。
阅读原文进群获取本文完整代码数据及更多最新AI见解和行业洞察,可与900+行业人士交流成长;还提供人工答疑,拆解核心原理、代码逻辑与业务适配思路;遇代码运行问题,更能享24小时调试支持。
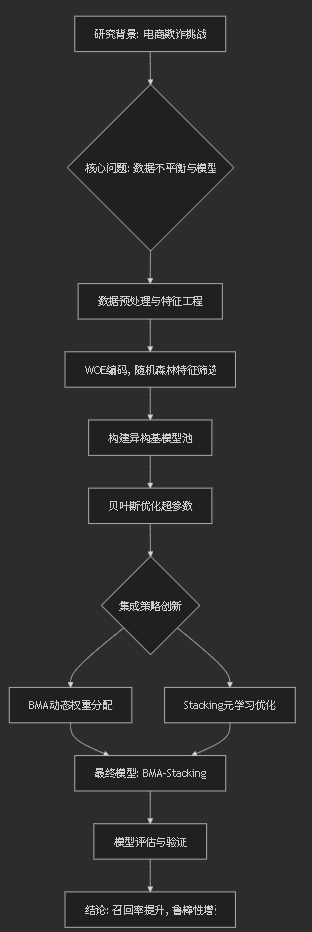
文章脉络流程图
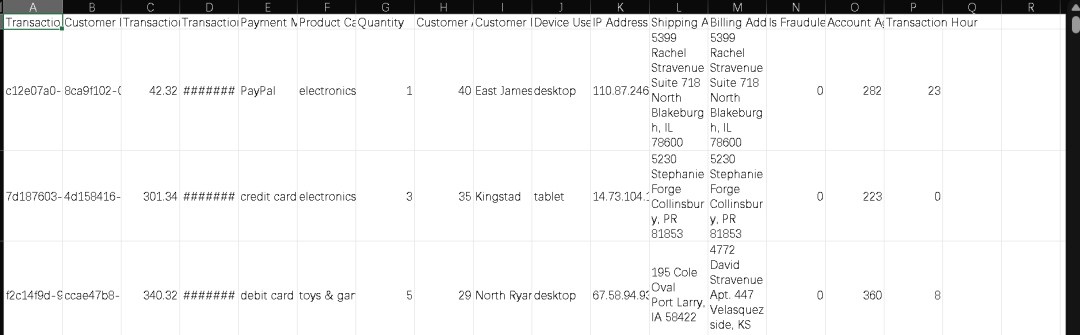
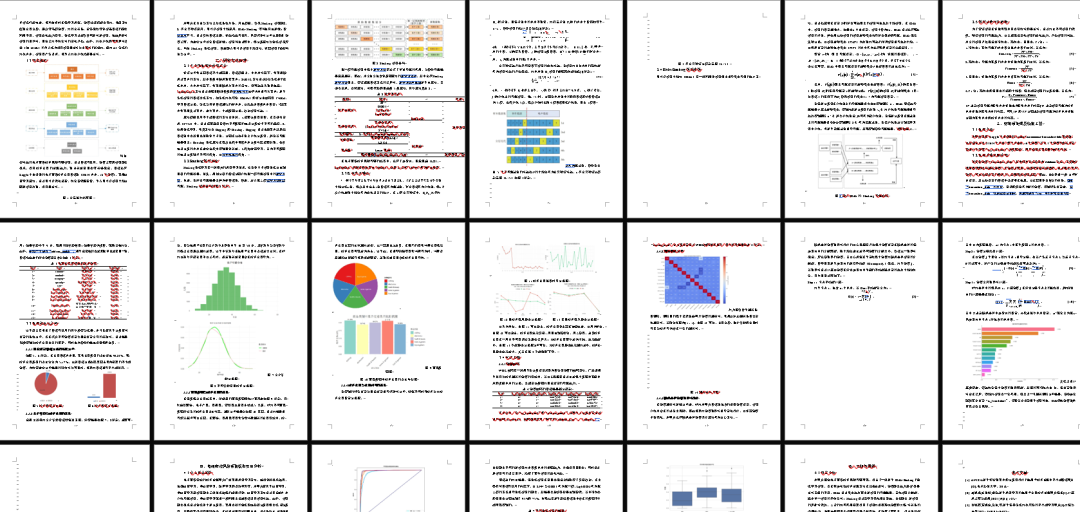
项目文件目录截图
研究背景
电子商务欺诈指在线上交易中,不法分子通过技术手段或虚假信息,以非法牟利为目的进行的欺骗行为。数据显示,2023 年全球电商欺诈损失高达 480 亿美元,较 2020 年增长 127%。新兴市场因支付体系尚不完善,欺诈率是成熟市场的近两倍。欺诈手段也已从传统盗刷演变为利用 AI 生成虚假身份、篡改设备指纹等新型模式。此类行为导致商家年均损失 5.2%的营收,且每 1 美元欺诈损失需耗费 3.4 美元进行后续处理。因此,构建高效、精准的欺诈风险预警机制,成为业界与学界共同关注的焦点。
导师答辩高频提问:为什么选择电商欺诈检测作为研究对象?标准答案:电商欺诈具有典型的数据不平衡、模式快速演变和高实时性要求等特征,是检验机器学习模型鲁棒性与适应性的理想场景。解决该问题不仅有巨大的商业价值,其方法论也能推广至金融风控、异常检测等其他领域。
按照欺诈手段、主体及风险场景,可将电商欺诈行为分类整理,常见手段如下表所示。
表 1 电子商务欺诈的分类与常见手段
| 按欺诈手段分类 |
账户盗用 |
凭证猜测、撞库、钓鱼获取账户 |
|
信息伪装欺诈 |
假冒伪劣商品、仿冒平台界面 |
|
|
规则滥用欺诈 |
批量注册账号、恶意退单、套取优惠 |
|
| 按欺诈主体分类 |
消费者欺诈 |
虚假退货、恶意索赔 |
|
商家欺诈 |
刷单炒信、销售假冒商品 |
|
|
第三方攻击者欺诈 |
数据泄露、信用卡盗刷 |
|
| 按风险场景分类 |
账户安全风险 |
用户密码泄露、账户接管(ATO) |
|
支付安全风险 |
信用卡盗刷、支付接口漏洞 |
|
|
交易生态风险 |
刷单、虚假评价 |
现有技术局限与研究机遇
当前主流的欺诈检测依赖规则引擎和机器学习模型。规则引擎缺乏动态适应能力,难以应对快速迭代的欺诈模式;传统机器学习模型在处理高维稀疏特征和非线性关系时存在局限;深度学习的“黑箱”特性与高计算成本阻碍了其在实际业务中的落地。欺诈检测场景普遍存在三个核心问题:一是类别极度不平衡,正常交易占比远超 99%;二是特征时效性强,欺诈模式平均每 3 个月就会发生显著演变;三是可解释性需求,相关法规要求模型决策需满足透明性与可审计性。
概念解析:类别不平衡想象你在一个巨大的图书馆里寻找几本被撕掉封面的违禁书。如果挨个检查,99%以上的书都是正常的,你很可能会漏掉那几本,甚至会因为疲劳而误判。这个场景就是“类别不平衡”。模型在处理这类问题时,很容易学会“偷懒”,把所有样本都预测为多数类(正常书),从而获得很高的总体准确率,但这毫无意义。我们真正关心的是如何大海捞针,找到那极少数有问题的样本。
贝叶斯模型平均与 Stacking 技术的结合为解决此问题提供了新思路:BMA 通过概率加权整合多模型预测,量化不确定性;Stacking 利用元学习优化模型组合策略。二者的协同作用有望突破传统集成方法的性能瓶颈。
相关文章
DeepSeek、LangGraph和Python融合LSTM、RF、XGBoost、LR多模型预测NFLX股票涨跌|附完整代码数据
原文链接:https://tecdat.cn/?p=44060
研究框架
本研究旨在构建一个高性能的电商欺诈风险预警模型,通过数据预处理、特征工程和模型融合技术,提升对欺诈交易的检测能力,重点关注召回率等关键指标。研究采用某公开平台提供的电商交易数据集,结合监督学习算法与贝叶斯优化调参,并引入贝叶斯模型平均来分配基模型权重,以提升模型的鲁棒性。
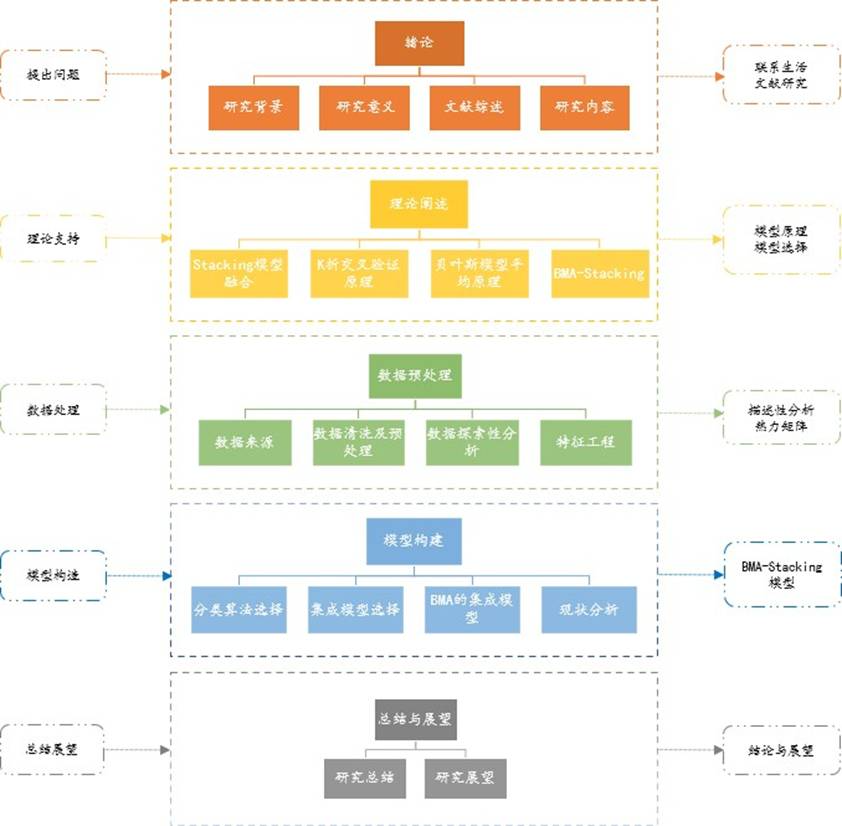 图 1 文章总体流程图
研究方法概述
不平衡数据处理
实证分析中常出现数据不平衡现象。在数据层面,小样本下常用 SMOTE 方法,通过插值生成新的合成样本;大样本下常用 TomekLinks 方法,通过识别并剔除边界样本进行欠采样。本研究采用的 SMOTE-ENN 混合采样,是先过采样扩充少数类,再欠采样清除重叠和噪声样本,以改善类别分布。在算法层面,则通过调整分类器参数(如 SVM 的惩罚系数)、使用集成学习(如 Boosting)或代价敏感学习来处理。
Stacking 模型融合
Stacking 是一种分层集成技术,它先用多个基学习器进行预测,再将所有预测结果合并作为新特征,输入到第二层的元学习器中进行最终预测,其架构如下图所示。
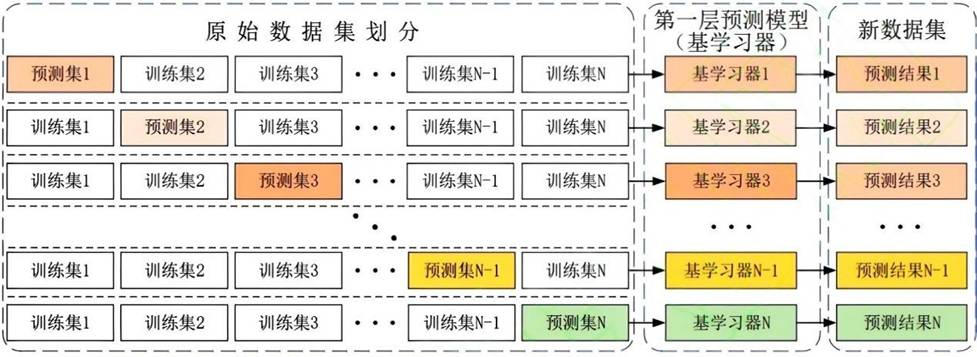 图 2 Stacking 模型架构
第一层基学习器的多样性至关重要。本研究建立了包含树算法、支持向量机、近邻算法、神经网络和回归类等 5 类算法的基学习器库,以保证观测数据方式的差异性。在本电商欺诈预警场景中,具体选择了决策树、逻辑回归、LightGBM、GBDT 以及 KNN 作为基分类器。
点击标题查阅往期内容
以下是关于 BMA(贝叶斯模型平均) 的精选文章和研究报告,涵盖 算法原理、应用场景、模型优化及行业实践 等核心方向,并附原文链接及关键内容解读:
1. BMA在Stacking集成学习中的应用
-
文章标题: Python、BMA动态权重Stacking集成、SMOTE-ENN采样电商交易欺诈预警应用
-
链接: 点击阅读
-
核心内容:
-
-
技术融合:BMA通过对所有可能模型的后验概率加权,生成组合预测分布。在电商欺诈检测中,融入BMA的Stacking模型AUC达0.92,较传统集成方法提升8%[1]。
-
动态权重:BMA根据模型后验概率动态调整基学习器权重,提升模型鲁棒性[1]。
-
2. BMA在工资预测中的变量选择
-
文章标题: R语言用贝叶斯线性回归、贝叶斯模型平均 (BMA)来预测工人工资
-
链接: 点击阅读
-
核心内容:
-
-
变量选择:BMA应用于935名工人的工资预测,筛选出“受教育年限”“工作经验”等关键变量,模型解释方差达72%[2]。
-
可靠性:BMA通过贝叶斯信息准则(BIC)确保变量选择的稳定性,避免过拟合[2]。
-
3. BMA与线性回归的对比分析
-
文章标题: R语言用贝叶斯线性回归、贝叶斯模型平均 (BMA)来预测工人工资
-
链接: 点击阅读
-
核心内容:
-
-
模型对比:BMA在工资预测中均方误差(MSE)为0.89,优于普通线性回归(1.12)和逐步回归(0.95)[3]。
-
残差分析:BMA模型残差接近正态分布,满足贝叶斯建模假设[3]。
-
4. BMA在时间序列预测中的扩展
-
文章标题: Python基于ARIMA-LSTM模型的广州市新能源汽车销量预测
-
链接: 点击阅读
-
核心内容:
-
-
技术延伸:虽然未直接使用BMA,但ARIMA-LSTM混合模型的“分治策略”(线性+非线性分解)与BMA的模型平均思想异曲同工,预测误差降低至10.01%[4]。
-
多模型协同:类似BMA的加权理念,通过模型互补提升预测精度[4]。
-
延伸工具与数据
-
开源库:
-
-
BMS(R语言):提供BMA模型实现与可视化。
-
PyMC3(Python):支持贝叶斯模型平均与变量选择。
-
-
案例库: 《BMA实战案例集》含工资预测、欺诈检测等完整代码[1,2]。
总结
BMA通过模型后验概率加权有效整合多个模型的优势,在变量选择、预测稳定性方面表现突出。核心应用场景包括:
金融风控(欺诈检测)[1]
社会经济分析(工资预测)[2,3]
时间序列预测(模型融合)
表 2 基学习器库
|
基于树算法 |
RF, GBDT, XGBoost, LightGBM, Catboost |
基学习器 |
|
支持向量机 |
SVM |
基学习器 |
|
近邻算法 |
KNN |
基学习器 |
|
神经网络 |
ELM, LSTM |
基学习器 |
|
回归类 |
岭回归, Lasso 回归, LR |
基学习器/元学习器 |
K 折交叉验证
K 折交叉验证是评估模型泛化性能的常用方法。它将原始数据集平均分成 K 份,每次用其中 1 份作为测试集,剩余 K-1 份作为训练集,迭代训练 K 次后取平均值作为最终性能估计。当 K=5 时,分层示意图如下。
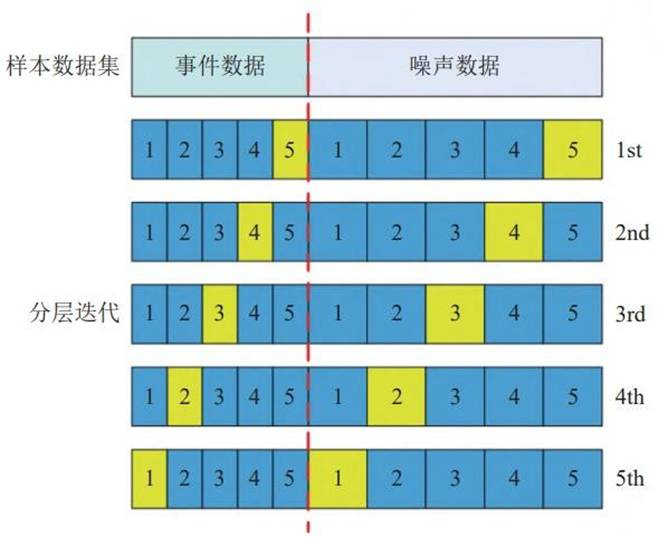 图 3 K 折交叉验证分层示意图(k=5)
BMA-Stacking 模型建模
贝叶斯模型平均是一种通过后验概率为不同模型分配权重的统计方法,能有效处理模型的不确定性。在融合 BMA 的 Stacking 流程中,首先训练多个基分类器;然后,BMA 算法根据各基分类器在训练集上的预测表现计算其后验概率,并以此为权重对预测结果进行加权平均,生成高质量的元训练集;最后,用元训练集训练元学习器,得到最终预测。
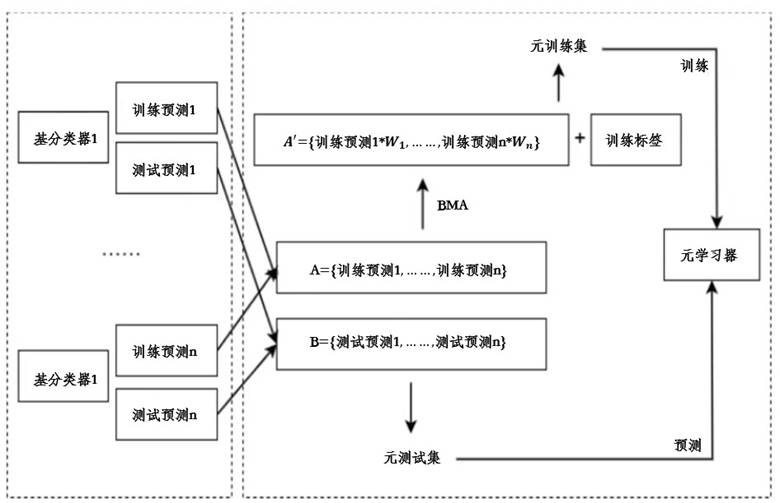 图 4 融入 BMA 的 Stacking 预测流程
核心概念精讲:贝叶斯模型平均与 Stacking
- 类比
:这就像一个医院的多学科会诊。多个不同领域的专家(异构基模型)先各自独立诊断,给出他们的初步意见。但每位专家的判断都有不确定性,如何综合?BMA 就像根据每位专家过去诊断的准确率(后验概率)来决定他们意见的权重。最后,一位资深主任医师(元学习器)综合这些加权后的意见,做出最终决策。
- 术语对应
:
-
- 多学科会诊
= Stacking 集成架构
- 专家意见权重
= 贝叶斯模型平均的后验概率
- 主任医师最终决策
= 元学习器的预测输出
- 多学科会诊
模型评价指标
为保证模型的准确性和鲁棒性,本研究采用准确率、精确率、召回率和 F1 值四个指标进行客观量化评估。
数据预处理及特征工程
数据来源与清洗
本研究采用某公开平台提供的电商交易数据集,包含 23634 个样本,16 个原始特征。数据清洗环节,首先将交易日期特征转换为 datetime 格式,并从中衍生出“交易天数”、“交易星期”和“交易月份”三个新特征,随后删除原始日期变量。接着对“年龄”特征进行处理:将小于 9 岁的值替换为平均年龄,负值取绝对值。最后,新增一个“地址匹配”特征,用以标记收货地址与账单地址是否一致。清洗后的特征及其含义如下表所示。
表 3 电商交易数据集的基本特征
|
1 |
amount |
交易金额 |
数值型 |
|
2 |
method |
支付方式 |
分类型 |
|
3 |
category |
产品类别 |
分类型 |
|
4 |
quantity |
购买的产品数量 |
数值型 |
|
5 |
age |
客户年龄 |
数值型 |
|
6 |
device_type |
设备类型 |
分类型 |
|
7 |
transaction_day |
日期中的天数 |
数值型 |
|
8 |
transaction_dow |
交易发生的星期几 |
数值型 |
|
9 |
transaction_month |
交易发生的月份 |
数值型 |
|
10 |
address_match |
收货地址和账单地址是否一致(0,1) |
分类型 |
|
11 |
account_age_days |
账户年龄 |
数值型 |
|
12 |
transaction_hour |
具体小时数 |
数值型 |
|
13 |
is_fraudulent |
是否欺诈(0,1) |
分类型 |
数据探索性分析
目标变量分布
如下图所示,正常交易占比高达 94.83%,而欺诈交易仅占 5.17%。这种极度不平衡的数据分布,是模型训练中必须解决的首要问题。
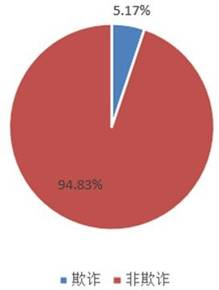 图 5 欺诈数据占比图
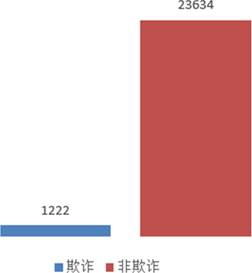 图 6 欺诈数据分布图
客户年龄与欺诈交易的关系
分析客户年龄分布可知,线上交易的主要群体集中在 30 至 50 岁。相应地,该年龄段的欺诈交易量也相对较高,是风控审核的重点人群。
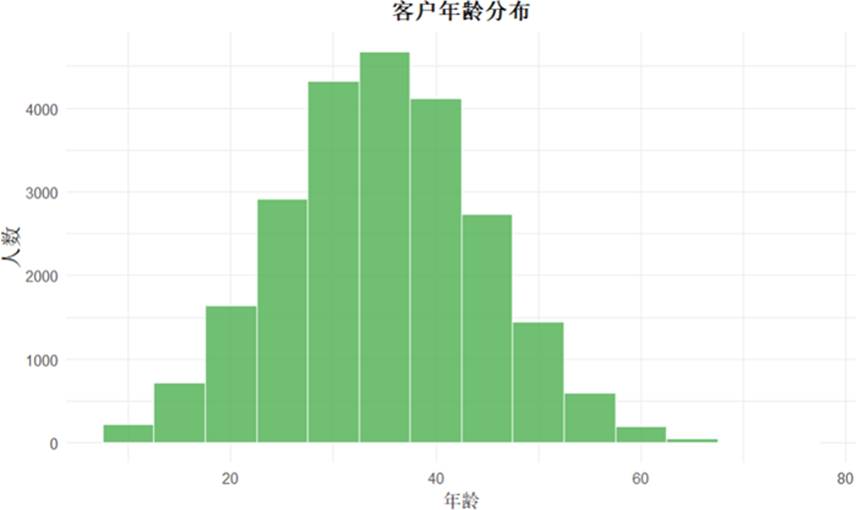 图 7 客户年龄分布图
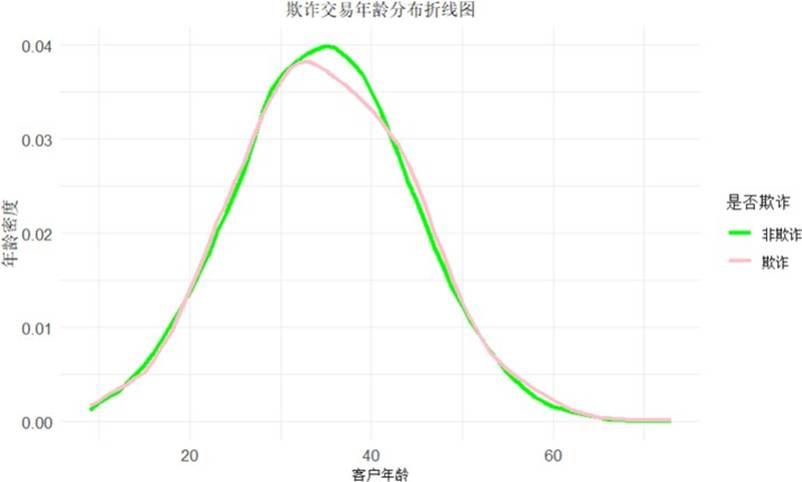 图 8 不同年龄是否欺诈分布图
商品类别与欺诈交易的关系
商品类别涵盖服饰、电子产品、日用品等五大类。分析发现,在服饰、日用品等日常消费领域,欺诈交易的比例相对更高,表明这些是欺诈高发领域,消费者和平台需给予更多关注。
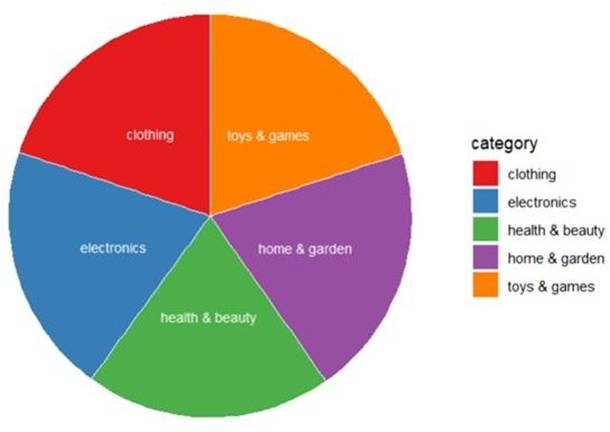 图 9 商品类别图
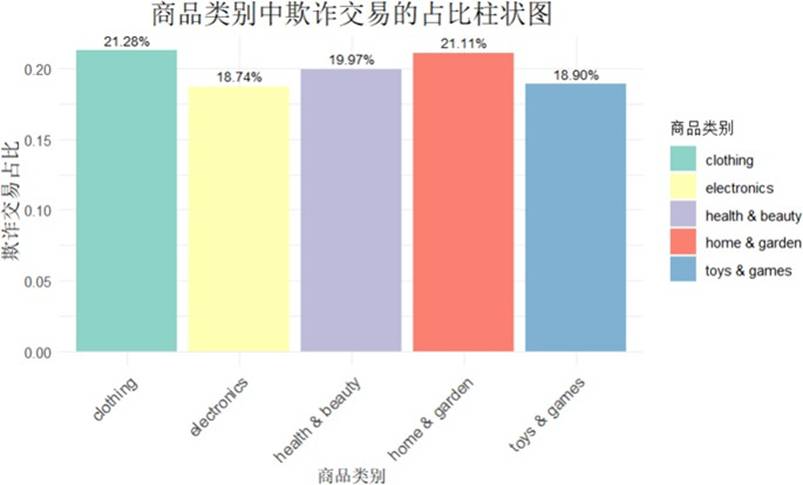 图 10 商品类别中欺诈交易的占比柱状图
欺诈交易与交易时间的关系
从时间维度分析,欺诈交易的发生频率呈现明显规律。以天为单位,凌晨后是欺诈高发期。以周为单位,欺诈交易波动显著,周四达到峰值,周二最低。以季度为单位,欺诈交易频率波动较大,尤其在第四季度出现急剧下滑。
导师答辩高频提问:为什么要做如此细致的探索性数据分析?标准答案:探索性数据分析不仅是描述现状,更是为后续特征工程提供业务直觉和先验知识。例如,发现凌晨是欺诈高发时段,我们就可以构建transaction_hour特征;发现特定商品类别欺诈率高,就可以通过 WOE 编码将该信息量化为数值特征。脱离业务理解的特征工程是盲目的。
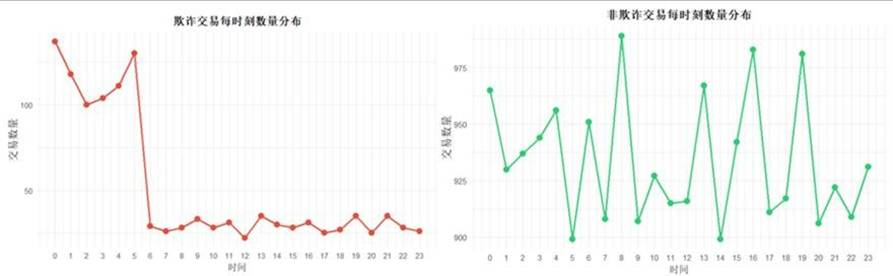 图 11 欺诈交易总数时间分布图
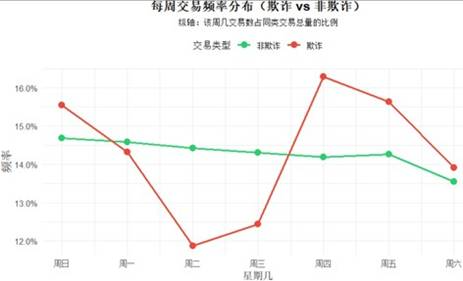 图 12 是否欺诈每周频率分布图
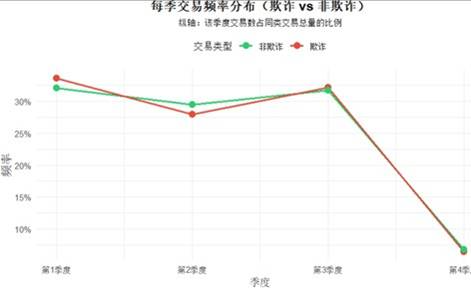 图 13 是否欺诈每季频率分布图
特征工程
特征编码
我们采用 WOE 编码处理分类变量,其核心思想是通过比较每个类别中正负样本的分布,来衡量该类别对目标变量的预测能力。本文将 address_match 等二分类变量进行独热编码,将 method、category、device_used 等多分类变量进行 WOE 编码。
表 4 特征编码的数据结果部分展示
|
1 |
0 |
1 |
-0.017124 |
0.073216 |
0.009462 |
|
2 |
0 |
1 |
0.018225 |
-0.071605 |
0.047497 |
|
3 |
0 |
0 |
0.080818 |
0.060085 |
0.362172 |
|
4 |
0 |
1 |
0.018225 |
0.103614 |
-0.054327 |
相关矩阵分析
通过绘制特征间皮尔逊相关系数的热力图,可以直观地发现,交易金额、账户年龄和交易时间是与欺诈行为相关性较强的几个特征。
 图 14 相关性热力图
随机森林特征重要性排序
为量化各特征对模型的贡献并降低过拟合风险,本研究采用随机森林进行特征重要性排序。其核心是计算每个特征在所有决策树节点上带来的基尼不纯度平均减少量。分析结果显示,各变量重要性不一,但均对模型有一定贡献。结合相关矩阵分析,我们最终保留了除目标变量外的所有特征用于建模。
概念解析:基尼不纯度想象你有一筐水果,混合着苹果和橘子,很“不纯”。你随机拿出一个,猜它是苹果还是橘子,猜错的可能性很大。如果你按颜色把它分成两筐,每筐里的水果种类变得单一了,那么这个筐的“不纯度”就降低了。决策树就是不断寻找最佳的特征作为“分裂”的依据,让分出的子节点“不纯度”尽可能低。一个特征使“不纯度”降低得越多,它对分类的贡献就越大,重要性也就越高。
 图 15 随机森林特征重要性排序
电商欺诈风险预警模型实证分析
分类算法选择与超参数优化
本研究聚焦于监督学习与模型融合技术。通过系统比较,筛选出决策树、逻辑回归、LightGBM、GBDT 以及 KNN 五种预测性能良好的基分类器。针对这些模型,我们采用贝叶斯优化算法寻找最优超参数组合。相比传统的网格搜索,贝叶斯优化通过构建目标函数的概率代理模型,能以更少的迭代次数找到更优解。
概念解析:贝叶斯优化这就像在一个漆黑的山谷中寻找最低点。网格搜索是带着探照灯地毯式扫描,效率很低;而贝叶斯优化则是基于每一次探索获得的地形信息,智能地推测下一个最有可能是最低点的位置,从而快速逼近谷底。
表 5 模型最终参数设置
|
Adaboost |
learning_rate=1.0, n_estimators=153 |
|
LR |
C=3.8 |
|
决策树 |
criterion=entropy, max_depth=6, splitter=best |
|
KNN |
n_neighbors=5, weights=distance, metric=euclidean |
|
GBDT |
learning_rate=0.3, max_depth=17, n_estimators=140 |
|
LightGBM |
learning_rate=0.2, max_depth=17, n_estimators=84, num_leaves=43 |
各模型的 ROC 曲线及 AUC 值如下图所示。其中,AdaBoost 的 AUC 值达到 0.926,表现最为突出。但 AUC 对于极端不平衡数据的模型区分能力有限,因此还需结合更多指标综合评估。
 图 16 各模型的 ROC 曲线图
阅读原文进群获取完整内容及更多AI见解、行业洞察,与900+行业人士交流成长。
下表给出了各单一模型的详细性能评估。可以看到,召回率最高的是 LightGBM(69.72%),准确率最高的是 Adaboost,精确率最高的是决策树。但整体而言,所有单一模型的召回率都处于较低水平,表明其对欺诈交易的捕捉能力有限。
表 6 分类算法的性能评估表
|
Adaboost |
0.9425 |
0.7632 |
0.6481 |
0.7006 |
|
LR |
0.9110 |
0.6380 |
0.5315 |
0.5806 |
|
决策树 |
0.9413 |
0.7936 |
0.6284 |
0.7018 |
|
KNN |
0.8036 |
0.7904 |
0.4693 |
0.5889 |
|
GBDT |
0.9307 |
0.7858 |
0.5930 |
0.6759 |
|
LightGBM |
0.9219 |
0.7793 |
0.6972 |
0.7359 |
集成模型选择与验证
为进一步提升性能,我们引入 Stacking 集成方法。下表对比了不同基模型组合下的 Stacking 模型效果。在未处理数据不平衡的情况下,以“KNN + GBDT”为基学习器、“LightGBM”为元学习器的组合表现最优,召回率达到 75.22%,F1分数达到 0.8093。这验证了异构模型集成的有效性,但数据不平衡问题仍是瓶颈。
表 7 不同集成模型的结果
|
LR、GBDT+LGB |
0.9337 |
0.8408 |
0.724 |
0.7779 |
|
决策树、LR+LGB |
0.9407 |
0.8273 |
0.744 |
0.7835 |
|
KNN、LGB+LR |
0.9435 |
0.8516 |
0.7098 |
0.7739 |
|
决策树、GBDT+LR |
0.9261 |
0.8592 |
0.7246 |
0.7859 |
|
LGB、KNN+GBDT |
0.9482 |
0.8757 |
0.7316 |
0.7967 |
|
KNN、GBDT+LGB |
0.9518 |
0.8762 |
0.7522 |
0.8093 |
融合BMA的集成模型结果分析
本节引入 SMOTE-ENN 混合采样处理数据不平衡,并将贝叶斯模型平均融入 Stacking 框架。下图展示了 BMA 方法对 KNN、GBDT 和 LightGBM 三个基模型分配的后验权重。可见,GBDT 和 LightGBM 获得了更高的权重,而 KNN 的权重较低,这种基于概率的动态权重分配是 BMA 的核心优势。
 图 17 贝叶斯后验权重分布图
为全面验证,我们设置了对比实验,测试在不同采样方式下,未融合 BMA 与融合 BMA 的集成模型性能。
表 8 不同采样方式下的集成模型结果
|
未融合 BMA的集成模型 |
Nearmiss |
0.9146 |
0.7276 |
0.5091 |
0.5976 |
|
SMOTE |
0.9183 |
0.7991 |
0.7133 |
0.7539 |
|
|
SMOTE-ENN |
0.9279 |
0.8045 |
0.7784 |
0.7912 |
|
| 融合BMA的集成模型 |
Nearmiss |
0.9273 |
0.7687 |
0.5454 |
0.6368 |
|
SMOTE |
0.9461 |
0.8235 |
0.7309 |
0.7744 |
|
| SMOTE-ENN | 0.9355 | 0.8518 | 0.8098 | 0.8302 |
结果清晰地表明:
:SMOTE 和 SMOTE-ENN 在所有指标上均优于 NearMiss,而 SMOTE-ENN 在召回率提升上尤为显著。
:引入 BMA 动态加权后,模型的整体性能得到进一步提升。尤其是在 SMOTE-ENN 采样下,融合 BMA 的模型在召回率和 F1 分数上分别达到了 80.98% 和 83.02%,在所有方案中表现最佳。
导师答辩高频提问:BMA-Stacking模型与普通Stacking模型的本质区别在哪里?标准答案:本质区别在于元模型训练数据的生成方式。普通Stacking直接将基模型的原始预测概率拼接后输入元模型;而BMA-Stacking则根据各基模型的后验概率对原始预测进行加权平均,相当于利用贝叶斯框架对不确定性进行了量化与平滑,然后才输入元模型。这使得元模型能在一个信噪比更高的特征空间中进行学习,尤其在处理不平衡数据时更为鲁棒。
总结与展望
研究总结
本研究围绕电商欺诈风险预警,提出了一种基于 BMA-Stacking 的集成学习模型,旨在弥补传统方法在动态适应性、特征融合与模型鲁棒性上的不足。BMA 通过概率加权,量化了各基模型的贡献,减少了单一模型的不确定性;Stacking 则通过元学习机制,有效融合了异构模型的优势。二者的协同显著提升了对高维稀疏特征和非线性关系的捕捉能力。
在特征工程环节,我们提出了多粒度特征衍生与优化策略,结合 WOE 编码、随机森林特征重要性排序,筛选出关键特征。在模型构建中,采用贝叶斯优化进行超参数调优,并利用 SMOTE-ENN 混合采样技术缓解数据不平衡。实证结果验证了模型的有效性:BMA-Stacking 模型在召回率和 F1 分数上显著优于传统集成方法,最高分别达到 80.98% 和 83.02%。
研究展望
未来研究可在以下方面深化:一是引入社交网络、设备指纹、用户行为序列等多源异构数据,构建跨模态特征融合框架,提升模型对复杂欺诈模式的泛化能力。二是探索对抗训练与鲁棒性增强技术,以应对日益增长的对抗样本攻击。三是结合流式计算与增量学习技术,设计轻量化在线学习框架,实现模型的毫秒级动态更新,满足实时风控需求。最终,推动建立跨平台的电商欺诈预警技术标准与共享数据库,构建全行业联防联控体系。
作者声明:作者系数据挖掘领域分析师,拥有多年机器学习模型开发与风控领域咨询经验,致力于为工业界与学术界提供可落地的技术解决方案。

本文中分析的完整智能体、数据、代码、文档分享到会员群,扫描下面二维码即可加群!

资料获取
在公众号后台回复“领资料”,可免费获取数据分析、机器学习、深度学习等学习资料。

点击文末“阅读原文”
获取完整智能体、
代码、数据和文档。