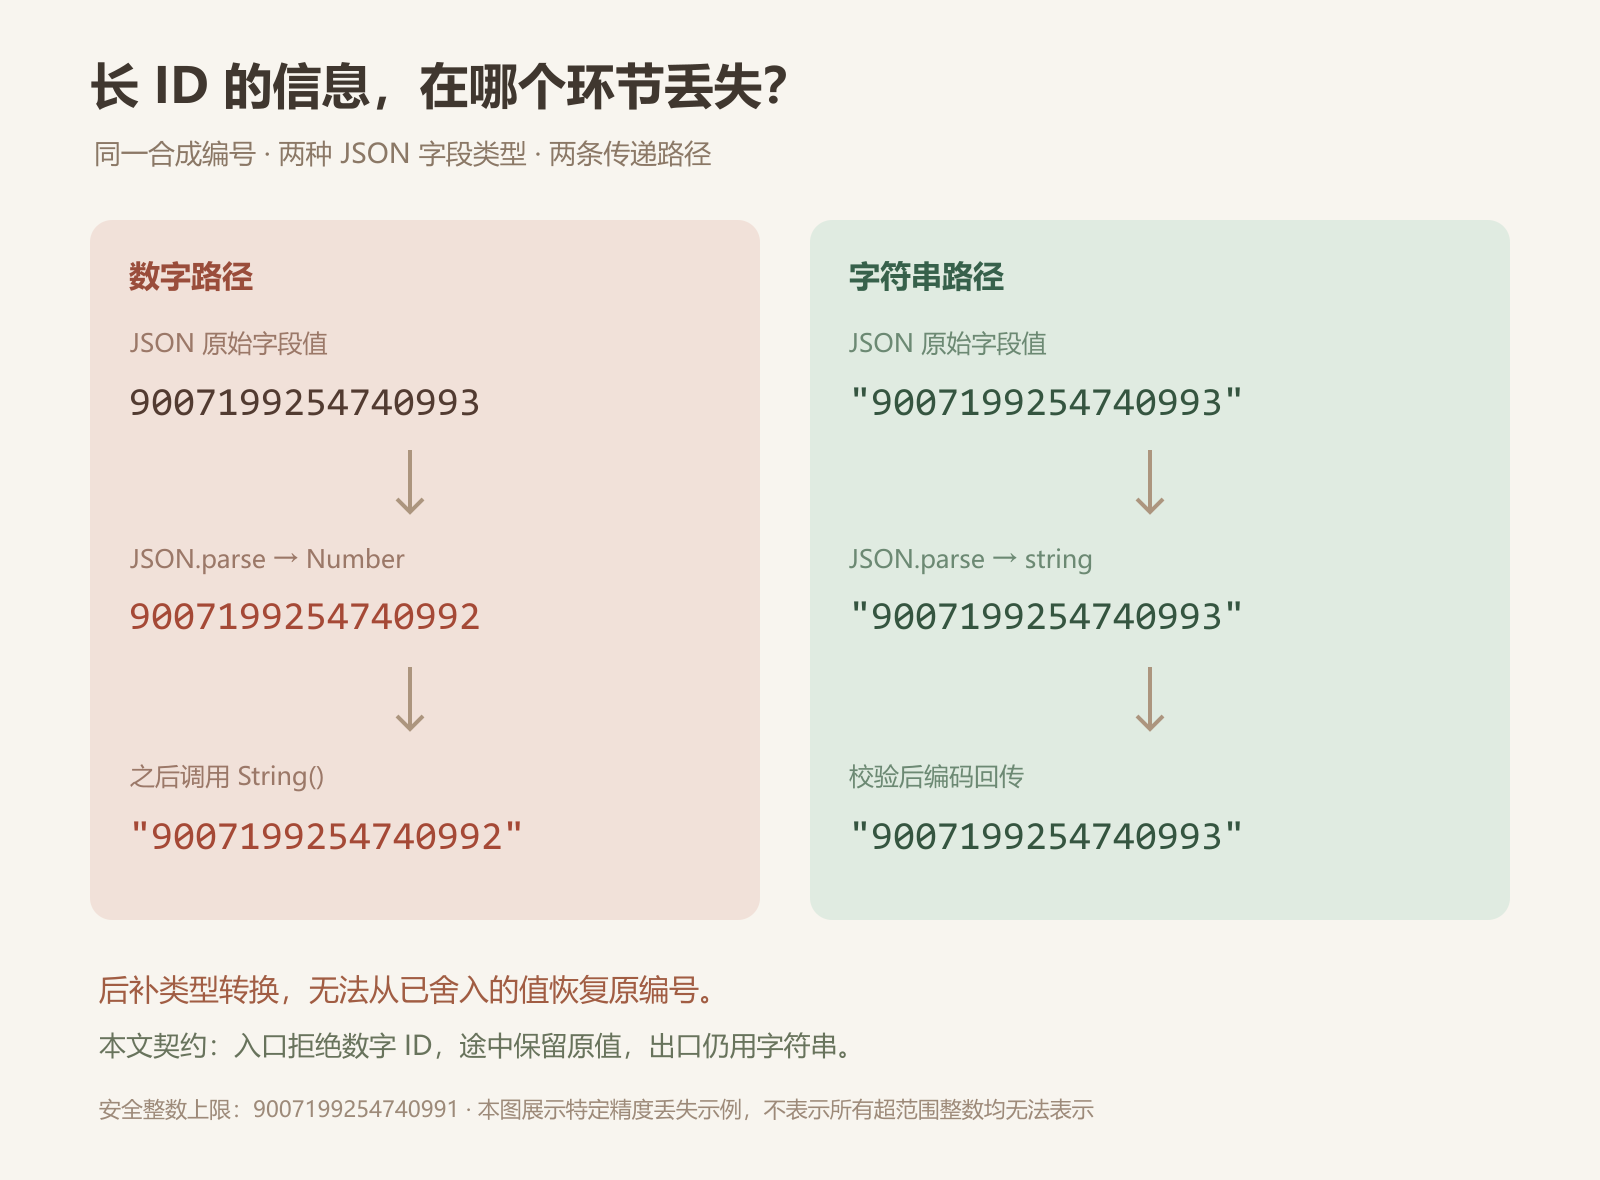
接口原文中的消息 ID 是 9007199254740993,前端读出来却成了 9007199254740992。如果再拿这个值查询详情或构造引用请求,后面的逻辑即使全部正确,也可能一直找错目标。
以米米商聊为背景,已整理的手机端资料包含消息引用操作。本文借“引用需要指向正确消息”的场景讨论独立的 JSON 与 JavaScript 示例,不代表产品采用这些 ID、字段或接口,也不推断其实际存储方案。文中所有消息与编号均为合成数据。
1. 长得像整数,不代表适合用 Number 保存
JavaScript 的 Number.MAX_SAFE_INTEGER 是 9007199254740991,即 2 的 53 次方减 1。安全整数文档解释了这个边界:超出相应范围后,整数的精确表示及相邻整数区分不再有普遍保证。
注意,这不等于更大的每一个整数都会出错。例如某些较大值仍可精确表示,但相邻值可能落到同一个 Number 上。因此,“这次打印看起来没问题”不足以证明一种长 ID 传输方案可靠。
const numericMessage = JSON.parse('{"id":9007199254740993}');
console.log(numericMessage.id); // 9007199254740992
console.log(String(numericMessage.id)); // "9007199254740992"
const stringMessage = JSON.parse('{"id":"9007199254740993"}');
console.log(stringMessage.id); // "9007199254740993"
上面第一种写法把 ID 作为 JSON 数字。它进入普通的 JavaScript Number 路径时已经发生舍入,之后调用 String() 只是把当前值写成文本,无法从那个值推回原来的十进制编号。
第二种写法从 JSON 文本开始就使用字符串。引号不是最后补上的显示格式,而是数据契约的一部分。
| "id": "9007199254740993" | string | 保留原字符串 |
| "id": 9007199254740993 | number,且本例已舍入 | 拒绝,不尝试修复 |
| "id": 1 | number,数值本身安全 | 仍拒绝,保持类型契约一致 |
| "id": "001" | string | 保留前导零,不改写为 "1" |
2. “不透明标识”意味着客户端不擅自解释
ID 用于判断“是不是同一条消息”,通常不需要客户端对它做加减乘除。本文选择的教学契约是:ID 为非空、首尾无空白的原始字符串;客户端按原值保存和传递,不转成数值,也不主动去掉前导零。
这里的“首尾无空白”是本例明示的校验规则,不是所有产品的通用 ID 格式。字符串内部字符、长度上限及允许的编号形式,应由真实接口另行约定。本文没有用“全是数字”的正则,假装已经知道服务端的全部规则。
同样,不要先 trim() 再悄悄接受错误输入。若协议不允许首尾空白,应报告不符合契约;否则一次清洗就可能掩盖上游字段异常。对于需要保留的字符串,不应额外做大小写变换或其他规范化。
3. 在进入业务逻辑前检查字段,回传时保留字符串
下面给出一个最小的入站与出站边界。入站仅接收单条对象,要求 id 符合本例契约、text 为字符串;出站构造引用请求时再次检查 ID,保证 JSON 里仍带引号。
function requireMessageId(id) {
if (typeof id !== "string" || id === "" || id.trim() !== id) {
throw new TypeError("Message id must be a non-empty exact string");
}
return id;
}
function decodeMessage(json) {
const value = JSON.parse(json);
if (value === null || typeof value !== "object" || Array.isArray(value)) {
throw new TypeError("Expected one message object");
}
const id = requireMessageId(value.id);
if (typeof value.text !== "string") {
throw new TypeError("Message text must be a string");
}
return { id, text: value.text };
}
function encodeQuoteRequest(id) {
return JSON.stringify({ quotedMessageId: requireMessageId(id) });
}
这段代码不会把数字 ID 自动转为字符串,包括小整数也一样。因为一旦同时接受两种类型,调用方就更难判断某个长 ID 是否已经在前一个环节受损。
它也不承担完整消息协议校验、权限验证或网络请求。服务端仍需根据当前访问者检查目标消息是否存在、是否可访问,以及是否允许引用。保存正确标识与允许访问该标识,对应不同的校验责任。
如果旧接口仍返回数字,应该追查并调整字段契约、序列化配置与中间层,而不是在界面底部补一次 String(),再宣称精度问题已经修复。
4. reviver 和 BigInt 能否补救,要看原始信息还在不在
JSON.parse 文档说明,reviver 处理的是已经解析的值。只拿普通回调里的 value 再转字符串或 BigInt,不能恢复已经舍入掉的原始数字。
这并不意味着所有 reviver 方案都无能为力。同一文档也介绍了使用 context.source 读取原始值文本的方式。若采用这种路线,需要核对运行环境支持、字段规则及配套序列化方案。本文选择从源头使用字符串,因此不依赖该能力,也不实现另一套无损 JSON 解析器。
BigInt 适合明确需要整数运算的场景,但“可以表示大整数”不等于“应把所有 ID 转成 BigInt”。转成整数会抹去前导零等字符串区别;从已经舍入的 Number 创建 BigInt,也无法找回丢失信息。
另外,BigInt 的 JSON 说明指出,未作额外处理时,JSON.stringify() 不会默认把 BigInt 序列化为普通 JSON 值。引入这种类型,需要明确输入、运算与输出边界;单纯透传标识时,原样字符串更容易检查。
5. 把验证放在原始 JSON 两侧
独立验证从本文原样提取两段 JavaScript,使用本地 Node.js 与合成消息运行。检查既覆盖演示输出,也覆盖字段拒绝、前导零、原文保留、JSON 往返和引用请求的类型。
| 解析未加引号的超范围示例 | 复现本例中的舍入结果 |
| 对已经舍入的值调用 String | 得到舍入后文本,不能恢复 |
| 以字符串传输两个相邻长 ID | 两者保持不同 |
| 解码字符串 ID,再编码引用请求 | 请求字段仍是相同字符串 |
| 输入数字、空值或空白 ID | 拒绝,不自动补救 |
| 输入 "001" 和 "1" | 保持两个不同标识 |
| 正文带空格和换行 | 正文原样保留 |
此外,用一组连续的长整数字符串检查编码往返,防止只测一个恰好没有问题的值。测试中的整数生成使用 BigInt;它只用于制作精确的合成输入,没有替换正文的字符串协议。
这些验证没有调用真实消息接口,也没有查询用户聊天记录,不能写成已经验证了产品的服务端编号系统。
排查真实问题时,应对照原始 JSON 字段、解析后的 typeof、各层模型定义和最终请求内容。特别留意自动生成的客户端模型、对象映射、缓存及格式化工具里,是否存在隐式数值转换;诊断日志无需记录聊天正文。
6. 标识的准确性应从源头贯穿到使用点
一个 ID 即使在列表里显示正常,也可能在详情查询、引用回传或缓存键生成时被转换。只修一个显示位置,无法覆盖整条数据路径。
明确字段契约,在入口拒绝错误类型,传递过程中保留原值,出口再次确认类型,可以让这类问题更早暴露。若数据已经在上游丢失精度,就回到仍保存原始信息的环节修正,避免继续传播一个看似合理的错误编号。
本文为独立教学示例,部分内容由 AI 辅助整理,代码与发布内容经独立核对。