1.prompt后面输入的自动转为字符串 可以在前面加+转成数字型
2.三元运算符 :? 与 : 配合使用。

3.switch语句:
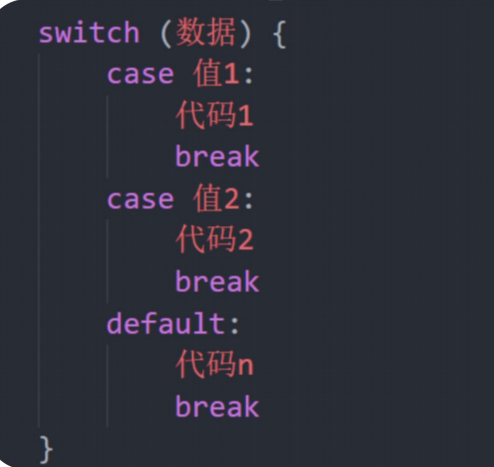
1).找到跟小括号里数据全等的case值,并执行里面对应的代码
2).若没有全等===的则执行default里的代码
例:数据若跟值2全等,则执行代码2
1.switchcase语句一般用于等值判断,不适合于区间判断
2.switchcase一般需要配合break关键字使用没有break会造成case穿透
4.while循环:
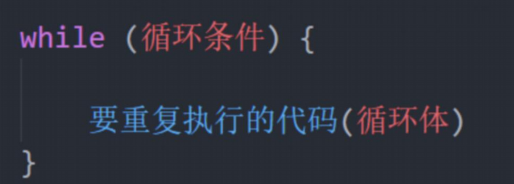
while大括号里代码执行完毕后不会跳出,而是继续回到小括号里判断条件是否满足,若满足又执行大括号里的代码,然后再回到小括号判断条件,直到括号内条件不满足,即跳出。
while循环需要具备三要素:
1. 变量起始值
2. 终止条件(没有终止条件,循环会一直执行,造成死循环)
3. 变量变化量(用自增或者自减)
5.循环结束:
1).break:退出循环
2).continue:结束本次循环,继续下次循环
区别:
1).continue 退出本次循环,一般用于排除或者跳过某一个选项的时候, 可以使用continue
2).break 退出整个循环,一般用于结果已经得到, 后续的循环不需要的时候可以使用
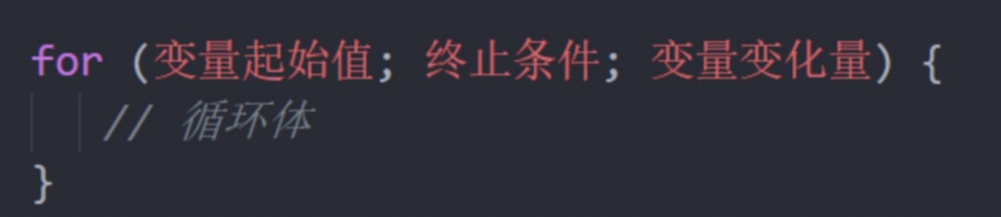
6.for循环:
1).作用:重复执行代码
2).好处:把声明起始值、循环条件、变化值写到一起,让人一目了然,它是最常使用的循环形式
7.数组:
1).数组是按顺序保存,所以每个数据都有自己的编号
2).计算机中的编号从0开始,所以小明的编号为0,小刚编号为1,以此类推
3).在数组中,数据的编号也叫索引或下标
4).数组可以存储任意类型的数据
a).元素:数组中保存的每个数据都叫数组元素
b).下标:数组中数据的编号
c).长度:数组中数据的个数,通过数组的length属性获得
8.遍历数组用循环
1).未赋值的变量是undefined
2).数组操作:增删改查
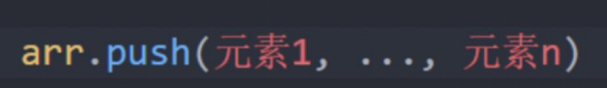
3).数组添加新的数据:
arr.push(新增的内容) 将一个或多个元素添加到数组的末尾,并返回该数组的新长度 (重点)
arr.unshift(新增的内容) 将一个或多个元素添加到数组的开头,并返回该数组的新长度
删除数组中数据:
arr.pop() 从数组中删除最后一个元素,并返回该元素的值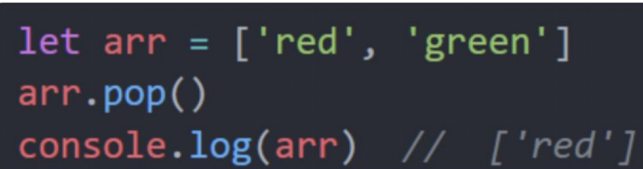
arr.shift() 从数组中删除第一个元素,并返回该元素的值
arr.splice(操作的下标,删除的个数)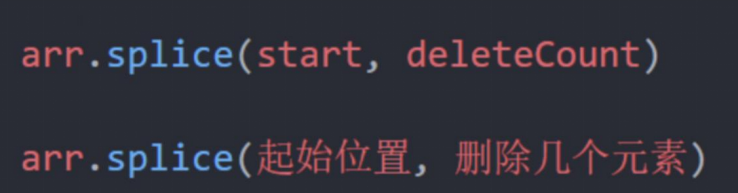
start 起始位置: 指定修改的开始位置(从0计数)
deleteCount: 表示要移除的数组元素的个数 可选的。 如果省略则默认从指定的起始位置删除到最后
重新赋值: 数组[下标] = 新值
查询数组数据: 数组[下标] 或者我们称为访问数组数据
9.冒泡排序:
1).冒泡排序是一种简单的排序算法。
2).它重复地走访过要排序的数列,一次比较两个元素,如果他们的顺序错误就把他们交换过来。走访数列的工作是重复地进行直到没有再需要交换,也就是说该数列已经排序完成。\\n这个算法的名字由来是因为越小的元素会经由交换慢慢“浮”到数列的顶端。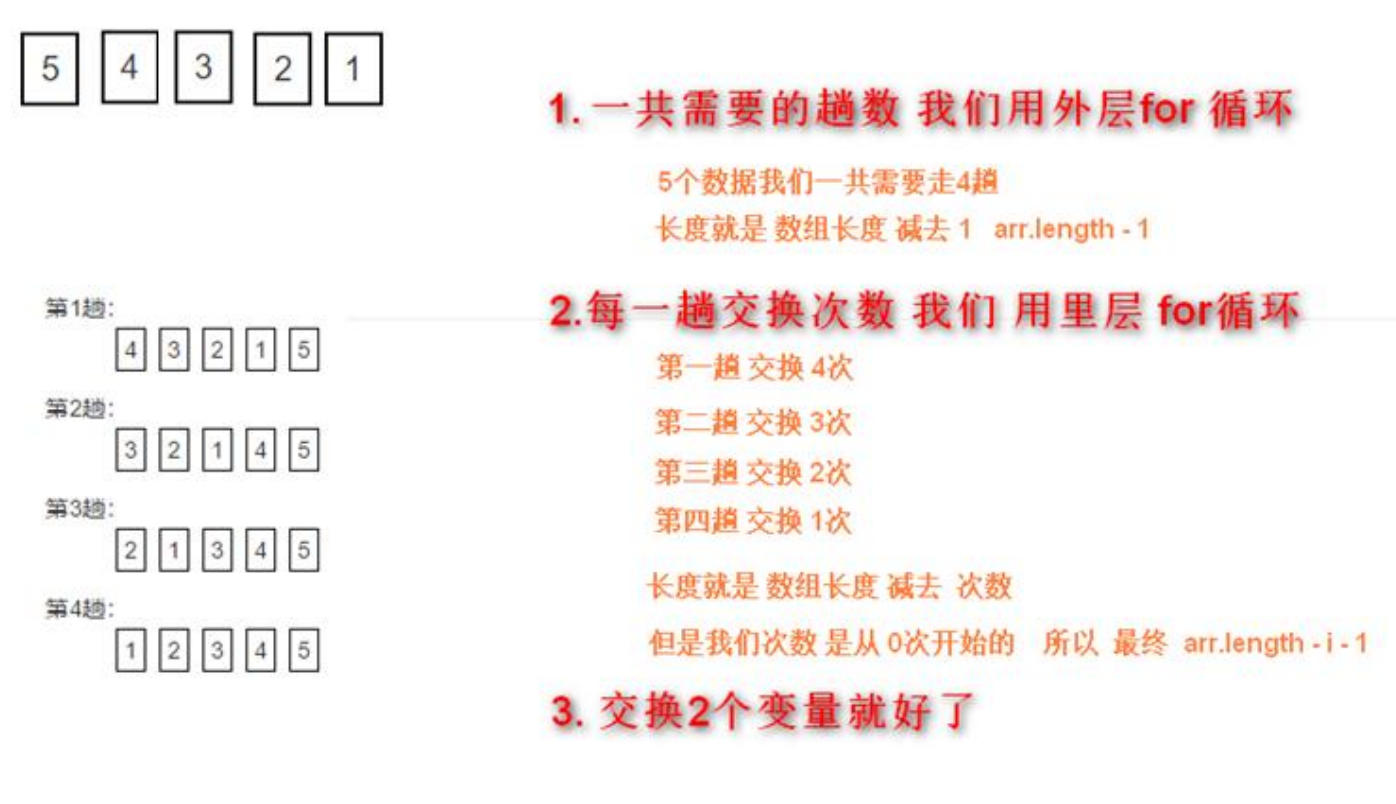
数组. sort() 方法可以排序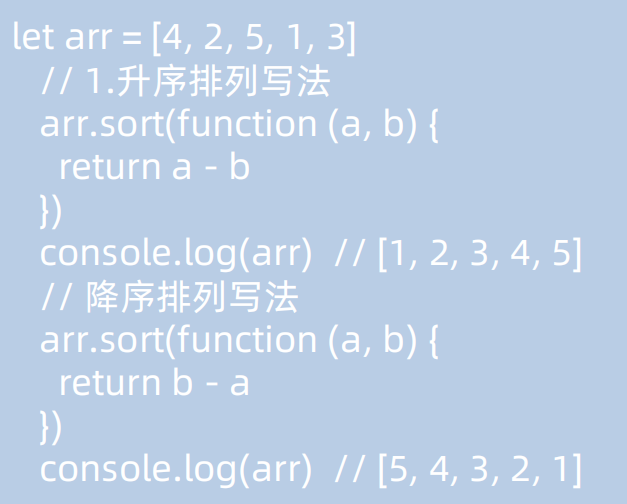
10.函数:
1).函数名:function,是被设计为执行特定任务的代码块 说明:
2).函数可以把具有相同或相似逻辑的代码“包裹”起来,通过函数调用执行这些被“包裹”的代码逻辑,这么做的优势是有利于精简代码方便复用。
3).函数的声明语法:
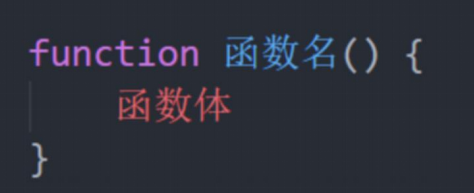
4).若函数完成功能需要调用者传入数据,那么就需要用有参数的函数.
这样可以极大提高函数的灵活性.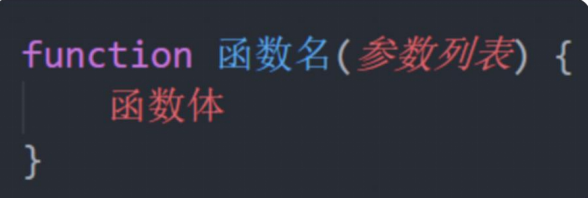
11.参数列表
Ø 传入数据列表
Ø 声明这个函数需要传入几个数据
Ø 多个数据用逗号隔开
如: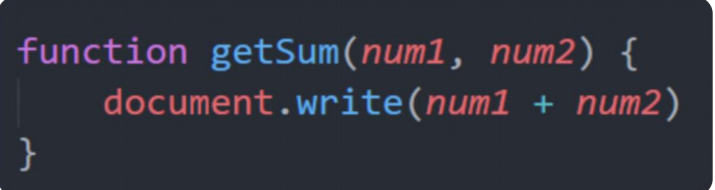
1).形参:声明函数时写在函数名右边小括号里的叫形参(形式上的参数)
2).实参:调用函数时写在函数名右边小括号里的叫实参(实际上的参数)
形参可以理解为是在这个函数内声明的变量(比如 num1 = 10)实参可以理解为是给这个变量赋值
开发中尽量保持形参和实参个数一致
我们曾经使用过的 alert('打印'), parseInt('11'), Number('11') 本质上都是函数调用的传参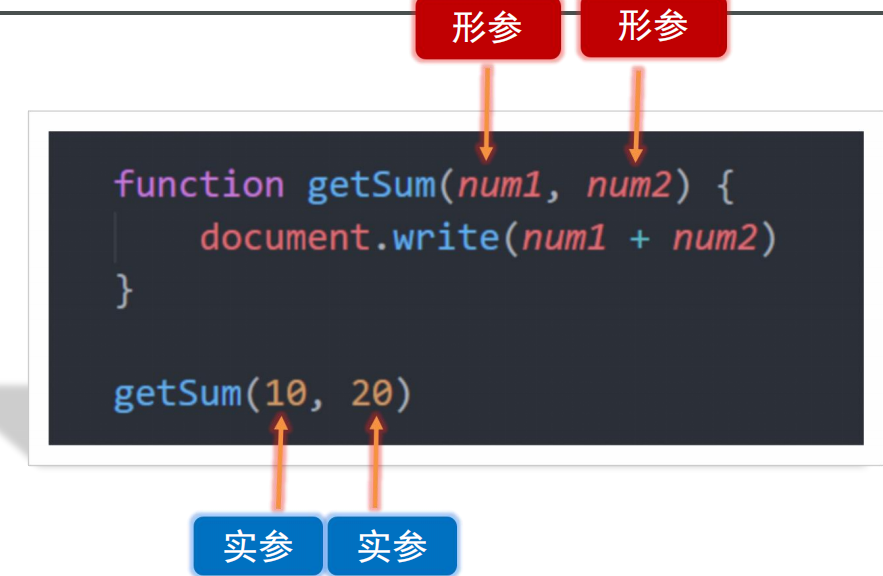
注:形参: 可以看做变量,但是如果一个变量不给值,默认是undefined
但是如果做用户不输入实参,刚才的案例,则出现 undefined + undefined 结果是NaN
用户不输入实参,可以给 形参默认值,可以默认为 0, 这样程序更严谨,可以如下操作: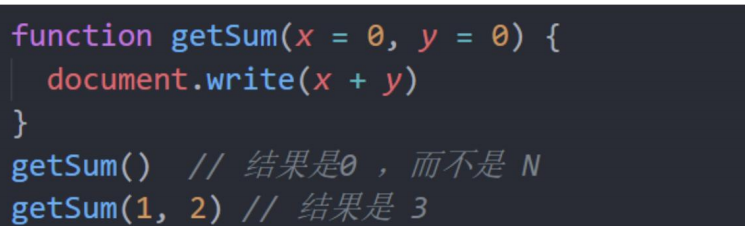
说明:这个默认值只会在缺少实参参数传递时 才会被执行,所以有参数会优先执行传递过来的实参, 否则默认为 undefined。
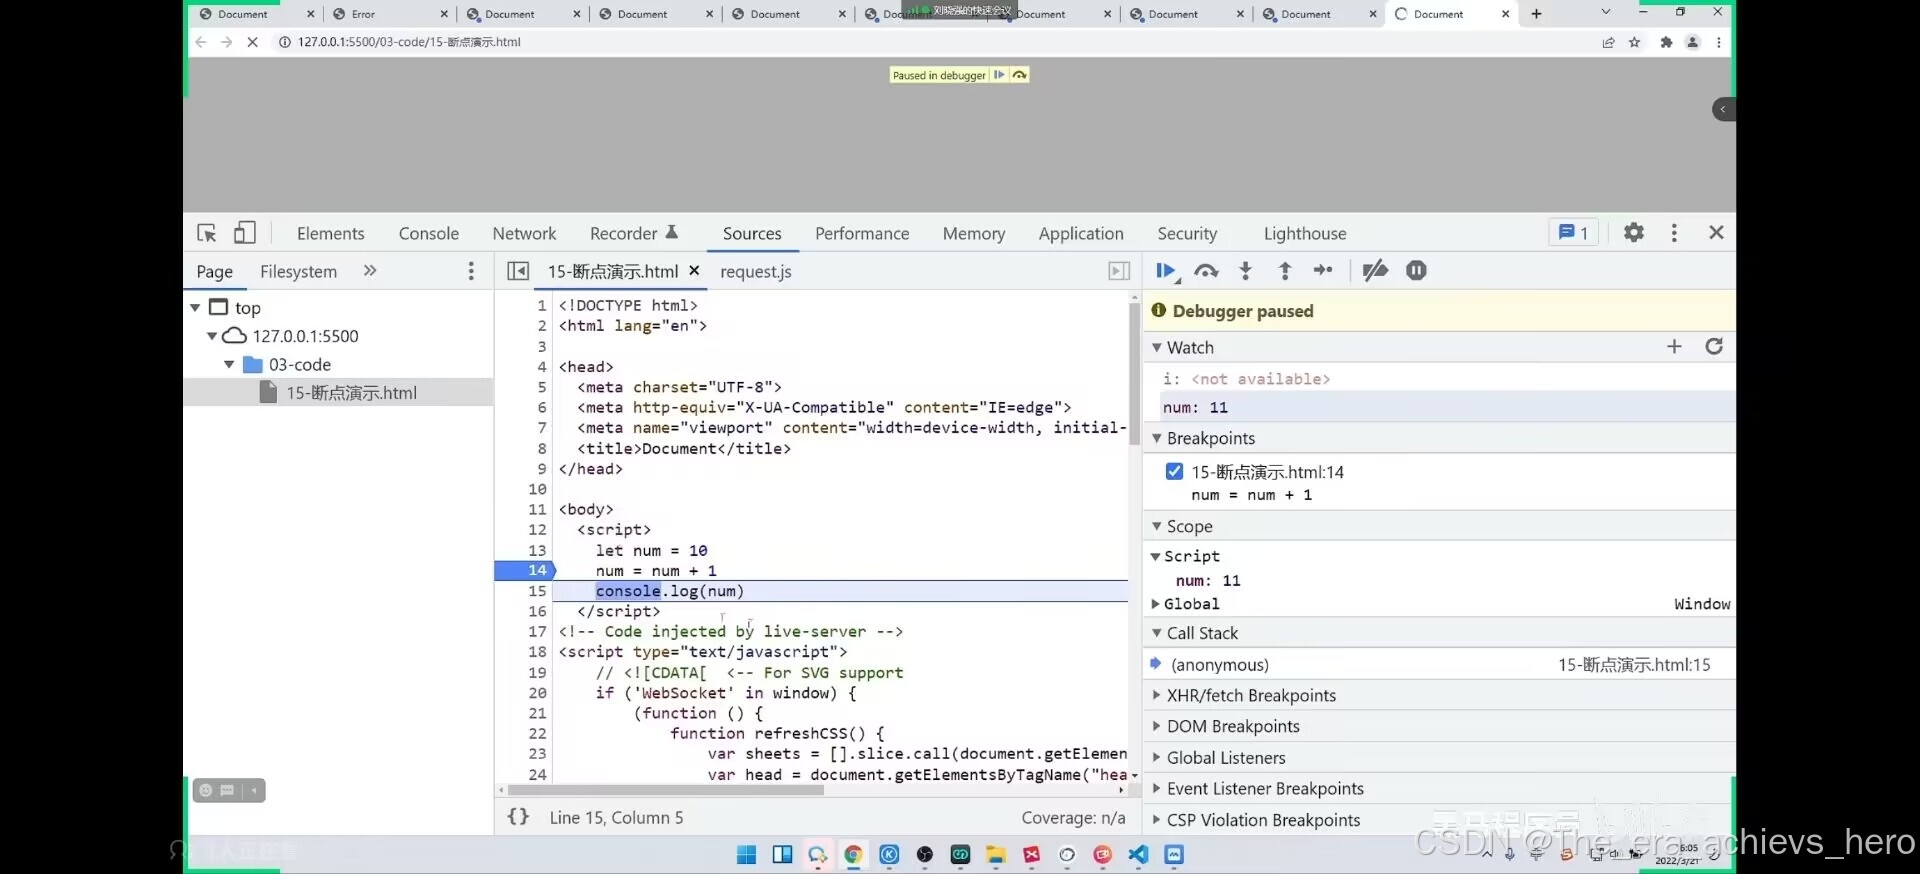
补充:1.断点测试:
作用:工作可以更好找到bug
打开F12开发者工具
点到sources一栏
选择代码文件