【爬取目标】
目标网站:携程酒店
在旅游行业分析、酒店价格监测、竞品市场调研等场景中,酒店的价格、评分、点评和地理位置数据具有重要价值。携程作为国内领先的在线旅游平台,酒店列表数据通过新版页面动态加载,且翻页数据依赖接口返回,手动采集效率极低。因此本文将教你使用 Python 的 DrissionPage 自动化框架,驱动浏览器访问携程酒店列表页,通过监听翻页接口数据包 + 解析首屏 DOM 卡片两种方式获取酒店数据,自动检测登录状态并暂停等待用户手动登录,最终把数据保存到 CSV 文件,并基于采集结果生成价格分布、评分分布、价格与评分关系、评分级别占比、热门区域排行等多张可视化图表,实现从数据采集到可视化分析的完整流程!
获取字段如下:酒店名称、综合评分、评分级别、点评数量、价格、房型、区域、酒店标签、评论摘要、酒店ID、环境、卫生、服务、设施、图片URL,共 15 个字段,如图所示: 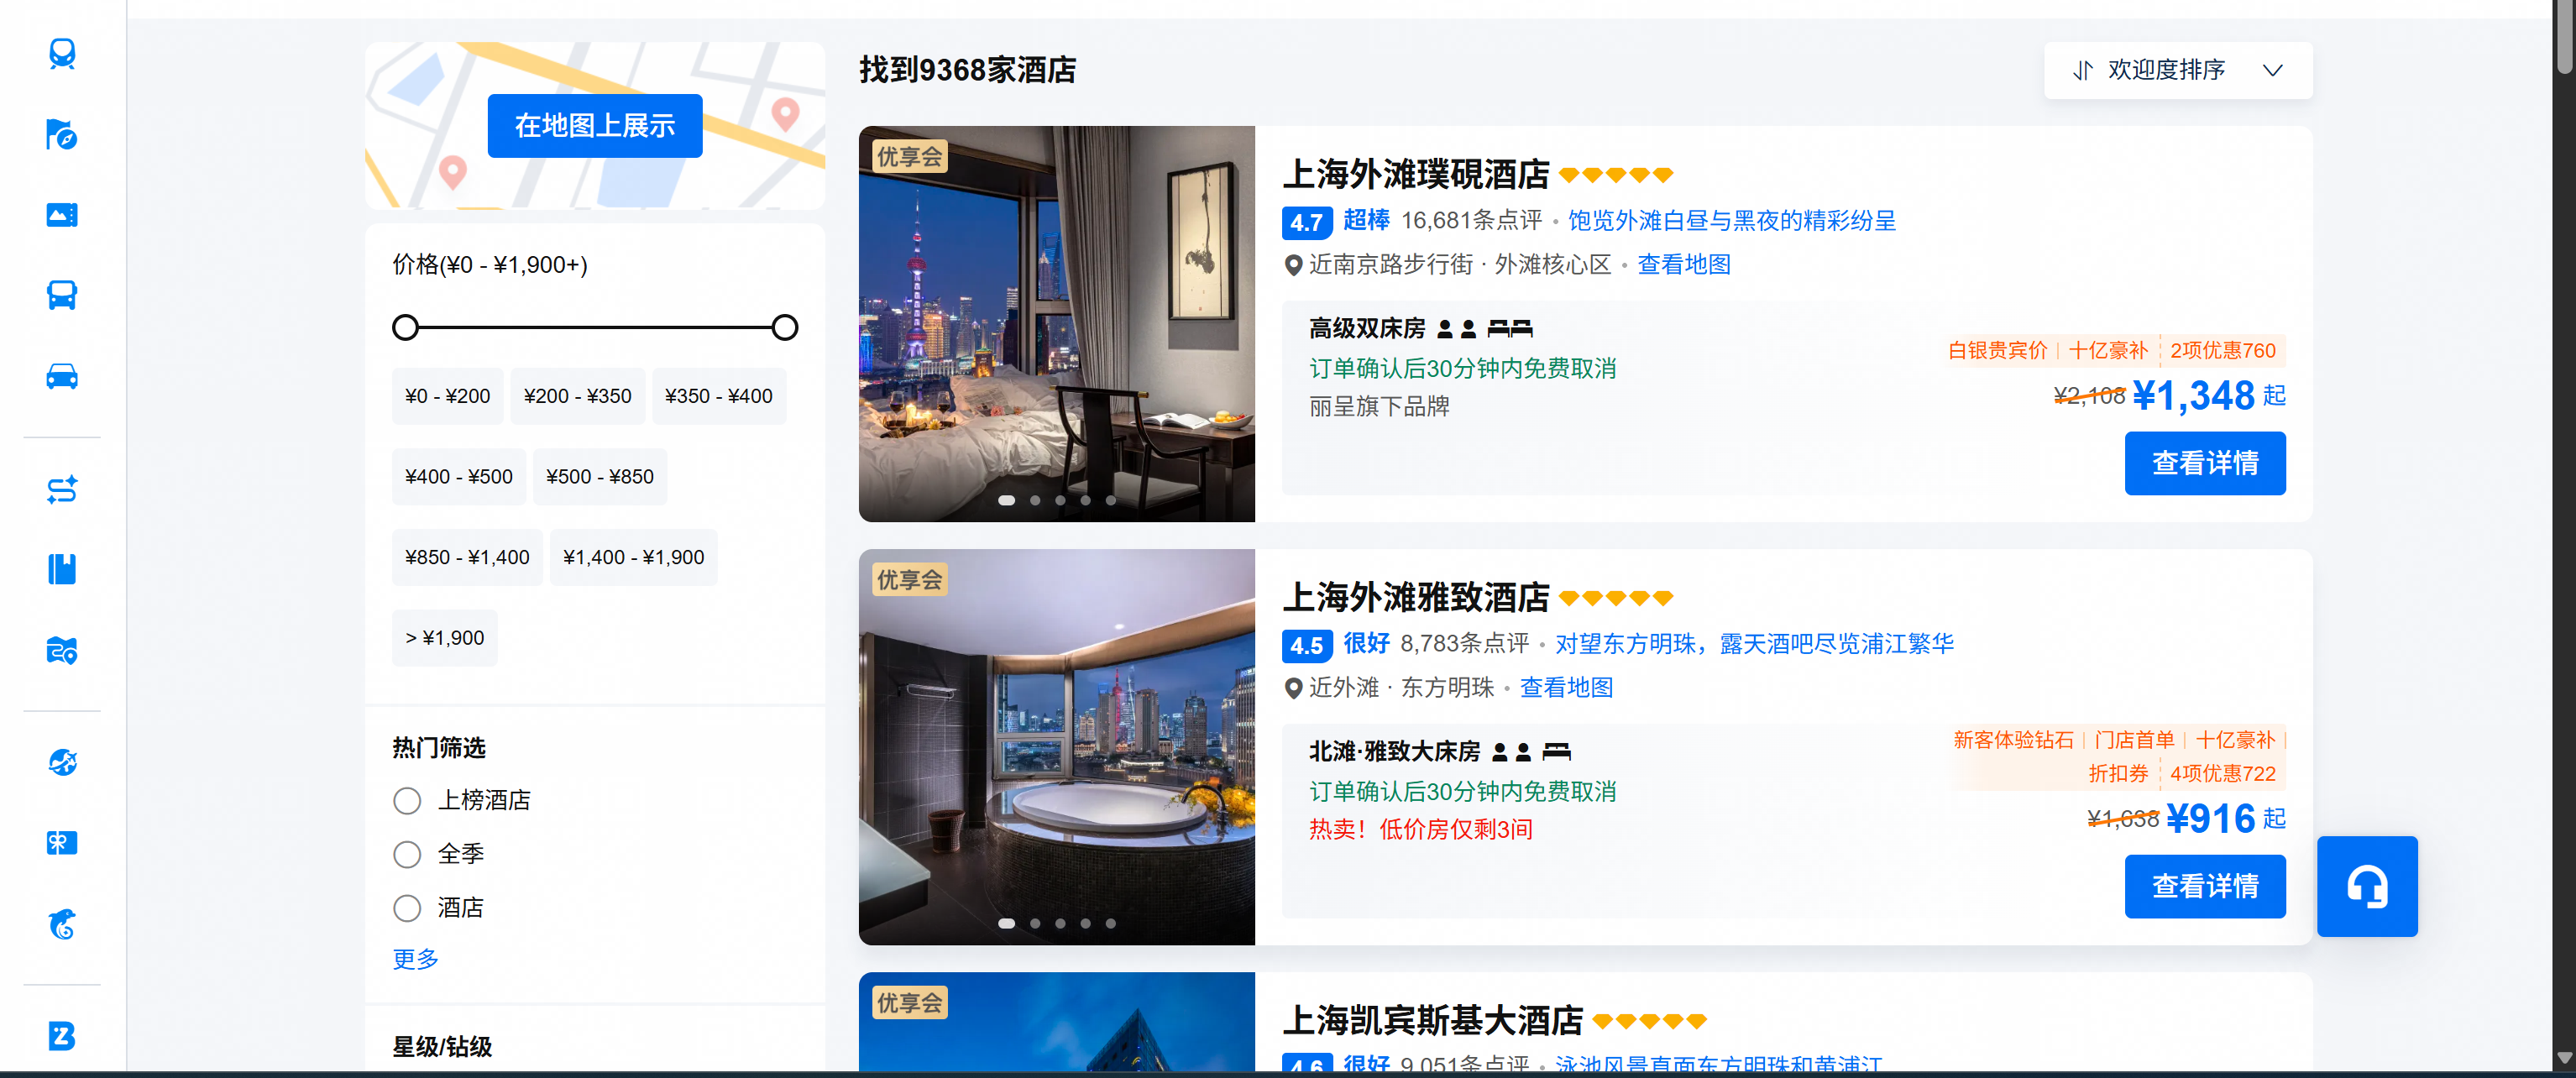
【实现效果】
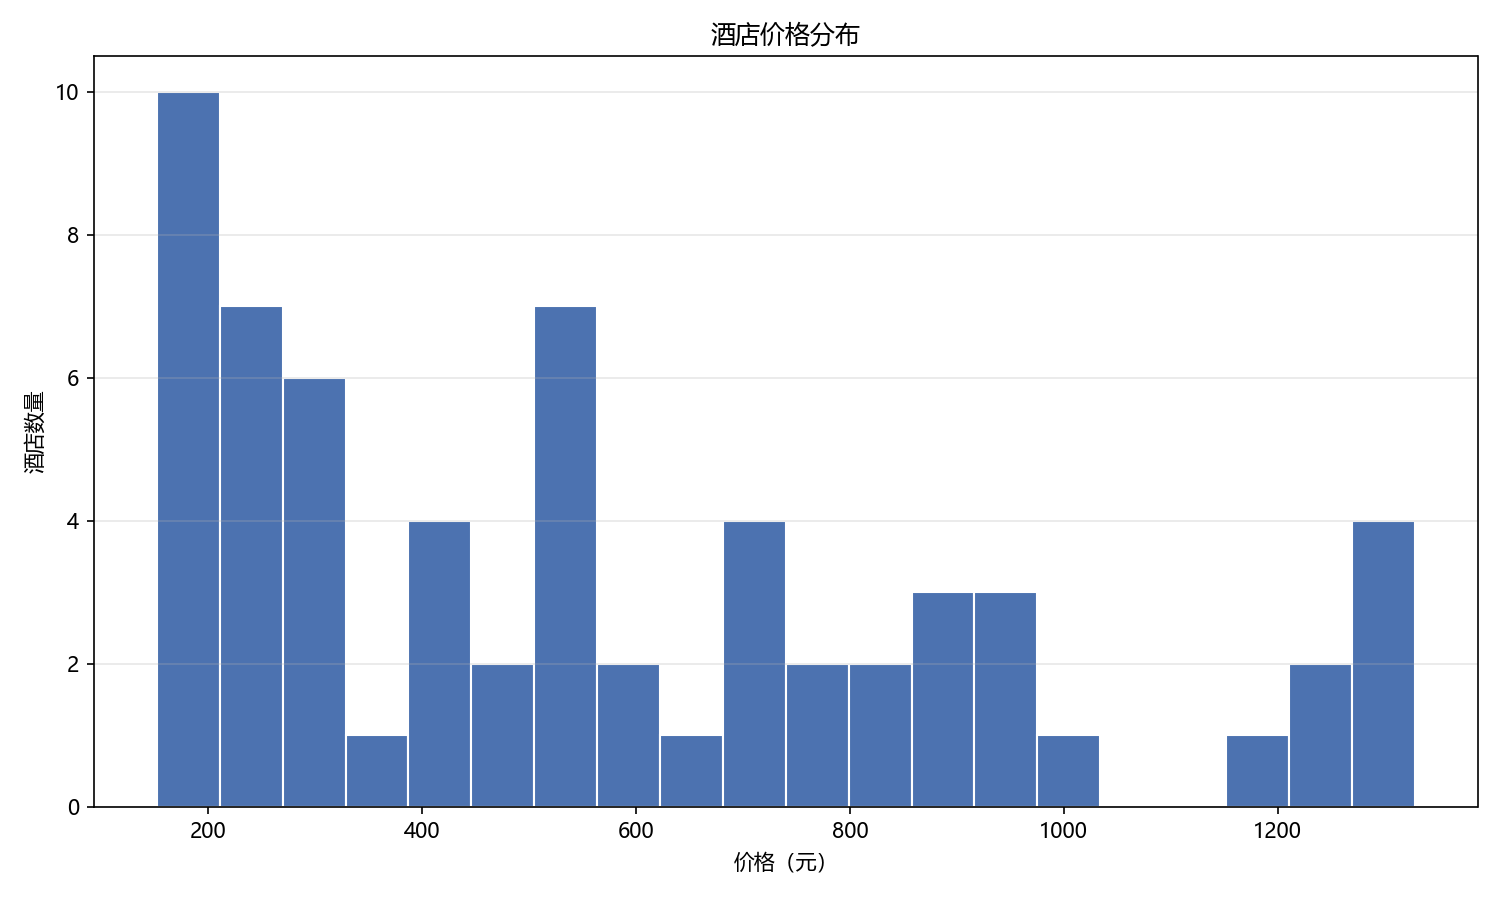
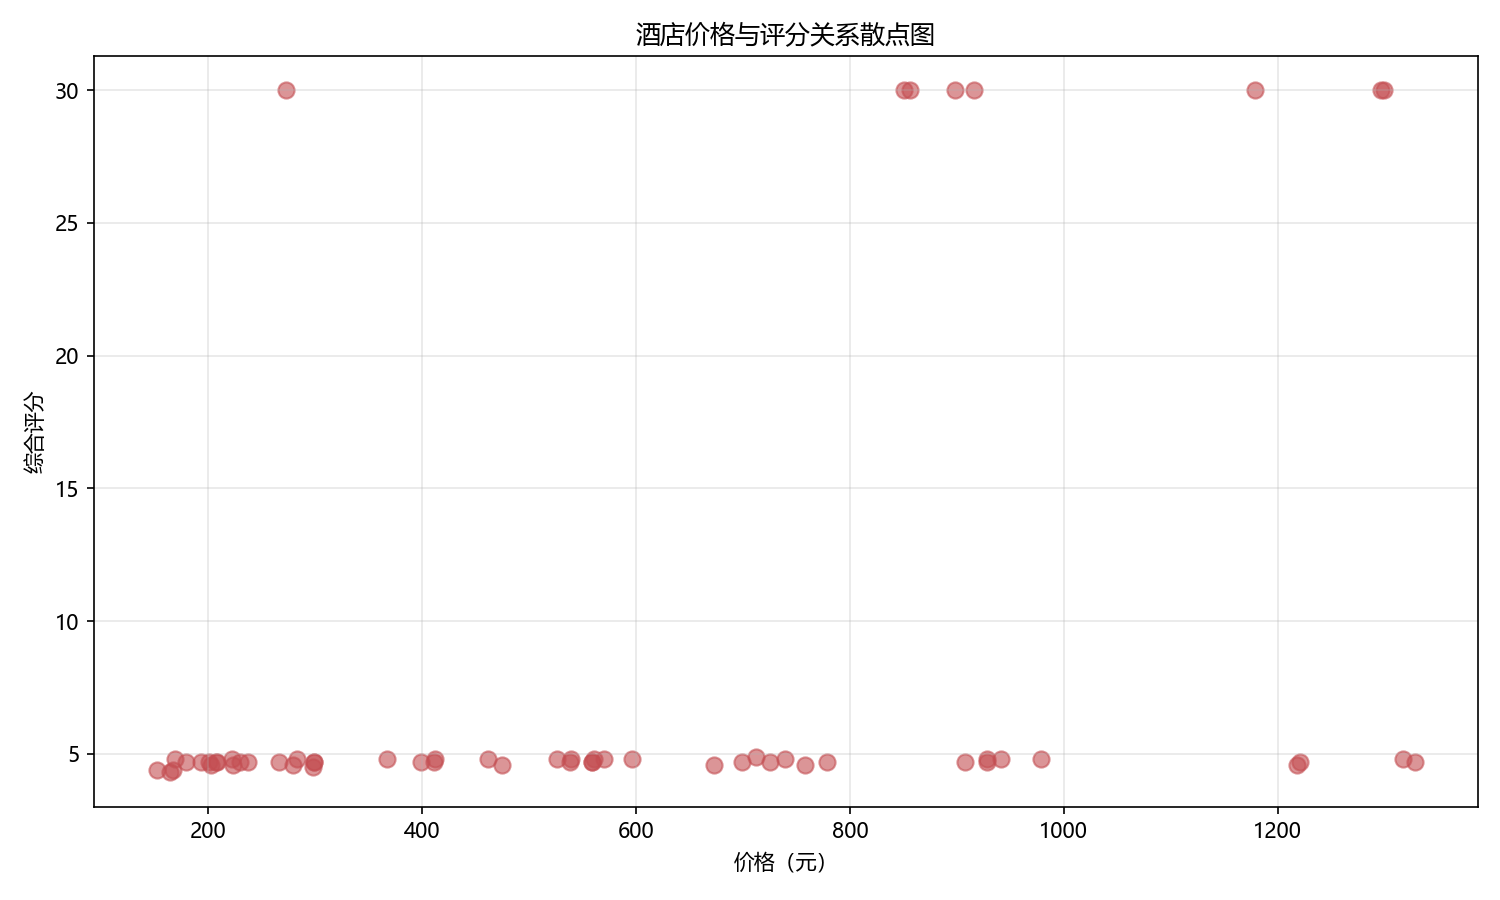
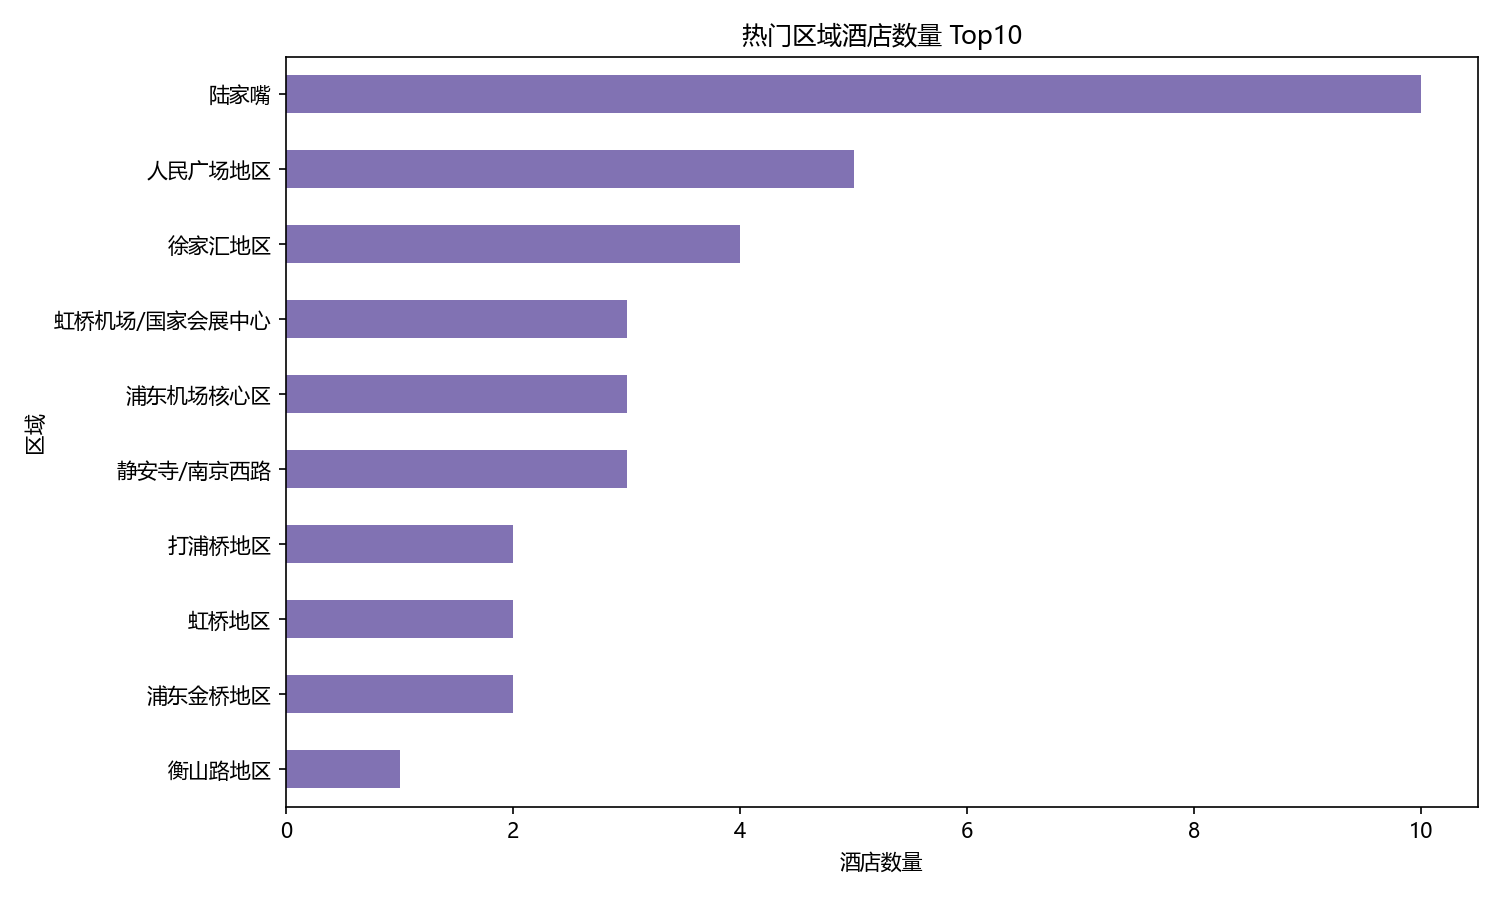
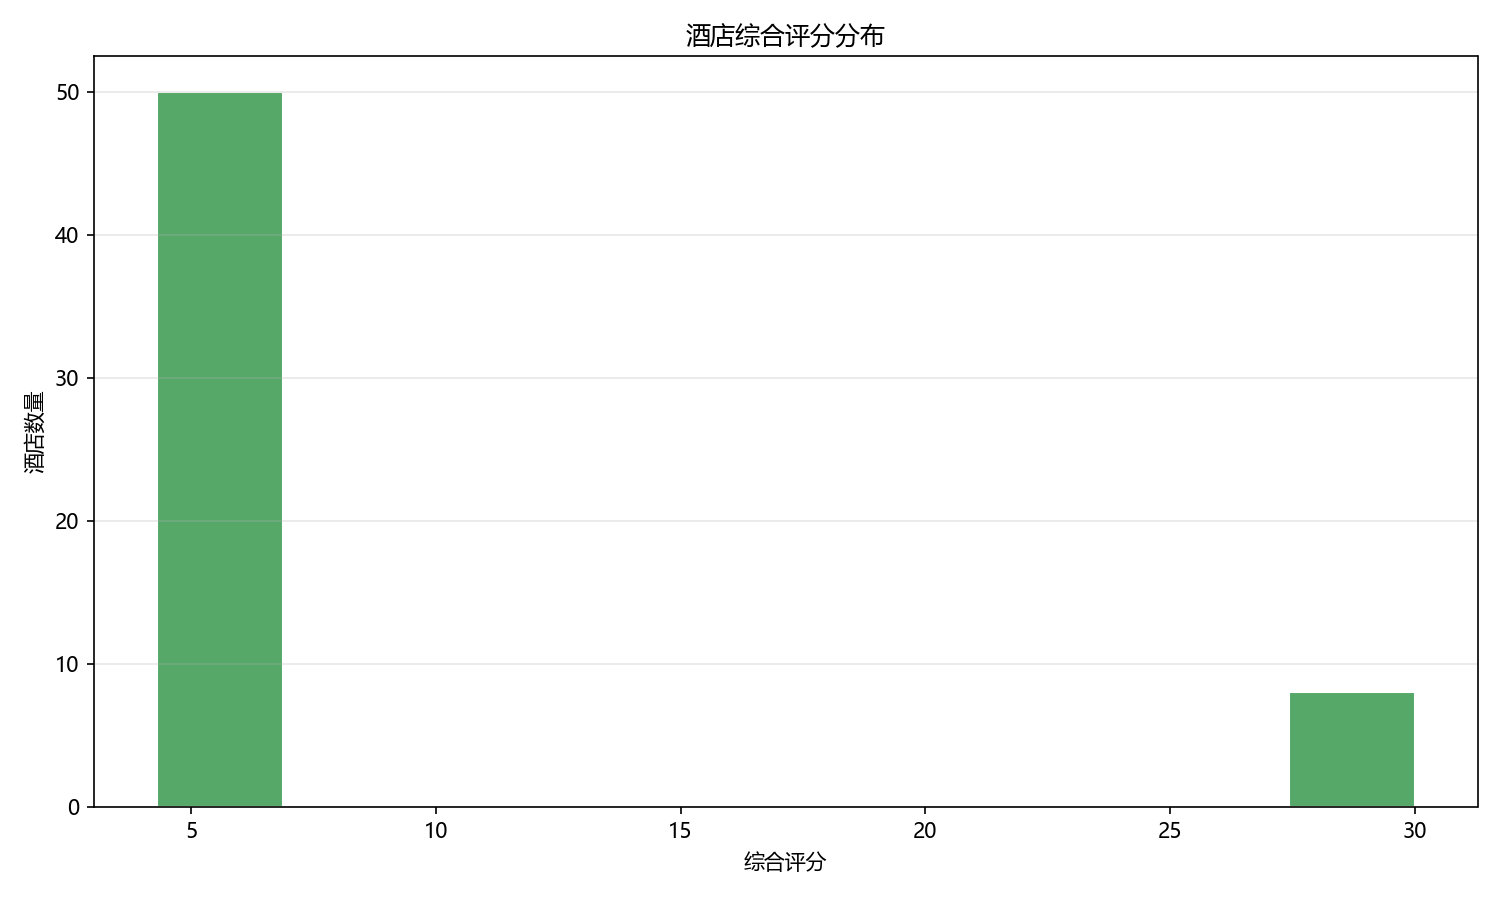
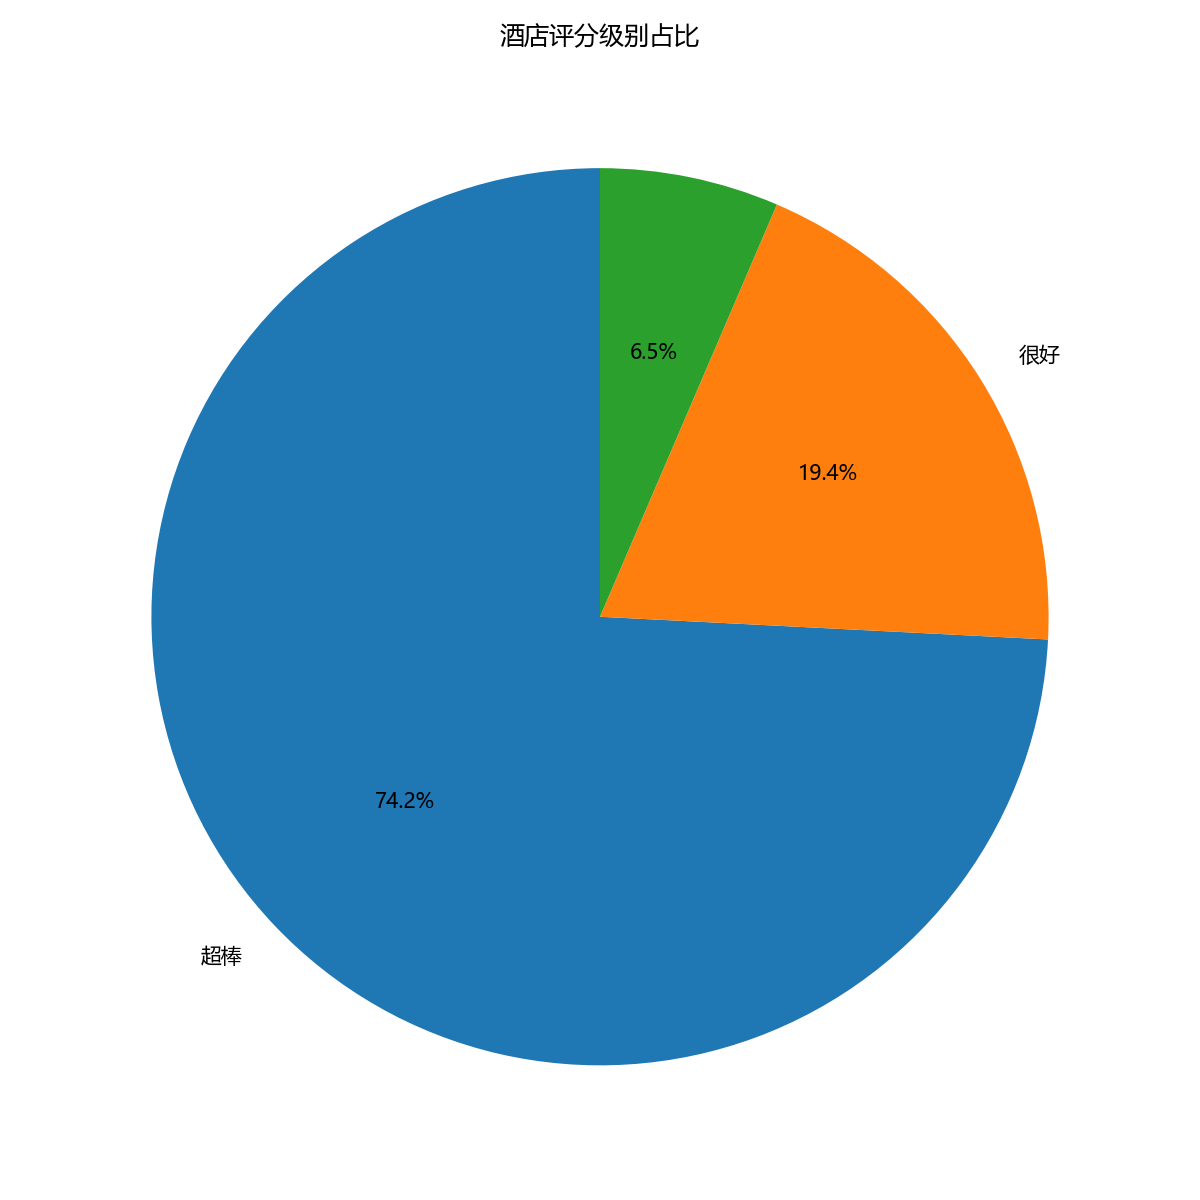
代码使用 DrissionPage 自动打开浏览器访问携程酒店列表页,先检测页面是否需要登录(URL 跳转 passport 登录域名、或出现\”扫码登录\”弹窗),需要登录时程序暂停,等待用户手动登录后按回车继续。新版页面是 Next.js SSR 渲染:首屏 12 家酒店直接渲染在网页源码中、不经过接口,因此脚本先解析首屏 DOM 卡片;向下滚动页面后,翻页数据通过 m.ctrip.com/restapi/soa2/34951/fetchHotelList 接口以 JSON 格式返回,脚本监听该接口数据包逐页提取酒店字段,两部分数据用 hotelId 去重合并后写入 CSV。全部数据采集完成后,自动调用数据分析模块:利用 pandas 统计价格、评分、评分级别、区域分布,利用 matplotlib 生成 5 张统计图表:
文章目录
- 一、技术栈和环境版本
- 二、爬虫实战分析
-
- 2.1 导入模块
- 2.2 分析网页,定位酒店列表数据接口(详细抓包过程)
-
- 第一步:打开开发者工具,观察首屏加载的请求
- 第二步:滚动页面,找到翻页数据接口
- 第三步:分析接口的响应数据结构
- 第四步:分析首屏 DOM 卡片结构
- 第五步:总结抓包规律
- 2.3 创建浏览器并检测登录状态
- 2.4 解析首屏酒店卡片
- 2.5 解析接口返回的酒店数据
- 2.6 保存酒店数据到 CSV
- 2.7 数据分析:价格分布与评分分布
- 2.8 数据分析:价格与评分关系、评分级别占比
- 2.9 数据分析:热门区域酒店 Top10
- 2.10 主函数——串联采集与分析全流程
- 三、完整爬虫代码
- 四、总结
- 五、专栏说明
一、技术栈和环境版本
Python版本:3.12.x
编辑器:PyCharm / VS Code
python内置模块:
import csv # CSV文件读写,用于酒店数据持久化
import json # JSON解析,处理接口返回的酒店数据
import os # 拼接输出文件路径
import re # 正则表达式,从卡片文本提取价格/点评数
import time # 延时等