音频每秒 16000 个采样,视频每秒 30 帧。三层步长为 2 的卷积把音频时间长度约缩为八分之一,输出仍约每秒 2000 个位置,而不是 30 个。把张量长度变短,不能自动完成时钟对齐。
10 月 8 日的 ARC 机器人推理论文关注推理与具体动作后果的联系。对多模态控制来说,输入对应的是哪个时刻,常常比再增加一层融合模块更先决定结果是否可信。
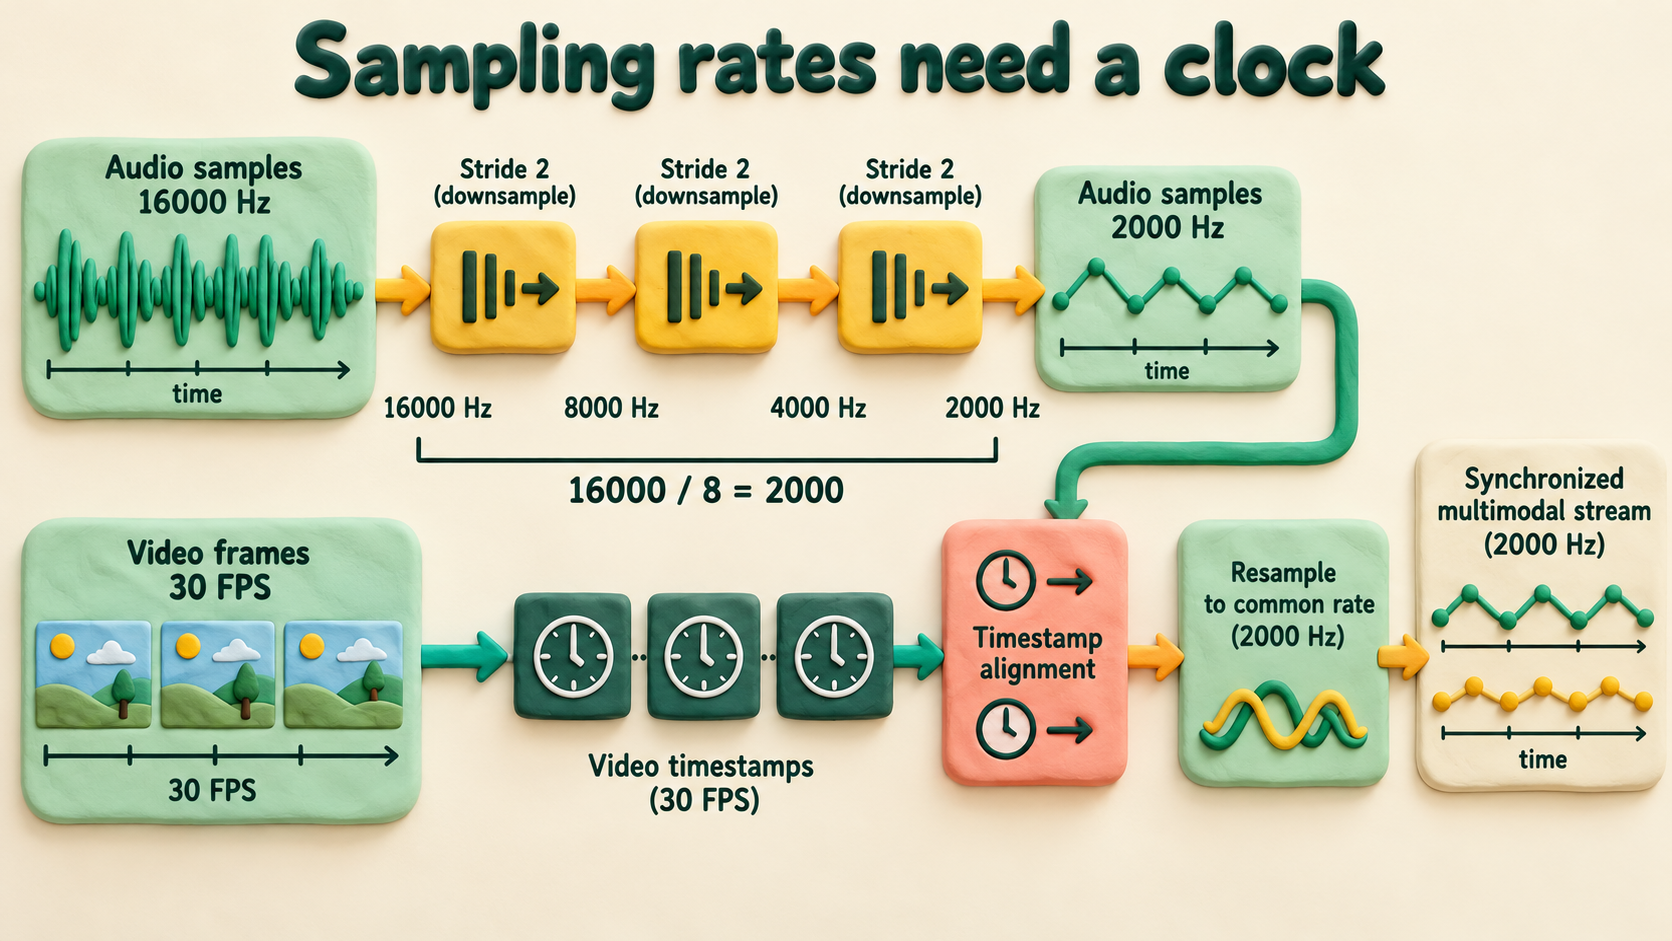
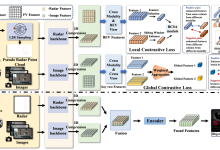
图中把视频插值到 2000 Hz,是一种可选的公共时间网格,不会凭空生成每秒 2000 帧的新视觉信息。也可以把音频特征按视频时间窗池化,或者让异步注意力消费原始时间戳。选择取决于任务、延迟和传感器时钟,而不取决于两个张量能否凑成相同长度。
下面用有理数算每帧覆盖的音频样本区间,避免浮点取整累积漂移。区间左闭右开,末端截断;该例采用理想同起点、无漂移时钟。
from fractions import Fraction
def frame_windows(audio_rate, fps, frame_count):
if audio_rate <= 0 or fps <= 0 or frame_count < 0:
raise ValueError("invalid rate or count")
ratio = Fraction(audio_rate, fps)
edges = [(i * ratio).numerator // (i * ratio).denominator
for i in range(frame_count + 1)]
return list(zip(edges, edges[1:]))
windows = frame_windows(16000, 30, 30)
assert windows[0][0] == 0
assert windows[-1][1] == 16000
assert all(a[1] == b[0] for a, b in zip(windows, windows[1:]))
assert set(b-a for a, b in windows) == {533, 534}
assert 16000 // (2**3) == 2000
print("first windows=", windows[:3])
print("covered samples=", sum(b-a for a, b in windows))
533 与 534 交替分配,才覆盖完整的一秒。始终取 533,每秒就会少覆盖 10 个样本。真实摄像头还可能丢帧、采用可变帧率;音频和视频设备的硬件时钟也可能逐渐漂移。因此应使用采集时间戳,区分曝光时间、传输到达时间和模型消费时间。
卷积输出长度还受 kernel、padding 和 dilation 影响,不能只写输入长度除以八。降采样前也应考虑抗混叠。本文没有处理真实音视频、没有实现滤波器,也没有测同步精度;已经验证的是理想时钟下的区间覆盖与算术关系。没有这些基本约定,“低延迟融合”的数字很难解释。