/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
🔥小叶-duck:个人主页
❄️个人专栏:《Data-Structure-Learning》《C++入门到进阶&自我学习过程记录》 《Linux系统从入门到实践》《Linux网络从入门到实践》 《Qt 方寸极境》 《MySQL》
✨未择之路,不须回头 已择之路,纵是荆棘遍野,亦作花海遨游
目录
前言
一、IO 的本质:等待 + 拷贝
1.1 IO 是什么
1.2 为什么 IO 比较慢
1.3 如何理解高效 IO
二、五种 IO 模型详解
2.1 钓鱼故事:五位人物对应五种 IO 模型
2.1.1 阻塞 IO(Blocking IO)
2.1.2 非阻塞 IO(Non-blocking IO)
2.1.3 信号驱动 IO(Signal-driven IO)
2.1.4 IO 多路复用(IO Multiplexing)
2.1.5 异步 IO(Asynchronous IO)
2.2 同步 IO vs 异步 IO
2.3 五种 IO 模型图表总结
三、非阻塞 IO
3.1 fcntl 系统调用
3.1.1 函数原型
3.1.2 fcntl 五大核心功能
3.2 非阻塞 IO 实战:基于 fcntl 实现
3.2.1 封装实现 SetNoBlock 函数
3.2.2 read 函数返回值详解
3.2.3 非阻塞 IO 实战:轮询读取标准输入
结束语
前言
在 Linux 网络编程开发中,IO 模型是支撑高并发服务的底层基石,也是面试高频考点。很多同学在学习 socket 编程时,只会调用接口,却不清楚不同 IO 模型背后的等待与拷贝逻辑,难以理解高并发方案选型的底层原因。
本文会从 IO 的本质入手,先拆解 IO 的两个核心阶段:等待数据就绪、内核数据拷贝到用户空间,解释 IO 性能瓶颈的来源,以及高效 IO 的设计思路。随后借助钓鱼的通俗案例,逐一讲解阻塞 IO、非阻塞 IO、信号驱动 IO、IO 多路复用、异步 IO 这五种经典 IO 模型,区分同步与异步 IO 的核心差异。
最后落地到代码实战,讲解fcntl系统调用,动手封装非阻塞工具函数,结合标准输入的轮询案例,完整演示非阻塞 IO 的编码写法与返回值处理。通过原理 + 案例 + 代码的方式,帮你吃透 Linux 下各类 IO 模型的底层逻辑。
一、IO 的本质:等待 + 拷贝
1.1 IO 是什么
在系统与网络编程场景中,IO 就是 Input 输入、Output 输出。我们平时写代码调用read、recv、write、send这类 IO 接口时,大部分耗时其实都消耗在等待数据的阶段。
从操作系统视角来看,一次完整的 IO 操作,可以拆成两个不可分割的阶段:
由此得到核心结论:IO = 等待 + 拷贝。 很多人狭义上只把数据拷贝理解成 IO,但完整的 IO 流程,等待和拷贝两个环节缺一不可。网卡、路由器等硬件负责长距离的数据转发,是数据抵达内核缓冲区的物理基础。后续所有 IO 模型,本质都是在这两个阶段做优化。
1.2 为什么 IO 比较慢
结合 IO = 等待 + 拷贝 这个公式分析效率: 拷贝是硬件执行动作,硬件速率固定,软件层面几乎很难提升拷贝本身的速度。 IO 低效的根本原因,是等待环节在整个 IO 流程里的时间占比太高。尤其是网络 IO,数据要经过远距离传输、路由器转发,等待耗时往往是拷贝耗时的成百上千倍。
高效 IO 的核心目标:在单位时间内,尽可能降低等待环节的时间占比。
1.3 如何理解高效 IO
我们用钓鱼的生活化例子来类比 IO 全过程,这个类比会贯穿后面所有 IO 模型的讲解:
- 钓鱼的人 = 应用进程
- 鱼竿 = 文件描述符(fd)
- 鱼漂 = 就绪事件,标记数据是否准备完成
- 鱼 = 需要读写的数据
- 池塘 = 网络或者磁盘
钓鱼同样分为两步:等鱼咬钩(等待) + 提竿捞鱼(拷贝)
- 低效钓鱼:绝大部分时间都在原地等待鱼咬钩,等待时间占比极高。
- 高效钓鱼:减少无效等待,或者在等待的间隙去处理其他事务。
提升 IO 效率的核心思路就和钓鱼一致:降低 IO 流程中等待环节的时间占比。
二、五种 IO 模型详解
2.1 钓鱼故事:五位人物对应五种 IO 模型
我们继续沿用前面钓鱼的生活化类比,五位钓鱼者不同的行为模式,分别对应操作系统里五种经典 IO 模型。
- 张三 — 阻塞 IO
- 李四 — 非阻塞 IO
- 王五 — 信号驱动 IO
- 赵六 — IO 多路复用
- 田七 — 异步 IO
核心公式:IO = 等待 + 拷贝。下面所有模型,都围绕这两个阶段做不同的设计。

2.1.1 阻塞 IO(Blocking IO)
对应人物:张三 张三是新手钓鱼者,全程死死盯着鱼漂。鱼漂不动就原地等待,不做任何其他事情;只有鱼漂晃动(鱼咬钩)时,才会执行提竿捞鱼的动作。 核心特征:被等待动作阻塞,等待期间无法执行其他事务。

工作流程
优缺点:
优点:逻辑简单,代码编写方便,所有 Socket 套接字默认都是阻塞模式。 缺点:一个线程同一时间只能处理一个 IO。高并发场景下,需要大量线程,会带来巨大的线程创建与上下文切换开销,系统性能下降。

2.1.2 非阻塞 IO(Non-blocking IO)
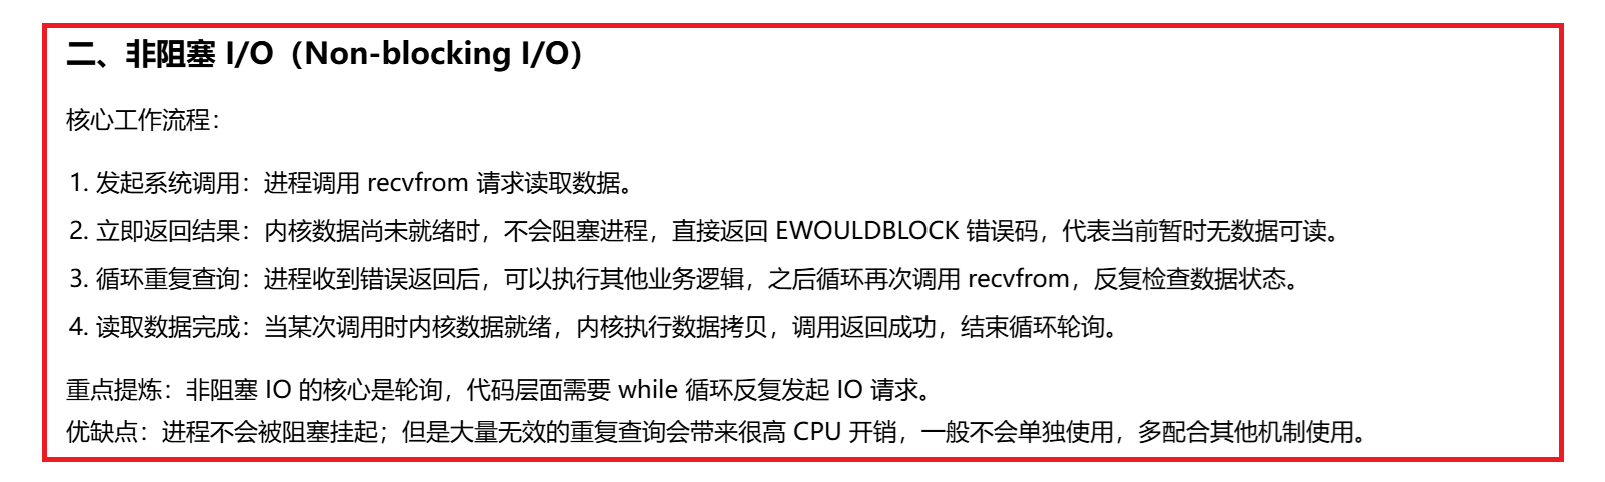
对应人物:李四 李四有多年钓鱼经验,不会一直盯着鱼漂死等。他会间歇性查看鱼漂状态,两次查看的间隙可以聊天、处理其他琐事;一旦发现鱼漂晃动,立刻提竿捞鱼。 核心特征:不会被等待动作阻塞,轮询检查状态,等待间隙处理其他工作。
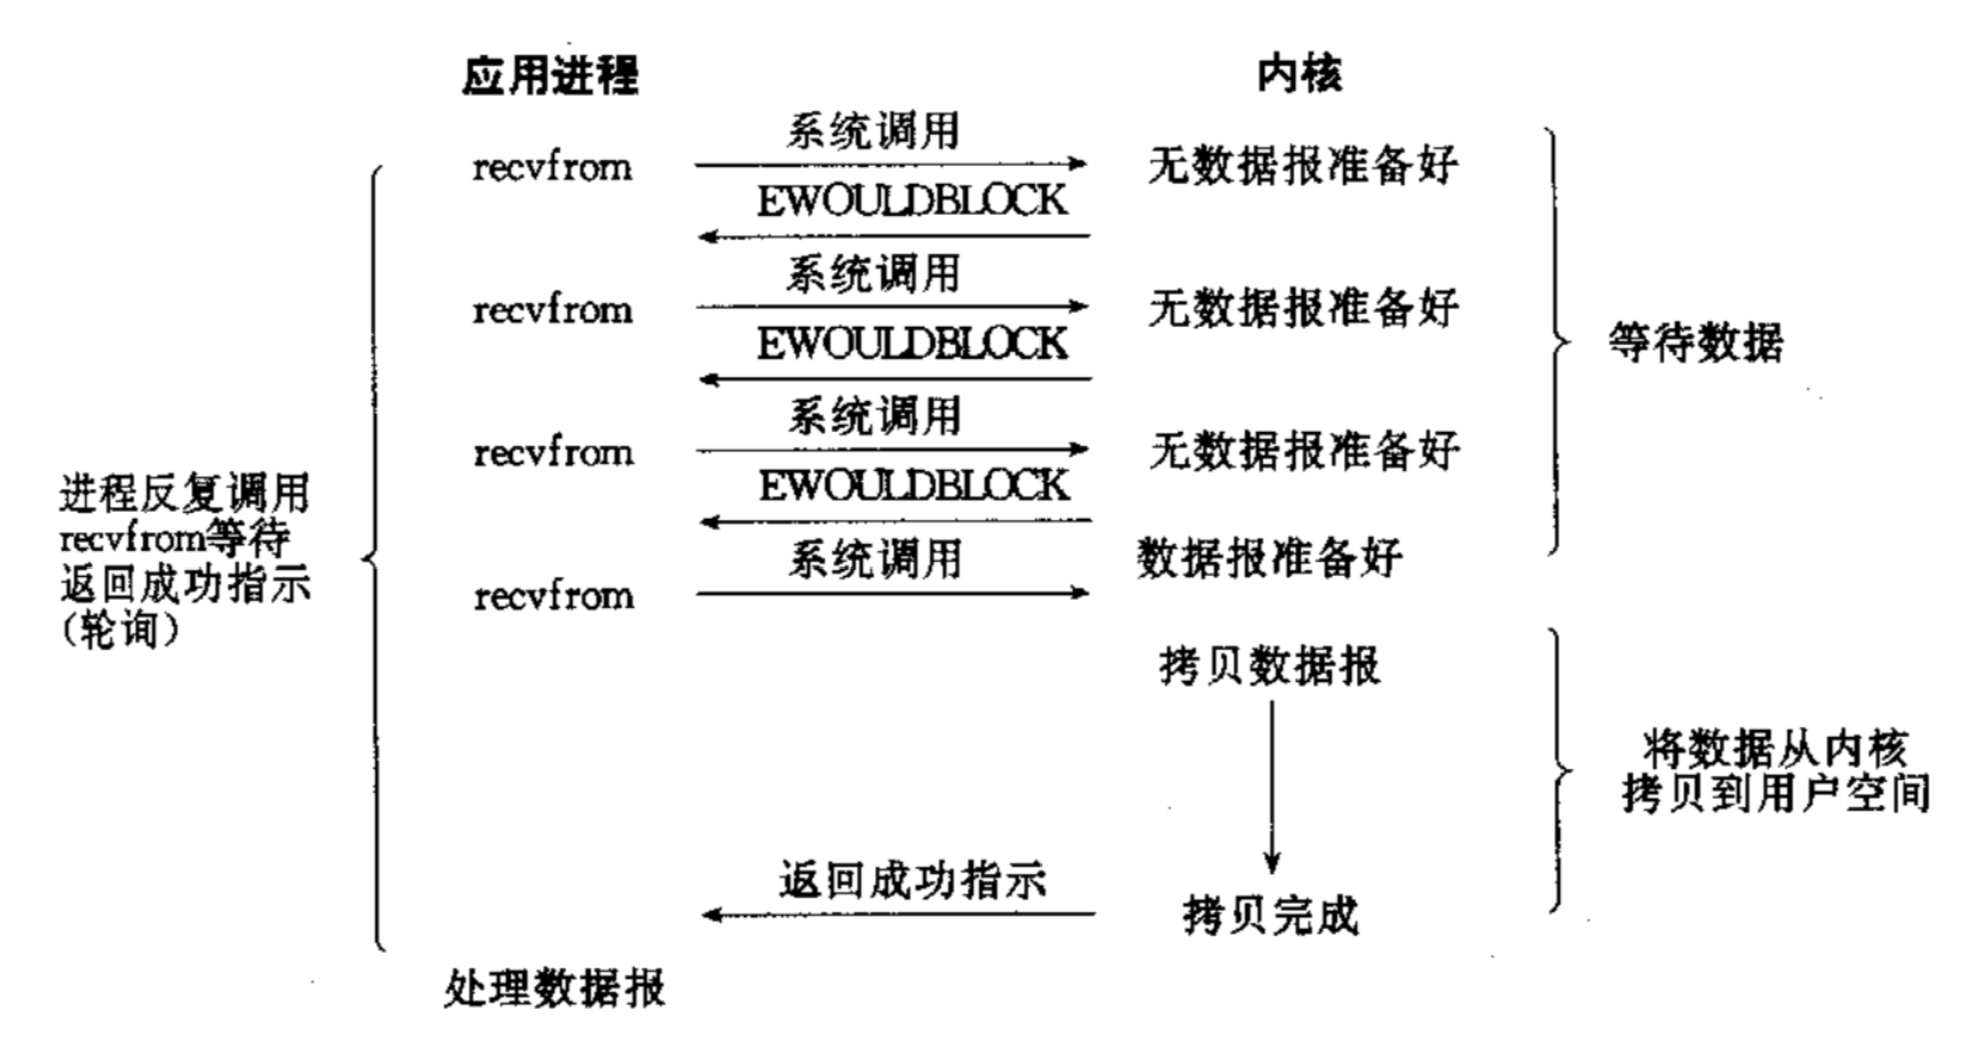
工作流程
问题 1:阻塞 vs 非阻塞,核心差别是什么?
阻塞 IO 和 非阻塞 IO,单纯 IO 本身的执行效率没有区别。 二者处理数据(捞鱼)的速度完全一样,差异仅仅是等待阶段的处理方式。 非阻塞 IO 并没有加快 IO 拷贝的速度,只是把原本无效等待的时间,拿来执行其他任务,提升了程序整体吞吐量。

注意: 非阻塞 IO 的致命缺陷:频繁轮询会大量消耗 CPU 资源,空转浪费算力,一般不会单独使用,通常搭配 IO 多路复用一起使用。
2.1.3 信号驱动 IO(Signal-driven IO)
对应人物:王五 王五经验更加老道,在鱼竿顶端悬挂铃铛,随后将鱼竿插在岸边,自己离开鱼竿去做其他事。当鱼咬钩拉动鱼线,触发铃铛响(信号通知),王五收到声音信号后,再回来提竿捞鱼。 核心特征:依靠信号通知事件就绪,无需主动轮询等待。

工作流程
关键点辨析
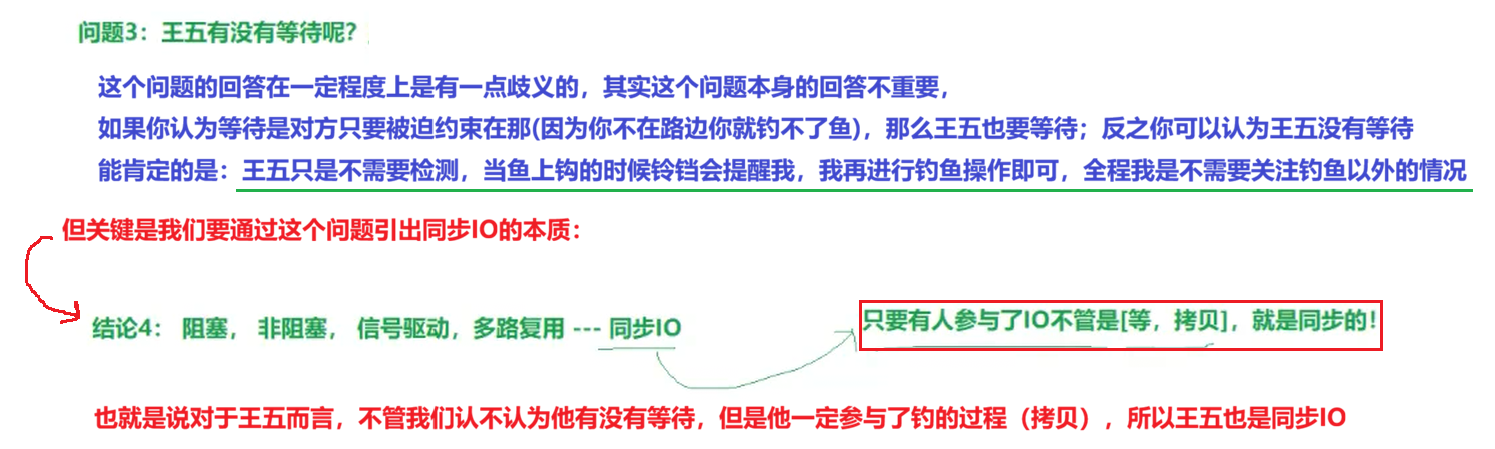
问题 3:王五有没有等待?
这个问题本身存在一定歧义。从现象上看,王五不需要持续盯着鱼漂轮询检测;但是王五依然要亲自参与捞鱼(拷贝)这个环节。 根据 IO 判定规则:只要进程参与 IO 的等待或者拷贝任意一个阶段,就属于同步 IO。所以信号驱动 IO 属于同步 IO。
优缺点:
优点:数据就绪前进程完全自由,CPU 利用率高。 缺点:高并发场景下信号会频繁触发,容易造成信号队列溢出、丢失事件,实际工程中使用很少。

2.1.4 IO 多路复用(IO Multiplexing)
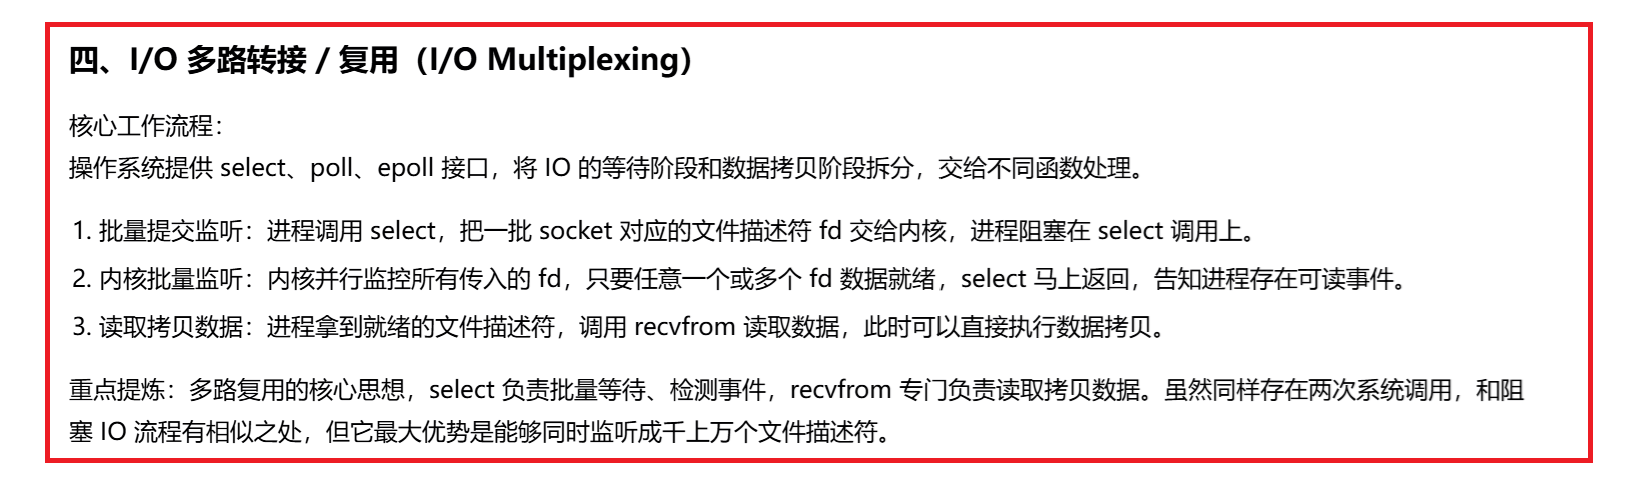
对应人物:赵六 赵六拥有大量鱼竿,一次性在岸边摆放多根鱼竿,来回巡视所有鱼竿的鱼漂状态。只要任意一根鱼竿的鱼漂晃动,就立刻对应捞鱼,甚至可以同时处理多条上钩的鱼。 核心特征:统一监听多个目标,一次等待多个就绪事件。常用函数:select、poll、epoll。

工作流程
问题 2:谁的钓鱼效率最高?
站在鱼上钩的概率角度,假设鱼咬任意一个鱼钩概率均等,赵六一次性监听大量鱼竿,单位时间内等待的时间占比会大幅降低。这就是 IO 多路复用的核心优势,也是 Nginx、Redis 等高并发服务的底层核心。

优缺点:
优点:单个线程可以同时监听成千上万个 IO 连接,不需要为每一条连接创建独立线程,极大减少线程创建、上下文切换的开销,是高并发网络开发最主流模型。 缺点:本质依旧属于同步 IO,就绪后仍然需要进程主动调用接口完成数据拷贝。
2.1.5 异步 IO(Asynchronous IO)
对应人物:田七 田七本身不参与钓鱼,他只想要最终的鱼。他把鱼竿、水桶全部交给下属小王,全权委托小王完成「等待鱼咬钩 + 捞鱼」的全部流程;小王完成钓鱼之后再通知田七,田七全程只处理自己的业务。 核心特征:仅发起任务,完全不参与等待、拷贝等任何 IO 流程,由操作系统全权执行。
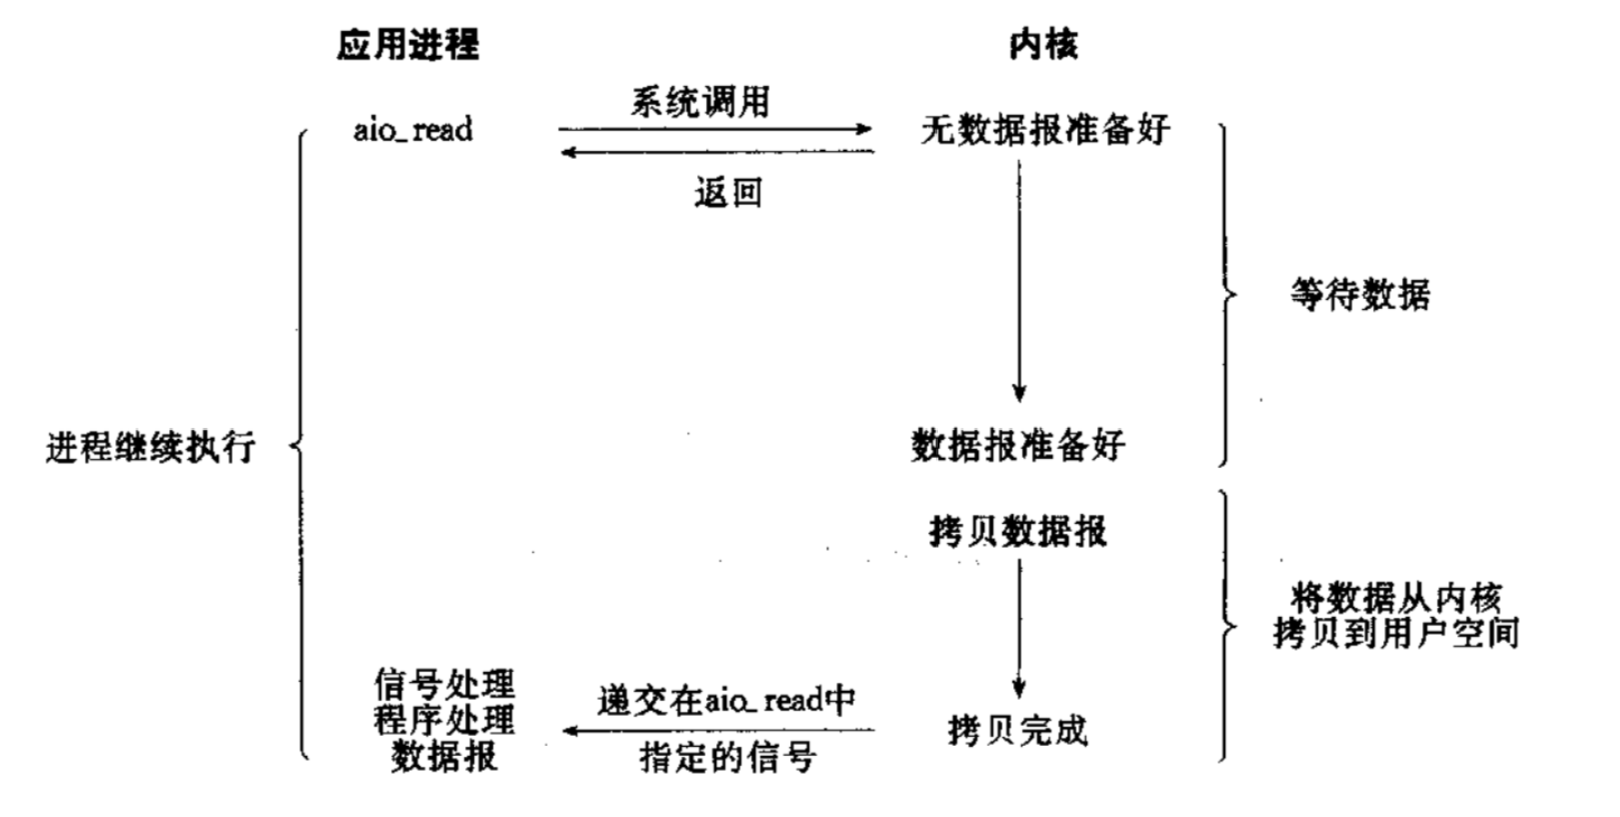
工作流程
关键点:
异步 IO 是五种模型里唯一的异步 IO。进程只负责发起 IO 请求,等待、拷贝两个阶段完全由内核完成,进程全程不参与。
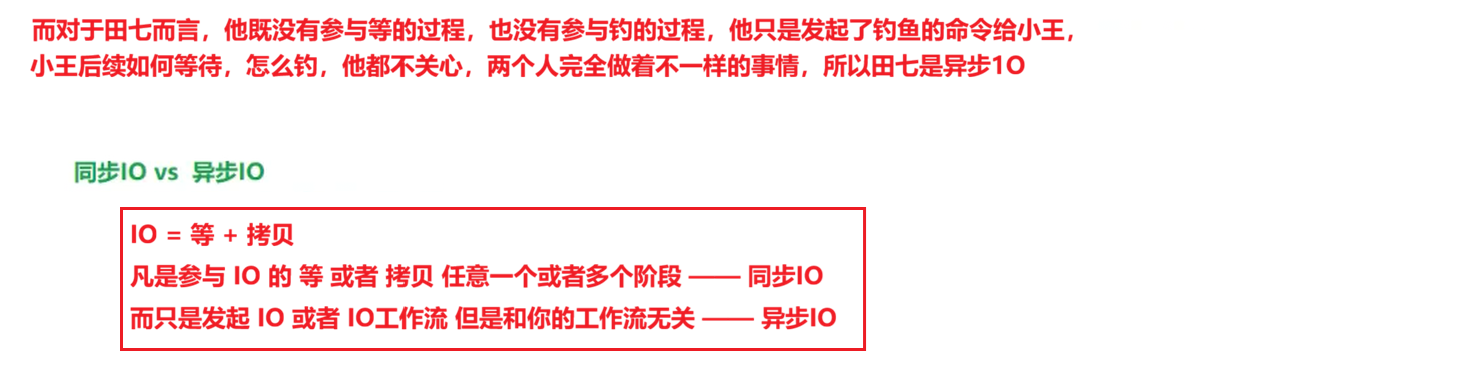

2.2 同步 IO vs 异步 IO
基于 IO = 等待 + 拷贝 公式,给出判定规则:
核心结论: 只要有人参与了 IO 的等待或者拷贝任意阶段,就是同步 IO; 只发起 IO 任务,后续 IO 流程和进程无关,才是异步 IO。
2.3 五种 IO 模型图表总结
为了方便大家对比和记忆,我把五种 IO 模型的特点整理成了下面这张表:
| 阻塞 IO | 进程阻塞等待 | 进程自己拷贝 | 同步 | 极低 | 简单的、并发量小的程序 |
| 非阻塞 IO | 进程轮询检查 | 进程自己拷贝 | 同步 | 低 | 一般不单独使用 |
| 信号驱动 IO | 信号通知 | 进程自己拷贝 | 同步 | 中 | 并发量不大的 UDP 程序 |
| IO 多路复用 | 内核同时监视多个 fd | 进程自己拷贝 | 同步 | 高 | 高并发服务器(Nginx、Redis) |
| 异步 IO | 内核等待 | 内核自动拷贝 | 异步 | 极高 | 对性能要求极高的场景(目前应用较少) |

三、非阻塞 IO
非阻塞 IO 是 Linux 网络开发中高频使用的 IO 模型。在 Linux 环境中,open调用无法永久修改已打开 fd 的非阻塞属性,我们一般依靠fcntl系统调用,动态修改已经打开的文件描述符状态。
3.1 fcntl 系统调用
fcntl 全称 File Control(文件控制),是 Linux/Unix 体系下的核心系统调用。 作用是:动态修改已经打开的文件描述符(fd)属性。当文件、套接字已经完成打开操作后,无法再次调用open修改属性,这时fcntl就是调整 fd 属性的核心通道。
3.1.1 函数原型
#include <unistd.h>
#include <fcntl.h>
int fcntl(int fd, int cmd, … /* arg */ );
参数说明:
3.1.2 fcntl 五大核心功能
根据cmd参数的取值,fcntl一共分为五类功能:
实现非阻塞 IO 时,我们只用到F_GETFL和F_SETFL这一组命令,用来读取、修改文件状态标记。
3.2 非阻塞 IO 实战:基于 fcntl 实现
了解完理论,下面看代码层面如何开启非阻塞 IO。我们通过fcntl读取当前 fd 的状态标记,追加O_NONBLOCK标志,再写回内核,完成非阻塞模式的设置。
核心思路:不能直接覆盖原有 flags,需要先F_GETFL拿到旧标记,或上 O_NONBLOCK,再F_SETFL写回,防止覆盖掉原有配置。
3.2.1 封装实现 SetNoBlock 函数
基于fcntl的文件状态标记功能,我们可以封装通用工具函数,将任意文件描述符设置为非阻塞模式。该函数仅调用一次,fd 就会永久保持非阻塞状态。
#include <iostream>
#include <cstdio>
#include <unistd.h>
#include <fcntl.h>
void Set_NonBlock(int fd)
{
// 1.获取fd当前的状态标志
int fl = fcntl(fd, F_GETFL);
if (fl < 0)
{
// 获取fl失败
perror("fcntl");
return;
}
// 2.按位或叠加O_NONBLOCK,保留原有标志位
fcntl(fd, F_SETFL, fl | O_NONBLOCK); // O_NONBLOCK:将fd设置成非阻塞
}
代码解读:
核心思路:不能直接覆盖原有 flags,必须先获取旧标记,叠加O_NONBLOCK,再写回。避免直接赋值清空文件描述符原本的配置。
3.2.2 read 函数返回值详解
函数原型:
#include <unistd.h>
ssize_t read(int fd, void *buf, size_t count);
结合阻塞、非阻塞两种场景,read一共有三类返回值,是非阻塞代码编写的重点:
核心易错点:非阻塞场景下,不能直接把read_size < 0判定为故障,必须结合错误码判断状态。
3.2.3 非阻塞 IO 实战:轮询读取标准输入
我们使用标准输入(fd=0)演示非阻塞 IO,循环轮询调用 read,没有数据时立刻返回,不阻塞进程。
#include <iostream>
#include <cstdio>
#include <unistd.h>
#include <fcntl.h>
void Set_NonBlock(int fd)
{
// 1.获取fd当前的状态标志
int fl = fcntl(fd, F_GETFL);
if (fl < 0)
{
// 获取fl失败
perror("fcntl");
return;
}
// 2.按位或叠加O_NONBLOCK,保留原有标志位
fcntl(fd, F_SETFL, fl | O_NONBLOCK); // O_NONBLOCK:将fd设置成非阻塞
}
int main()
{
// 设置标准输入为非阻塞
Set_NonBlock(0);
char buffer[1024];
while (true)
{
int n = read(0, buffer, sizeof(buffer));
// 系统调用read不同于recv、recvfrom,read会读取到用户在键盘中输入的任何字符包括回车键\\n
if (n > 0)
{
// 有数据就绪了
buffer[n – 1] = 0; // 这里不是buffer[n]就是因为我们需要手动把回车键\\n忽略掉
std::cout << buffer << std::endl;
}
else if (n < 0)
{
// 关键:针对非阻塞read,如果数据还没有就绪,返回值小于0;数据读取错误,返回值也是0
// 数据没有就绪算不算数据读取错误?不算
// 但是两者的结果都是read返回值小于0,如何区分?错误码
if (errno == EAGAIN || errno == EWOULDBLOCK)
{
// 返回的错误码是EAGAIN或者EWOULDBLOCK说明是数据没有就绪
std::cout << "数据还没有就绪…" << std::endl;
// 处理自己的事情
std::cout << "0 not ready, do other thing!" << std::endl;
sleep(1);
continue;
}
else if (errno == EINTR)
{
// 当程序正在读取数据的时候,突然收到一个 SIGINT(Ctrl+C)或其他信号,
// read会返回-1并且errno 设置为 EINTR
continue; //重新尝试读取
}
else
{
// 说明是数据读取错误
break;
}
}
else
{
// ctrl + d:表示从标准输入当前输入结束(类似read读取到文件结尾,返回0)
break;
}
}
}
代码关键点解读:
- 非阻塞设置:Set_NonBlock(0)将标准输入设置为非阻塞模式,该设置永久生效,不需要每次 read 都重复设置。
- read 返回值处理:
- n > 0:成功读到数据
- n == 0:对端关闭连接,标准输入场景就是按下Ctrl+D
- n < 0:检查errno
- EWOULDBLOCK / EAGAIN:无数据就绪,是非阻塞 IO 正常现象,不是错误
- EINTR:调用被信号中断,重新尝试读取
- 其他错误码:真实 IO 故障,终止读取
运行效果:
编译运行程序后:
- 没有输入任何内容时,程序每隔 1 秒打印数据还没有就绪…,不会卡住等待输入;
- 输入内容并回车后,程序立刻读取并打印输入的文本。
这就是非阻塞 IO 最典型的特征:调用 read 不会阻塞进程,没有数据就立刻返回,有数据就正常读取。

结束语
本篇我们从 IO 的本质「等待 + 拷贝」出发,依次讲解了 Linux 下五种经典 IO 模型,通过钓鱼的类比理清各自的工作流程,区分同步 IO 与异步 IO 的核心边界,最后落地到非阻塞 IO 的代码实战。
我们学习了如何利用fcntl修改文件描述符属性,封装非阻塞工具函数,并且掌握非阻塞场景下read返回值与错误码的处理逻辑,明白EAGAIN/EWOULDBLOCK只是数据未就绪的正常状态,并非程序故障。
非阻塞 IO 虽然可以做到不阻塞进程,但单纯轮询的方式会带来大量无效系统调用,CPU 资源消耗较高。下一章我们将学习 IO 多路复用,解决多文件描述符轮询带来的性能问题,进一步理解 Linux 高并发网络服务的核心实现方案。