目录标题
-
-
- 一、代码实现(基于之前封装好的算法和代码)
- 二、测试代码(反向传播找最后参数贼快)
-
差分数值梯度下降: blog: 深度学习9:神经网络学习6:神经网络类实现和使用
核心就是使用误差的反向传播法来计算梯度,而不是使用差分数值计算;这将大大提升学习的效率
一、代码实现(基于之前封装好的算法和代码)
对于二层网络 TwoLayerNet,隐藏层由一个 Affine 层和一个 ReLU 层组成,输出层则由一个 Affine 层和一个 Softmax-with-Loss 层组成
引入sigmoid在blog: 深度学习1:基本概念,感知机,激活函数(阶跃,sigmoid,Tanh函数)
引入softmax在blog: 深度学习2:激活函数(ReLU,softmax和恒等函数)及激活函数的最终选择
引入交叉熵在 blog: 深度学习4:神经网络学习1:损失函数,交叉熵误差
引用梯度方法在blog: 深度学习5:神经网络学习2:数值微分,偏导,梯度
引用关于层的引入: 深度学习11:反向传播2:激活层的反向传播和实现ReLU和Sigmoid 深度学习12:反向传播3:仿射层实现(Affine)
引入输出层: 深度学习13:反向传播4:输出层Softmax-with-Loss
import numpy as np
from common.functions import softmax, sigmoid, cross_entropy
from common.gradient import numerical_gradient
from common.layers import * # 引入神经网络的层
from collections import OrderedDict # 有序字典,用来保存结构
class TwoLayerNet:
# 初始化
def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01):
self.params = {}
self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size)
self.params['b1'] = np.zeros(hidden_size)
self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
self.params['b2'] = np.zeros(output_size)
self.params['b2'] = np.zeros(output_size)
# 定义层结构(forward时候直接遍历整个结构,backward也是遍历很方便*)
self.layers = OrderedDict()
self.layers['Affine1'] = Affine(self.params['W1'], self.params['b1'])
self.layers['ReLU1'] = Relu()
self.layers['Affine2'] = Affine(self.params['W2'], self.params['b2'])
# 单独定义最后一层:SoftmaxWithLoss
self.lastLayer = SoftmaxWithLoss()
# 前向传播(预测)
def forward(self, X):
# 对于神经网络中的每一层,依次调用forward方法
# 不需要最后一层lastLayer,这算出损失值了
for layer in self.layers.values():
X = layer.forward(X)
return X
# 计算损失
def loss(self, x, t):
y = self.forward(x)
loss_value = self.lastLayer.forward(y, t)
return loss_value
# 计算准确度
def accuracy(self, x, t):
y_pred = self.forward(x) # 预测分类数值
# 根据最大概率得到预测的分类号
y = np.argmax(y_pred, axis=1)
# 与正确解标签对比,得到准确率
accuracy = np.sum(y == t) / x.shape[0]
return accuracy
# 计算梯度:使用数值微分方法
def numerical_gradient(self, x, t):
# 定义目标函数
loss_f = lambda w: self.loss(x, t)
# 对每个参数,使用数值微分方法计算梯度
grads = {}
# 数值微分,每一次权重更新
grads['W1'] = numerical_gradient(loss_f, self.params['W1'])
grads['b1'] = numerical_gradient(loss_f, self.params['b1'])
grads['W2'] = numerical_gradient(loss_f, self.params['W2'])
grads['b2'] = numerical_gradient(loss_f, self.params['b2'])
return grads
# 计算梯度:使用反向传播法(一次前向一次反向就算出梯度)
def gradient(self, x, t):
# 前向传播,直到计算损失(算出反向)
#参考blog 知道执行一次前向传播的目的: 深度学习10-反向传播插曲疑问:为啥先执行一次前向传播
# 在仿射层对输入数据X做保存,方便反向传播计算梯度,存到各自仿射层的实例属性中了
self.loss(x, t)
# 反向传播
dy = 1
dy = self.lastLayer.backward(dy)
# 将神经网络中的所有层翻转处理
layers = list(self.layers.values())
layers.reverse() #这个list反转是原地反转
for layer in layers:
dy = layer.backward(dy)
# 提取各层参数的梯度(反向传播时候每层的梯度都保存在各自实例的属性中了,可以直接拿到了)
grads = {}
grads['W1'], grads['b1'] = self.layers['Affine1'].dW, self.layers['Affine1'].db
grads['W2'], grads['b2'] = self.layers['Affine2'].dW, self.layers['Affine2'].db
return grads
二、测试代码(反向传播找最后参数贼快)
import numpy as np
import matplotlib.pyplot as plt
from common.load_data import get_data
from two_layer_net import TwoLayerNet
# 1.加载数据
x_train, x_test, t_train, t_test = get_data()
#2.创建模型
network = TwoLayerNet(input_size=784,hidden_size=50,output_size=10)
# 整个数据集29400,每个100数据作为小批次训练量
# 3.设置超参数
learning_rate = 0.1
batch_size = 100
num_epochs = 10 # 就是29400整个数据集重复训练10次
train_size = x_train.shape[0]
iter_per_epoch = np.ceil(train_size/batch_size) #294次
iters_num = int(num_epochs * iter_per_epoch) # 总循环小批次 294*10
#设置一些容器存储数据
train_loss_list = []
train_acc_list = []
test_acc_list = []
# 4.循环迭代,用梯度下降法训练模型
for i in range(iters_num):
# 4.1 随机选取批量数据
batch_mask = np.random.choice(train_size,batch_size)
x_batch = x_train[batch_mask]
t_batch = t_train[batch_mask]
# 4.2计算梯度
# grad = network.numerical_gradient(x_batch, t_batch)
grad = network.gradient(x_batch, t_batch)
# 4.3更新参数
for key in ('W1', 'W2', 'b1', 'b2'):
network.params[key] -= learning_rate * grad[key]
# 4.4 计算并保存当前的训练损失
loss = network.loss(x_batch,t_batch)
train_loss_list.append(loss)
# 4.5 每完成一个epoch的迭代,就计算并保存训练和测试准确率
if i % iter_per_epoch == 0:
train_acc = network.accuracy(x_train, t_train)
test_acc = network.accuracy(x_test, t_test)
train_acc_list.append(train_acc)
test_acc_list.append(test_acc)
print('Epoch: {}, Loss: {}, Train Acc: {}, Test Acc: {}'.format(i//iter_per_epoch + 1, loss, train_acc, test_acc))
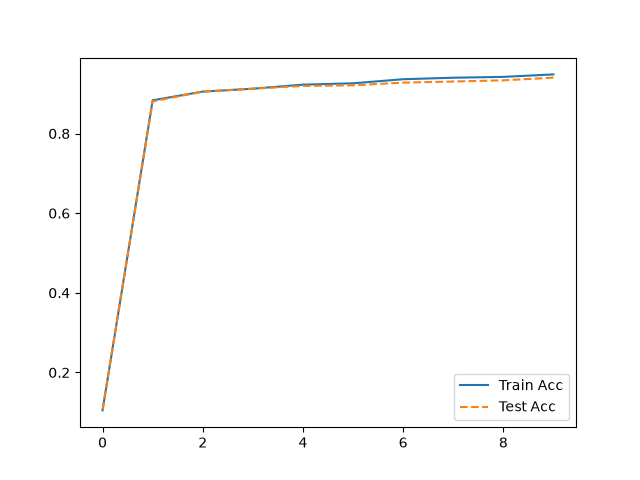
# 5. 画图
x = np.arange(len(train_acc_list))
plt.plot(x, train_acc_list, label='Train Acc')
plt.plot(x, test_acc_list, label='Test Acc', linestyle='–')
plt.legend(loc='best')
# plt.show()
plt.savefig('gradient_descent_nn_train_bp_result.png')