摘要
单细胞扰动测序(Perturb‑seq)技术可以观测基因敲除、药物刺激等干预之后细胞转录组的变化,但湿实验成本高昂、实验条件受限,很难遍历全部基因、药物以及不同细胞背景。Arc Institute发表在Cell上的State模型,是一套用于预测细胞扰动响应的深度学习框架,由SE(State Embedding,细胞状态嵌入模块)与ST(State Transition,状态迁移模块)两大核心组件构成。该模型不再对单个细胞进行建模,而是直接对细胞群体分布进行学习,能够在全新细胞背景下零样本预测扰动带来的转录组改变。同时文章配套开源评测套件Cell‑Eval,为扰动预测模型建立统一的量化评估标准。本文围绕论文核心思想、模块架构、评测基准、实验效果、局限与未来方向展开解析。
一、研究背景与现存痛点
Perturb‑seq可以获得扰动之后单细胞RNA测序数据,但现实中存在几大核心难题:
很多传统方法假设细胞群体异质性可以忽略,简单将扰动细胞直接匹配对照组细胞;或者用最优传输OT做细胞一对一映射。但细胞是群体分布,并非简单的一一对应关系。State的核心创新:不去做单细胞一对一匹配,直接学习从“对照组细胞分布”变换到“扰动后细胞分布”的迁移算子。
核心数据生成假设: Xp=X0+Tp(X0)+α
X0:未扰动本底细胞状态;Tp:扰动p带来的状态改变;α为实验技术噪声。
X0无法直接观测,State从群体分布层面拟合这一变换,规避单细胞不可观测的问题。
二、State整体架构:SE嵌入模块 + ST状态迁移模块
State分为两大可独立使用又可以组合使用的子模块:
2.1 SE 细胞状态嵌入模块
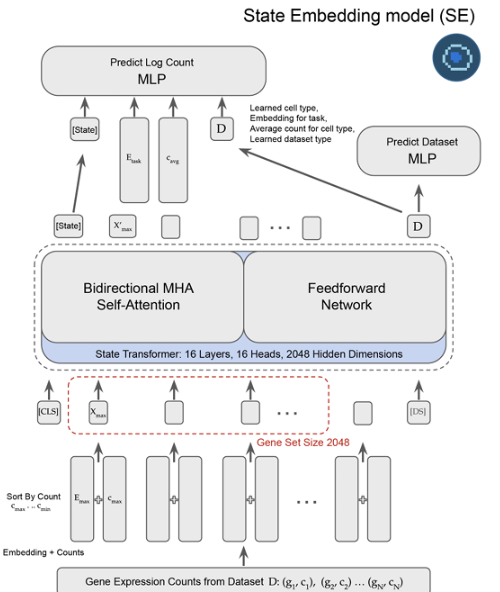
SE是大规模自监督预训练编码器,在1.67亿人类单细胞数据上完成预训练,目标输出细胞的低维隐向量,抑制实验批次噪声,保留真实生物学信号。
关键设计点
- 基因表达预测损失:模型根据细胞嵌入,预测基因的表达量,同时兼顾细胞内基因重建、跨细胞基因表达模式一致性(即soft bin 重建损失—SE主目标)
- 数据集分类辅助损失:利用{DS}token预测这条数据来自哪一个数据集,迫使模型把技术批次信息放到这个专用token,把细胞真正生物学特征保留在{CLS}输出(其里面的全局信息就是后面交给ST的)
SE输出的细胞嵌入,既保留细胞类型、分化状态、通路活性等生物学信息,又很大程度剥离测序平台、批次等技术噪声。推理阶段不需要metadata元信息就可以得到细胞表征。
2.2 ST 状态迁移模块(State Transition)
ST是State的核心预测模块,以细胞集合(cell set)为输入单位,而非单个细胞。
传统模型输入:单个细胞;ST输入:一批S个细胞构成的细胞集合(也可以是经过SE编码后的隐状态)。
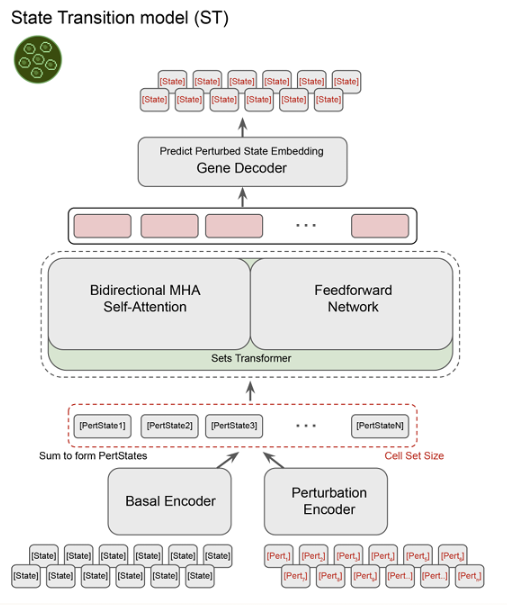
数据组织:按协变量分组构建细胞集合 把细胞按照:细胞系/细胞类型、扰动标签、批次分组。训练时,每一条训练样本由配对集合构成:一组对照组细胞集合(未扰动)+一组对应的扰动后细胞集合。集合内部S个细胞做自注意力,建模群体内部的细胞异质性。
论文实验中集合大小S=768,集合尺寸对性能影响巨大,过小会丢失群体异质性信息。
- 编码器将对照组细胞(原始表达矩阵或者SE输出嵌入)映射到隐空间;
- 扰动标签、batch标签编码为嵌入,加到细胞特征上;
- Transformer主干(GPT‑2/LLaMA改造为双向注意力,不使用位置编码,因为集合内细胞没有有序序列含义),在集合内全部细胞之间做自注意力,建模群体异质性;
- 残差式设计:Transformer学习的是扰动带来的状态变化残差,而不是完全重写细胞表征;
- 解码头把隐特征还原回基因表达空间。
3. 损失函数:MMD最大均值差异 ST不使用MSE单细胞损失,使用MMD衡量「预测的扰动后细胞分布」和「真实观测扰动后细胞分布」两个概率分布之间的距离。
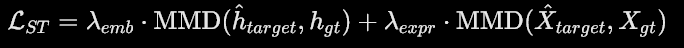
使用能量距离内核,优化目标是:让预测出来的细胞集合整体分布,和真实扰动后分布尽可能接近。
重要理论结论:在满足分布正则条件的前提下,ST模型的解空间包含最优传输OT映射,但不会强制约束必须是OT映射,相比专门的Neural‑OT模型拥有更大自由度,适配真实生物复杂变换。
两种运行模式
- ST+HVG:直接使用原始高可变基因表达作为输入,不需要SE预训练嵌入;适合数据集充足
- ST+SE:输入使用SE预训练出来的细胞嵌入,再通过解码器映射回基因表达;零样本、跨数据集泛化能力大幅提升
三、Cell‑Eval:单细胞扰动预测的标准化评测框架
过去不同扰动预测论文使用五花八门评价指标,很难横向对比。该论文提出Cell‑Eval完整评测套件,从三个维度衡量模型预测质量:
核心指标说明:
Cell‑Eval不仅给出数值指标,也配套可视化工具,现已开源,成为Virtual Cell Challenge虚拟细胞竞赛官方评测基准。
四、实验结果与关键发现
论文使用多套大规模扰动数据集:
- Tahoe‑100M:50多种癌细胞系,数百种药物化学扰动;
- Parse‑PBMC:人外周血,细胞因子扰动;
- Replogle‑Nadig:CRISPR基因敲除遗传扰动。
设置两类测试任务:
主要实验结论
五、State的优势与现存局限性
优势
局限性
六、应用价值与未来展望
现实应用价值
未来方向
七、总结
State代表单细胞AI从“静态细胞表征”走向细胞虚拟仿真(Virtual Cell)的重要一步。
- SE解决了跨数据集、跨批次的细胞表征问题;
- ST跳出传统单细胞建模范式,以细胞群体分布为单元,直接学习扰动对细胞群体的变换;
- Cell‑Eval为整个领域建立扰动预测模型的评测基准。
State并不是真正完整细胞世界模型,它擅长“给定扰动,模拟细胞群体转录组分布变化”,但还缺少自主推演全新扰动、完整细胞生命周期动态演化的能力。但它已经证明:大规模单细胞扰动数据驱动下,在硅片上模拟细胞干预响应具备可行性,为虚拟细胞、AI辅助药物开发开辟了新路径。
项目开源地址: GitHub – ArcInstitute/state: State is a machine learning model that predicts cellular perturbation response across diverse contexts · GitHub Cell‑Eval评测库:https://github.com/ArcInstitute/cell‑eval