大家读完觉得有帮助记得关注和点赞!!!
摘要
网络威胁情报(CTI)是现代网络防御的基础,然而大部分CTI存在于非结构化的报告中,其数量和异质性远远超出人工分析的能力,这推动了从CTI报告自动构建知识图谱的研究。然而,大多数现有方法在单个报告内提取部分信息,跨来源的场景尚未被探索,其中相同的威胁被赋予不相关的名称。我们的关键洞察是,攻击行为一旦映射到MITRE ATT&CK(一个由专家维护的标准化攻击技术目录),就可以锚定报告的其余部分。攻击行为是报告描述的 adversary 行动,而上下文实体(例如,威胁行为者、活动和受影响的产品)和失陷指标(IoC;例如,IP地址)是这些行为的参与者和痕迹。将它们附着到这些锚点上,将每个报告的图置于一个规范空间中,其中重叠的技术成为对齐不相关名称的信号。
我们在BEACON中实现了这一洞察,这是一个LLM驱动的跨来源CTI知识图谱构建框架。其第一阶段将每个报告提取为一个图,采用“先提议后验证”的范式,将候选者锚定在报告证据和官方ATT&CK定义中,以抑制LLM的误分类和幻觉。其第二阶段通过分层对齐策略合并这些图,该策略按确定性递减的顺序应用信号,从字符级和语义相似性到重叠的技术邻域,并在合并池化邻域时迭代。没有现有的基准将实体链接到技术锚点或提供跨来源对齐的地面真实。因此,我们从34个来源构建并发布了两个人工标注的数据集:据我们所知,这是最大的报告级CTI提取数据集(8,395个元素)和第一个跨来源整合数据集(3,487个)。在这些数据集上,BEACON分别优于所有基线至少23%和9%。
1 引言
网络威胁情报(CTI)是关于现有和新兴网络威胁的基于证据的知识(Mavroeidis和Bromander,2017),它是现代网络防御的基础,将组织从被动的事件响应转变为主动的威胁预测。这些知识的大部分存在于安全厂商独立和持续发布的自然语言报告中(Orbinato等人,2022;Johnson等人,2016;Li等人,2022;Suarez-Roman等人,2026)。报告主要描述三类信息:(1)上下文实体代表关于活动的高级上下文,如威胁行为者、活动、恶意软件家族和受影响的产品。(2)攻击行为是 adversary 执行的中级战术、技术和程序(TTP)(Strom等人,2020)。MITRE ATT&CK(Strom等人,2020)将攻击行为标准化为由安全专家策划和维护的技术分类法。每个技术级条目,或TTP,都有一个唯一的ID,如T1190表示利用面向公众的应用程序,T1566表示网络钓鱼。(3)失陷指标(IoC)代表攻击过程的低级痕迹,如IP地址、文件哈希和CVE标识符。
这些报告在措辞、命名约定和详细程度上各不相同,其数量和异质性远远超过人工分析的能力。这推动了将此类知识组织成图以进行大规模查询的研究(Hogan等人,2021;Gao等人,2024;Cheng等人,2025b),但仍存在两个主要局限性。首先,现有方法仅覆盖CTI报告中的部分信息,并分为两个研究焦点。一个将自然语言中的攻击行为描述映射到ATT&CK技术,但忽略了周围的上下文实体和IoC(Satvat等人,2021;Li等人,2022;Cheng等人,2025a)。另一个提取上下文实体和IoC作为每个报告自身措辞中的关系三元组,而不将行为映射到ATT&CK技术或捕获它们与ATT&CK技术的关系(Cheng等人,2025b;Gao等人,2024;Marchiori等人,2023;Yang等人,2026)。没有现有工作将两者提取到一个结构中。近期工作转向大型语言模型(LLM),因其更强的自然语言处理能力(Zhang等人,2025;Cheng等人,2025b;Yang等人,2026),但CTI的三个特性使提取对LLM变得困难。同一实体在不同上下文中可以扮演不同角色:Gmail可以是受影响的产品或用于发送钓鱼邮件的工具,微软可以是受影响的厂商或报告自身的发布者,后者不应被提取。ATT&CK包含数百种技术,其定义仅在细微细节上有所不同:通过远程服务的横向移动是T1021(The MITRE Corporation,2025)具有合法访问权限,但通过漏洞是T1210(The MITRE Corporation,2026)。并且LLM输出是生成的而非从文本中检索的,因此提取的信息可能在源中不存在。这些特性使得基于LLM的提取遭受误分类和幻觉(Büchel等人,2025;Mezzi等人,2025;Tao等人,2024)。
其次,没有现有方法能可靠地从不同CTI源构建跨报告的知识图谱。厂商以不同的命名约定独立报告相同的威胁,并且没有单个报告包含跨源使用的所有别名(Saha等人,2025;Cheng等人,2026)。例如,三份关于Oracle E-Business Suite活动的报告将同一威胁行为者命名为Cl0p(Ernalbant,2025)、Clop(Lakshmanan,2025)和Graceful Spider(Kovacs,2025)(图1,左):前两个相差一个字符,而第三个完全无关。大多数现有工作对单个报告内的实体进行去重(Cheng等人,2025b),少数多报告尝试依赖于嵌入相似性(Yang等人,2026),这无法对齐不相关的名称如Cl0p和Graceful Spider。虽然LLM可以从上下文中匹配实体,但跨报告比较所有实体对成本高昂,且LLM可能错误地合并出现在相关叙述中的不同实体。例如,描述Oracle E-Business Suite的报告也提到行为者早期的MOVEit活动作为背景(Ernalbant,2025;Lakshmanan,2025),而比较报告的LLM可能因为共享相同的行为者和上下文而错误地合并这两个活动。
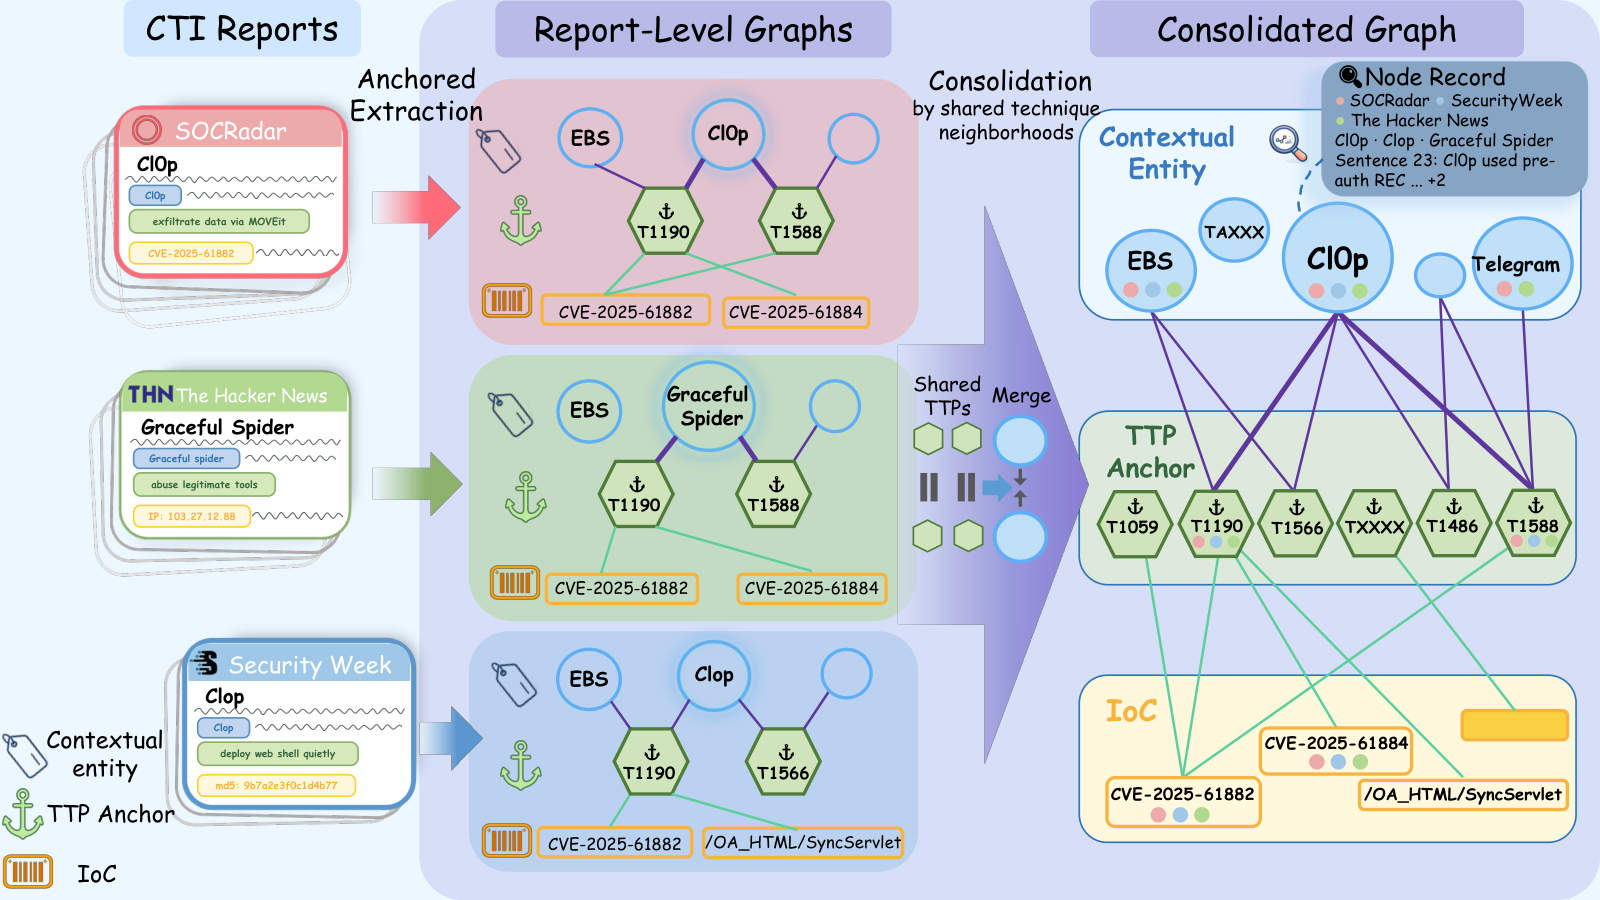
图1:从异构报告到一个整合图。左:三个主要CTI源,SOCRadar(SOCRadar,2026)、The Hacker News(The Hacker News,2026)和SecurityWeek(SecurityWeek,2026),覆盖相同的活动并将其行为者命名为Cl0p(Ernalbant,2025)、Graceful Spider(Lakshmanan,2025)和Clop(Kovacs,2025)。中:空间锚定阶段将每个报告提取为一个图,其中上下文实体(圆形)和IoC(矩形)附着到ATT&CK技术锚点(六边形)。右:整合阶段合并指向同一实体的节点,其中共享的技术邻域对齐不相关的名称。节点内的彩色点标记其来源报告,合并后的行为者节点在其记录中保留每个别名、来源和证据句子。
图描述:一个三部分图。左侧显示三个不同来源报告中的三个不同名称。中间显示每个报告被转换为一个以ATT&CK技术为锚点的图。右侧显示三个报告图合并为一个整合图,不同名称的节点合并为一个。
在本工作中,我们的目标是构建一个跨CTI源的知识图谱,覆盖所有三类信息,并可靠地合并指向同一现实世界实体的节点。我们的关键洞察是,攻击行为是CTI报告的核心组成部分,无论来源如何措辞,都可以映射到ATT&CK技术,而上下文实体和IoC描述这些行为的参与者和痕迹(Satvat等人,2021;Li等人,2022)。因此,将实体附着到ATT&CK技术作为锚点,捕获了现有方法未提取的关系,并将每个报告的图统一在一个共享的规范空间中,为具有不相关名称的实体提供了额外的领域特定对齐信号。
我们基于这一洞察构建了BEACON(行为锚定的CTI报告整合),一个LLM驱动的两阶段框架,用于跨不同CTI源构建一个知识图谱(图1)。为抑制误分类和幻觉,我们设计了“先提议后验证”的范式。第一阶段,空间锚定,将每个报告提取为一个图,其中上下文实体和IoC附着到ATT&CK技术锚点。由于叙述中映射到技术的攻击行为是交织的,LLM首先将每个报告分解为基于报告证据的原子行为。然后,它为每个原子行为提议多个候选技术,以扩展在数百种细粒度定义中的覆盖范围,并对照其官方ATT&CK定义验证每个候选。在相同的“先提议后验证”范式下,上下文实体和IoC在它们的证据重叠时被提取并附着到技术锚点。
对于第二阶段,整合,我们设计了一种分层对齐策略,通过按确定性递减的顺序应用合并信号来合并每个报告的图,每个层级建立在上层的合并之上,并且每个合并都由LLM根据报告证据进行验证。为覆盖从单个字符差异到完全不相关名称的命名分歧,它通过从字符级和语义相似性到仅锚定空间可用的信号来匹配实体:它们的ATT&CK技术邻域的重叠,即它们附着到的技术集合。由于共享多个攻击行为的实体很可能是相同的,邻域级别可以匹配具有不相关名称的实体,并且在每次合并池化其成员的邻域并暴露新候选者时迭代。
没有现有的基准将实体链接到技术锚点或提供跨来源对齐的地面真实。因此,我们构建并发布了两个新数据集:BEACON-Single,包含来自15个发布者的150份报告,总计8,395个节点和边,据我们所知是最大的用于报告级CTI提取的人工标注基准;以及BEACON-Group,将来自31个发布者的100份报告组织成33组,覆盖相同的威胁,是第一个用于跨来源CTI整合的基准。两个数据集都通过双重专家标注和高级仲裁精心策划。BEACON在两个任务上都优于所有基线,提取任务至少23%,整合任务至少9%。在最难的情况下,实体在不同来源中以不同拼写或完全不相关的名称出现,BEACON优于所有基线至少27%。消融实验表明,ATT&CK技术邻域对于对齐这些困难实体至关重要。
2 相关工作
2.1 CTI提取
不断演进的CTI标准如STIX(OASIS Cyber Threat Intelligence Technical Committee,2021)、MITRE ATT&CK(Strom等人,2020)和OpenCTI(Filigran,2026)为表示和交换威胁知识提供了共享词汇,然而CTI社区通常以自然语言报告的形式分发情报。为弥合这一差距,一条工作线从报告文本中重建攻击行为并将其映射到ATT&CK技术(Husari等人,2017;Li等人,2022;Legoy等人,2020;Orbinato等人,2022;Alam等人,2023;Nguyen等人,2024;Kumarasinghe等人,2024;Lekssays等人,2025;Cai等人,2026;Li等人,2024;Büchel等人,2025;Zhang等人,2025;Haque等人,2026)。早期方法依赖于规则引导的NLP或有监督分类器(Husari等人,2017;Li等人,2022;Legoy等人,2020;Orbinato等人,2022),但此类流水线难以处理自然语言变异性,并且随着威胁演变而迁移性差。后续工作利用预训练语言模型如BERT(Devlin等人,2019),或将报告文本和TTP定义嵌入共享空间进行语义比较(Alam等人,2023;Nguyen等人,2024;Kumarasinghe等人,2024),或将文本端到端映射到TTP ID(Cai等人,2026;Li等人,2024)。它们更好地处理了变异性,但仍受限于预训练主干和标注数据。近期工作转向LLM(Büchel等人,2025),TechniqueRAG(Lekssays等人,2025)使用指令微调的LLM对候选技术进行重排序,然后用微调后的模型进行映射;AttacKG+(Zhang等人,2025)将三元组扩展为时态行为图,但其实体与映射的技术无关联。Haque等人将预测的TTP ID聚合为活动级集合(Haque等人,2026),确认了多报告设置的价值,同时使实体保持未对齐状态。在这一系列中,提取侧重于攻击行为,而上下文实体和IoC未被提取或未附着到映射的技术,而BEACON两者都提取并附着到映射的技术。
另一条工作线针对上下文信息。这些方法提取攻击的命名参与者,如威胁行为者、恶意软件家族和受影响组织,及其关系到图中。早期系统使用基于规则和无监督的NLP技术(Park和Lee,2022),而近期工作使用LLM端到端提取本体约束的关系三元组(Cheng等人,2025b;Zhang和Soh,2024)。像CTINexus(Cheng等人,2025b)和CTI-Thinker(Yang等人,2026)这样的系统仅在报告明确写出ID(如T1190)作为字符串时才提取MITRE ATT&CK技术ID。报告用自然语言描述而未命名ID的行为因此未被映射到技术。LADDER同时提取TTP和上下文实体,但其本体仅将每个TTP连接到恶意软件,因此图无法捕获其他类型实体与攻击行为之间的关系(Alam等人,2023)。在这一系列中,提取侧重于上下文实体和IoC,而不将攻击行为映射到技术或捕获它们与ATT&CK技术的关系。此外,两条工作线都限于单个报告,而BEACON从跨源报告中构建一个覆盖所有三类信息的图。
2.2 跨源链接与对齐
经典实体匹配使用相似性函数和二元分类器比较名称、文本字段和属性,判断两条记录是否匹配(Cohen和Richman,2002;Bilenko和Mooney,2003),但在名称和属性重叠缺失时表现不佳。神经实体匹配将记录编码为学习到的表示以进行成对比较(Mudgal等人,2018;Fu等人,2020;Li等人,2020;Jiang等人,2024),然而当两条记录差异显著时,仅凭文本语义无法可靠地识别同一实体。例如,“Twitter”和“X”指同一产品,但在关于该重命名的足够训练数据出现之前,没有嵌入能将新名称与旧名称关联。当实体在图中连接时,结构提供了额外的匹配信号(Lacoste-Julien等人,2013;Suchanek等人,2011)。最近,实体匹配使用LLM判断两条记录是否指向同一实体(Wang等人,2025),但这些判断仍基于相同的文本证据。
在CTI中,少数现有方法尝试解决实体对齐问题。CTINexus(Cheng等人,2025b)将实体对齐限制在单个报告内的去重,而CTI-Thinker(Yang等人,2026)尽管跨源对齐,但依赖于编码器嵌入和余弦相似性阈值。这两种方法在CTI命名约定上都失败。威胁实体通常被赋予不相关的代号,如Wicked Panda和Brass Typhoon指同一行为者,它们在语义和拼写上都很远,因此嵌入和字符串相似性都无法匹配它们。威胁实体也可能被赋予字母数字标签,如APT41和TA415,它们没有语义供嵌入比较,且共享很少字符供字符串相似性匹配。字符串相似性还可能错误地合并拼写几乎相同的两个标签,如APT41和APT40。命名约定也因厂商而异。例如,Mandiant将上述行为者跟踪为APT41,而微软在其自己的天气主题方案中将其命名为Brass Typhoon。因此,跨源对齐此行为者需要匹配APT41与Brass Typhoon,这两个来自不相关命名方案的名称,精确名称和基于相似性的匹配都无法处理。BEACON通过它们共享的ATT&CK技术邻域来对齐实体,这是一个跨源一致且独立于命名约定的信号。
3 方法论
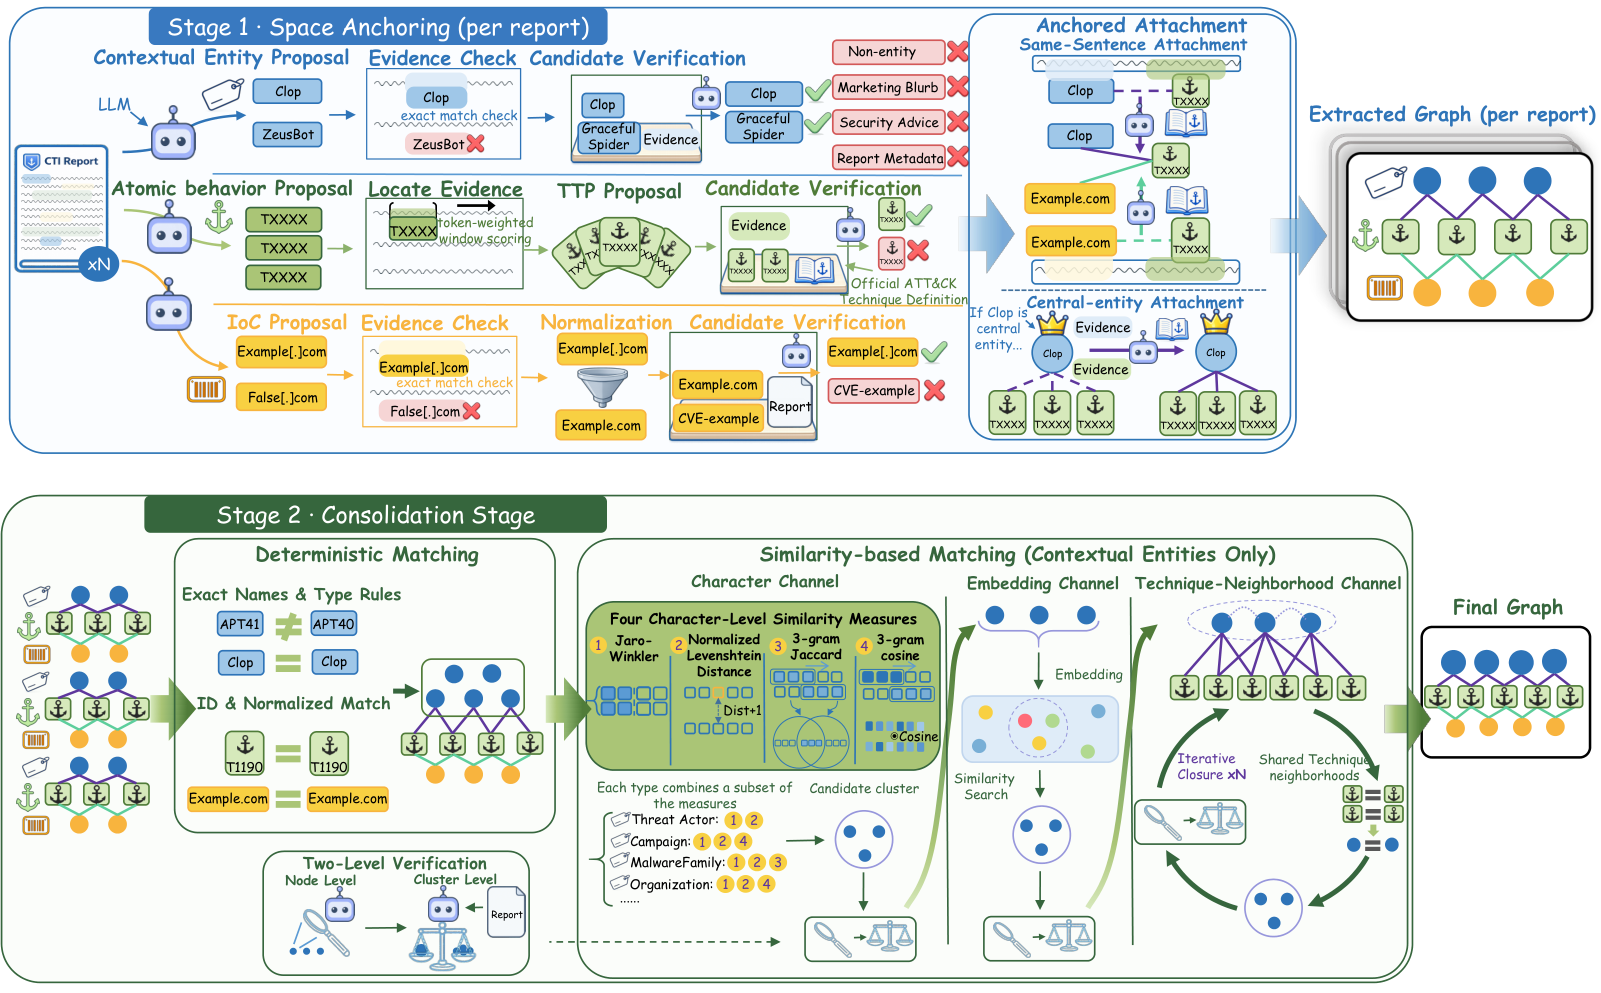
图2:BEACON流水线。阶段1将每个报告转换为一个锚定图,沿三条轨道进行:LLM提议上下文实体、原子行为和IoC,每个提议都基于报告证据。原子行为通过令牌加权窗口评分定位到证据跨度,其候选技术对照官方ATT&CK定义进行验证。IoC在最终审查前进行规范化。然后通过同句附着在已验证节点之间提议候选边,每条边由LLM确认,报告中心实体还额外与每个锚点配对。阶段2整合每个报告的图:确定性匹配合并相同的技术ID、规范化的IoC形式和精确名称,剩余的上下文实体进入三个候选通道:按类型度量的字符相似性、嵌入相似性和共享技术邻域。每个候选聚类经过节点级和聚类级LLM验证,邻域通道迭代直到没有新的合并被接受。
[图描述:一个详细的流程图,显示BEACON的两阶段流水线。阶段1包括行为定位、上下文实体和IoC提取、锚定附着。阶段2包括确定性匹配、三个相似性通道和迭代闭包。]
图2给出了BEACON的概述,一个以LLM为驱动的框架,分两个阶段运行。第一阶段,空间锚定,将每个CTI报告 {r₁, …, rₙ} 提取为一个图,其中上下文实体和IoC附着到ATT&CK技术锚点。第二阶段,整合,合并跨报告中指向同一现实世界实体的节点,生成一个覆盖所有三类信息的整合图 G∗。为抑制误分类和幻觉,两个阶段都遵循“先提议后验证”的范式,每个提议在进入图之前都经过验证。
3.1 空间锚定阶段
锚定阶段将CTI报告 r 提取为一个图 G=(Vₐ∪V_c∪V_o, E),包含三种类型的节点:技术锚点 Vₐ,映射到一个ATT&CK技术;上下文实体 V_c,类型为 ThreatActor、Campaign、MalwareFamily、Tool、Organization、Product、Location 或 Sector;以及IoC V_o,类型为IP地址、域名、URL、电子邮件、文件路径、注册表项、文件哈希、CVE、互斥量或AES密钥。边设计遵循CTI报告的两个特性。首先,攻击行为是CTI报告的核心组成部分,上下文实体和IoC作为其参与者和痕迹进入叙述(Satvat等人,2021;Li等人,2022)。其次,无论来源如何措辞,攻击行为都可以可靠地映射到MITRE ATT&CK。因此,E 中的每条边都将上下文实体或IoC连接到技术锚点,这为整合阶段提供了跨源对齐的领域特定信号。这些节点类型和边形成了BEACON的预定义本体。
3.1.1 行为定位
BEACON通过四个步骤将报告 r 中的攻击行为映射到ATT&CK技术。首先,由于CTI报告将攻击描述为连续叙述,其中映射到不同技术的操作出现时没有清晰边界,LLM将报告分解为原子行为列表。我们将原子行为 b 定义为一个 adversary 动作,如利用一个面向公众的服务或投放一个有效载荷,匹配ATT&CK定义单个技术的粒度。每个原子行为是一个简短的句子,使用报告自身的动词和技术术语表述,技术字符串如域名和文件路径保持不变。
其次,为将每个原子行为基于报告证据,BEACON使用确定性定位器,而不依赖LLM来定位证据。定位证据要求输出与报告文本完全匹配,而LLM输出是生成的而非从文本中检索的,因此生成的证据不保证在报告中存在。确定性定位器则保证每个证据跨度取自报告,避免了这种形式的幻觉。定位器采用基于评分的机制,根据与 b 共享的令牌对连续句子的每个有界窗口进行评分,每个匹配按其在整个报告中的频率倒数加权,使罕见术语占主导地位。评分前,定位器对行为中的每个词干和报告句子进行词干提取,并移除停用词和报告中最频繁的令牌,这些令牌携带的行为特定信息很少。匹配的两词和三词短语获得额外奖励,因为短语匹配比单令牌匹配更不可能是巧合。得分最高的窗口成为证据跨度 s(b)。如果多个窗口共享相同分数,定位器仅保留最短的一个,以使后续验证更加聚焦。
第三,由于ATT&CK包含数百种具有细微定义差异的技术,单个候选很容易遗漏正确的技术,LLM读取 b 及其 s(b),并提议多个候选ATT&CK技术。提议负责召回,因此候选技术仅需与证据相关。BEACON使用的ATT&CK版本中不存在的候选被移除,以抑制幻觉。例如,LLM可以提议一个已被撤销的ATT&CK技术,而其训练数据中仍包含该技术。
第四,BEACON通过LLM作为法官机制(Zheng等人,2023),对照MITRE ATT&CK目录中的官方定义验证剩余候选。LLM接收原子行为、其证据跨度以及每个候选的官方ATT&CK名称和定义,并分别判断每个候选。为保持判断间分数一致,LLM在预定义级别分配置信度。更高级别要求证据满足更多技术的定义。为将判断保持在证据范围内并防止弱证据通过,我们指示LLM不要从自身知识推断,并在证据不明确时要求保守评分。置信度超过阈值的候选成为锚点,每个都由报告内的证据支持,并携带其技术的官方ATT&CK ID,如T1190,该ID在所有报告中共享。
3.1.2 上下文实体和IoC提取
由于LLM在一次读取长报告时可能遗漏实体,BEACON将报告拆分为重叠的连续句子窗口,以便窗口边界处的实体有足够的上下文被提取。然后LLM根据预定义本体从每个窗口中提取上下文实体和IoC候选及其类型。与原子行为不同,原子行为由LLM改写,而上下文实体或IoC是报告的确切子字符串。因此,BEACON让LLM直接指定每个候选的证据句子,因为不正确的指定可以通过字符串匹配轻松检查。由于候选是LLM输出,可能在字符如大小写方面与报告文本不同,BEACON对未通过精确检查的候选应用词级匹配,该匹配规范化候选和每个句子,如果其词集Jaccard与候选的重叠超过阈值,则接受该句子。为防止错误位置移除真实实体,如果所有命名的句子都未通过两种检查,BEACON以相同方式搜索窗口的其余部分。在报告中任何地方都找不到的候选作为幻觉的一种形式被移除。
为减少重复验证,上下文实体和IoC首先被规范化和去重。由于IoC拼写稳定但常因类型特定约定而混淆,每类型确定性规范化器将每个IoC转换为规范化形式,如移除写入为example[.]com的域名中的方括号。具有相同规范化形式的IoC直接合并。上下文实体没有外部标准形式,因此BEACON仅将名称小写、移除多余空格,并合并完全相同的类型-名称对,将剩余情况留给整合阶段。去重后,BEACON验证上下文实体和IoC候选。同一上下文实体在不同上下文中可以扮演不同角色,因此候选是否通过并匹配其类型取决于其自身证据。LLM分别检查每个上下文候选,确认其匹配本体中的类型定义,它是特定实体而非像“一个流行网站”这样的通用描述,且既非营销语言,也非防御建议,也非报告元数据如作者和发布日期。当不确定时,LLM拒绝该候选。IoC候选在规范化后具有标准化形式,因此LLM在一次通过中对照完整报告审查它们,仅报告要拒绝的值或要修正的类型。
3.1.3 锚定附着
由于没有像三元组那样可提取的实体与ATT&CK技术之间的显式关系,BEACON在节点之后添加所有边。用LLM验证每个实体-技术对成本高昂,因此BEACON提议候选边以减少要验证的对数。由于参与行为的实体倾向于在报告中靠近该行为被描述,BEACON在实体的证据跨度与锚点的证据跨度共享至少一个句子时提议候选边。LLM接收两个跨度以及锚点的ATT&CK定义,并判断实体是否参与该行为。仅当共享句子明确描述关系或直接支持时,候选才被接受。当实体和行为仅出现在同一句子或属于同一报告主题时被拒绝,因此仅共现不产生边。
报告通常命名其中心实体(威胁行为者、恶意软件家族或活动),而不会在每个行为描述中重复它。这些行为的证据跨度因此从不包含实体,中心实体与其行为之间的边被遗漏。BEACON因此将ThreatActor、Campaign和MalwareFamily视为报告中心类型,并分两遍处理这些类型的实体。LLM首先根据报告文本和带有MITRE ATT&CK定义的ATT&CK技术判断该实体是否是报告的中心主题,即报告是否将该实体的行为描述为由此实体执行。与行为的共现、共享主题或模糊证据不足以做出此判断。通过此检查的实体随后与报告中的每个技术锚点配对,每个配对经历相同的验证过程。通过这些边,每个实体都被链接到携带跨所有报告共享的官方ATT&CK技术ID的锚点。
3.2 整合阶段
给定从CTI报告中提取的报告级图 {G₁, …, Gₙ},整合阶段合并指向同一现实世界实体的节点,并输出一个整合图 G∗。我们设计了一种分层对齐策略,按确定性递减的顺序应用对齐信号,并且由后续信号提议的每个合并在已由先前信号合并的图上运行。因此,LLM判断较小的一组模糊名称,既降低了成本,也减少了误分类和幻觉的机会。先前信号合并的节点还结合了其成员的证据,当LLM验证来自确定性较低的信号的候选时,为其提供了更丰富的上下文。
确定性匹配
由于锚定阶段已为每个技术锚点赋予其官方ATT&CK ID,两个锚点在携带相同ID时合并。两个IoC在共享类型且其值经每类型规范化后相同时合并。对于少数IoC类型,相同的字符串并不能可靠地指示同一现实世界实体,因此BEACON保持这些类型的IoC未合并。例如,互斥量名称(程序分配给锁的名称)可以被不相关的程序重用。具有相同类型和规范化名称的上下文实体直接合并。对于相同编号命名方案(前缀如APT、UNC、FIN(Google Cloud,)或TA(Proofpoint Threat Research Team,2025)后跟数字)中的威胁行为者名称,BEACON应用额外的类型特定规范化,如移除大小写和前导零差异,并且当前缀和数字都匹配时两个名称合并。每个合并节点保留每个成员的来源报告(图1,右),因此任何合并节点都可以追溯到支持它的句子和来源。
基于相似性的匹配
由于多个厂商独立以不同命名约定报告同一威胁,即使经过规范化,同一实体的名称仍可能不同,因此上下文实体需要的不只是确定性规则。还有三个候选提议通道,每个通道使用一个对齐信号来提议候选对。来自所有通道的对按类型组合成连通分量作为候选聚类,由LLM稍后验证。
字符通道针对拼写变体如“Cl0p”与“Clop”。由于实体类型在其名称的字符串模式上有所不同,该通道使用四种度量,每种适合不同的模式:Jaro–Winkler用于末尾不同的短名称,如尾部版本数字;归一化Levenshtein用于相差几个字符的名称,如Cl0p和Clop;三元余弦用于多词名称,因为当单词被插入或重新排序时其分数保持较高;以及三元Jaccard,一种更严格的忽略重复的重叠度量,用于重复子字符串会夸大相似性的短名称。每个实体类型由四种度量的加权子集评分,在评分前具有自己的规范化。例如,活动名称移除“Operation”前缀,并由三元余弦、Jaro–Winkler和归一化Levenshtein评分。当分数超过阈值时,一对成为候选。该通道在名称短时使用更高阈值,因为短名称更可能巧合地相似。两条额外规则处理字符相似性可能误导的CTI命名模式。首先,相同编号命名方案中但数字不同的威胁行为者对被排除在评分之外,因为像APT41和APT40这样的名称拼写几乎相同,但从不指同一实体。其次,短全字母名称与任何其首字母缩写它的多词名称配对,如IRS和Internal Revenue Service,这捕获了四种度量遗漏的首字母缩写对。
嵌入通道处理名称字符相似性太低而字符通道无法匹配,但可能在语义上相关的实体,如“Clop ransomware group”和“Cl0p”指同一行为者。文本嵌入模型编码每个实体名称,当嵌入余弦相似性超过阈值时,一对成为候选。为避免在类型内比较所有对,该通道仅计算具有基本词汇重叠的名称对的相似性:相同的规范化名称、共享的单词,或三元Jaccard或Jaro–Winkler分数低于低阈值的名称。具有编号命名方案的实体被排除在此通道之外,因为不同的数字总是指不同的实体,嵌入相似性可能违反这一规则。
技术邻域通道针对具有不相关名称的实体,字符和嵌入通道都无法提议这些实体,如Graceful Spider和Cl0p指同一行为者。它依赖于锚定阶段构建的结构。对于每个实体 v,该通道收集 v 附着到的ATT&CK技术邻域 N_a(v)。由于共享多个攻击行为的实体很可能是同一实体,当两个实体的邻域共享至少两个ATT&CK技术时,它们成为候选对。此通道最后运行,因为先前的合并结合了成员邻域并暴露了先前共享太少ATT&CK技术的候选。
三个通道提议的每个候选聚类都经过LLM验证。LLM接收每个成员的名称、类型、来源报告和证据跨度,并在两个粒度上以预定义级别给出置信度判断。由于候选聚类可能包含少数不属于的成员而其余正确,节点级判断移除不适合聚类的成员,同时保持聚类的其余部分有效。由于候选聚类是成对候选的连通分量,它可以包含从未被提议为对的名称。也就是说,如果A与B配对,B与C配对,则所有三个进入一个聚类,即使A和C是不同的实体。聚类级判断因此决定所有成员是否指向一个现实世界实体。
迭代闭包。
合并结合了其成员的ATT&CK技术邻域,因此先前共享太少技术的实体随后可以通过技术邻域通道成为候选。为对齐仅在先前合并后才成为候选的实体,该通道迭代直到没有新的合并通过验证。由于合并不创建新名称,字符和嵌入通道本来可以匹配的每一对在初始时已经可用,因此这些通道不迭代。结合邻域也增加了不相关实体之间的重叠,但重叠仅产生候选,并且每个候选在通过相同LLM验证后被接受。迭代总是停止,因为每轮要么合并节点,要么当没有候选通过验证时,邻域保持不变,因此无法提议新候选。
4 评估
4.1 评估设置
数据集
我们构建并发布两个数据集,BEACON-Single用于报告级提取,BEACON-Group用于跨来源整合。每个实例由两位专家标注员独立标注,分歧由高级标注员仲裁。据我们所知,BEACON-Single是最大的用于报告级CTI提取的人工标注数据集,BEACON-Group是第一个用于跨来源CTI整合的数据集。
BEACON-Single包含来自15个发布者的150份报告,包含4,966个标注节点实例和3,429个边实例。BEACON-Group将来自31个发布者的100份报告组织成33组,每组覆盖相同或密切相关的威胁。黄金标准整合将2,908个报告级节点合并为1,950个整合节点,其中528个组合了来自多个报告的节点,2,278条边合并为1,537条。
研究问题。
我们的评估回答三个问题:
-
RQ1:空间锚定阶段是否准确提取了所有三种节点类型及其边?
-
RQ2:整合阶段是否正确地跨源对齐实体?
-
RQ3:空间锚定阶段的验证和整合阶段每个基于相似性的通道贡献多少?
基线。
对于RQ1,我们比较了覆盖CTI提取两条线的五个系统。从关注上下文信息的线路上,CTINexus使用LLM端到端提取本体约束的关系三元组。从关注行为的线路上,AttacKG+使用LLM构建时态行为图并将其映射到ATT&CK技术;SoK-NER是一个基于规则和资源的ATT&CK匹配流水线;SIGMERGE-TTP是一个基于监督BERT的多子序列分类器,在固定的ATT&CK标签集上,其在我们数据集上的召回率上限为98.72%。分步引导LLM使用与BEACON相同的模型、输入和目标本体,但在一次引导调用中产生所有输出,而不经过锚定流水线。对于RQ2,基线覆盖了没有技术锚点的三种对齐信号。CTINexus对相同类型的实体进行聚类,其嵌入相似性超过阈值。由于其发布的实现在单个报告内去重,我们将组内所有报告的报告级节点合并到一个输入中,以便它跨它们去重。ComEM使用LLM判断由词汇相似性检索的候选对,并选择剩余候选中的最佳匹配。GA-MGM应用通用领域结构匹配,使用固定文本相似性和图拓扑联合对齐组内的所有图。所有基线输出通过确定性规则转换为我们的本体,而不访问黄金标注。
指标。
所有结果报告为微精确率、召回率和F1。对于RQ1,当预测节点或边在同一个报告中,在一对一匹配下,匹配相同类型的黄金节点或边时,预测正确。对于RQ2,我们以合并链接单位对最终聚类进行评分:大小为 k 的聚类贡献 k-1 个链接,与黄金聚类 G 重叠的预测聚类 P 贡献 max(|P∩G|-1, 0) 个正确链接。此指标奖励部分恢复的聚类,惩罚过度合并,并避免成对计数给予大聚类的二次权重。整体整合结果聚合所有三种节点类型。所有整合系统以相同的黄金报告级节点作为输入,因此RQ2独立于提取质量衡量对齐质量。
实现。
需要LLM的每个系统都使用GPT-4o(OpenAI,2024)。所有系统使用相同的ATT&CK v17.1快照,所有阈值在小型留出开发集上调优一次后固定。每个报告的数字来自每个配置的单个运行,我们通过95%百分位数自助置信区间(RQ1在报告上10,000次重采样,RQ2在组上)和主要比较的配对自助测试来量化采样不确定性。
4.2 结果
4.2.1 RQ1:锚定阶段提取
| P | R | F1 | P | R | F1 | P | R | F1 | P | R | F1 | P | R | F1 | |
| CTINexus (Cheng等人,2025b) | 40.93 | 31.26 | 35.45 | – | – | – | 41.81 | 14.04 | 21.02 | – | – | – | – | – | – |
| AttacKG+ (Zhang等人,2025) | 22.85 | 24.82 | 23.80 | 54.70 | 44.99 | 49.37 | 9.99 | 24.48 | 14.19 | – | – | – | – | – | – |
| SoK-NER (Büchel等人,2025) | – | – | – | 26.61 | 31.34 | 28.78 | – | – | – | – | – | – | – | – | – |
| SIGMERGE-TTP (Cai等人,2026) | – | – | – | 42.06 | 52.72 | 46.79 | – | – | – | – | – | – | – | – | – |
| 分步引导LLM | 73.23 | 34.64 | 47.03 | 68.22 | 27.57 | 39.27 | 88.65 | 42.98 | 57.89 | 39.91 | 11.07 | 17.33 | 38.69 | 17.09 | 23.70 |
| BEACON (Ours) | 90.66 | 68.08 | 77.77 | 72.51 | 84.60 | 78.09 | 83.68 | 79.32 | 81.44 | 59.10 | 62.64 | 60.82 | 56.68 | 45.56 | 50.52 |
| 表1:RQ1空间锚定提取:三种节点类型和两种边类型的微精确率、召回率和F1(%)。 最佳以粗体标出,次佳以下划线标出。“–”表示基线原生不产生的输出。 |
表1报告了空间锚定结果。BEACON在所有五种输出类型上达到最佳F1(总体78.7%,95% CI [77.4, 79.9]),并在每种类型上超过每个基线至少23%。分步引导LLM是覆盖所有五种输出的一个基线,与BEACON共享模型,因此这一优势来自空间锚定阶段的流水线而非模型。
技术锚点。
对于BEACON,TTP提取衡量整合阶段所依赖的技术锚点的质量。SIGMERGE-TTP召回率高但精确率低得多,因为分类器在官方ATT&CK文本上训练,对真实报告中更广泛的行为描述分配了过多的技术。AttacKG+在基线中达到最佳F1,但受限于其多步流水线,其中三元组重写和战术-技术标记各自丢失信息并累积错误。分步引导LLM的召回率最低,因为它在一次长引导调用中完成所有提取,遗漏了许多行为。BEACON的优势集中在召回率(84.60),因为将报告分解为原子行为允许为每个行为分别提议多个候选技术,而验证仅在证据跨度支持技术的ATT&CK定义时接受候选。
上下文实体和IoC。
CTINexus和AttacKG+仅在实体出现在关系三元组中时才提取实体,因此没有显式关系的实体不被提取。BEACON则将实体附着到技术锚点,而不需要实体-实体关系,这解释了其在上下文实体和IoC上更高的召回率。差异最大的是CTINexus,其IoC召回率为14.04,因为IoC通常出现在列表而非描述关系的句子中,因此三元组提取器很少找到包含它们的关系。AttacKG+仅提取与攻击相关的三元组,进一步限制了其覆盖的上下文实体范围,其部分低IoC分数来自与我们部分重叠的IoC类型。分步引导LLM因相同原因遗漏实体。在IoC上,分步引导LLM精确率较高但提取保守,遗漏了超过一半的黄金IoC,而BEACON的F1来自确定性规范化和过滤。
锚定边。
边是最难的输出,因为正确的边需要两个正确的端点和它们关系的已验证证据。分步引导LLM是唯一产生这些类型边的基线,因为SoK-NER和SIGMERGE-TTP仅提取技术,CTINexus和AttacKG+不将实体关联到技术。IoC–TTP边是两者中更难的,因为列表中的IoC很少与行为的证据跨度共享一个句子,因此提议的候选边更少。
4.2.2 RQ2:跨来源整合
| P | R | F1 | P | R | F1 | |
| GA-MGM (Wang等人,2020) | 31.42 | 45.51 | 37.17 | 10.06 | 56.67 | 17.09 |
| ComEM (Wang等人,2025) | 62.01 | 68.27 | 64.99 | 26.26 | 86.67 | 40.31 |
| CTINexus (Cheng等人,2025b) | 85.17 | 82.85 | 84.00 | 32.61 | 100.00 | 49.18 |
| BEACON (Ours) | 98.59 | 89.74 | 93.96 | 100.00 | 96.67 | 98.31 |
| 表2:RQ2整合阶段上下文实体和IoC的微精确率、召回率和F1(%)。 最佳以粗体标出,次佳以下划线标出。 |
完整整合。
表2报告了整合结果。BEACON在两种节点类型上达到最佳F1(93.96和98.31),并超过每个基线至少9%。技术锚点占958个黄金合并链接单元中的304个,通过共享技术ID确定性合并,因此从比较中排除。CTINexus通过嵌入相似性对齐实体,错误地合并了具有相似字符串的IoC(精确率32.61,而BEACON在确定性匹配下为100),且无法提议具有不相关名称的别名。ComEM也无法提议此类候选,且LLM无法判断未提议的对,这限制了召回率。其精确率低,因为其BM25阻塞和Flan-T5匹配排名都偏好具有重叠上下文的候选,且其选择器很少选择“不匹配”选项,因此来自同一活动的不同实体被合并。其IoC对齐不应用CTI特定规范化,依赖于模型自身对IoC格式的知识,导致F1低(40.31)。GA-MGM通过文本相似性和图拓扑对齐图,但它期望密集图,其中实体直接相互连接,而此任务中的报告图稀疏,边仅存在于实体和技术锚点之间,因此它同时失去了精确率和召回率。总体而言,共享技术邻域是跨来源持有的唯一结构信号,并给予BEACON其额外的领域特定对齐优势。
| CTINexus (Cheng等人,2025b) | 55.88 | 51.82 | 53.77 |
| ComEM (Wang等人,2025) | 39.66 | 75.00 | 51.89 |
| GA-MGM (Wang等人,2020) | 10.16 | 30.91 | 15.30 |
| BEACON (Ours) | 95.12 | 70.91 | 81.25 |
| 表3:RQ2残余对齐:确定性规则无法对齐的220个黄金上下文实体对齐单元的微精确率、召回率和F1(%)。 最佳以粗体标出,次佳以下划线标出。 |
残余对齐。
表3评估了确定性规则无法对齐的220个黄金上下文实体对齐单元,即名称拼写不同或跨来源完全不相关的实体。当其成员既不共享相同规范化名称也不共享相同类型-名称对时,保留一个单元,因此过滤器仅移除名称已经匹配的单元,每个比较系统都能正确对齐。BEACON在此子集上保留81.25 F1(95% CI [72.9, 87.3]),而CTINexus降至53.77([45.5, 61.8]),因为剩余情况集中在跨来源差异最大的别名上。两个区间不重叠,配对差异为+27.5 F1(p < 10⁻⁴)。嵌入相似性仍然对齐了大约一半的这些单元,但它无法对齐语义不相关的名称。ComEM达到51.89 F1,表中召回率最高(75.00)但精确率低(39.66),因为其选择器合并了几乎每个提议的候选。GA-MGM降至15.30,因为其两个信号在此子集上都失败。其文本相似性无法匹配不相关的名称,而相同编号命名方案中的名称看起来相似并被提议为匹配。由于没有排除此类对的规则且没有针对报告证据的验证,这些提议成为合并,这解释了其10.16的精确率。其图拓扑信号在这些稀疏报告图上也无帮助。在此子集上,技术邻域通道至关重要。移除它使F1从81.25降至64.85,因为从共享技术邻域提议并针对报告证据验证的候选对齐了字符和嵌入相似性都遗漏的实体。
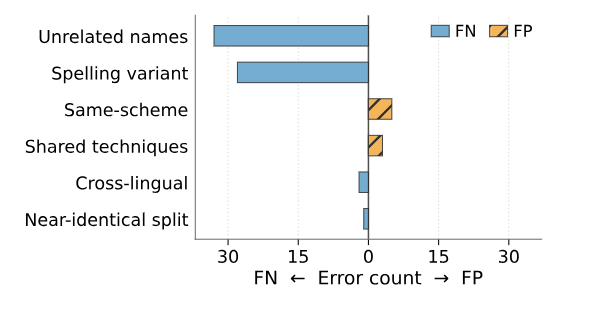
图3:在合并链接度量下的上下文实体错误分析。遗漏的合并(FN)显示在左侧,错误合并(FP)显示在右侧。
[图描述:两个条形图,显示遗漏合并和错误合并的原因分类。遗漏合并主要是由于完全不相关的名称(>50%)和LLM验证保守。错误合并主要是由于相似的名称。]
错误分析。
图3显示了在合并链接度量下的上下文实体错误,其中遗漏的合并大约是错误合并的十倍。超过一半的遗漏对齐来自名称完全不相关的实体,如SPIKEDWINE和APT29,其技术邻域共享太少技术,因此三个通道都无法提议该对。近一半的剩余遗漏对齐涉及缩写和拼写变体,但其主要原因是LLM验证保守,拒绝了证据支持薄弱的候选,如IRS和Internal Revenue Service这对,由字符通道提议但被拒绝。在错误合并方面,大多数情况合并了相似名称或相同编号命名方案中的名称,如Storm-1175与Storm-0506。排除规则覆盖固定的前缀列表,不包括Storm,表明CTI中的命名方案太多样化而无法枚举。其余的错误合并结合了两个共享技术但不同的行为者,如Black Basta和Cactus。
4.2.3 RQ3:组件归因
| 无实体审查 | Ctx | −14.06 | +7.67 | −1.59 |
| 无TTP验证 | TTP | −42.78 | +8.54 | −33.02 |
| 无IoC过滤 | IoC | −24.75 | +11.76 | −9.88 |
| 无边确认 | Ctx–TTP | −15.42 | +2.71 | −8.46 |
| 无边确认 | IoC–TTP | −14.02 | +4.11 | −4.62 |
| 表4:RQ3:空间锚定验证消融。 每行移除一个验证组件,并报告相对于完整BEACON(表1),该组件应用于的输出类型上微P/R/F1(%)的变化。 |
锚定验证。
表4报告了空间锚定阶段每个验证组件的消融。每次移除都提高召回率但降低精确率更多,因此验证以较小的召回率代价抑制误分类和幻觉。TTP验证效果最大,确认了对照官方ATT&CK定义验证候选技术的价值。实体审查效果最平衡,F1几乎不变。IoC过滤显著改变精确率和召回率,因为像路径和IP这样的IoC易于按格式提取,但并非所有都与攻击相关,因此过滤器移除了许多不相关的,同时偶尔移除有效的。移除边确认在两种边类型上都显著降低精确率,这表明许多从共享句子提议的候选边反映的是共现而非参与。
| P | R | F1 | F1 | |
| 无字符度量 | 98.39 | 88.30 | 93.07 | 95.52 |
| 无字符规则 | 98.74 | 88.14 | 93.14 | 95.56 |
| 无嵌入 | 99.03 | 81.57 | 89.46 | 93.30 |
| 无邻域 | 99.42 | 81.89 | 89.81 | 93.52 |
| 完整BEACON | 98.59 | 89.74 | 93.96 | 96.07 |
| 表5:RQ3整合阶段消融使用微指标(%)。 每行移除一个候选提议组件。最佳以粗体标出,次佳以下划线标出。 |
整合通道。
表5报告了整合阶段每个提议组件的消融。完整配置达到最佳上下文和总体F1,每次移除都降低召回率,而精确率几乎不变,因为通道仅提议候选,相同的LLM验证决定每个合并。嵌入和邻域通道对召回率贡献最大,程度相似。邻域通道对齐嵌入通道无法提议的具有不相关名称的实体。两个字符级组件贡献较少,因为其简单情况已由确定性规范化解决,其较难情况部分由嵌入通道处理。移除邻域通道时精确率最高(99.42),表明邻域通道提议了三个中最不可靠的候选。
5 结论
我们发现现有从CTI报告构建知识图谱的方法仅提取部分信息,且跨来源设置未被探索。我们基于攻击行为可以可靠地映射到MITRE ATT&CK,而上下文实体和IoC描述其参与者和痕迹的洞察,提出了BEACON。空间锚定阶段将上下文实体和IoC附着到ATT&CK技术锚点,将每个报告的图置于一个规范空间中。整合阶段通过按确定性递减顺序应用的信号合并它们,其中共享的技术邻域对于对齐具有不相关名称的实体至关重要。为抑制误分类和幻觉,两个阶段都遵循基于报告证据的“先提议后验证”范式。在我们构建并发布的两个人工标注数据集上,BEACON优于所有基线。