Zhiqi Li(^{1,2*}),Wenhai Wang(^{2*}),Hongyang Li(^{2*}),Enze Xie(^{3}),Chonghao Sima(^{2}),Tong Lu(^{1}),Yu Qiao(^{2}),Jifeng Dai(^{2})
(^{1}) 南京大学 (^{2}) 上海人工智能实验室 (^{3}) 香港大学
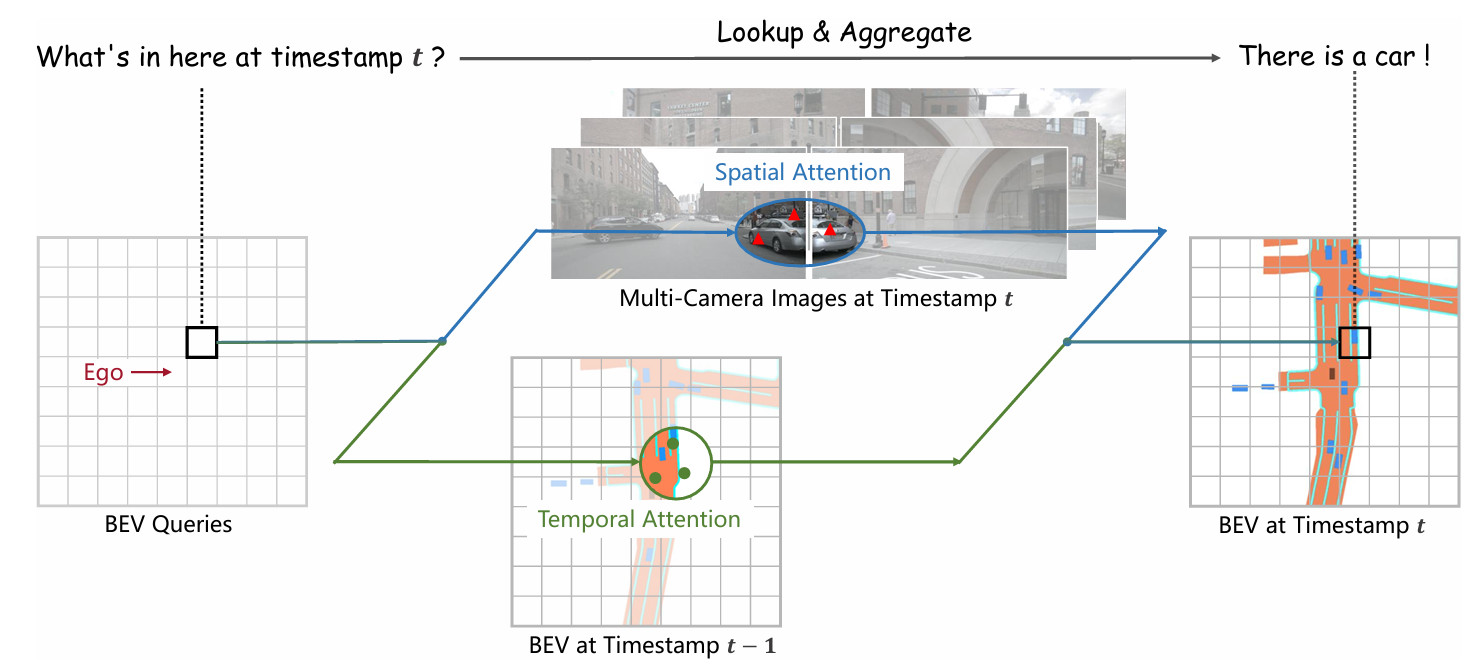
图1:我们提出BEVFormer,一种用于自动驾驶的范式,它同时应用Transformer和时间结构,从多相机输入生成鸟瞰图(BEV)特征。BEVFormer利用查询来查找空间/时间空间,并相应地聚合时空信息,从而为感知任务带来更强的表示。
摘要
基于多相机图像的3D视觉感知任务,包括3D检测和地图分割,对自动驾驶系统至关重要。在这项工作中,我们提出了一种新框架,称为BEVFormer,它使用时空Transformer学习统一的BEV表示,以支持多种自动驾驶感知任务。简而言之,BEVFormer通过预定义的网格状BEV查询与空间和时间空间交互,从而利用空间和时间信息。为了聚合空间信息,我们设计了空间交叉注意力,使每个BEV查询从跨相机视图的感兴趣区域中提取空间特征。对于时间信息,我们提出时间自注意力,以循环方式融合历史BEV信息。我们的方法在nuScenes测试集上以NDS指标取得新的最先进结果56.9%56.9\\%56.9%,比之前最佳方法高9.09.09.0个点,并与基于LiDAR的基线性能相当。我们进一步表明,BEVFormer显著提高了速度估计的准确性以及在低能见度条件下目标的召回率。代码可在https://github.com/fundamentalvision/BEVFormer获取。
1 引言
3D空间中的感知对于自动驾驶、机器人等多种应用至关重要。尽管基于LiDAR的方法[43, 20, 54, 50, 8]取得了显著进展,基于相机的方法[45, 32, 47, 30]近年来也受到了广泛关注。除了部署成本低之外,与基于LiDAR的对应方法相比,相机还具有检测远距离目标和识别基于视觉的道路元素(例如交通灯、停止线)的理想优势。
自动驾驶中对周围场景的视觉感知,期望根据多个相机给出的2D线索预测3D边界框或语义地图。最直接的解决方案基于单目框架[45, 44, 31, 35, 3]和跨相机后处理。该框架的缺点在于分别处理不同视图,无法捕获跨相机信息,导致性能和效率较低[32, 47]。
作为单目框架的替代方案,一种更统一的框架是从多相机图像中提取整体表示。鸟瞰图(BEV)是周围场景常用表示,因为它清晰呈现目标的位置和尺度,并适用于多种自动驾驶任务,例如感知和规划[29]。尽管先前的地图分割方法证明了BEV的有效性[32, 18, 29],但在3D目标检测中,基于BEV的方法尚未显示出相对于其他范式的显著优势[47, 31, 34]。根本原因在于3D目标检测任务需要强BEV特征来支持准确的3D边界框预测,而从2D平面生成BEV是病态的。一种流行的生成BEV特征的BEV框架基于深度信息[46, 32, 34],但该范式对深度值或深度分布的准确性敏感。因此,基于BEV的方法的检测性能会受到复合误差影响[47],不准确的BEV特征会严重损害最终性能。因此,我们受到启发设计一种不依赖深度信息、能够自适应学习BEV特征而不是严格依赖3D先验的BEV生成方法。Transformer使用注意力机制动态聚合有价值特征,在概念上满足我们的需求。
使用BEV特征执行感知任务的另一个动机是,BEV是连接时间空间和空间空间的理想桥梁。对于人类视觉感知系统,时间信息在推断目标运动状态和识别被遮挡目标方面起着关键作用,视觉领域的许多工作已经证明了使用视频数据的有效性[2, 27, 26, 33, 19]。然而,现有多相机3D检测的最先进方法很少利用时间信息。重大挑战在于自动驾驶具有时间关键性,场景中的目标快速变化,因此简单堆叠跨时间戳的BEV特征会带来额外计算成本和干扰信息,可能并不理想。受循环神经网络(RNN)[17, 10]启发,我们利用BEV特征以循环方式将时间信息从过去传递到现在,这与RNN模型的隐藏状态具有相同精神。
为此,我们提出一种基于Transformer的鸟瞰图(BEV)编码器,称为BEVFormer,它可以有效聚合来自多视图相机和历史BEV特征的时空特征。由BEVFormer生成的BEV特征可以同时支持多种3D感知任务,例如3D目标检测和地图分割,这对自动驾驶系统很有价值。如图1所示,我们的BEVFormer包含三个关键设计:(1)网格状BEV查询,通过注意力机制灵活融合空间和时间特征;(2)空间交叉注意力模块,聚合来自多相机图像的空间特征;(3)时间自注意力模块,从历史BEV特征中提取时间信息,这有利于运动目标的速度估计和严重遮挡目标的检测,同时带来可忽略的计算开销。利用BEVFormer生成的统一特征,模型可以与不同任务特定头(如Deformable DETR[56]和掩码解码器[22])协作,实现端到端3D目标检测和地图分割。
我们的主要贡献如下:
- 我们提出BEVFormer,一种时空Transformer编码器,将多相机和/或时间戳输入投影为BEV表示。借助统一BEV特征,我们的模型可以同时支持多种自动驾驶感知任务,包括3D检测和地图分割。
- 我们设计了可学习BEV查询,以及空间交叉注意力层和时间自注意力层,分别从跨相机中查找空间特征、从历史BEV中查找时间特征,然后将它们聚合为统一BEV特征。
- 我们在多个具有挑战性的基准上评估所提出的BEVFormer,包括nuScenes[4]和Waymo[40]。与先前方法相比,我们的BEVFormer持续取得改进性能。例如,在可比参数和计算开销下,BEVFormer在nuScenes测试集上取得56.9%56.9\\%56.9% NDS,比先前最佳检测方法DETR3D[47]高9.09.09.0个点(56.9%56.9\\%56.9%对47.9%47.9\\%47.9%)。对于地图分割任务,我们也取得最先进性能,在最困难的车道分割上比Lift-Splat[32]高超过5.05.05.0个点。我们希望这一直接而强大的框架可以作为后续3D感知任务的新基线。
2 相关工作
2.1 基于Transformer的2D感知
最近,一个新趋势是使用Transformer重新表述检测和分割任务[7, 56, 22]。
DETR[7]使用一组目标查询,通过交叉注意力解码器直接生成检测结果。然而,DETR的主要缺点是训练时间长。Deformable DETR[56]通过提出可变形注意力解决了这个问题。与DETR中的普通全局注意力不同,可变形注意力与局部感兴趣区域交互,仅在每个参考点附近采样KKK个点并计算注意力结果,从而具有高效率并显著缩短训练时间。可变形注意力机制计算如下:
DeformAttn(q,p,x)=∑i=1NkeyWi∑j=1NkeyAij⋅Wi′x(p+Δpij),
\\mathrm{DeformAttn}(q,p,x) = \\sum_{i = 1}^{N_{\\mathrm{key}}}W_{i}\\sum_{j = 1}^{N_{\\mathrm{key}}}\\mathcal{A}_{ij}\\cdot \\mathcal{W}_{i}^{\\prime}x(p + \\Delta p_{ij}),
DeformAttn(q,p,x)=i=1∑NkeyWij=1∑NkeyAij⋅Wi′x(p+Δpij),
其中q,p,xq,p,xq,p,x分别表示查询、参考点和输入特征。iii索引注意力头,NheadN_{\\mathrm{head}}Nhead表示注意力头总数。jjj索引采样键,NkeyN_{\\mathrm{key}}Nkey是每个头的总采样键数。Wi∈RC×(C/Hhead)W_{i}\\in \\mathbb{R}^{C\\times (C / H_{\\mathrm{head}})}Wi∈RC×(C/Hhead)和Wi′∈R(C/Hhead)×CW_{i}^{\\prime}\\in \\mathbb{R}^{(C / H_{\\mathrm{head}})\\times C}Wi′∈R(C/Hhead)×C是可学习权重,其中CCC是特征维度。Aij∈[0,1]A_{ij}\\in [0,1]Aij∈[0,1]是预测的注意力权重,并由∑j=1NkeyAij=1\\sum_{j = 1}^{N_{\\mathrm{key}}}A_{ij} = 1∑j=1NkeyAij=1归一化。Δpij∈R2\\Delta p_{ij}\\in \\mathbb{R}^2Δpij∈R2是参考点ppp的预测偏移。x(p+Δpij)x(p + \\Delta p_{ij})x(p+Δpij)表示位置p+Δpijp + \\Delta p_{ij}p+Δpij处的特征,通过双线性插值提取,如Dai等人[12]所述。在这项工作中,我们将可变形注意力扩展到3D感知任务,以高效聚合空间和时间信息。
2.2 基于相机的3D感知
先前的3D感知方法通常独立执行3D目标检测或地图分割任务。对于3D目标检测任务,早期方法类似于2D检测方法[1, 28, 49, 39, 53],通常基于2D边界框预测3D边界框。Wang等人[45]遵循先进的2D检测器FCOS[41],并直接为每个目标预测3D边界框。DETR3D[47]将可学习3D查询投影到2D图像中,然后采样相应特征进行端到端3D边界框预测,无需NMS后处理。另一种解决方案是将图像特征变换为BEV特征,并从俯视图预测3D边界框。这些方法利用深度估计[46]或类别深度分布[34]中的深度信息将图像特征变换为BEV特征。OFT[36]和ImVoxelNet[37]将预定义体素投影到图像特征上,以生成场景的体素表示。最近,(\\mathbf{M}^2)BEV[48]进一步探索了基于BEV特征同时执行多种感知任务的可行性。
实际上,从多相机特征生成BEV特征在地图分割任务中得到了更广泛研究[32, 30]。一种直接方法是通过逆透视映射(IPM)[35, 5]将透视视图转换为BEV。此外,Lift-Splat[32]基于深度分布生成BEV特征。方法[30, 16, 9]利用多层感知机学习从透视视图到BEV的转换。PYVA[51]提出一种跨视图Transformer,将前视单目图像转换为BEV,但由于全局注意力机制[42]的计算成本,该范式不适合融合多相机特征。除空间信息外,先前工作[18, 38, 6]还通过堆叠若干时间戳的BEV特征来考虑时间信息。堆叠BEV特征将可用时间信息限制在固定时间持续时间内,并带来额外计算成本。在这项工作中,所提出的时空Transformer通过同时考虑空间和时间线索生成当前时间的BEV特征,并且时间信息通过RNN方式从先前BEV特征中获得,仅带来少量计算成本。
3 BEVFormer
将多相机图像特征转换为鸟瞰图(BEV)特征,可以为多种自动驾驶感知任务提供统一的周围环境表示。在这项工作中,我们提出一种新的基于Transformer的BEV生成框架,可以通过注意力机制有效聚合来自多视图相机和历史BEV特征的时空特征。
3.1 整体架构
如图2所示,BEVFormer有6个编码器层,每一层遵循Transformer[42]的传统结构,但有三项定制设计,即BEV查询、空间交叉注意力和时间自注意力。具体而言,BEV查询是网格状可学习参数,设计用于通过注意力机制从多相机视图中查询BEV空间中的特征。空间交叉注意力和时间自注意力是与BEV查询一起工作的注意力层,用于根据BEV查询从多相机图像中查找并聚合空间特征,以及从历史BEV中查找并聚合时间特征。
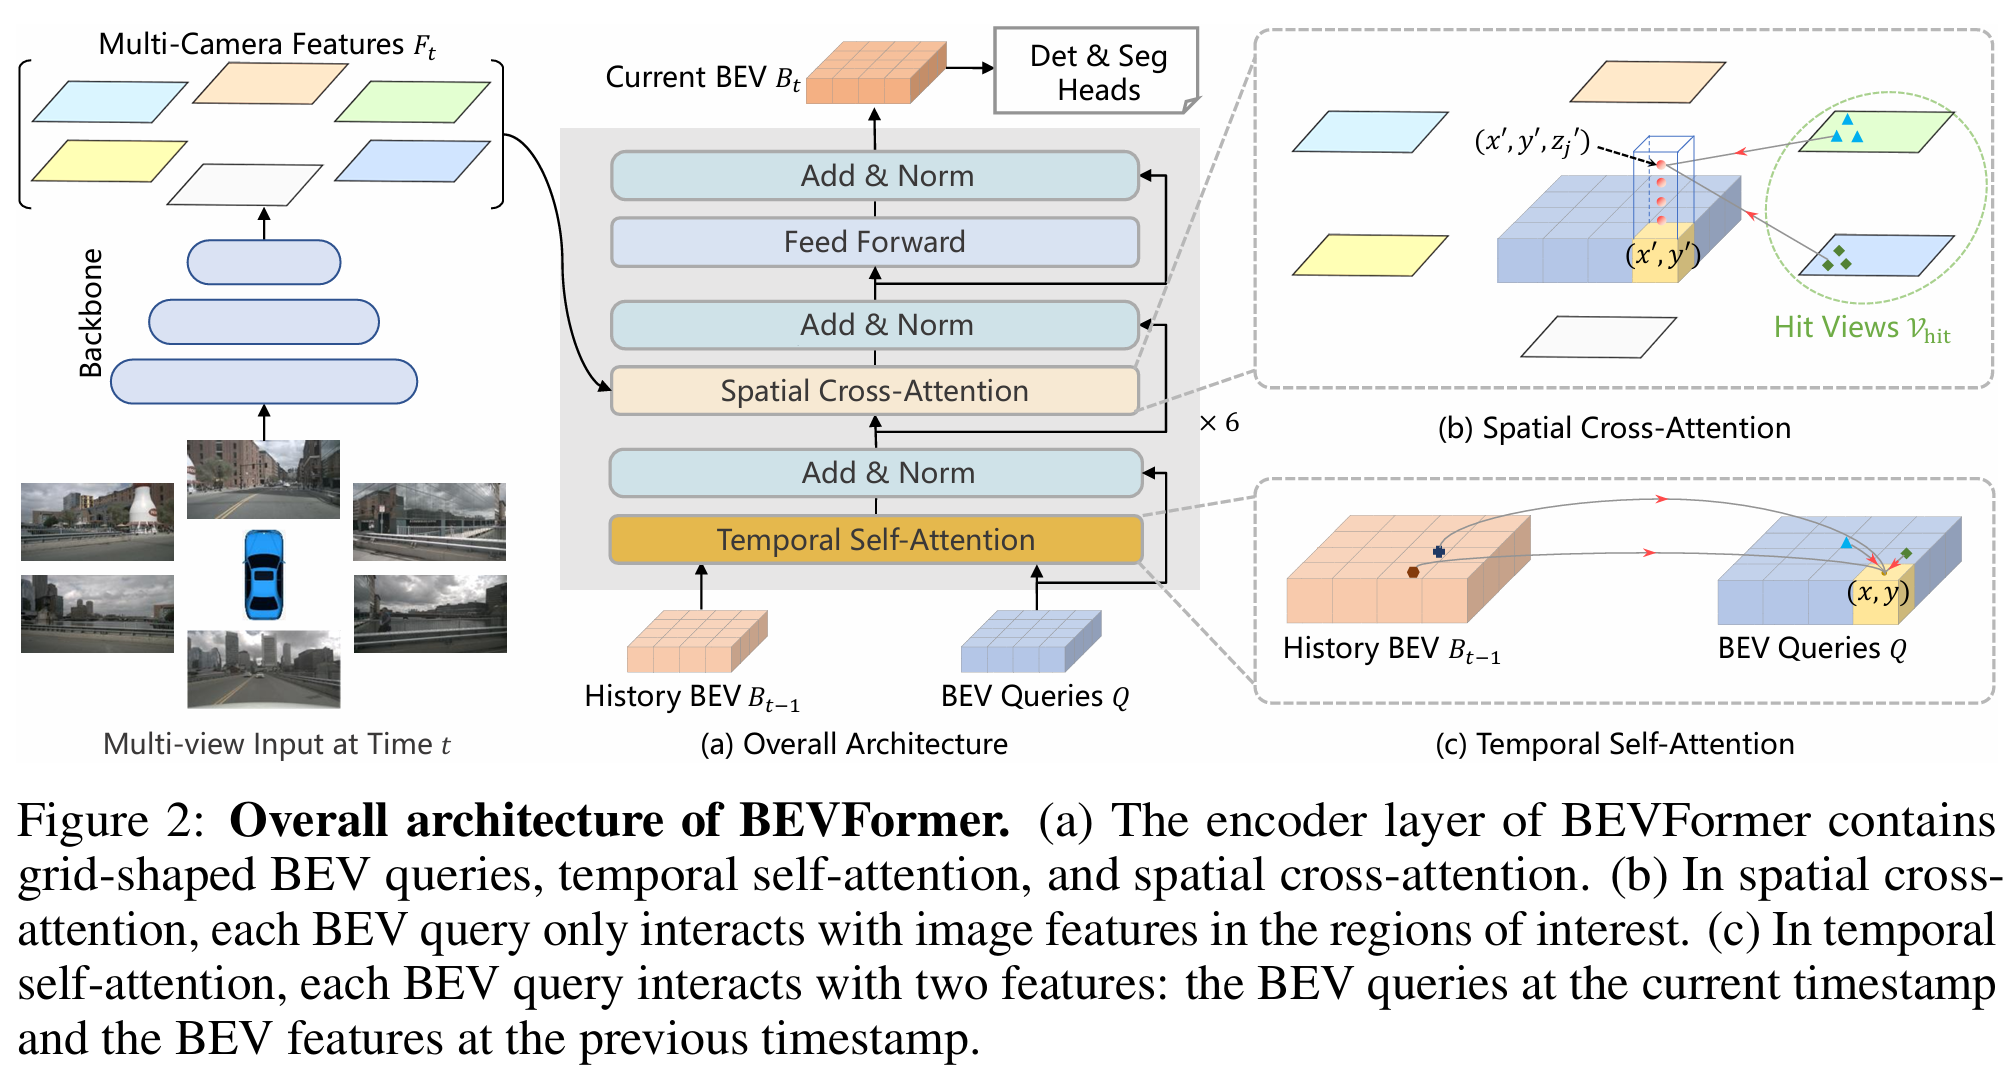
在推理期间,在时间戳ttt,我们将多相机图像输入主干网络(例如ResNet-101[15]),并获得不同相机视图的特征Ft={Fti}i=1NviewF_{t} = \\{F_{t}^{i}\\}_{i = 1}^{N_{\\mathrm{view}}}Ft={Fti}i=1Nview,其中FtiF_{t}^{i}Fti是第iii个视图的特征,NviewN_{\\mathrm{view}}Nview是相机视图总数。同时,我们保留先前时间戳t−1t – 1t−1的BEV特征Bt−1B_{t – 1}Bt−1。在每个编码器层中,我们首先使用BEV查询QQQ通过时间自注意力从先前BEV特征Bt−1B_{t – 1}Bt−1查询时间信息。然后,我们采用BEV查询QQQ通过空间交叉注意力从多相机特征FtF_{t}Ft查询空间信息。经过前馈网络[42]后,编码器层输出细化后的BEV特征,作为下一编码器层的输入。经过6个堆叠编码器层后,生成当前时间戳ttt的统一BEV特征BtB_{t}Bt。以BEV特征BtB_{t}Bt为输入,3D检测头和地图分割头预测感知结果,例如3D边界框和语义地图。
3.2 BEV查询
我们预定义一组网格状可学习参数Q∈RH×W×CQ \\in \\mathbb{R}^{H \\times W \\times C}Q∈RH×W×C作为BEVFormer的查询,其中H,WH, WH,W是BEV平面的空间形状。具体而言,位于QQQ中p=(x,y)p = (x, y)p=(x,y)处的查询Qp∈R1×CQ_{p} \\in \\mathbb{R}^{1 \\times C}Qp∈R1×C负责BEV平面中对应的网格单元区域。BEV平面中的每个网格单元对应现实世界大小sss米。BEV特征的中心默认对应自车位置。遵循常见做法[14],在将BEV查询QQQ输入BEVFormer之前,我们向其添加可学习位置嵌入。
3.3 空间交叉注意力
由于多相机3D感知的输入规模很大(包含NviewN_{\\mathrm{view}}Nview个相机视图),普通多头注意力[42]的计算成本极高。因此,我们基于可变形注意力[56]开发空间交叉注意力,这是一种资源高效的注意力层,其中每个BEV查询QpQ_{p}Qp仅与其跨相机视图的感兴趣区域交互。然而,可变形注意力最初是为2D感知设计的,因此需要针对3D场景进行一些调整。
如图2(b)所示,我们首先将BEV平面上的每个查询提升为柱状查询[20],从柱中采样NrefN_{\\mathrm{ref}}Nref个3D参考点,然后将这些点投影到2D视图。对于一个BEV查询,投影的2D点只能落在某些视图上,其他视图不会被命中。这里,我们将命中的视图称为νhit\\nu_{\\mathrm{hit}}νhit。之后,我们将这些2D点视为查询QpQ_{p}Qp的参考点,并从命中视图νhit\\nu_{\\mathrm{hit}}νhit中围绕这些参考点采样特征。最后,我们对采样特征执行加权求和,作为空间交叉注意力的输出。空间交叉注意力(SCA)过程可以表述为:
SCA(Qp,Ft)=1∣νhit∣∑i∈νhit∑j=1NrefDeformAttn(Qp,P(p,i,j),Fti),
\\mathrm{SCA}(Q_{p},F_{t}) = \\frac{1}{|\\nu_{\\mathrm{hit}}|}\\sum_{i\\in \\nu_{\\mathrm{hit}}}\\sum_{j = 1}^{N_{\\mathrm{ref}}}\\mathrm{DeformAttn}(Q_{p},\\mathcal{P}(p,i,j),F_{t}^{i}),
SCA(Qp,Ft)=∣νhit∣1i∈νhit∑j=1∑NrefDeformAttn(Qp,P(p,i,j),Fti),
其中iii索引相机视图,jjj索引参考点,NrefN_{\\mathrm{ref}}Nref是每个BEV查询的总参考点数。FtiF_{t}^{i}Fti是第iii个相机视图的特征。对于每个BEV查询QpQ_{p}Qp,我们使用投影函数P(p,i,j)\\mathcal{P}(p,i,j)P(p,i,j)获得第iii个视图图像上的第jjj个参考点。
接下来,我们介绍如何从投影函数P\\mathcal{P}P获得视图图像上的参考点。我们首先计算位于QQQ中p=(x,y)p = (x, y)p=(x,y)处的查询QpQ_{p}Qp对应的现实世界位置(x′,y′)(x^{\\prime}, y^{\\prime})(x′,y′),如式3所示。
x′=(x−W2)×s,y′=(y−H2)×s,
x^{\\prime} = (x – \\frac{W}{2})\\times s,\\quad y^{\\prime} = (y – \\frac{H}{2})\\times s,
x′=(x−2W)×s,y′=(y−2H)×s,
其中H,WH, WH,W是BEV查询的空间形状,sss是BEV网格分辨率大小,(x′,y′)(x^{\\prime}, y^{\\prime})(x′,y′)是以自车位置为原点的坐标。在3D空间中,位于(x′,y′)(x^{\\prime}, y^{\\prime})(x′,y′)的目标将出现在z轴上的高度z′z^{\\prime}z′处。因此,我们预定义一组锚定高度{zj′}j=1Nref\\{z_{j}^{\\prime}\\}_{j = 1}^{N_{\\mathrm{ref}}}{zj′}j=1Nref,以确保能够捕获出现在不同高度的线索。这样,对于每个查询QpQ_{p}Qp,我们获得3D参考点的柱(x′,y′,zj′)j=1Nref(x^{\\prime}, y^{\\prime}, z_{j}^{\\prime})_{j = 1}^{N_{\\mathrm{ref}}}(x′,y′,zj′)j=1Nref。最后,我们通过相机投影矩阵将3D参考点投影到不同图像视图,可以写为:
P(p,i,j)=(xij,yij)
\\mathcal{P}(p,i,j) = (x_{ij},y_{ij})
P(p,i,j)=(xij,yij)
其中
zij⋅[xijyij1]T=Ti⋅[x′y′zj′1]T.
z_{ij}\\cdot [x_{ij}y_{ij}1]^T = T_i\\cdot [x^{\\prime}y^{\\prime}z_{j}^{\\prime}1]^T.
zij⋅[xijyij1]T=Ti⋅[x′y′zj′1]T.
这里,P(p,i,j)\\mathcal{P}(p, i, j)P(p,i,j)是从第jjj个3D点(x′,y′,zj′)(x^{\\prime}, y^{\\prime}, z_{j}^{\\prime})(x′,y′,zj′)投影到第iii个视图上的2D点,Ti∈R3×4T_{i} \\in \\mathbb{R}^{3 \\times 4}Ti∈R3×4是第iii个相机的已知投影矩阵。
3.4 时间自注意力
除空间信息外,时间信息对于视觉系统理解周围环境也至关重要[27]。例如,没有时间线索,很难从静态图像推断运动目标的速度或检测严重遮挡目标。为解决这个问题,我们设计时间自注意力,它可以通过结合历史BEV特征来表示当前环境。
给定当前时间戳ttt的BEV查询QQQ和在时间戳t−1t – 1t−1保留的历史BEV特征Bt−1B_{t – 1}Bt−1,我们首先根据自车运动将Bt−1B_{t – 1}Bt−1对齐到QQQ,使相同网格处的特征对应相同现实世界位置。这里,我们将对齐后的历史BEV特征Bt−1B_{t – 1}Bt−1记为Bt−1′B_{t – 1}^{\\prime}Bt−1′。然而,从时间t−1t – 1t−1到ttt,可移动目标在现实世界中以各种偏移移动。构建不同时间BEV特征中同一目标的精确关联具有挑战性。因此,我们通过时间自注意力(TSA)层建模特征之间的这种时间连接,可以写为:
TSA(Qp,{Q,Bt−1′})=∑V∈{Q,Bt−1′}DeformAttn(Qp,p,V),
\\mathrm{TSA}(Q_p,\\{Q,B_{t – 1}^{\\prime}\\}) = \\sum_{V\\in \\{Q,B_{t – 1}^{\\prime}\\}}\\mathrm{DeformAttn}(Q_p,p,V),
TSA(Qp,{Q,Bt−1′})=V∈{Q,Bt−1′}∑DeformAttn(Qp,p,V),
其中QpQ_{p}Qp表示位于p=(x,y)p = (x,y)p=(x,y)处的BEV查询。此外,与普通可变形注意力不同,时间自注意力中的偏移Δp\\Delta pΔp由QQQ和Bt−1′B_{t – 1}^{\\prime}Bt−1′的拼接预测。具体而言,对于每个序列的第一个样本,时间自注意力将退化为没有时间信息的自注意力,此时我们将BEV特征{Q,Bt−1′}\\{Q,B_{t – 1}^{\\prime}\\}{Q,Bt−1′}替换为重复的BEV查询{Q,Q}\\{Q,Q\\}{Q,Q}。
与[18, 38, 6]中简单堆叠BEV相比,我们的时间自注意力可以更有效地建模长时间依赖。BEVFormer从先前BEV特征中提取时间信息,而不是堆叠多个BEV特征,因此需要更少计算成本并受到更少干扰信息影响。
3.5 BEV特征的应用
由于BEV特征Bt∈RH×W×CB_{t} \\in \\mathbb{R}^{H \\times W \\times C}Bt∈RH×W×C是一种通用2D特征图,可用于多种自动驾驶感知任务,因此3D目标检测和地图分割任务头可以基于2D感知方法[56, 22]进行少量修改来开发。
对于3D目标检测,我们基于2D检测器Deformable DETR[56]设计端到端3D检测头。修改包括使用单尺度BEV特征BtB_{t}Bt作为解码器输入,预测3D边界框和速度而不是2D边界框,并且仅使用L1L_{1}L1损失监督3D边界框回归。借助该检测头,我们的模型可以端到端预测3D边界框和速度,无需NMS后处理。
对于地图分割,我们基于2D分割方法Panoptic SegFormer[22]设计地图分割头。由于基于BEV的地图分割基本上与常见语义分割相同,我们利用[22]的掩码解码器和类别固定查询来针对每个语义类别,包括汽车、车辆、道路(可行驶区域)和车道。
3.6 实现细节
训练阶段。对于时间戳ttt的每个样本,我们从过去2秒的连续序列中随机采样另外3个样本,这种随机采样策略可以增强自车运动的多样性[57]。我们将这四个样本的时间戳记为t−3t – 3t−3、t−2t – 2t−2、t−1t – 1t−1和ttt。对于前三个时间戳的样本,它们负责循环生成BEV特征{Bt−3,Bt−2,Bt−1}\\{B_{t – 3}, B_{t – 2}, B_{t – 1}\\}{Bt−3,Bt−2,Bt−1},该阶段不需要梯度。对于时间戳t−3t – 3t−3的第一个样本,没有先前BEV特征,时间自注意力退化为自注意力。在时间ttt,模型基于多相机输入和先前BEV特征Bt−1B_{t – 1}Bt−1生成BEV特征BtB_{t}Bt,因此BtB_{t}Bt包含跨四个样本的时间和空间线索。最后,我们将BEV特征BtB_{t}Bt输入检测和分割头并计算相应损失函数。
推理阶段。在推理阶段,我们按时间顺序评估视频序列的每一帧。先前时间戳的BEV特征被保存并用于下一帧,这种在线推理策略时间高效,并与实际应用一致。尽管我们利用时间信息,但我们的推理速度仍与其他方法[45, 47]相当。
4 实验
4.1 数据集
我们在两个具有挑战性的公开自动驾驶数据集上进行实验,即nuScenes数据集[4]和Waymo开放数据集[40]。
nuScenes数据集[4]包含1000个场景,每个场景约20秒,关键样本以2Hz标注。每个样本由6个相机的RGB图像组成,具有360∘360^{\\circ}360∘水平视场。对于检测任务,有来自10个类别的140万个标注3D边界框。我们遵循[32]的设置执行BEV分割任务。该数据集还提供检测任务的官方评估指标。nuScenes的平均精度均值(mAP)使用地面平面上的中心距离而不是3D交并比(IoU)计算,以匹配预测结果和真值。nuScenes指标还包含5种真正例指标(TP指标),包括ATE、ASE、AOE、AVE和AAE,分别测量平移、尺度、方向、速度和属性误差。nuScenes还定义nuScenes检测分数(NDS)为NDS=110[5mAP+∑mTP∈TP(1−min(1,mTP))]\\mathrm{NDS} = \\frac{1}{10} [5\\mathrm{mAP} + \\sum_{m\\mathrm{TP}\\in \\mathrm{TP}}(1 – \\min (1,m\\mathrm{TP}))]NDS=101[5mAP+∑mTP∈TP(1−min(1,mTP))],以捕获nuScenes检测任务的各个方面。
Waymo开放数据集[40]是一个大规模自动驾驶数据集,包含798个训练序列和202个验证序列。注意,Waymo每帧提供的五张图像只有约252∘252^{\\circ}252∘水平视场,但提供的标注标签是自车周围360∘360^{\\circ}360∘。我们移除训练和验证集中无法在任何图像上看到的边界框。由于Waymo开放数据集规模大且频率高[34],我们使用训练划分的子集,从训练序列中每第555帧采样,并且只检测车辆类别。我们使用0.5和0.7的3D IoU阈值计算Waymo数据集上的mAP。
4.2 实验设置
遵循先前方法[45, 47, 31],我们采用两类主干:ResNet101-DCN[15, 12](从FCOS3D[45]检查点初始化)和VoVnet-99[21](从DD3D[31]检查点初始化)。默认情况下,我们利用FPN[23]输出的多尺度特征,尺寸为ν16\\nu_{16}ν16、ν32\\nu_{32}ν32、ν64\\nu_{64}ν64,维度为C=256C = 256C=256。对于nuScenes实验,BEV查询默认大小为200×200200\\times 200200×200,感知范围为XXX和YYY轴[−51.2m,51.2m][- 51.2\\mathrm{m},51.2\\mathrm{m}][−51.2m,51.2m],BEV网格分辨率大小sss为0.512m0.512\\mathrm{m}0.512m。我们对BEV查询采用可学习位置嵌入。BEV编码器包含6个编码器层,并在每层不断细化BEV查询。每个编码器层的输入BEV特征Bt−1B_{t – 1}Bt−1相同且不需要梯度。对于每个局部查询,在由可变形注意力机制实现的空间交叉注意力模块中,它对应Nref=4N_{\\mathrm{ref}} = 4Nref=4个不同高度的3D目标点,预定义高度锚从−5- 5−5米到3米均匀采样。对于2D视图特征上的每个参考点,我们在每个头的该参考点周围使用四个采样点。默认情况下,我们以24个epoch、学习率2×10−42\\times 10^{- 4}2×10⁻⁴训练模型。
对于Waymo实验,我们更改少量设置。由于Waymo的相机系统无法捕获自车周围整个场景[40],BEV查询默认空间形状为300×220300\\times 220300×220,感知范围为XXX轴[−35.0m,75.0m][- 35.0\\mathrm{m},75.0\\mathrm{m}][−35.0m,75.0m]和YYY轴[−75.0m,75.0m][- 75.0\\mathrm{m},75.0\\mathrm{m}][−75.0m,75.0m]。每个网格的分辨率大小sss为0.5m0.5\\mathrm{m}0.5m。自车位于BEV的(70, 150)处。
基线。为消除任务头影响并公平比较其他BEV生成方法,我们使用VPN[30]和Lift-Splat[32]替换BEVFormer,并保持任务头和其他设置相同。我们还通过将时间自注意力调整为不使用历史BEV特征的普通自注意力,将BEVFormer改编为静态模型,称为BEVFormer-S。
4.3 3D目标检测结果
我们仅使用检测头在检测任务上训练模型,以便与先前最先进3D目标检测方法公平比较。在表1和表2中,我们报告在nuScenes测试集和验证集上的主要结果。在公平训练策略和可比模型规模下,我们的方法在验证集上比先前最佳方法DETR3D[47]高超过9.2个点(51.7%51.7\\%51.7% NDS对42.5%42.5\\%42.5% NDS)。在测试集上,我们的模型在没有额外技巧的情况下取得56.9%56.9\\%56.9% NDS,比DETR3D(47.9%47.9\\%47.9% NDS)高9.0个点。我们的方法甚至可以达到与一些基于LiDAR的基线相当的性能,例如SSN(56.9%56.9\\%56.9% NDS)[55]和PointPainting(58.1%58.1\\%58.1% NDS)[43]。
先前的基于相机的方法[47, 31, 45]几乎无法估计速度,而我们的方法表明时间信息在多相机检测的速度估计中起关键作用。BEVFormer在测试集上的平均速度误差(mAVE)为0.3780.3780.378 m/s,大幅优于其他基于相机的方法,并接近基于LiDAR方法[43]的性能。
我们还在Waymo上进行实验,如表3所示。遵循[34],我们以IoU标准0.7和0.5评估车辆类别。此外,由于基于IoU的指标对基于相机的方法过于困难,我们还采用nuScenes指标评估结果。由于很少有基于相机的工作在Waymo上报告结果,我们也使用DETR3D官方代码在Waymo上进行实验以比较。我们可以观察到,在IoU标准0.5下,BEVFormer在LEVEL_1和LEVEL_2难度上分别以包含朝向信息的平均精度(APH)[40]优于DETR3D 6.0%6.0\\%6.0%和2.5%2.5\\%2.5%。在nuScenes指标上,BEVFormer以3.2%3.2\\%3.2% NDS和5.2%5.2\\%5.2% AP的优势优于DETR3D。我们还在前相机上与CaDNN[34]比较,CaDNN是一种在Waymo数据集上报告结果的单目3D检测方法。在IoU标准0.5下,BEVFormer在LEVEL_1和LEVEL_2难度上分别以APH 13.3%13.3\\%13.3%和11.2%11.2\\%11.2%优于CaDNN。
4.4 多任务感知结果
我们同时使用检测头和分割头训练模型,以验证模型对多任务的学习能力,结果如表4所示。在相同设置下比较不同BEV编码器时,BEVFormer在除道路分割外的所有任务上取得更高性能,道路分割结果与BEVFormer-S相当。例如,在联合训练下,BEVFormer在检测任务上比Lift-Splat*[32]高11.0个点(52.0%52.0\\%52.0% NDS对41.0%41.0\\%41.0% NDS),在车道分割IoU上高5.6个点(23.9%23.9\\%23.9%对18.3%18.3\\%18.3%)。与单独训练任务相比,多任务学习通过共享更多模块(包括主干和BEV编码器)节省计算成本并减少推理时间。在本文中,我们表明BEV编码器生成的BEV特征可以很好地适应不同任务,并且使用多任务头训练的模型在检测任务和车辆分割上表现更好。然而,联合训练的模型在道路和车道分割上不如单独训练的模型,这是多任务学习中称为负迁移[11, 13]的常见现象。
4.5 消融研究
为深入探究不同模块的效果,我们在nuScenes验证集上使用检测头进行消融实验。更多消融研究见附录。
空间交叉注意力的有效性。为验证空间交叉注意力的效果,我们使用BEVFormer-S进行消融实验以排除时间信息干扰,结果如表5所示。默认空间交叉注意力基于可变形注意力。为比较,我们还构建了两种不同注意力机制的基线:(1)使用全局注意力替换可变形注意力;(2)使每个查询仅与其参考点交互而不是周围局部区域,这类似于先前方法[36, 37]。为更广泛比较,我们还用VPN[30]和Lift-Splat[32]提出的BEV生成方法替换BEVFormer。我们可以观察到,在可比模型规模下,可变形注意力显著优于其他注意力机制。全局注意力消耗过多GPU内存,点交互感受野有限。稀疏注意力取得更好性能,因为它与先验确定的感兴趣区域交互,平衡了感受野和GPU消耗。
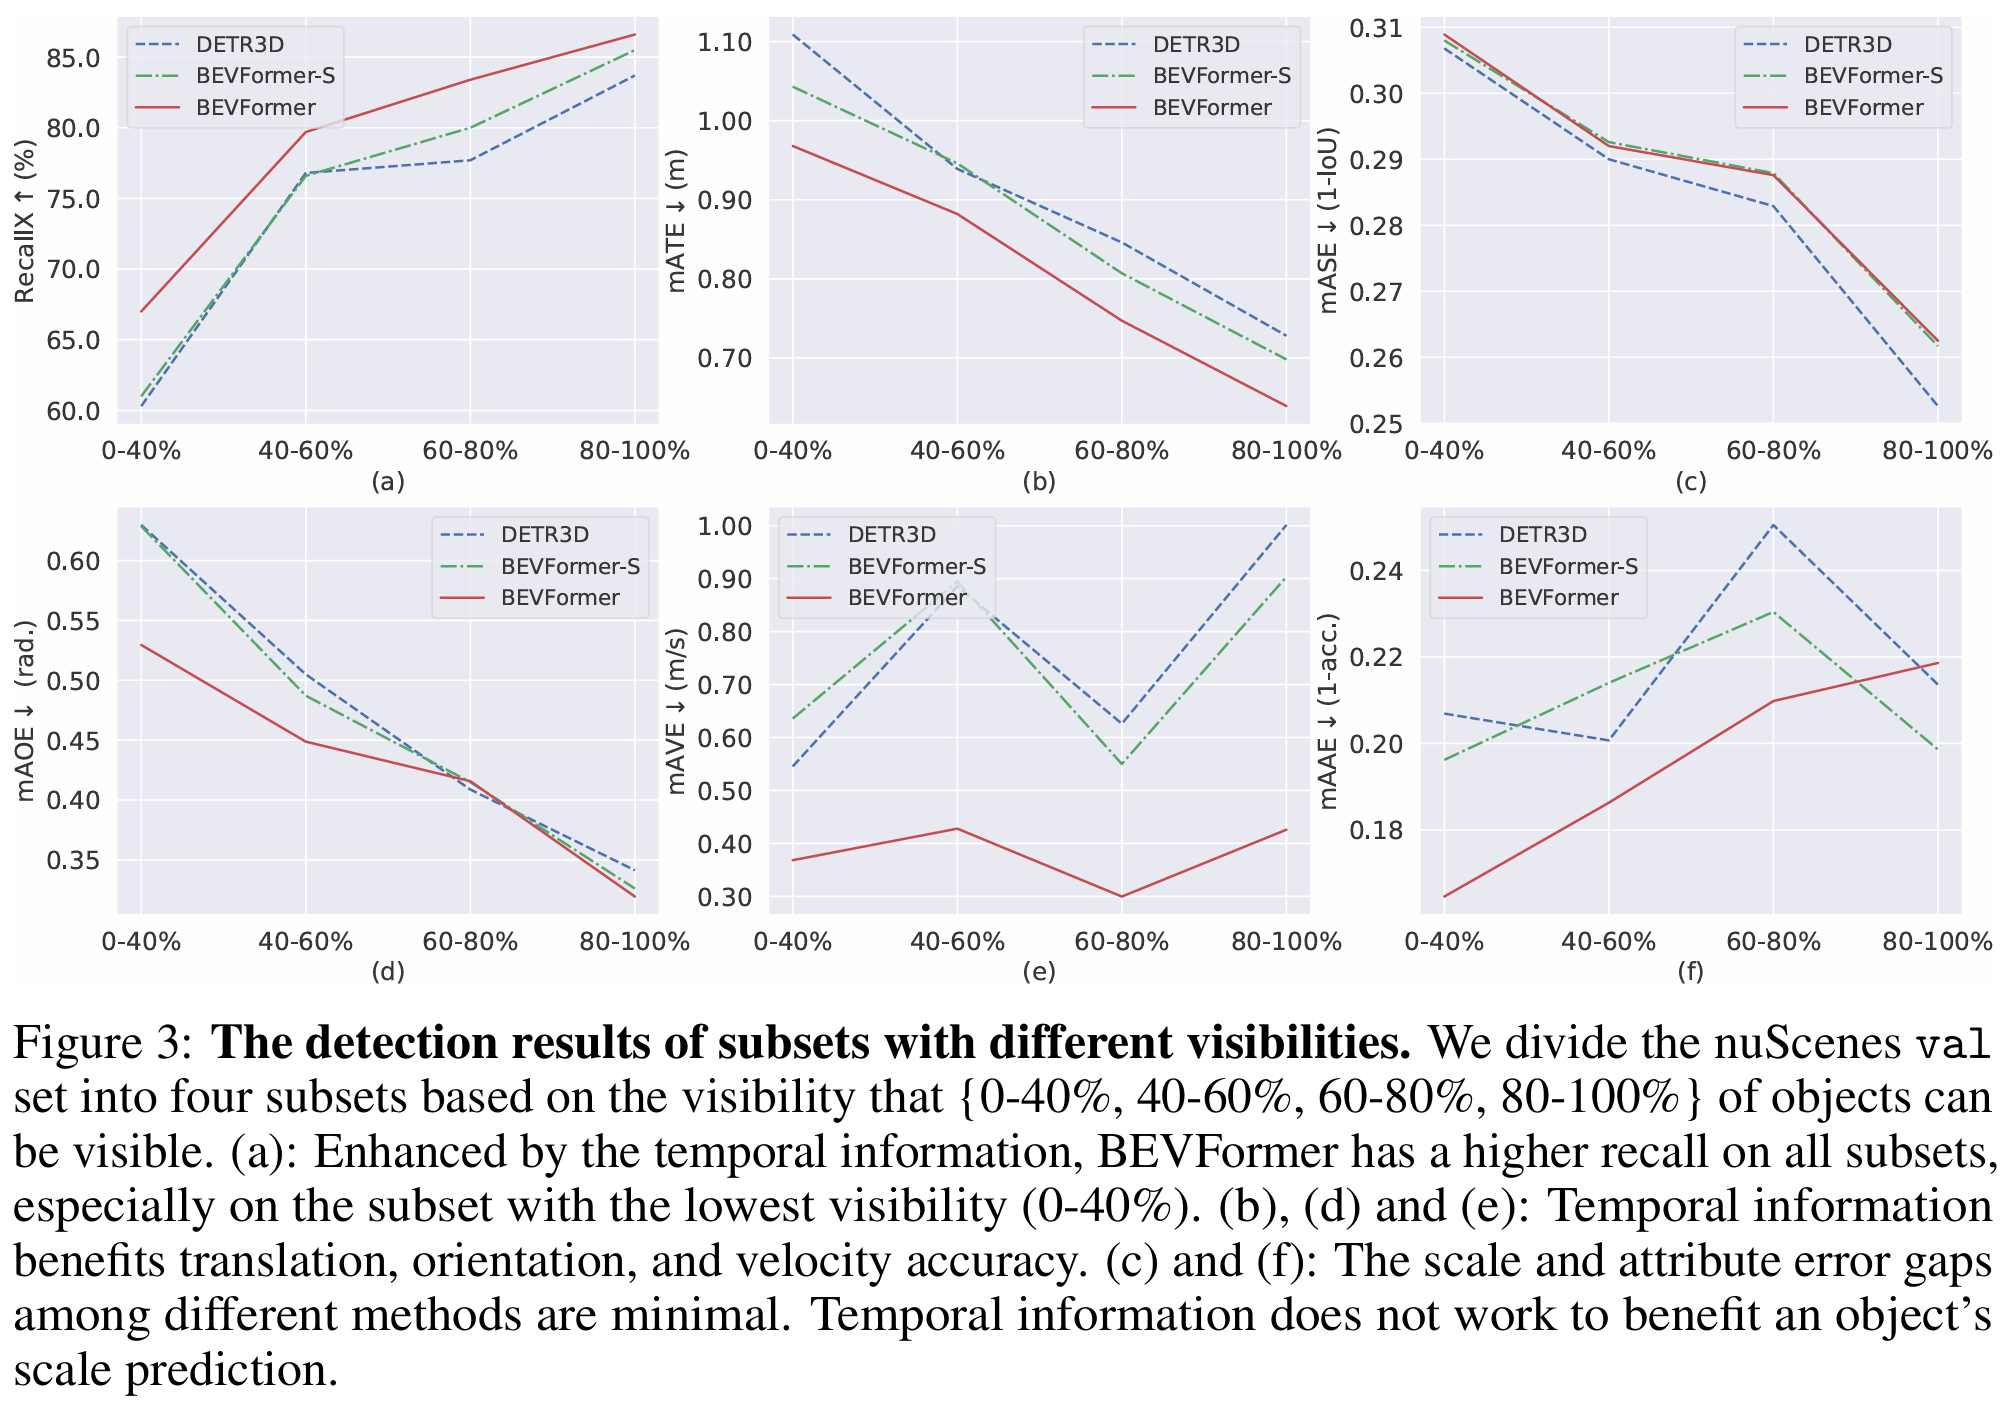
时间自注意力的有效性。从表1和表4可以观察到,在相同设置下,BEVFormer显著优于BEVFormer-S,尤其是在具有挑战性的检测任务上。时间信息的效果主要体现在以下方面:(1)引入时间信息极大有利于速度估计准确性;(2)借助时间信息,目标的预测位置和方向更准确;(3)由于时间信息包含过去目标线索,我们在严重遮挡目标上获得更高召回率,如图3所示。为评估BEVFormer在不同遮挡程度目标上的性能,我们根据nuScenes提供的官方可见性标签将验证集分为四个子集。在每个子集中,我们还计算匹配时中心距离阈值为2米的所有类别的平均召回率。所有方法的最大预测框数为300,以公平比较召回率。在仅0−40%0 – 40\\%0−40%目标可见的子集上,BEVFormer的平均召回率以超过6.0%6.0\\%6.0%的优势优于BEVFormer-S和DETR3D。
模型规模与延迟。我们在表6中比较不同配置的性能和延迟。我们从三个方面消融BEVFormer规模,包括是否使用多尺度视图特征、BEV查询形状和层数,以验证性能与推理延迟之间的权衡。我们可以观察到,使用一个编码器层的配置C取得50.1%50.1\\%50.1% NDS,并将BEVFormer延迟从原始130ms降低到25ms。配置D使用单尺度视图特征、更小BEV尺寸且仅1个编码器层,推理时仅消耗7ms,尽管与默认配置相比损失3.9个点。然而,由于多视图图像输入,限制效率的瓶颈在于主干,面向自动驾驶的高效主干值得深入研究。总体而言,我们的架构可以适应各种模型规模,并灵活权衡性能与效率。
4.6 可视化结果
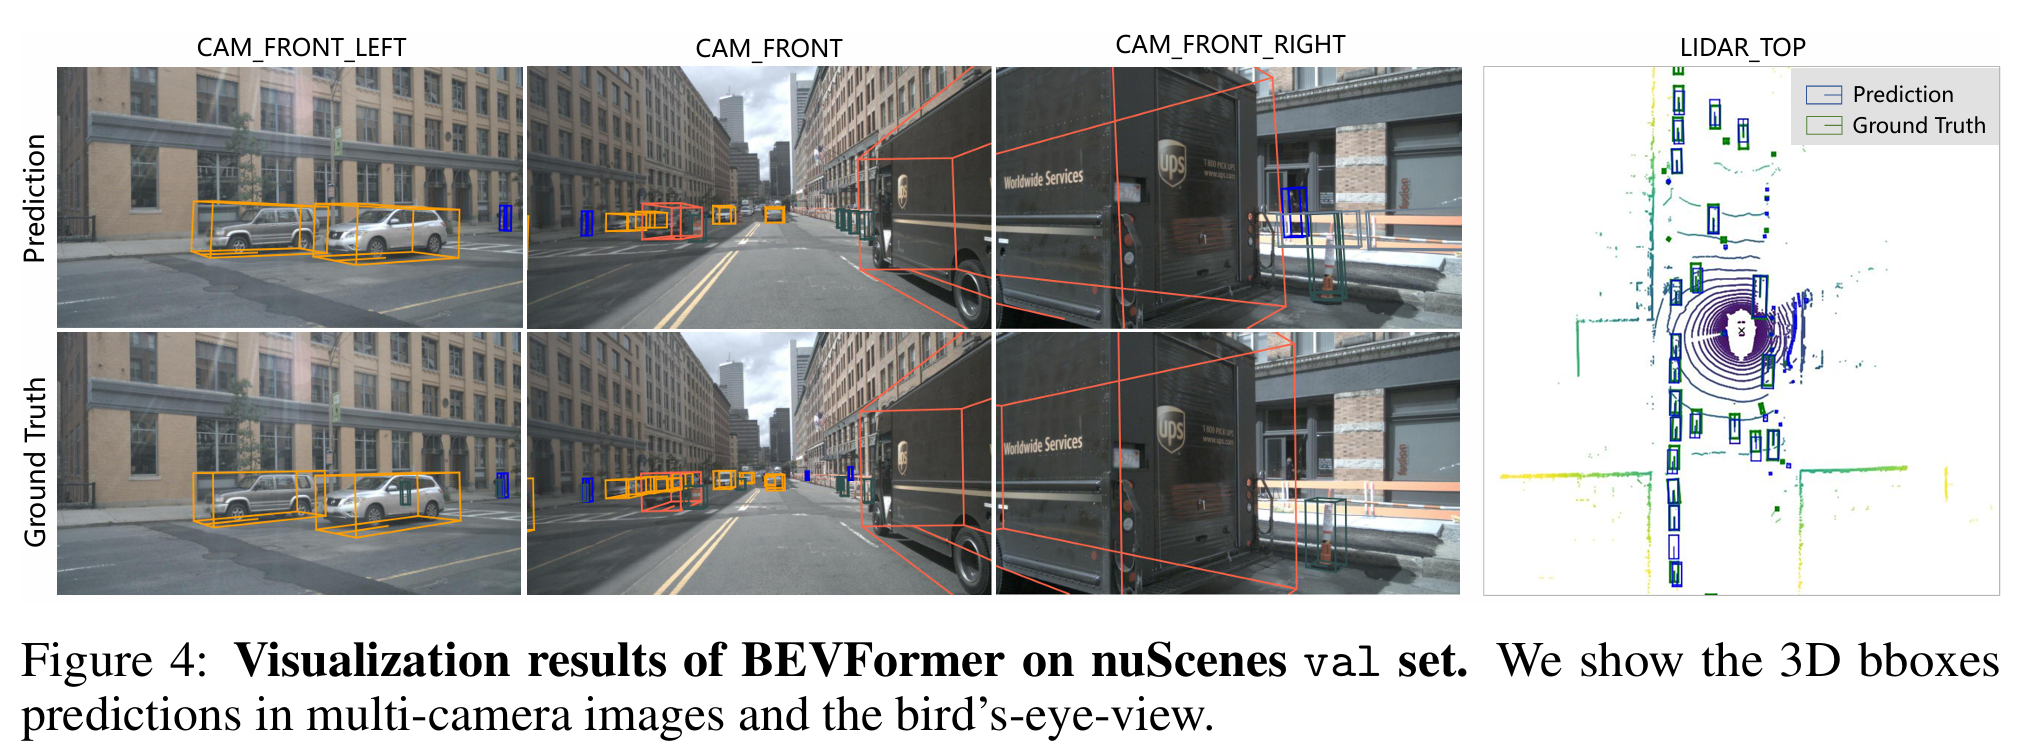
我们在图4中展示复杂场景的检测结果。除少数小而远的目标错误外,BEVFormer产生了令人印象深刻的结果。更多定性结果见附录。
5 讨论与结论
在这项工作中,我们提出BEVFormer,从多相机输入生成鸟瞰图特征。BEVFormer可以高效聚合空间和时间信息,并生成强大的BEV特征,同时支持3D检测和地图分割任务。
局限性。目前,基于相机的方法在效果和效率上仍与基于LiDAR的方法存在一定差距。从2D信息准确推断3D位置仍然是基于相机方法的长期挑战。
广泛影响。BEVFormer表明,利用多相机输入的时空信息可以显著提高视觉感知模型的性能。BEVFormer展示的优势,例如更准确的速度估计和对低可见度目标的更高召回率,对于构建更好、更安全的自动驾驶系统及更多应用至关重要。我们相信BEVFormer只是后续更强大视觉感知方法的基线,基于视觉的感知系统仍有巨大潜力有待探索。
附录
A 实现细节
在本节中,我们提供所提出方法和实验的更多实现细节。
A.1 训练策略
遵循先前方法[47, 56],我们以24个epoch、每GPU批大小1(包含6个视图图像)、学习率2×10−42 \\times 10^{- 4}2×10⁻⁴训练所有模型,主干学习率乘数为0.1,并使用余弦退火[24]衰减学习率。我们采用AdamW[25],权重衰减为1×10⁻²¹ \\times 10^{- 2}1×10⁻²优化模型。
A.2 VPN和Lift-Splat
我们在本工作中使用VPN[30]和Lift-Splat[32]作为两个基线。为公平比较,主干和任务头与BEVFormer相同。
VPN。我们采用官方代码。受MLP参数量巨大的限制,VPN难以生成高分辨率BEV(例如200×200200 \\times 200200×200)。为与VPN比较,在本工作中,我们通过两个视图转换层将单尺度视图特征转换为低分辨率50×5050 \\times 5050×50的BEV。
Lift-Splat。为在可比参数数量下与BEVFormer公平比较,我们用两个额外卷积层增强Lift-Splat的相机编码器。其他设置保持不变。
A.3 任务头
检测头。我们为每个3D边界框预测10个参数,包括每个框尺度的3个参数(l,w,h)(l,w,h)(l,w,h)、中心位置的3个参数(xo,yo,zo)(x_{o},y_{o},z_{o})(xo,yo,zo)、目标朝向θ\\thetaθ的2个参数(cos(θ),sin(θ))(\\cos (\\theta),\\sin (\\theta))(cos(θ),sin(θ))、速度的2个参数(vx,vy)(v_{x},v_{y})(vx,vy)。训练阶段仅使用L1L_{1}L1损失和L1L_{1}L1代价。遵循[47],我们使用900个目标查询,并在推理时保留300个最高置信度预测框。
分割头。如图5所示,对于语义地图的每个类别,我们遵循[22]中的掩码解码器,使用一个可学习查询表示该类别,并基于普通多头注意力的注意力图生成最终分割掩码。
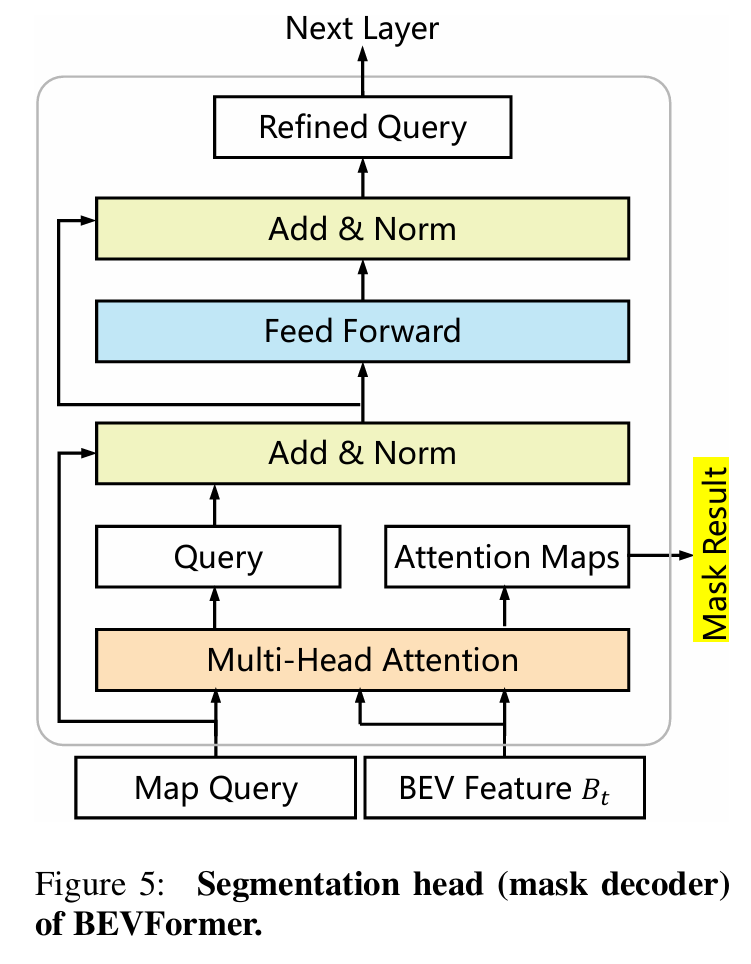
图5:BEVFormer的分割头(掩码解码器)。
A.4 空间交叉注意力
全局注意力。除可变形注意力[56]外,我们的空间交叉注意力也可以通过全局注意力(即普通多头注意力)[42]实现。采用全局注意力最直接的方式是使每个BEV查询与所有多相机特征交互,这种概念实现不需要相机标定。然而,这种直接方式的计算成本无法承受。因此,我们仍利用相机内外参决定一个BEV查询应交互的命中视图。该策略使一个BEV查询通常只与一个或两个视图交互而不是所有视图,从而使在空间交叉注意力中使用全局注意力成为可能。值得注意的是,与其他依赖精确相机内外参的注意力机制相比,全局注意力对相机标定更鲁棒。
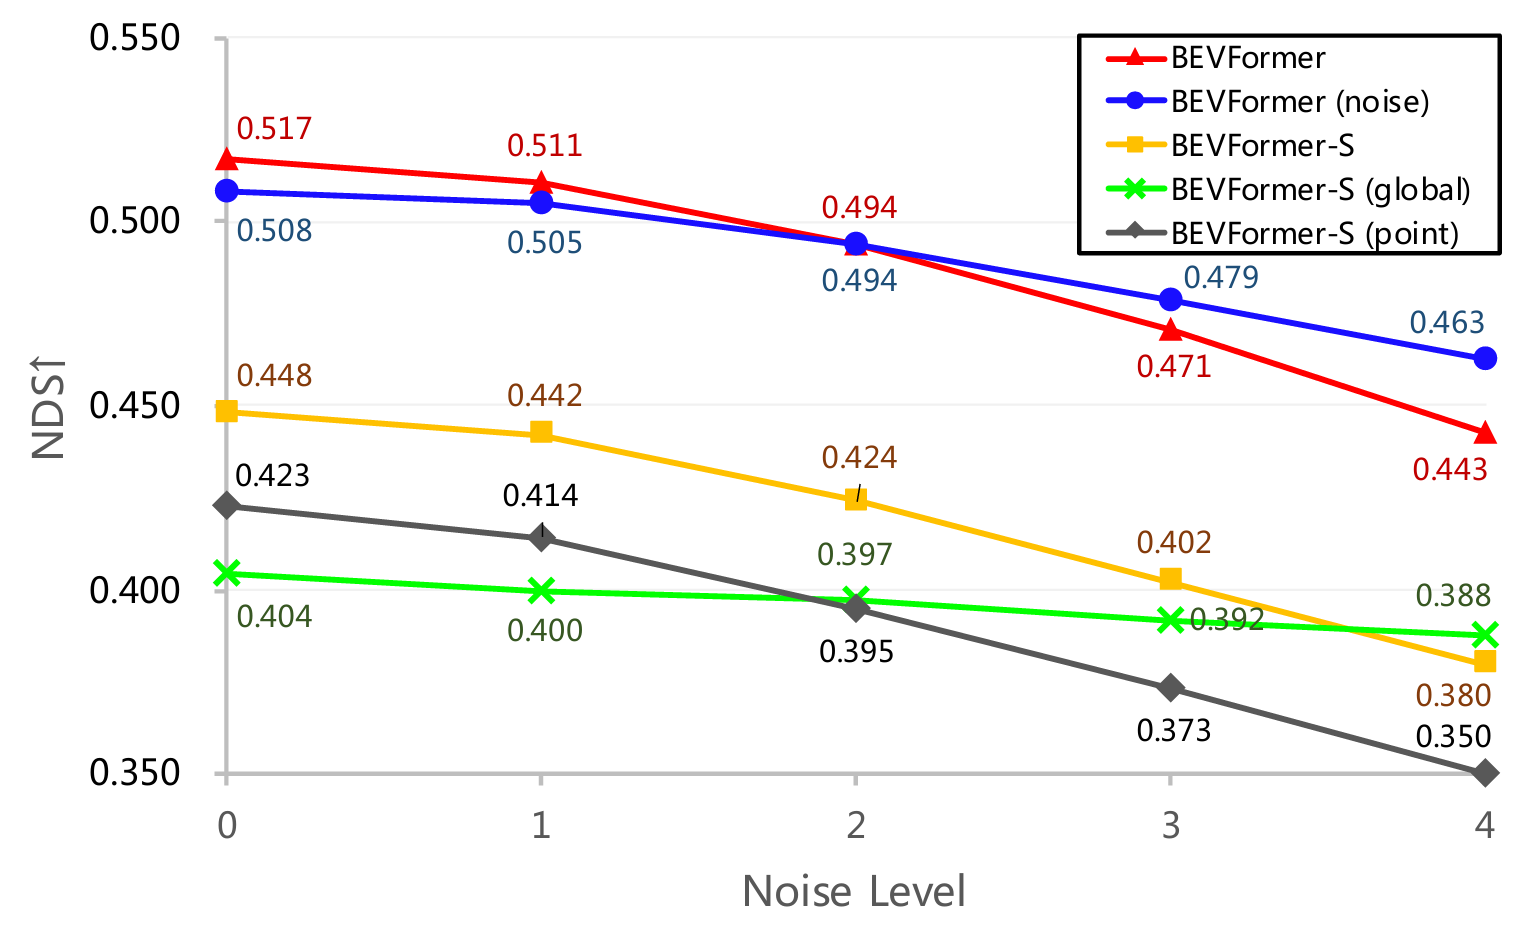
图6:nuScenes验证集上方法在不同程度相机外参噪声下的NDS。对于第iii级噪声,旋转噪声从均值为0、方差为iii的正态分布采样(旋转噪声单位为度,每个轴噪声独立),平移噪声从均值为0、方差为5i5i5i的正态分布采样(平移噪声单位为厘米,每个方向噪声独立)。“BEVFormer”是我们的默认版本。“BEVFormer (noise)”使用噪声外参训练(噪声级=1)。“BEVFormer-S”是BEVFormer的静态版本,其空间交叉注意力由可变形注意力[56]实现。“BEVFormer-S (global)”是BEVFormer-S,其空间交叉注意力由全局注意力(即普通多头注意力)[42]实现。“BEVFormer-S (point)”是BEVFormer-S,其空间交叉注意力为点空间交叉注意力,我们通过移除预测偏移和权重,将可变形注意力的交互目标从局部区域退化为仅参考点。
B 相机外参鲁棒性
BEVFormer依赖相机内参和外参获得2D视图上的参考点。在自动驾驶系统部署阶段,外参可能因标定误差、相机偏移等多种原因产生偏差。如图6所示,我们展示模型在不同相机外参噪声水平下的结果。与BEVFormer-S (point)相比,BEVFormer-S利用基于可变形注意力[56]的空间交叉注意力,在参考点周围采样特征而不是仅与参考点交互。借助可变形注意力,BEVFormer-S的鲁棒性强于BEVFormer-S (point)。例如,噪声水平为4时,BEVFormer-S的NDS下降15.2%15.2\\%15.2%(由1−0.3800.4481 – \\frac{0.380}{0.448}1−0.4480.380计算),而BEVFormer-S (point)的NDS下降17.3%17.3\\%17.3%。与BEVFormer-S相比,BEVFormer仅下降14.3%14.3\\%14.3% NDS,这表明时间信息也可以提高对相机外参的鲁棒性。遵循[32],我们表明当使用噪声外参训练BEVFormer时,BEVFormer (noise)具有更强鲁棒性(仅下降8.9%8.9\\%8.9% NDS)。使用基于全局注意力的空间交叉注意力时,BEVFormer (global)具有很强抗干扰能力(即使在外参噪声第4级下也仅下降4.0%4.0\\%4.0% NDS)。原因是我们没有利用相机外参为BEV查询选择RoI。
值得注意的是,在最严酷噪声下,我们看到BEVFormer-S (global)甚至优于BEVFormer-S(38.8%38.8\\%38.8% NDS对38.0%38.0\\%38.0% NDS)。
C 消融研究
训练期间帧数的影响。表7展示训练期间帧数的影响。我们看到nuScenes验证集上的NDS随帧数增长持续上升,并在帧数≥4\\geq 4≥4时开始趋于平稳。因此,我们在实验中默认将训练期间帧数设为4。
表7:训练期间使用不同帧数时模型在nuScenes验证集上的NDS。“#Frame”表示训练期间帧数。
| 1 | 0.448 | 0.375 | 0.802 |
| 2 | 0.490 | 0.388 | 0.467 |
| 3 | 0.510 | 0.410 | 0.423 |
| 4 | 0.517 | 0.416 | 0.394 |
| 5 | 0.517 | 0.412 | 0.387 |
表8:nuScenes验证集上的消融实验。“A.”表示用自车运动对齐历史BEV特征。“R.”表示从5个连续帧中随机采样4帧。“B.”表示同时使用BEV查询和历史BEV特征预测偏移和权重。
| 1 | × | ✓ | ✓ | 0.510 | 0.410 |
| 2 | ✓ | × | ✓ | 0.513 | 0.410 |
| 3 | ✓ | ✓ | × | 0.513 | 0.404 |
| 4 | ✓ | ✓ | ✓ | 0.517 | 0.416 |
一些设计的效果。表8展示若干消融研究结果。比较#1和#4,我们看到用自车运动对齐历史BEV特征对于表示与当前BEV查询相同的几何场景很重要(51.0%51.0\\%51.0% NDS对51.7%51.7\\%51.7% NDS)。比较#2和#4,从5帧中随机采样4帧是一种有效的数据增强策略,可提高性能(51.3%51.3\\%51.3% NDS对51.7%51.7\\%51.7% NDS)。与在时间自注意力模块中仅使用BEV查询预测偏移和权重(见#3)相比,同时使用BEV查询和历史BEV特征(见#4)包含更多关于过去BEV特征的线索,有利于位置预测(51.3%51.3\\%51.3% NDS对51.7%51.7\\%51.7% NDS)。
D 可视化
如图7所示,我们比较BEVFormer与BEVFormer-S。借助时间信息,BEVFormer成功检测到两辆被板子遮挡的公交车。我们还在图8中展示目标检测和地图分割结果,可以看到检测结果和分割结果高度一致。我们在图9中提供更多地地图分割结果,可以看到借助BEVFormer生成的强BEV特征,通过简单掩码解码器可以很好地预测语义地图。
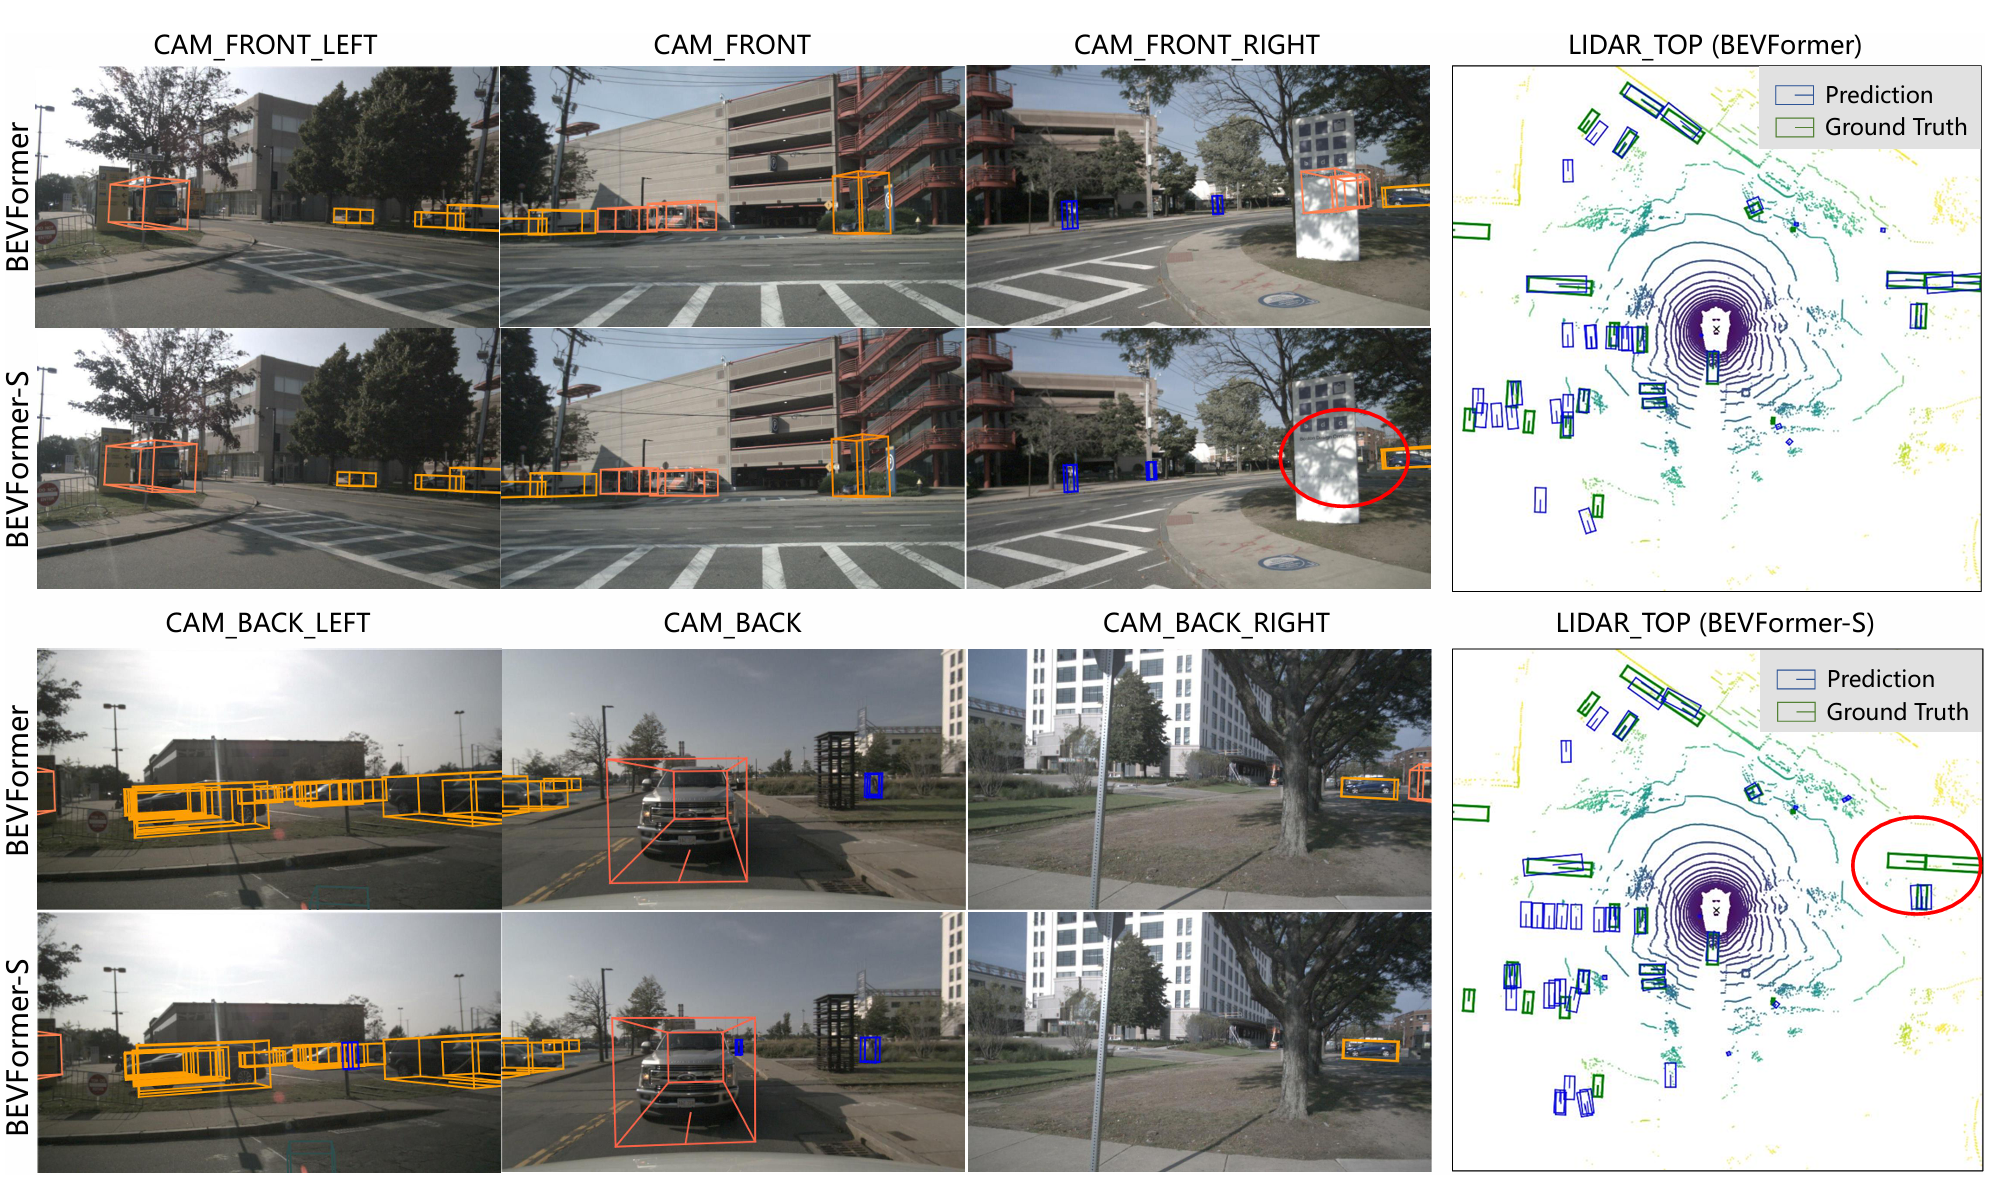
图7:BEVFormer与BEVFormer-S在nuScenes验证集上的比较。我们可以观察到BEVFormer可以检测高度遮挡目标,而这些目标在BEVFormer-S的预测结果中漏检(红圈中)。
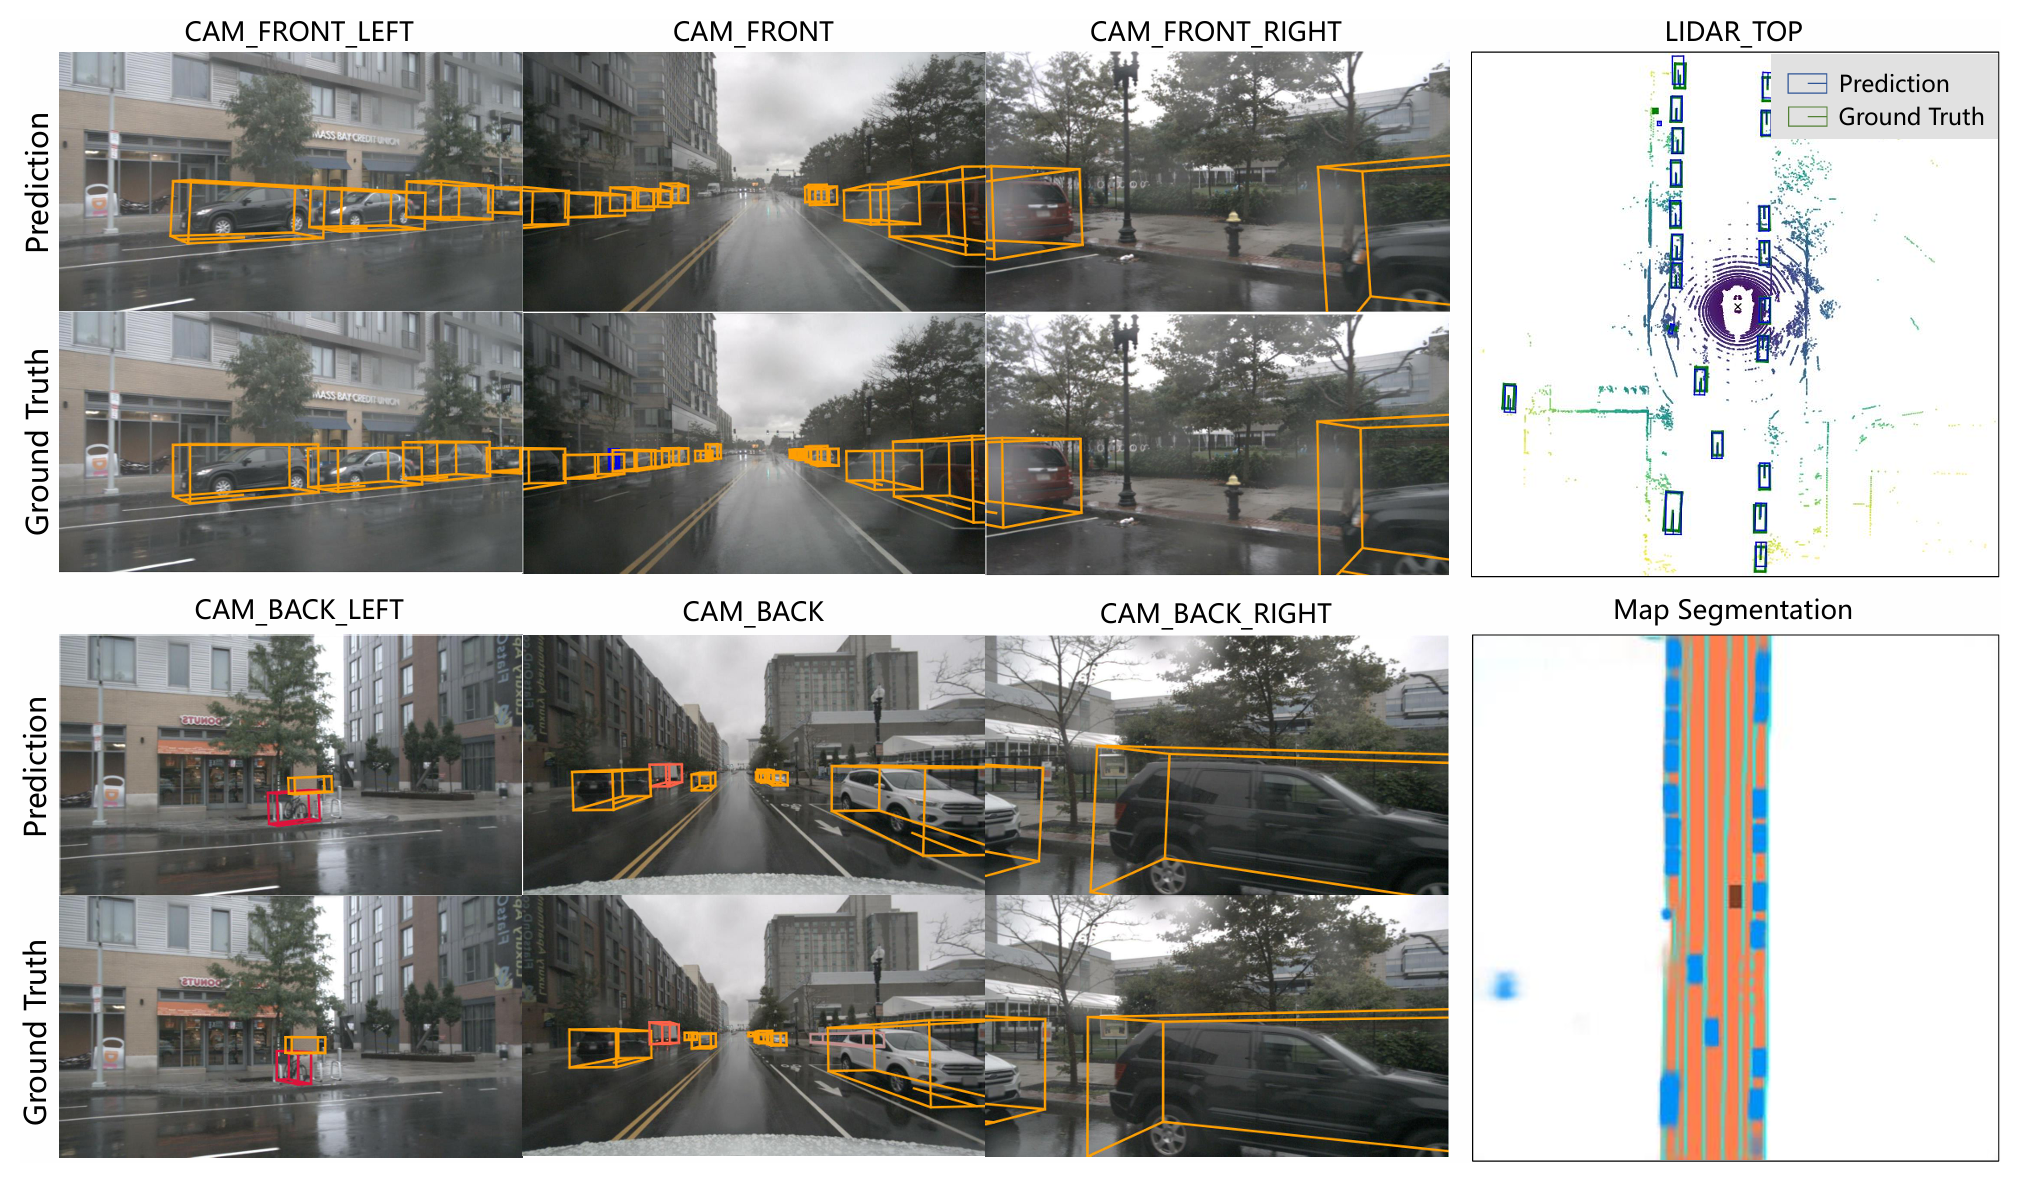
图8:目标检测和地图分割任务的可视化结果。我们分别用蓝色、橙色和绿色展示车辆、道路和车道分割。
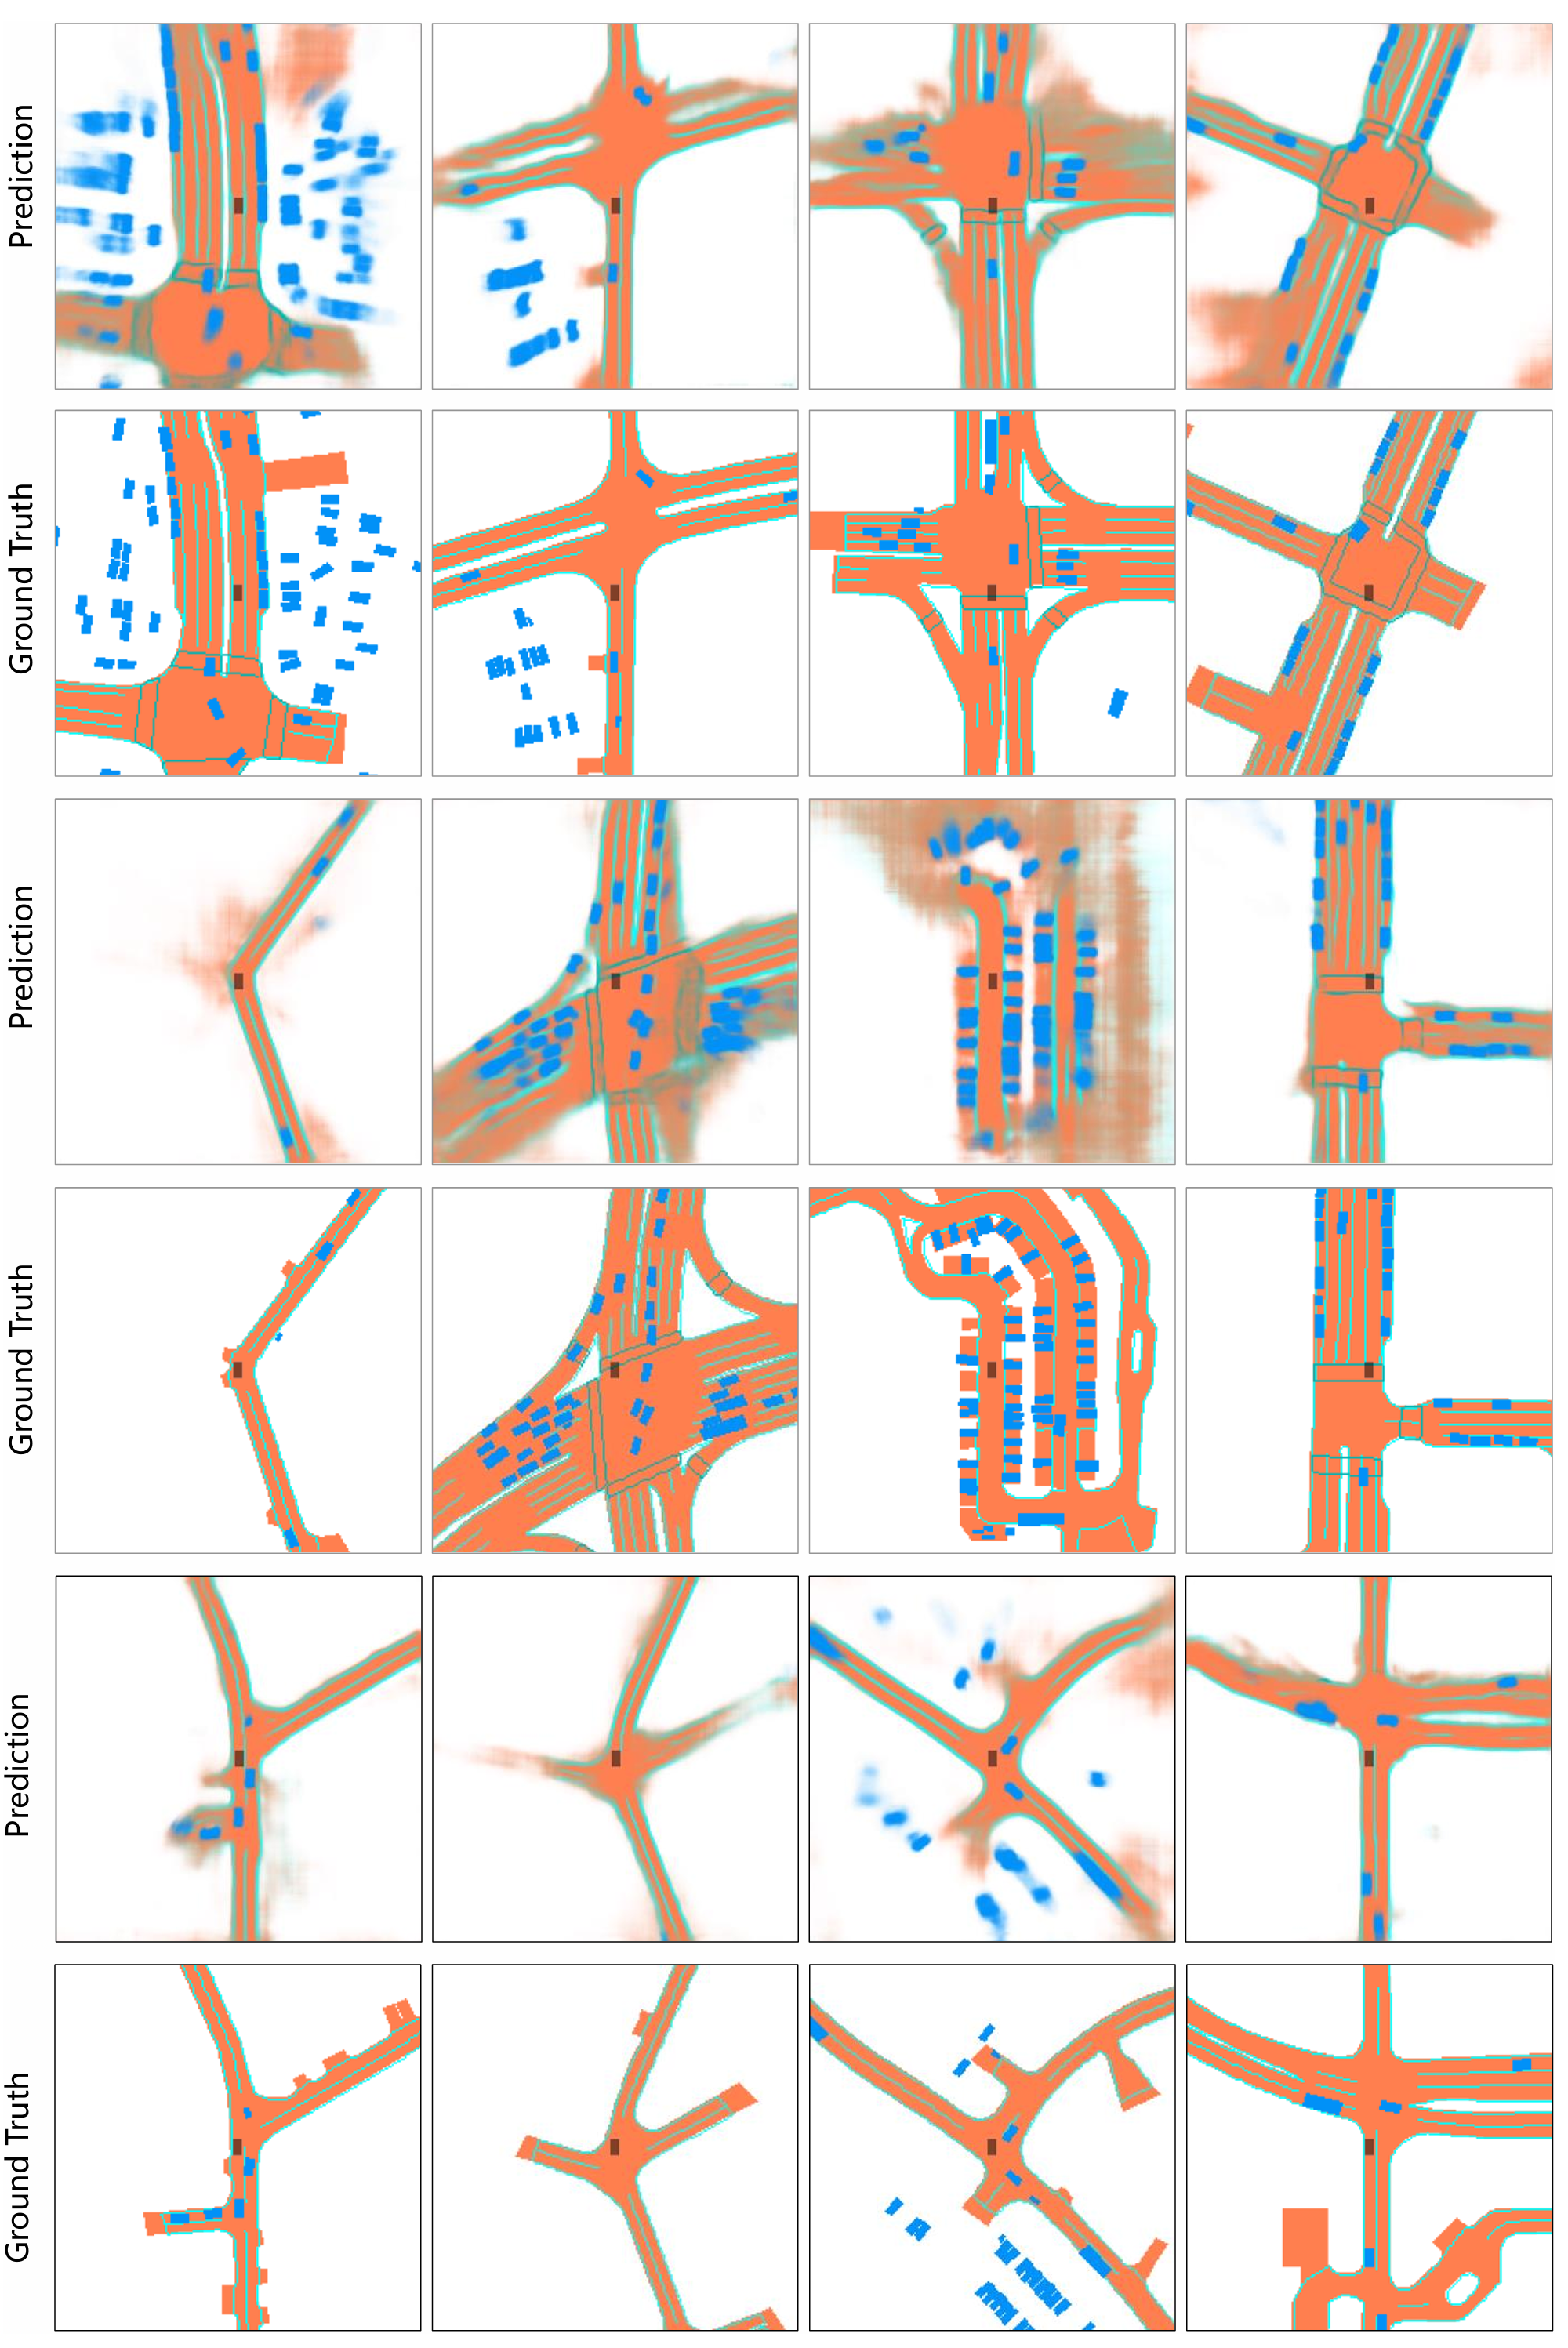
图9:地图分割任务的可视化结果。我们分别用蓝色、橙色、青色和绿色展示车辆、道路、人行横道和车道分割。
以上为全文中文翻译;参考文献条目按学术惯例保留原文。