因果压缩:从 gzip 到 Transformer KV Cache 到记忆的统一视角
一句话结论:压缩 因果链在螺旋展开中,将已确定的低虚部分支折叠回生成元,用更短的编码替代冗余展开。gzip 的 LZ...
一句话结论:压缩 因果链在螺旋展开中,将已确定的低虚部分支折叠回生成元,用更短的编码替代冗余展开。gzip 的 LZ...
Transformer 骨架精讲:Self-Attention 公式、参数量,为什么要除以 √d 【大模型面试通关手册 · 第 02 篇】 本篇覆盖:self-...
/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */#content_views .toc,/* 编辑器常在...
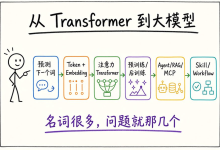
对于本文呢,我不但想把 Transformer 的原理从头到尾讲清楚,还想带你看看今天大家知道的大模型,究竟是怎么在 ...
文章目录 模块出处 模块介绍 模块提出的动机(Motivation) 适用范围与模块效果 模块代码及使用方式 模块出处 Paper:Anchor-SAM: Ac...
《量化论文精读》|深度学习统计套利:如何从股票残差中寻找交易机会? 系列:量化论文精读 · 第 3 篇...
摘要: 7月31日同一天,MiniMax和字节跳动各自发布了新一代视频模型H3和Seedance 2.5。加上2月的Kling 3....
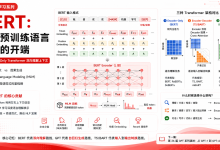
文章目录一、BERT 出现前的问题二、BERT 是 Encoder-Only Transformer三、BERT 输入格式:[CLS]、[SEP]...
一、一个让无数开发者破防的悖论 最近 Transformer 与 Masked Attention 再次冲上热榜。很多前端同学跟我一样:论文里的...
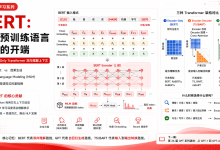
文章目录一、BERT 出现前的问题二、BERT 是 Encoder-Only Transformer三、BERT 输入格式:[CLS]、[SEP]...
 admin