/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
时序数据库怎么选:从大数据架构到 Apache IoTDB 实战,一套不只看跑分的方法
本文面向正在搭建工业互联网、物联网或设备数据平台的架构师与开发者。所有产品判断都应以自己的业务数据完成 PoC;文中不使用无法复现的“百万级”“十倍提升”等营销数字。
很多团队做时序数据库选型,第一步就是收集厂商参数:每秒写入多少点、压缩比多少、单次查询几毫秒。表格很快就能填满,结论却未必可靠。原因并不复杂:设备数量、测点密度、采样周期、乱序比例、查询跨度、副本数以及硬件配置只要变一个,结果就可能完全不同。真正值得问的不是“谁的峰值最高”,而是“谁能在我们的数据形态、查询习惯和运维边界下,连续三年保持稳定且可控的成本”。
本文给出一套可落地的方法,并用 Apache IoTDB 做一次小型实战。Apache IoTDB 的开源安装包可从官方下载页获取;需要企业级产品、服务与解决方案时,可访问企业版官网。 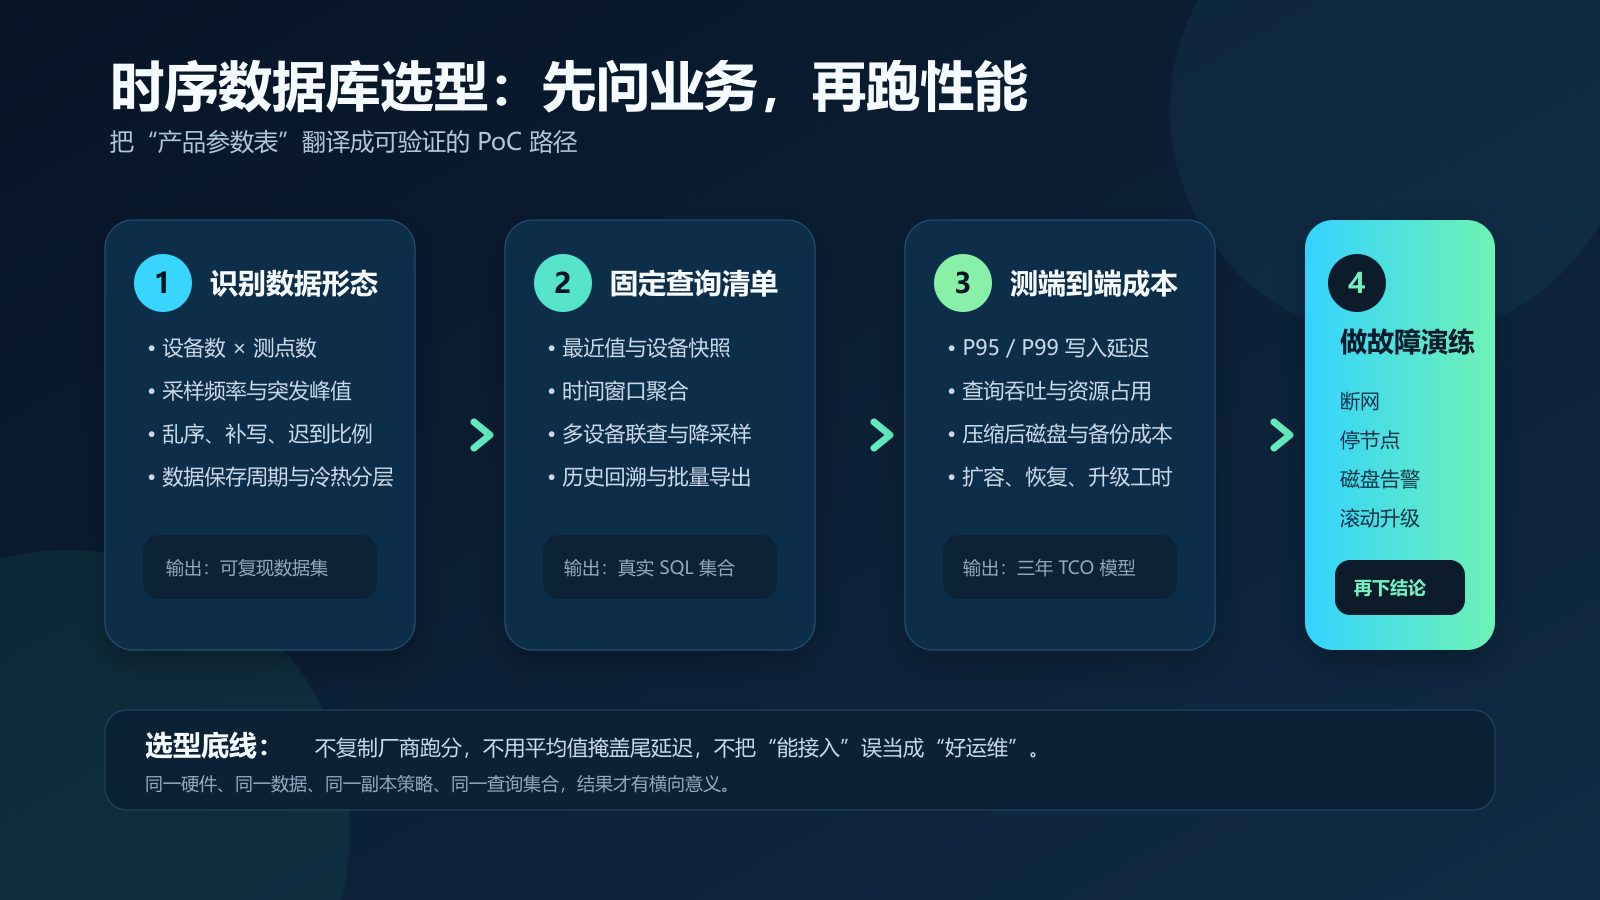
图 1:原创选型流程图。先固定业务和测试口径,再讨论产品。
一、先把问题说清楚:你存的不是“时间戳加数值”
时序数据看起来结构简单,落到业务里却至少有四个变量。
第一是数据规模,而且不能只看每天新增多少行。假设有 10 万台设备,每台 200 个测点,每秒采一次,与 2000 台设备、每台 1 万个测点,虽然总点数接近,但元数据组织、并发连接和查询模式并不相同。第二是写入秩序。工业现场会遇到网关断连、数据补传、时钟漂移,乱序写入和成批回灌必须进入测试集。第三是查询形态。大屏常查最近值,运维人员会拉取单设备曲线,算法团队则可能跨设备扫描数月历史数据。第四是数据生命周期:原始秒级数据保存多久,降采样结果保存多久,过期数据是否自动清理,这些问题最终都会反映到存储和运维成本上。
因此,选型文档至少要先写出五个数字:设备数、测点数、平均与峰值写入速率、乱序比例、典型查询时间跨度。少了任何一个,所谓性能结论都容易变成“在别人的场景里很快”。
二、从大数据视角看,时序数据库应当站在哪一层
时序数据库不是整个数据平台的替代品。它更适合作为设备数据的在线底座:上游接收传感器、边缘网关和采集系统的数据,下游为实时监控、告警、可视化和分析任务提供统一访问。复杂的离线加工仍可以交给 Spark 等计算引擎,业务主数据也可以继续放在原有关系型系统里。
IoTDB 的特点是把设备语义、时间序列存储和分布式能力放在同一套系统中。官方文档显示,其 2.x 同时提供树模型和表模型;分布式架构中,ConfigNode 负责节点、配置、权限、Schema 与分区等集群信息,DataNode 承担数据存储和查询执行。对于大数据团队,更有价值的一点是生态衔接:官方提供 Spark 表模型连接器,可以通过 DataFrame 或 Spark SQL 读写 IoTDB,并支持部分过滤、列裁剪、offset 和 limit 下推,减少无效数据传输。相关细节可参考 IoTDB 产品介绍与 Spark 连接器文档。
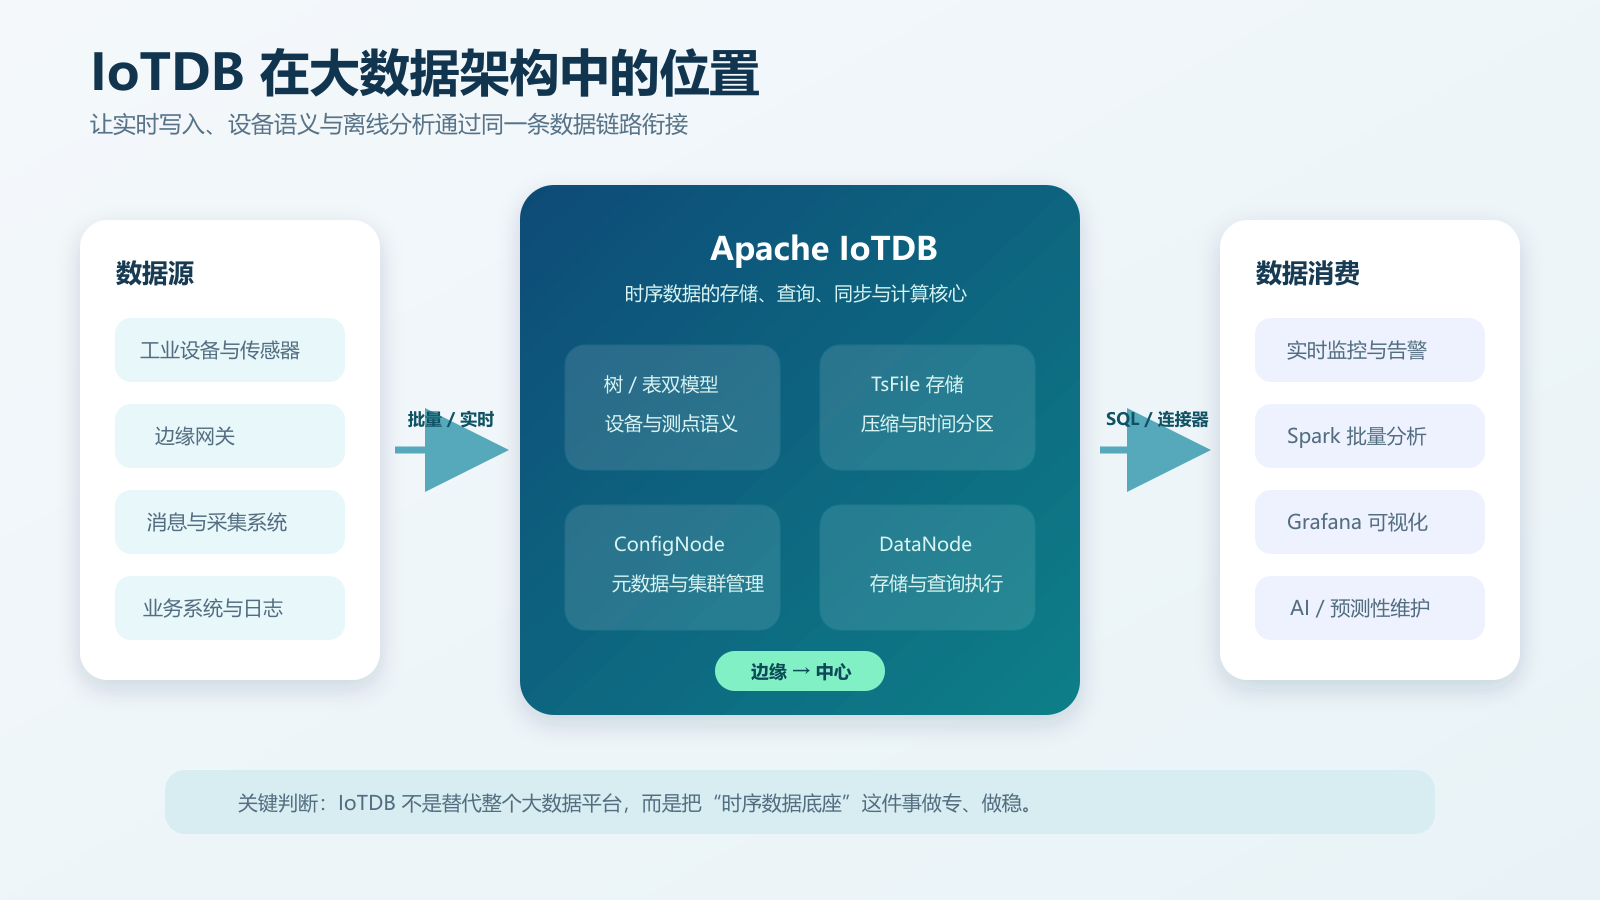
图 2:原创架构图。IoTDB 负责时序数据底座,实时应用与离线分析各取所需。
三、与国外常见路线相比,差异不只在 SQL 语法
如果把候选产品放在同一张表里,更建议比较“技术路线与团队匹配度”,而不是把功能列表打勾。
| 核心组织方式 | 面向设备与测点,提供树、表两种模型 | measurement、tag、field,3.x 基于 Arrow/DataFusion 并采用 Parquet 持久化路线 | 建立在 PostgreSQL 之上,以 hypertable 按时间自动分区 |
| 更自然的场景 | 工业设备层级、海量测点、边缘到中心的数据链路 | 监控、事件与云化时序负载,团队接受对象存储架构 | 已深度使用 PostgreSQL,希望保留关系型生态与复杂关联 |
| 选型时重点验证 | 路径或表模型设计、乱序补写、集群扩缩与同步 | 对象存储一致性、冷热查询边界、版本间迁移成本 | 索引和 chunk 规划、关系查询与时序写入之间的资源竞争 |
| 团队学习曲线 | SQL 较易上手,但设备建模要先做好 | 需理解不同代际产品和部署形态 | PostgreSQL 团队上手快,但仍需掌握 hypertable 生命周期 |
这个对比没有“绝对赢家”。InfluxDB 3 官方文档强调 Arrow、DataFusion、对象存储和 SQL/InfluxQL;TimescaleDB 官方则强调其 PostgreSQL 基础以及 hypertable、chunk 的自动时间分区。选择 IoTDB 的充分理由,不应只是“开源”或“写得快”,而应是业务本身具有明显的设备层级与测点语义,并且希望从边缘采集、中心存储到大数据分析保持较短的数据链路。反过来,如果团队的主要资产是大量 PostgreSQL 存储过程和关系查询,迁移成本也必须如实计入总成本。
四、代码实战:用一张设备表跑通写入与降采样
下面用电机监测做一个最小可运行示例。为了便于复现,示例采用 IoTDB 2.x 表模型。正式部署前请在下载页确认服务端版本,并让客户端与服务端保持兼容。若用 Docker 做本地 PoC,可按官方镜像说明固定版本和容器地址;以下以 Docker Hub 当前可见的 2.0.10-standalone 标签为例:
docker pull apache/iotdb:2.0.10-standalone
docker network create –driver=bridge –subnet=172.18.0.0/16 –gateway=172.18.0.1 iotdb
docker run -d –name iotdb-service \\
–hostname iotdb-service –network iotdb –ip 172.18.0.6 \\
-p 6667:6667 \\
-e cn_internal_address=iotdb-service \\
-e cn_seed_config_node=iotdb-service:10710 \\
-e cn_internal_port=10710 -e cn_consensus_port=10720 \\
-e dn_rpc_address=iotdb-service -e dn_internal_address=iotdb-service \\
-e dn_seed_config_node=iotdb-service:10710 \\
-e dn_mpp_data_exchange_port=10740 \\
-e dn_schema_region_consensus_port=10750 \\
-e dn_data_region_consensus_port=10760 -e dn_rpc_port=6667 \\
apache/iotdb:2.0.10-standalone
docker exec -it iotdb-service \\
/iotdb/sbin/start-cli.sh -sql_dialect table -h iotdb-service
进入 CLI 后,创建数据库和设备表。这里把工厂、产线和设备编号设为 TAG,把电机型号设为 ATTRIBUTE,把持续变化的温度、振动和电流设为 FIELD。这样的分类比把所有列一视同仁更贴近查询习惯。
CREATE DATABASE IF NOT EXISTS factory;
USE factory;
CREATE TABLE motor_metrics (
time TIMESTAMP TIME,
factory STRING TAG,
line STRING TAG,
device_id STRING TAG,
model STRING ATTRIBUTE,
temperature DOUBLE FIELD,
vibration DOUBLE FIELD,
current_amp DOUBLE FIELD,
running BOOLEAN FIELD
) WITH (TTL=31536000000);
INSERT INTO motor_metrics
(time, factory, line, device_id, model,
temperature, vibration, current_amp, running)
VALUES
('2026-09-18 09:00:00', 'shanghai', 'line_1', 'motor_001', 'M-200', 67.2, 2.10, 18.3, true),
('2026-09-18 09:01:00', 'shanghai', 'line_1', 'motor_001', 'M-200', 68.5, 2.35, 18.7, true),
('2026-09-18 09:02:00', 'shanghai', 'line_1', 'motor_001', 'M-200', 71.8, 3.20, 20.1, true),
('2026-09-18 09:00:00', 'shanghai', 'line_1', 'motor_002', 'M-200', 62.9, 1.85, 17.6, true),
('2026-09-18 09:01:00', 'shanghai', 'line_1', 'motor_002', 'M-200', 63.4, 1.92, 17.8, true);
先看每台设备的最新状态:
SELECT device_id,
LAST(temperature) AS last_temp,
LAST(vibration) AS last_vibration,
LAST_BY(time, temperature) AS last_time
FROM motor_metrics
GROUP BY device_id;
再做 1 分钟窗口降采样,并筛出平均温度高于 70℃ 的窗口:
SELECT date_bin(1m, time) AS minute_time,
device_id,
AVG(temperature) AS avg_temp,
MAX(vibration) AS max_vibration
FROM motor_metrics
WHERE time >= 2026–09–18 09:00:00
AND time < 2026–09–18 10:00:00
GROUP BY date_bin(1m, time), device_id
HAVING AVG(temperature) > 70.0
ORDER BY minute_time, device_id;
这段 SQL 很短,却覆盖了选型中最该关注的三个问题:设备维度是否自然、最近值查询是否直接、时间窗口聚合是否易读。继续做 PoC 时,不要只把五行数据放大成五千万行,还应主动加入 5% 至 20% 的乱序数据、重复时间戳、空值、设备离线后的集中补传,以及跨月历史查询。IoTDB 官方文档也明确提供了 date_bin 时间分桶、LAST、LAST_BY 等表模型能力,可据此构造真实查询集。
如果要模拟客户端批量写入,可以使用 Python 原生接口的 Tablet。官方建议客户端不要高于服务端版本,测试时应把版本号锁进依赖文件,而不是长期使用不固定的最新版。
from iotdb.table_session import TableSession, TableSessionConfig
from iotdb.utils.IoTDBConstants import TSDataType
from iotdb.utils.Tablet import ColumnType, Tablet
config = TableSessionConfig(
node_urls=["127.0.0.1:6667"],
username="root",
password="root",
database="factory",
time_zone="Asia/Shanghai",
)
session = TableSession(config)
columns = ["factory", "line", "device_id", "model",
"temperature", "vibration", "current_amp", "running"]
types = [TSDataType.STRING, TSDataType.STRING, TSDataType.STRING,
TSDataType.STRING, TSDataType.DOUBLE, TSDataType.DOUBLE,
TSDataType.DOUBLE, TSDataType.BOOLEAN]
column_types = [ColumnType.TAG, ColumnType.TAG, ColumnType.TAG,
ColumnType.ATTRIBUTE, ColumnType.FIELD, ColumnType.FIELD,
ColumnType.FIELD, ColumnType.FIELD]
timestamps = [1789693200000, 1789693260000, 1789693320000]
values = [
["shanghai", "line_1", "motor_003", "M-300", 64.1, 1.72, 16.8, True],
["shanghai", "line_1", "motor_003", "M-300", 65.0, 1.81, 17.1, True],
["shanghai", "line_1", "motor_003", "M-300", 66.4, 2.05, 17.5, True],
]
tablet = Tablet("motor_metrics", columns, types, values, timestamps, column_types)
session.insert(tablet)
session.close()
五、PoC 不只测吞吐:建议保留这张验收表
一次靠谱的 PoC,至少跑 72 小时,覆盖稳定写入、峰值写入、历史回灌和混合查询。测试环境要固定硬件、网络、副本数、数据模型与压缩策略,并记录 P50、P95、P99,而不是只写平均延迟。建议按下列维度验收:
六、什么情况下更值得优先验证 IoTDB
如果项目具备以下特征,IoTDB 值得进入 shortlist:设备和测点之间存在清晰层级;写入规模随设备数持续增长;边缘侧资源有限且需要向中心同步;既有实时监控,也有 Spark 等离线分析;团队希望用 SQL 和多语言客户端降低应用接入门槛。尤其是在工业现场,数据并不总是整齐到达,设备身份、测点语义和断点补传通常比“理论峰值”更重要。
但也要看到边界:任何数据库都不能替代糟糕的数据模型。TAG 选择过细、设备标识不稳定、TTL 没有规划、查询不带时间范围,都会把问题推迟到数据量上来以后。集群能力也不等于零运维,副本策略、磁盘水位、备份恢复和升级演练仍然需要制度化。
最终建议很简单:先用一周时间把自己的数据和 SQL 做成固定测试集,再让两到三个候选系统在同一环境里跑。结果不要只看一张吞吐柱状图,而要同时看尾延迟、故障恢复、三年成本和团队掌握难度。若 IoTDB 在这些指标上与业务高度匹配,可以从Apache IoTDB 下载页开始搭建 PoC;对于需要商业支持、企业级功能或方案咨询的团队,可进一步访问企业版官网。
参考资料
- Apache IoTDB 产品介绍
- Apache IoTDB 表模型快速 SQL 体验
- Apache IoTDB Python 原生接口
- Apache IoTDB Spark 连接器
- Apache IoTDB 发布历史
- InfluxDB 3 官方文档
- TimescaleDB Hypertables 官方文档