## 一、項目介绍
摘 要
本研究旨在探索基于深度学习的水下机器人目标识别技术。利用PyTorch框架和YOLOv10算法,系统实现了高效的目标检测功能。用户可以上传图片,应用图像增强技术包括伽马校正、白平衡和水下图像去雾等,以提高识别准确率。系统还支持置信度阈值设置,允许用户根据需求调整检测精度。此外,用户可以查看模型位置,确保透明度和可追溯性。
该系统通过深度学习技术显著提升了水下环境的视觉识别能力,为水下机器人提供了强大的视觉感知工具。图像增强模块有效改善了水下图像的质量,增强了目标特征的可见性。用户友好的界面设计使得操作简便,适用于各种水下探测任务。系统的高效性和准确性为水下机器人的目标识别任务提供了可靠的技术支持,具有广泛的应用前景。
关键词:深度学习;YOLO目标检测算法;水下机器人目标识别技术研究
研究内容
本研究聚焦于基于深度学习的水下机器人目标识别技术,主要依托PyTorch框架和YOLOv10算法构建识别模型。研究内容包括图像处理模块的开发,用户可上传图片,应用多种增强技术包括伽马校正、白平衡及水下图像去雾等,以提升图像质量。此外,系统支持对上传图片进行预测并保存结果,为用户提供便捷的操作体验。
另一核心研究内容为检测设置功能的实现,用户可根据需求设置置信度阈值,以调整目标识别的精度。同时,系统提供模型位置查看功能,增强透明度和可追溯性。通过这些研究内容,旨在提升水下机器人在复杂环境下的目标识别能力,为水下探测、资源开发等领域提供技术支持。
PyTorch框架
PyTorch是一个广泛使用的深度学习框架,主要由Facebook人工智能研究院(FAIR)开发,具备高效的计算图机制和灵活的动态神经网络结构。它的核心优势之一是其动态计算图(Dynamic Computational Graph)特性,允许在模型的训练过程中实时修改计算图。这种灵活性使得PyTorch在开发时可以更方便地进行调试和原型设计,特别适用于那些需要复杂控制流和动态变化的神经网络。与静态计算图的TensorFlow不同,PyTorch的动态计算图支持即时反馈,使得开发者可以直接通过Python代码与模型进行交互,从而加速了实验和开发的进程。
另外,PyTorch的另一个显著特点是其与Python生态系统的紧密集成,尤其是在Numpy、SciPy等科学计算库的兼容性方面,使得数据处理和模型开发变得更加流畅。PyTorch也拥有强大的GPU加速能力,支持CUDA并行计算,显著提升了大规模数据处理和深度学习训练的效率。此外,PyTorch还拥有丰富的预训练模型和工具库,如TorchVision、TorchText等,为图像处理、自然语言处理等领域的应用提供了很大的便利。这些特性使得PyTorch成为学术研究和工业应用中的热门选择,并且随着社区的发展和支持,越来越多的开发者和研究人员选择它作为主要的深度学习框架。
OpenCV
OpenCV(Open Source Computer Vision Library)是一个开源的计算机视觉和机器学习库,旨在为实时图像处理和计算机视觉任务提供强大的功能。自1999年由英特尔推出以来,OpenCV已成为全球广泛使用的计算机视觉工具之一,支持Windows、Linux、macOS以及Android和iOS等多个平台。它提供了丰富的图像处理函数,包括图像读取、显示、变换、特征提取、对象跟踪、边缘检测、图像分割等多种功能,支持多种常见的图像文件格式。OpenCV还集成了强大的机器学习模块,能够进行分类、回归、聚类等任务,使得开发者能够在计算机视觉任务中实现复杂的算法和数据分析。
OpenCV的优势在于其跨平台性、开源性和广泛的应用范围。作为一个高效的图像处理库,OpenCV广泛应用于工业检测、安防监控、医学影像分析、自动驾驶、机器人视觉等领域。它还支持GPU加速,能够大幅提升图像处理速度,尤其在处理大规模图像数据时表现尤为突出。与其他计算机视觉库相比,OpenCV具有丰富的文档和教程,社区活跃,更新频繁,方便开发者快速入门并实现高效的图像处理任务。除此之外,OpenCV的与深度学习框架的集成(如TensorFlow和PyTorch)进一步增强了它在人工智能和机器学习领域的应用能力,使得开发者可以更加灵活地构建复杂的视觉识别和智能化应用。
系统概述
本系统是一套基于深度学习的水下机器人目标识别技术解决方案,利用PyTorch框架和YOLOv10算法构建高效的目标检测模型。系统支持用户上传图片,并提供了多种图像增强技术,包括伽马校正、白平衡和水下图像去雾等,以改善水下环境的图像质量。用户可以对上传的图片应用增强技术,进行预测,并保存结果,从而实现水下目标的精准识别。
系统还具备灵活的检测设置功能,用户可以根据具体需求设置置信度阈值,以调整目标识别的精度。此外,系统提供模型位置查看功能,确保用户对模型使用的透明度和可追溯性。通过这些功能,系统旨在为水下机器人提供强大的视觉感知能力,支持其在复杂水下环境中的高效作业,广泛应用于水下探测、资源开发等领域。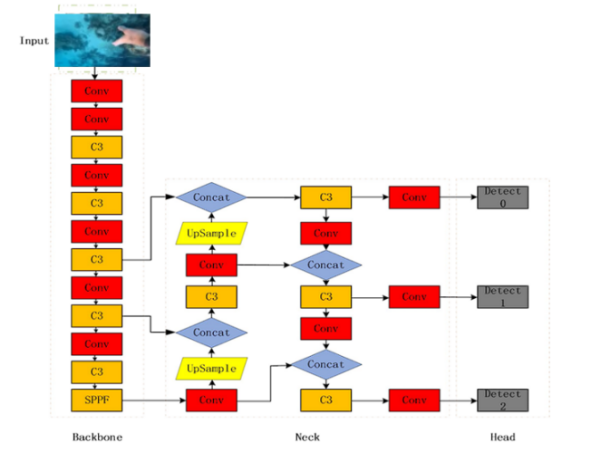
二、文档介绍



三、项目设计与实现
数据预处理设计
数据预处理是本研究的关键步骤,旨在提高水下图像数据的质量和一致性。首先,对原始图像数据进行格式统一和尺寸调整,确保输入数据的规范性。随后,应用图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以增强图像的对比度和清晰度,突出目标特征。这些预处理步骤对于提高模型训练效率和识别准确率至关重要。
在数据增强过程中,系统还支持用户上传自定义图片,并应用相同的增强技术进行处理。增强后的图像数据被用于训练和测试YOLOv10模型,以确保模型能够在不同水下环境中保持高识别性能。通过这些数据预处理步骤,系统有效地提升了水下机器人目标识别的准确性和鲁棒性,为实际应用奠定了坚实基础。

模型训练设计
模型训练设计是本研究的核心环节,基于PyTorch框架和YOLOv10算法构建高效的目标检测模型。首先,利用预处理和增强后的水下图像数据集进行模型训练。训练过程中,采用批量处理和随机梯度下降(SGD)优化算法,逐步调整模型参数,以最小化损失函数。通过多次迭代,模型逐渐学习到水下目标的关键特征,并提高识别准确率。
在训练过程中,系统还支持用户设置置信度阈值,以调整识别结果的精度。此外,系统提供模型位置查看功能,方便用户了解模型的部署情况。通过这些设计,系统不仅提高了水下机器人目标识别的准确性,还增强了用户体验,为水下探测和作业提供了有力的技术支持。
模型调用设计
本系统模型调用设计紧密围绕用户操作流程,确保用户能够便捷地完成从图片处理到目标识别的全过程。首先,用户通过上传图片接口将待处理的图像上传至系统。系统接收到图像后,会根据用户选择的图像增强选项,对图像进行预处理。这些图像增强操作旨在改善图像质量,提高后续目标识别的准确性。预处理完成后,系统将增强后的图像输入到基于YOLOv10算法的深度学习模型中进行目标检测。YOLOv10模型在PyTorch框架下运行,能够快速、准确地识别图像中的目标,并输出检测结果的坐标和置信度信息。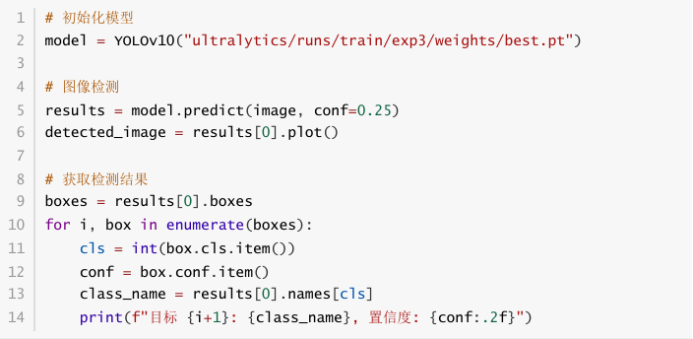 为了方便用户管理和使用模型,系统还设计了检测设置模块。在该模块中,用户可以根据实际需求调整置信度阈值,以控制检测结果的精确度。此外,系统还提供了模型位置信息查看功能,使用户能够了解模型的具体部署位置。这些设计不仅增强了系统的灵活性,还提高了用户对模型运行过程的透明度。在模型调用过程中,系统会实时显示检测进度和结果,用户可以直观地查看识别结果,并将其保存到本地。通过这种设计,系统实现了从图像上传、增强、检测到结果保存的全流程自动化,为用户提供了高效、便捷的水下目标识别服务。
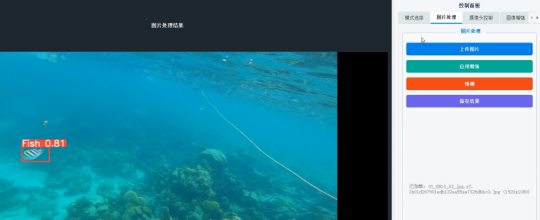
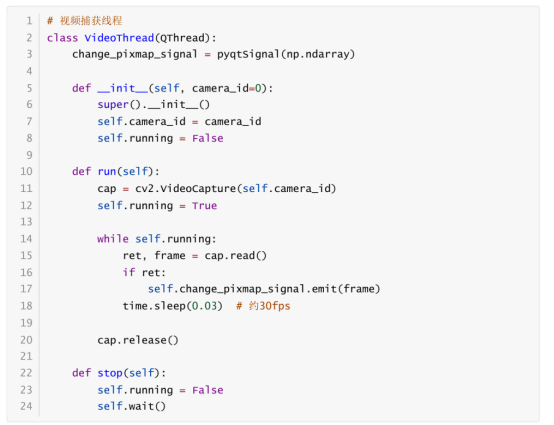
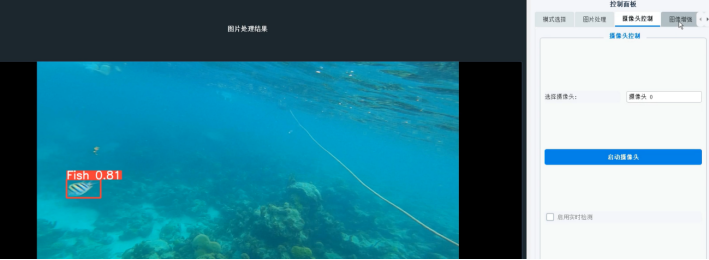
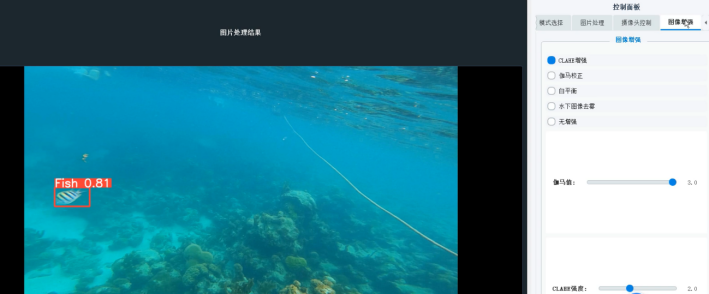
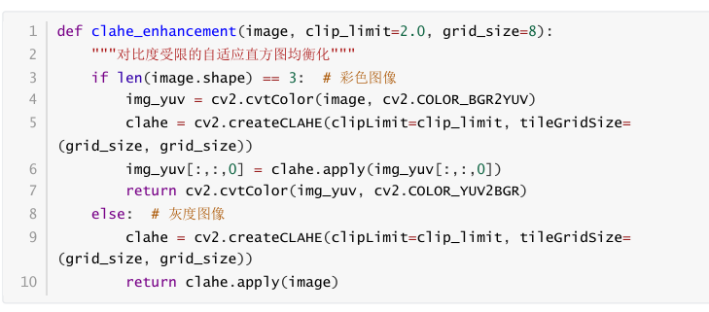
本系统基于深度学习、PyTorch框架和YOLOv10目标检测算法,旨在实现高效、准确的水下机器人目标识别。系统提供了全面的图片处理功能,包括上传图片、应用增强、预测和保存结果,以及多种图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以适应复杂的水下环境并提高目标识别的准确性。检测设置模块允许用户根据实际需求调整置信度阈值,并提供模型位置信息,增强了系统的灵活性和透明度。
在技术实现上,系统充分利用了深度学习的优势,结合PyTorch框架的灵活性和YOLOv10算法的高效性,实现了快速、准确的实时目标检测。通过模型设计与优化,系统针对水下环境进行了专门的调整,提高了模型对水下环境的适应性,并在各项指标上取得了显著提升。此外,系统还考虑了非功能性需求,如性能、可靠性、安全性和易用性,确保了系统的实用性、稳定性和用户体验。
综上所述,本系统在水下机器人目标识别领域具有显著的技术优势和应用价值。通过深度学习、PyTorch和YOLOv10的结合,系统能够高效、准确地识别水下目标,为海洋资源开发、海洋环境监测等领域提供了有力的技术支持。未来,随着技术的不断进步和应用场景的不断拓展,本系统将在水下机器人智能化发展中发挥更大的作用。