前言
在边缘AI的落地过程中,我们经常面临一个尴尬的局面:用高通QIMSDK跑通一个YOLO检测Demo只需要几行代码,但当你要把它变成7×24小时运行、接8路摄像头、还要对接企业云平台的工业级产品时,各种“玄学”问题就会接踵而至:加个queue延迟暴涨200ms、多路并发掉帧、容器化后零拷贝失效、模型升级导致业务崩溃…… 这个系列共四篇文章,我们将从GStreamer底层的一帧数据流转开始,逐层向上“打怪升级”,直至构建出一套高可用、可观测、易运维的边缘智能多媒体微服务架构。
第一篇,我们先从那个让无数人头疼的“多路掉帧与延迟”问题说起,潜入GStreamer底层,看清数据的真实流向。
1. 一个常踩的坑
先说一个几乎每个做多路视频的人都撞过的坑。
手上有一块高通跃龙(Qualcomm Dragonwing)系列的板子,接了 4 路 1080p 摄像头,跑一条标准的 YOLOv8 检测管线。
- 单路跑,一切正常:帧率稳定在 30fps,画面干净。
- 把四路一起接上,结果掉帧了。画面一卡一卡,waylandsink 那头明显追不上采集端。
凭经验,我们可能先在管线里加了几个 queue。掉帧确实好了,画面重新流畅。但端到端延迟从原来的 ~60ms涨到了 ~260ms。监控画面里,人已经走过去两秒了,框才叠上来。对安防、对工业质检来说,这个延迟是不能接受的。
问题摆在了面前:
- 多路并发时,掉帧到底卡在哪一环?
- queue 到底在缓冲什么? 为什么加了它掉帧好了,延迟却涨了200ms?
- 大家都说 QIMSDK 是"零拷贝"的,那零拷贝到底断在了哪一跳?
更让人难受的是,这类问题在应用层几乎没有可观测的抓手。Python / C++ 代码里只有"创建管线、启动、取结果"这么几行,掉帧也好、延迟涨也好,都发生在我们看不见的下面。我们能做的似乎只有"加点 queue 试试"、“把分辨率降一档试试”,全是碰运气。
很明显,要回答这个问题,光看 App Builder 那层的配置是不够的。我们必须知道一帧数据从摄像头出来、到显示器上屏,中间经过了哪些节点、在哪一跳换了内存、在哪一跳切了线程。知道了这些,"加 queue"就从碰运气变成了有依据的决策:会知道该加在哪、queue 的参数该怎么设、以及加了之后那 200ms 延迟是从哪来的、能不能省掉。
这篇文章就从问题出发,把这条管线拆开来看。
2. 先建立坐标系:QIMSDK 和 GStreamer 是什么关系
QIMSDK 2.0是面向高通平台的统一AI与多媒体产品开发框架。 
在拆管线之前,必须先搞清楚一件事:你在 App Builder 里写的那几行配置,和底层真正在跑的东西,不是一回事。
QIMSDK 2.0 的管线架构是从 GStreamer 衍生出来的。高通在 GStreamer 之上做了三件事:
这里有一个非常关键、但官方文档一笔带过的设计点:
App Builder 在编译期不依赖 GStreamer 头文件,但运行时仍然是 GStreamer 插件在跑。
这句话值得咀嚼。它意味着:
- 好处:我们不需要先去啃一遍 GStreamer 的 pad、caps、negotiation、clock 那一套概念,就能装配出一条能跑的 AI 管线。门槛被实实在在地降下来了。写业务的人可以只关心"摄像头→检测→叠加→显示"这个语义层。
- 代价:一旦出现花屏、掉帧、延迟异常,问题几乎必然发生在 GStreamer 运行时那一层——而代码里却看不到 GStreamer 的任何痕迹。这时候我们必须有能力"下潜",用 gst-inspect-1.0、GST_DEBUG、latency tracer 这些 GStreamer 原生工具去看底层到底发生了什么。
用一张图表达分层关系: 编译期不依赖 GStreamer,运行期仍是 GStreamer 在跑 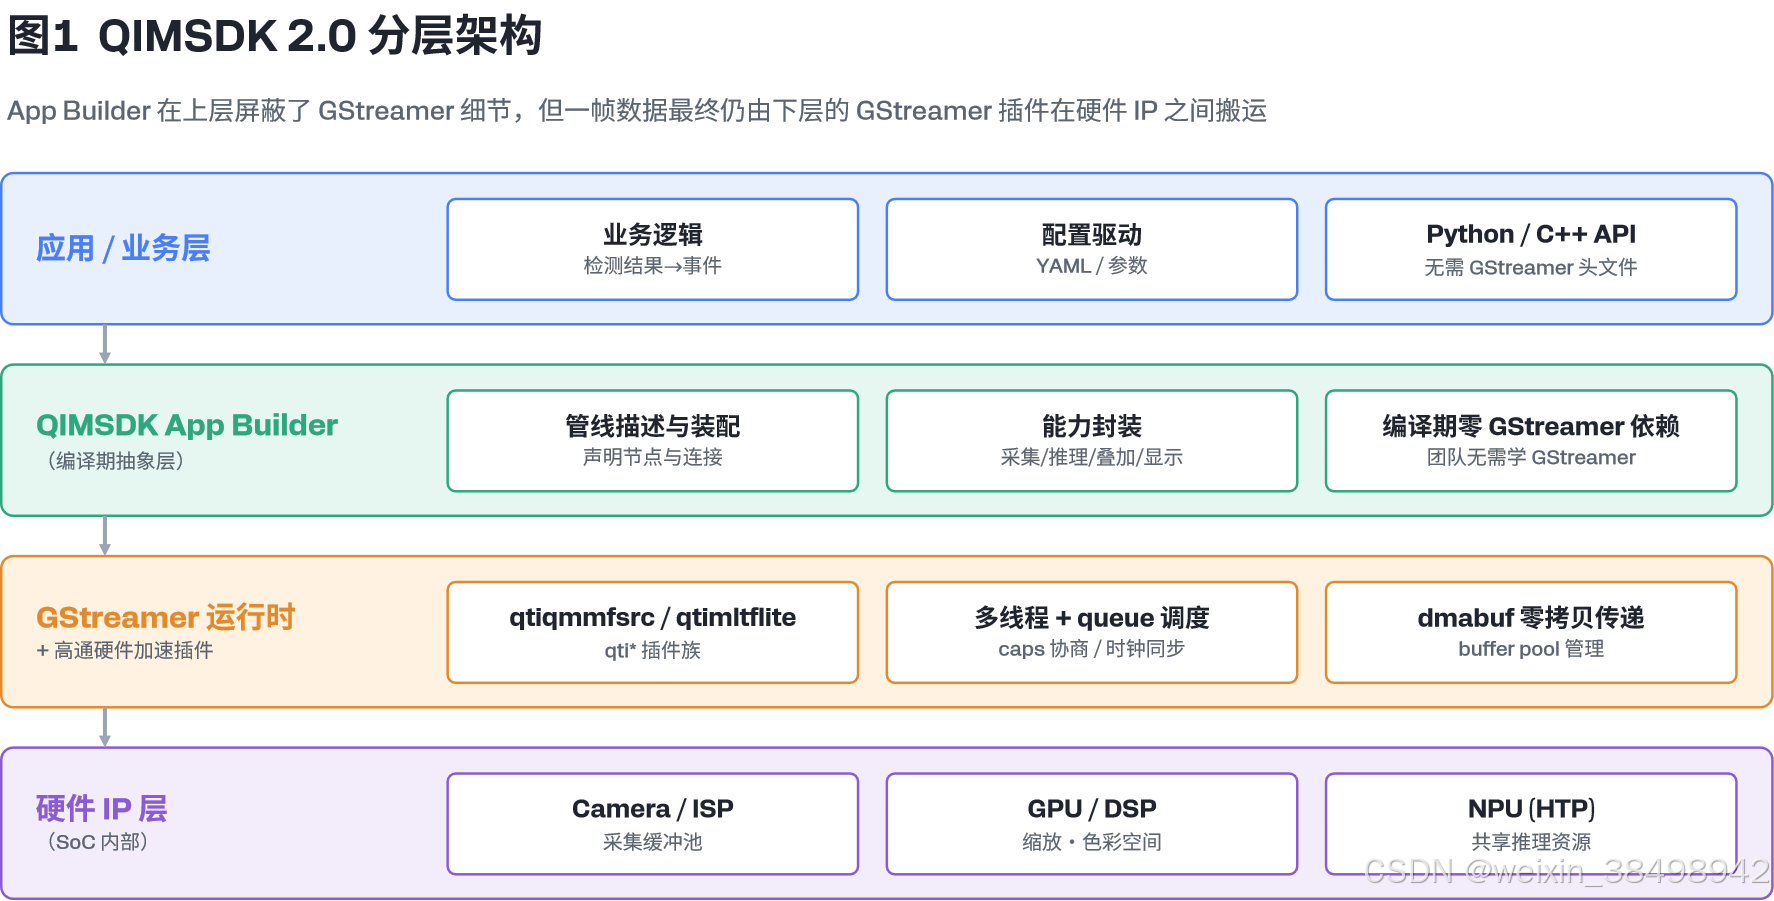
(图1:上三层是能直接操作的抽象,最下层是 SoC 内部的硬件 IP。配置在"App Builder"层,但一帧数据真正的物理流动,发生在"GStreamer 运行时 + 硬件 IP"这下两层。排查问题的本质,就是把视线从上往下移。)
3. 逐跳拆解一条典型 AI 管线
我们以官方 YOLOv8 检测链路为例,这是一条最典型、最有代表性的 AI 管线:
qtiqmmfsrc → tee → queue → qtimlvconverter → qtimltflite
→ qtimlpostprocess → qtimetamux → qtivoverlay → waylandsink
对应的 gst-launch 写法大致是这样(简化版,用于说明结构,实际属性名与路径须以 gst-inspect-1.0 为准 ★):
gst-launch-1.0 -e \\
qtiqmmfsrc camera=0 ! \\
video/x-raw,format=NV12,width=1920,height=1080,framerate=30/1 ! \\
tee name=t \\
t. ! queue ! \\
qtimlvconverter ! \\
qtimltflite model=/opt/models/yolov8.tflite delegate=external ! \\
qtimlpostprocess module=yolov8 ! \\
qtimetamux name=mux \\
t. ! queue ! mux. \\
mux. ! qtivoverlay ! waylandsink
拆解每一跳的时候,通常有三个问题,这三个问题是排查一切管线问题的"体检表":
(a) 输入 / 输出的 caps 是什么?——格式、分辨率、内存类型。 (b) buffer 的所有权在谁手里?这一跳是否发生拷贝 / 格式转换? © 这一跳是同步还是异步?阻塞会传导到哪里?
下面逐节点过一遍。
插一句关于 caps 的基础:caps(capabilities)是 GStreamer 里描述"一个 pad 上流动的数据长什么样"的协商协议。它不只是"格式=NV12"这么简单,还包括分辨率、帧率,以及最容易被忽视的 memory: 类型。数据到底是放在普通系统内存里,还是放在 dmabuf / GBM 这种硬件可直接访问的内存里。两个相邻插件能不能零拷贝对接,本质上就是看它们的 caps 里 memory: 类型能不能对上。对不上,GStreamer 就会"好心"地在中间插一个转换,于是零拷贝就断了,而且这个转换是隐式的,你不开 debug 根本看不见。这就是为什么下面每一跳我都要先问 caps。
3.1 qtiqmmfsrc(采集源)
- (a) caps:输出通常是 video/x-raw 带硬件内存标记(如 memory:GBM / dmabuf),格式 NV12,分辨率和帧率就是你配置的 1080p30。
- (b) 拷贝:不拷贝。这是零拷贝的起点。摄像头 / ISP 把数据写进一个缓冲池(buffer pool)里的 dmabuf,qtiqmmfsrc 往下游传的是这块 buffer 的引用(handle),不是数据本身。
- © 线程:运行在采集线程上。如果下游把 buffer 的引用攥着不放(比如某个节点处理太慢还没释放),采集端的 buffer pool 会被耗尽,直接表现为采集侧掉帧。
3.2 tee(分流)
- (a) caps:透传,输入什么输出什么。
- (b) 拷贝:不拷贝。tee 把同一块 buffer 的引用计数 +1,分发给多个下游分支。注意,它分发的是同一块内存,不是复制了一份。这个语义后面讲多流调度时是关键。
- © 线程:tee 本身不切线程。它的下游分支如果直接处理,会在同一个线程里串行执行,这就是为什么 tee 后面几乎总要跟 queue(下一节详述)。
3.3 queue(缓冲 + 线程边界)
- (a) caps:透传。
- (b) 拷贝:不拷贝 buffer 数据,它只是把 buffer 的引用放进一个队列。
- © 线程:这是关键,queue 是 GStreamer 里切换线程的标准手段。 queue 上游和下游跑在两个不同的线程上。这就回答了开场那个问题的一半:加 queue 之所以能解决掉帧,是因为它解耦了上下游的执行节奏,让慢的一端不至于直接阻塞快的一端;而它之所以让延迟上涨,是因为队列本身在攒数据,队列里排着的每一帧,都是实打实的等待时间。queue 不是魔法,它是用延迟换吞吐。
3.4 qtimlvconverter(预处理转换)
全链路最重要的拷贝点。
- (a) caps:输入是摄像头的 NV12(硬件内存),输出是推理引擎要的 tensor(通常是 RGB / NCHW 布局、float 或量化后的 int8)。
- (b) 拷贝:几乎必然发生拷贝 / 转换。 原因是模型要的输入和摄像头给的格式对不上——需要做 resize(1920×1080 → 比如 640×640)、色彩空间转换(NV12 → RGB)、归一化(像素值 / 255、减均值除方差)、布局重排(HWC → CHW)。这几步里任何一步都要重新写一块内存。所以零拷贝的链条,第一次真正断裂,通常就断在这里。
- © 线程:承接 queue 之后的转换线程。如果这一跳慢(比如 resize 没走硬件、落到了 CPU),它会反压 queue,queue 满了再反压采集端。
★ 怎么验证这一跳到底在哪做的:用 GST_DEBUG=qtimlvconverter:5 gst-launch-1.0 … 看它协商出来的 caps 和内部 log,确认 resize / 色彩转换是走了 GPU/DSP 还是回落到了 CPU。不同平台、不同输入分辨率,这里的行为可能完全不同。
3.5 qtimltflite(推理)
- (a) caps:输入 tensor,输出 tensor(检测头的原始输出,还没解码成框)。
- (b) 拷贝:取决于 delegate。走 NPU(HTP)时,tensor 数据理想情况下常驻在 NPU 可访问的内存里,不额外往 CPU 搬。但如果某些算子不被 NPU 支持、回落到了 CPU,就会在 NPU↔CPU 之间来回拷贝,这是隐形的性能杀手。
- © 线程:推理线程。NPU 是共享资源,这一点在多流场景下至关重要(第 5 节展开)。
3.6 qtimlpostprocess / qtimetamux(后处理 + 元数据合并)
- (a) caps:qtimlpostprocess 把推理输出的 tensor 解码成检测框(boxes / scores / labels),生成 GStreamer 的 meta;qtimetamux 把这个 meta 和原始视频流重新对齐合并。
- (b) 拷贝:基本不拷贝视频数据。它们处理的是元数据(一小撮框坐标和置信度),视频帧本身还是之前那块 buffer 的引用。
- © 线程:随上游。
3.7 qtivoverlay → waylandsink(叠加 + 上屏)
- (a) caps:qtivoverlay 拿着 meta 里的框坐标,在视频 buffer 上就地画框;waylandsink 把最终 buffer 交给 Wayland 合成器上屏。
- (b) 拷贝:叠加通常是就地渲染(在 buffer 上直接画),上屏走的是零拷贝 surface 提交——把 dmabuf 直接交给合成器,不往显存里再 copy 一遍。所以链路的尾段又回到了零拷贝。
- © 线程:显示线程,受合成器的 vsync 节奏约束。
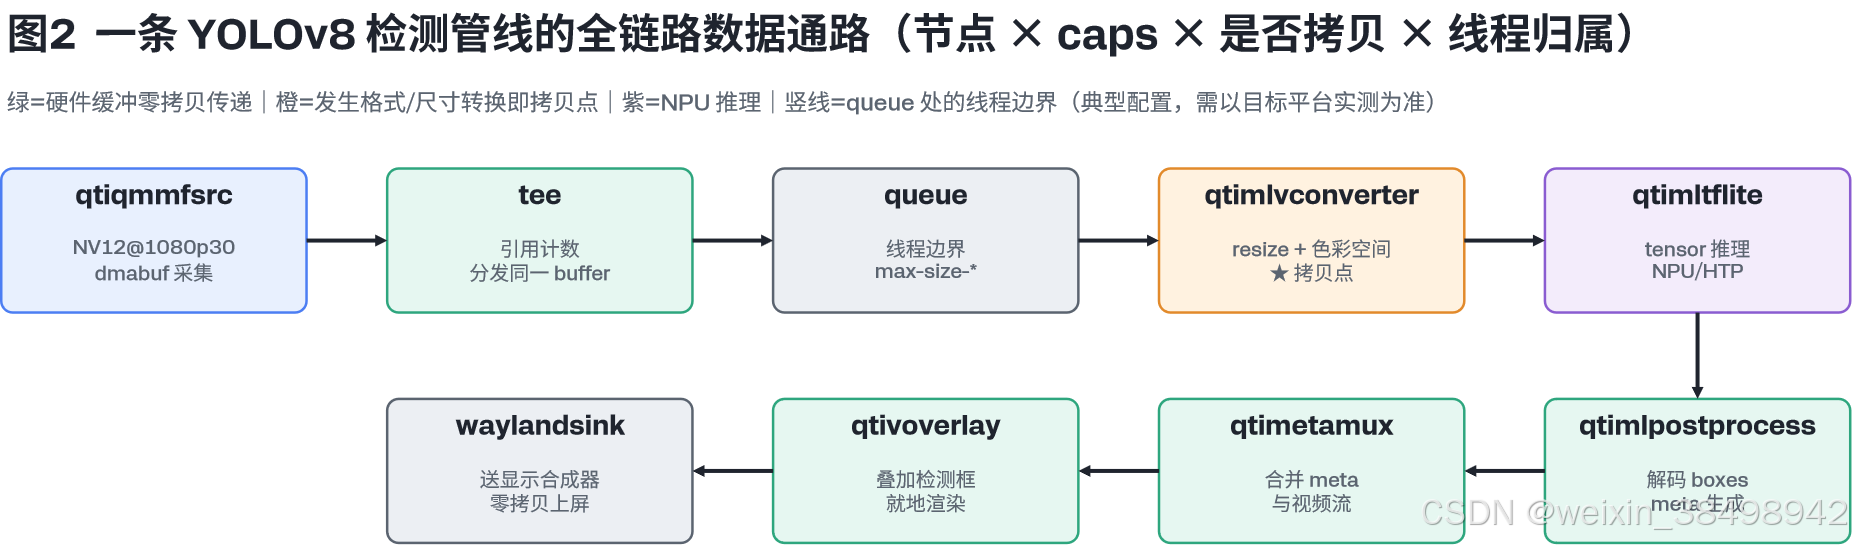
(图2:绿色是硬件缓冲零拷贝传递,橙色是发生格式/尺寸转换的拷贝点,紫色是 NPU 推理。看一眼就明白:这条"零拷贝管线"真正拷贝的地方,其实只有 qtimlvconverter 这一跳。而它恰恰是最容易被忽视、也最该被优化的地方。)
排查主线:先确认 caps 协商成功 → 再定位哪一跳发生拷贝(多在 qtimlvconverter)→ 最后看 queue 深度与线程阻塞传导。
| qtiqmmfsrc | — → video/x-raw(memory:GBM),NV12 | 否 (硬件采集到 dmabuf) | 采集线程 |
| tee / queue | 透传 → 透传 | 否 (引用计数,不复制 buffer) | queue 之后切线程 |
| qtimlvconverter | NV12 → tensor(RGB/NCHW,float) | ★是 (resize + 色彩空间 + 归一化) | 转换线程 |
| qtimltflite | tensor → tensor(输出) | 视 delegate 而定 (NPU 内常驻) | 推理线程 (抢 HTP) |
| qtimlpostprocess / metamux | tensor → meta视频 | 否 (只处理元数据) | 随上游 |
| qtioverlay → waylandsink | video+meta → 合成器 surface | 否 (就地叠加 + 零拷贝上屏) | 显示线程 |
4. 零拷贝到底"零"在哪
“零拷贝"这个词被用得太滥了,很多人以为是"全程不复制内存”。不是的。准确的说法是:
零拷贝 = 在能共享硬件缓冲的节点之间,只传递 buffer 的引用(dmabuf handle),而不复制数据本身。
它的物理基础是两个东西:buffer pool 和 dmabuf。
4.1 buffer pool:谁分配、谁回收
摄像头采集不是每一帧都 malloc 一块新内存,那样又慢又碎。它预先向系统申请一批固定大小的 buffer,组成一个池子。采集时从池子里拿一个空 buffer 填数据,用完了归还回池子循环利用。
这就解释了开场故障的一个深层机理:如果下游某个节点处理太慢,迟迟不释放 buffer,池子里就没有空 buffer 给采集端用了,采集直接停摆或掉帧。你在应用层看到的"掉帧",根因可能是下游某一跳的 buffer 没及时还回来。
4.2 dmabuf:跨 IP 共享的通行证
dmabuf(DMA buffer)是 Linux 内核提供的一种跨驱动、跨硬件 IP 共享内存的机制。一块 dmabuf 可以被 Camera、GPU、DSP、NPU、显示控制器同时映射访问,大家看到的是同一块物理内存。节点之间传的是这块 dmabuf 的 fd(文件描述符),谁都不用 copy。
所以"零在哪"的答案是:“零”在那些能直接消费硬件缓冲的 qti* 插件之间。而"不零”也很清楚,凡是要改变数据本身形态的地方(resize、色彩空间、量化、布局重排),就必须写新内存,零拷贝就断了。本管线里,这个断点集中在 qtimlvconverter。
这里顺带澄清一个常见误解:零拷贝不等于零开销。 即使数据不被复制,dmabuf 在不同 IP 之间共享时,仍然涉及 cache 一致性的维护,一个 IP 写完、另一个 IP 读之前,可能需要 cache flush / invalidate。这部分开销比 memcpy 小得多,但不是零。所以当你用 latency tracer 看到某个"零拷贝"节点也有几百微秒的耗时时,不必惊讶,那往往就是同步和一致性维护的成本,而不是偷偷做了拷贝。真正该警惕的是毫秒级的耗时,那基本就是发生了真正的数据搬运或 CPU 回落。
4.3 三件验证工具(这节的实操核心)
与其相信我上面的推断,不如自己验。下潜到 GStreamer 层,有三把刀:
① gst-inspect-1.0 看 pad template,确认一个插件接受和产出什么 caps,尤其看它支持哪些 memory: 类型(dmabuf / GBM)。如果两个相邻插件的内存类型对不上,中间就会被 GStreamer 插入隐式转换。
gst-inspect-1.0 qtimlvconverter # 看它的 SRC/SINK pad 支持的 caps 和 memory 类型
② GST_DEBUG 看 caps 协商,这是定位"哪一跳偷偷转换了"的利器。把相关元件的 debug 级别调高,看 negotiation 日志里实际协商出来的 caps:
GST_DEBUG=GST_CAPS:5,qtimlvconverter:5 gst-launch-1.0 ... 2>caps.log
# 在 caps.log 里搜 "caps" 和 "negotiated",看格式/内存类型在哪一跳变了
一段典型的协商日志片段长这样(示意):
0:00:01.2 qtimlvconverter caps negotiation: sink accepted
video/x-raw(memory:GBM), format=NV12, 1920×1080
0:00:01.2 qtimlvconverter caps negotiation: src pushing
other/tensors, format=RGB, layout=NCHW, 1x3x640x640, type=float32
>>> implicit CONVERT: NV12@1080p → RGB/NCHW@640 [COPY HERE]
看到那行 implicit CONVERT … [COPY HERE] 了吗?这就是零拷贝断裂的物证。
③ latency tracer 看各跳耗时,定位到底是哪一跳慢:
GST_DEBUG=GST_TRACER:7 GST_TRACERS="latency" gst-launch-1.0 ... 2>lat.log
# 分析每个 element 的处理延迟,找出耗时最高的那一跳
再强调一次 ★:上面所有命令里的属性名、模型路径、delegate 配置,都要以 gst-inspect-1.0 在你的 SDK 版本和目标平台上的实际输出为准。本文给的是排查方法,不是可直接复制的生产命令。
5. 多流调度:tee、queue 与 NPU 争用
回到开场:为什么单路好好的,四路一起就掉帧?这一节讲清楚三个机制。
5.1 机制一:tee 的引用计数
前面说过,tee 分发的是同一块 buffer 的引用。这带来一个微妙的后果:
只要还有任何一个分支没有释放这块 buffer,这块 buffer 就不能被回收。
设想你有一条检测分支(慢,要过 NPU)和一条直显分支(快,直接上屏)。如果检测分支卡住了,它攥着的那块 buffer 迟迟不释放,buffer pool 被耗尽,连带快的直显分支也拿不到新 buffer,一个慢分支把整条采集都拖死了。
解法就是在每个 tee 分支后面加 queue。queue 会在线程边界处把 buffer “接下来”,让各分支在各自的线程里独立推进,一个分支慢不至于立刻反压到 tee 上游。这就是 GStreamer 里那条铁律"tee 之后必加 queue"的由来,它不是风格建议,是正确性要求(忘了加,轻则互相拖累,重则死锁)。
5.2 机制二:queue 三组参数,分别管什么
queue 有三组容量上限,决定了它什么时候开始阻塞上游:
| max-size-buffers | 最多缓冲多少帧 | 帧率稳定、想精确控制积压帧数 |
| max-size-bytes | 最多缓冲多少字节 | 分辨率/码率波动大,想按内存预算封顶 |
| max-size-time | 最多缓冲多少时长 | 对延迟敏感的场景首选,直接按 ms 封住最大积压延迟 |
开场故障里"加了 queue 延迟涨 200ms"的根因,往往就是用了默认的 max-size-buffers(默认能缓冲好几帧),队列攒满了。对低延迟场景,应该显式把 max-size-time 压到一个可接受的小值(比如一两帧的时长),队列满了宁可丢老帧也不要堆积,用可控的丢帧换可控的延迟。
5.3 机制三:多模型的两种组织方式
当你要跑多个模型时,有两种结构(对应官方的 parallel-inference 示例思路):
- 串联(多模型级联):A 模型的输出喂给 B 模型。比如先检测人体框、再对每个框做姿态估计。特点是有依赖、延迟累加。
- 并行(多模型分流):tee 出多个分支,各跑各的模型。比如一路做目标检测、一路做分类。特点是无依赖、可并行。
5.4 机制四:NPU 是共享资源,帧率不是简单除以二
这是多流最反直觉的一点。你可能以为:两路推理抢一个 NPU,每路拿到一半算力,帧率减半。实际不是。
NPU(HTP)在做推理时,任务是串行排队执行的。两路推理争用同一个 HTP,会有:
- 上下文切换开销:两个模型来回切,要重新加载权重 / 配置,这部分是纯损耗;
- 内存带宽争用:两路同时读写 tensor,挤占同一条内存总线;
- VTCM / 片上缓存抖动:模型 A 把模型 B 的权重从片上缓存里挤出去了,下次切回来又得重新加载。
结果就是:两路一起跑的总吞吐,通常低于单路的 2 倍,有时明显低于。帧率不是 30 → 15,可能是 30 → 11。四路就更不是简单除以四了。
所以开场的四路掉帧,综合起来是三重作用: ① buffer pool 在某个慢分支处被耗尽; ② queue 参数没为多流调好; ③ 四路推理在 NPU 上的争用,让总算力达不到四路的需求。 加 queue 只缓解了前两个(用延迟换),第三个是物理上限。这时候要么降分辨率、要么降帧率、要么减模型、要么换更强的硬件,没有免费的午餐。
★ 怎么量化 NPU 争用:固定其他变量(同分辨率、同码流、同散热),分别测 1 路 / 2 路 / 4 路的实际 FPS 和 NPU 占用率,画出来。你会看到一条明显低于线性的曲线,这条曲线就是你做容量规划的依据。务必在目标板子上实测,不同 SoC 的 NPU 架构差异很大。
5.5 一个端到端延迟的"算账"示例(方法,非实测数字)
很多人对延迟没有量化的概念,只会说"感觉有点卡"。其实端到端延迟是可以拆项估算的,拆开之后你就知道该优化哪一项。以单路为例,一帧从采集到上屏的延迟,大致由这几段构成:
| 采集曝光 + ISP | 取决于 sensor,约 1 帧时长 | 基本固定 |
| queue 排队 | = 队列里积压的帧数 × 帧间隔 | ✅ 可控,调 max-size-time |
| qtimlvconverter 转换 | 亚毫秒~数毫秒 | ⚠️ 确认走硬件 |
| qtimltflite 推理 | 模型决定,几 ~ 几十毫秒 | ⚠️ 量化 / 换模型 |
| 后处理 + 叠加 | 通常很小 | 一般不是瓶颈 |
| 合成器上屏 | 受 vsync 约束,约 1 帧 | 基本固定 |
关键洞察是:queue 排队这一项,是唯一一个"你能随意放大也能随意缩小"的项。 开场那个"加 queue 延迟涨 200ms",算一下就明白,如果 queue 默认攒了 6 帧,30fps 下每帧 33ms,光排队就是 6 × 33 ≈ 200ms。一分不差。而其他各项加起来可能才几十毫秒。
所以优化延迟的第一刀,永远是先砍 queue 的积压,而不是上来就换模型、换硬件。先把队列压到 1~2 帧,看端到端延迟降到多少,再决定要不要动推理那一段。先算账,再花钱。
6. 什么时候该"下潜"到原生 GStreamer
App Builder 很香,但它有边界。什么时候必须绕过它、直接写原生 GStreamer 插件或管线?给一张决策表:
| 标准采集→推理→叠加→显示 | ✅ 够用 | 这是 App Builder 的主场 |
| 调 queue 参数、加 tee 分支 | ✅ 够用 | 配置层面就能搞定 |
| 多模型串联 / 并行 | ✅ 多数够用 | 参考 parallel-inference 结构 |
| 自定义动态 pad(运行时增删分支) | ⚠️ 多半要下潜 | 动态 pad 的 request/release 逻辑超出声明式描述能力 |
| 特殊时钟同步(多源严格对齐、外部时钟) | ⚠️ 要下潜 | 需要直接操作 GStreamer clock |
| 非标准硬件通路(自研 IP、特殊 dmabuf 协商) | 🔴 必须写原生插件 | 要实现自己的 GstBaseTransform / 协商逻辑 |
| 性能关键的零拷贝改造 | 🔴 必须下潜 | 要精确控制 buffer pool 和 caps,容不得抽象层的隐式行为 |
一句话总结判断标准:当你需要控制的东西,在 App Builder 的声明式配置里"没有对应的旋钮"时,就该下潜了。 下潜不是失败,是工程的正常分层。80% 的管线用 App Builder 快速搭好,剩下 20% 的硬骨头用原生 GStreamer 精雕。
还有一个实操建议:下潜之前,先用 gst-launch 把问题复现成一条命令。 App Builder 最终产出的也是一条 GStreamer 管线,你完全可以把它"拍扁"成等价的 gst-launch 写法,在命令行里反复改参数、开 debug、换节点。命令行迭代一次只要几秒,比改代码、重新编译、重新部署快得多。等你在 gst-launch 上把管线调通了,再决定是回填到 App Builder、还是就以原生管线的形态固化下来。这个"先 gst-launch 验证、再工程化"的习惯,会在后续几篇文章里反复出现。
7. 三条可复用的排查顺序
这些机制,最后浓缩成一套遇到花屏 / 掉帧 / 高延迟时,照着做的排查顺序。核心就一句话:从上往下、按依赖顺序排查 
顺序为:
【下篇预告】 在第一篇中,我们拆解了qtiqmmfsrc → tee → queue → qtimlvconverter → qtimltflite这条主干管线,明确了“零拷贝到底断在哪”以及“queue参数如何影响延迟”。但知道了这些,只是排雷的第一步。当我们真正把模型塞进管线,新的问题就来了:推理耗时到底卡在哪?预处理(resize/归一化)是走硬件还是CPU?如何针对高通HTP/NPU做模型量化与性能调优?
在第二篇中,我们将聚焦模型部署与推理性能调优,把这根管线的“算力”压榨到极致。
系列索引:(一)GStreamer数据通路与多流调度 · (二)QNN/ONNX Runtime/TFLite三大推理后端选型 · (三)Agentic Skills实测与提示词工程· (四)微服务化与事件流实践