🌊 专注 AI 大模型与前沿科技深度解析,习惯从工程师视角拆解技术热点,让我们一起在技术浪潮中保持清醒与好奇 🚀
回头一看,房间变了:视频世界模型的「记忆」难题怎么破?
想象你在玩一个"AI 生成的游戏":输入一张照片,模型就能让你在这个场景里自由走动。你往前走、左转、再转回来——问题来了:刚才那栋红房子,怎么变成了灰色?桌子的位置也挪了。这不是游戏 bug,而是视频世界模型的"金鱼记忆":模型每生成一帧,主要靠最近几帧做条件,几分钟前看到的东西早就被挤出了上下文。
最近一个名为 WorldCrafter 的工作,用一种很漂亮的思路缓解了这个问题。这篇文章就拆解它的做法,以及——更重要的——你能从中学到什么可以写进作品集的东西。前置知识要求不高:了解扩散模型和 Transformer 注意力的基本概念即可。
30 秒结论
- 核心判断:长时一致性的关键不是"更长的上下文",而是"按需求取的记忆"。WorldCrafter 的思路——让目标相机位姿决定从历史里"查询"什么——很可能成为这类系统的标准件。
- 适合谁:想做世界模型、视频生成、三维视觉方向的学生与转行者。这是理解"记忆机制 + 相机几何 + 扩散模型"三者如何拼装的绝佳样本。
- 不适合谁:想找开箱即用产品的人(目前还是研究原型);以及需要精确几何输出(测量、导出 mesh 做仿真)的场景。
关键证据
展开说明
为什么"拉长上下文"走不通?
朴素做法是把历史帧全塞进注意力。问题是视频 token 极其昂贵:一分钟的视频经过主流 tokenizer 压缩后仍有数万到数十万个 token,注意力开销随长度平方增长。更要命的是,其中绝大多数 token 对当前要渲染的视角毫无用处——你回头时,模型需要的是"身后那面墙"的证据,而不是正前方天空的几万张快照。
核心机制:让相机位姿来"点单"
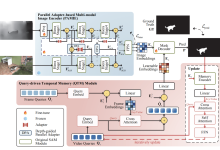
关键洞察一句话:请求哪个视角,就按哪个视角去压缩历史。三个部件配合:
分工很清晰:最近几帧管"时间上的连贯",记忆 token 管"空间上的回环"。
可以写进作品集的最小原型
这个机制的骨架并不复杂,本质是一次"位姿做 Query"的交叉注意力:
import torch
import torch.nn as nn
class PoseConditionedReadout(nn.Module):
"""按目标相机位姿,从记忆特征中读出视角特异 token"""
def __init__(self, dim=1024, num_mem_tokens=64, num_heads=8):
super().__init__()
self.queries = nn.Parameter(torch.randn(num_mem_tokens, dim))
# 相机外参 3×4 拉平为 12 维,编码成条件向量
self.pose_mlp = nn.Sequential(
nn.Linear(12, dim), nn.SiLU(), nn.Linear(dim, dim)
)
self.attn = nn.MultiheadAttention(dim, num_heads, batch_first=True)
def forward(self, memory_feats, target_pose):
# memory_feats: [B, S, D],历史观测的记忆特征
# target_pose: [B, 12],目标视角的相机外参
q = self.queries.unsqueeze(0) + self.pose_mlp(target_pose).unsqueeze(1)
out, _ = self.attn(q, memory_feats, memory_feats)
return out # [B, 64, D],作为条件注入视频生成器
真实系统当然更复杂:记忆本身在联合训练中滚动更新,位姿编码通常用 Plücker 射线这类几何上更友好的形式。但"查询—压缩—注入"这个闭环,就是上面这个样子。
面试里常被追问的点
- 为什么不用显式三维(深度反投影、点云)? 显式方案受深度估计质量拖累,动态物体和遮挡边界容易出错;隐式记忆端到端可学,代价是不可解释、难以直接编辑。
- 记忆为什么是固定大小? token 预算决定生成成本。预算固定意味着历史再长,延迟和显存都可预测——这是流式应用的硬约束。
- 少步蒸馏牺牲了什么? 去噪步数减少会损失细节与多样性,通常靠分布蒸馏把教师模型的输出分布压进少步学生模型,换取数量级的加速。
落地建议
风险与反例
- 高动态场景:记忆记的是"过去的它"。物体移动后你再回头看,隐式记忆可能交出"幽灵"画面。动态场景的长时一致性仍是开放问题。
- 固定预算是双刃剑:场景越大、探索越久,远期细节被压缩得越狠。"分钟级一致"指语义和布局层面,别期待逐像素复现。
- 隐式 ≠ 万能:要做场景编辑、重光照、物理仿真,或需要可测量的几何输出,显式三维表示(3DGS、mesh)仍是更合适的底座。
- 没看过的地方全靠"脑补":单图或文本开局时,转身看到的背面来自模型先验的想象——一致性只对"看过的部分"作数。