版权与内容来源声明
本文为原创整理。文中涉及官方文档、开源仓库、论文与公开报道的内容,均在附表 A 中标注来源;引用官方原文保持原样,不作改写。文中命令、版本号与界面截图以本文成文时的实测/核验结果为准,标注「待验证」的部分请以你本地环境实际输出为判断依据。本文不推荐任何不合规的软件获取方式,也不对任何收益结果作承诺。转载请注明出处。
一个 trace 的三条 span 按时间戳排完,顺序是这样的:
[
{"span": "search", "svc": "tool", "ts_ms": –13},
{"span": "llm", "svc": "agent", "ts_ms": 57},
{"span": "root", "svc": "gateway", "ts_ms": 180}
]
排在最上面的是最里层的那次检索调用,最后面的是链路入口。三条 span 的真实起点是 82、57、0 ms,记录成了 -13、57、180 —— tool 慢 95 ms,agent 没偏,gateway 快 180 ms。一次「gateway 调 agent、agent 调 tool」的正常调用,在图上变成「tool 先动、llm 接上、gateway 收尾」。
这条 trace 的两个父子边,全部颠倒 —— 排出来的顺序里,调用方向是反的。
这份数据来自一段三十来行、只用标准库的脚本,不是某一次线上事故的原始日志 —— 时间线、机器数量、每条 span 的间隔,都是按最小复现还原的推演场景;真实的是偏移与排序之间的因果链,它由三个常量决定,换批随机种子也照样成立。本文要答的是评测口径的三件事:颠倒算什么、修完还剩多少、判据定在哪条线上。
一、先看现场:工具调用排在模型思考前面
顺序颠倒不是显示问题,是「谁调用了谁」被写反了;按父子边统计,这次颠倒占 92.8%。
一条 trace 排完,两个父子边全反了
真实顺序是 root(0 ms)→ llm(57 ms)→ search(82 ms),两跳隔 57 ms 和 25 ms。记录出来的顺序是 search(-13)→ llm(57)→ root(180),两跳隔 70 ms 和 123 ms。
两跳间隔都被放大,倍数不同:25 ms 变 70 ms,57 ms 变 123 ms。放大后的值等于两端偏移之差减去真实间隔 —— 95 减 25 得 70,180 减 57 得 123。间隙有多离谱取决于两台机器差多少,与实际隔多远无关。
这也是它不像时钟故障的原因。人对时钟故障的直觉是抖动、忽快忽慢、偶发乱序,而这里是稳定、可复现、比例固定的乱序,更像代码 bug。
因果被写反之后,排障会往哪个方向跑偏
先看自动归因:最常见的规则是「按 start 排序,最早开始的是入口,最晚结束的是瓶颈」。套上去,tool 最早开始,第一嫌疑落在检索服务;root 最晚开始,第二嫌疑落在网关排队。两个都查完、指标都正常,才会有人回头怀疑 trace。
更贵的一种跑偏是「第一个变慢的环节」定位:找时间轴上的空隙,空隙大的那段就是耗时所在。本次第一跳空隙放大到 70 ms(真实 25),第二跳放大到 123 ms(真实 57)。按这个找,会稳定地指向「时钟走快的那台机器记的 span」—— 本次就是 gateway 记的 root,与性能、与调用关系都无关,只与偏移符号有关。
还有一种更隐蔽:告警规则写了「子 span 必须晚于父 span 开始」,规则没错,但会把 92.8% 的 trace 判成异常,然后被加进白名单关掉。
口径先钉死:什么算颠倒,分母是什么
判定式只有一行:一条父子边算颠倒,当且仅当 child.start < parent.start。用 start 不用 end,因为 end 的顺序天然可以反 —— 异步调用、「发了不管」的旁路、流式返回结束得比父早,都合法。拿 end 判会把正常并发算成故障,口径从一开始就脏了。
分母也有讲究。本文分母是父子边数 400,不是 trace 数 200。本次每条 trace 至少有一条边颠倒,按 trace 算得到 200/200,看着更吓人,但丢掉了「错了几条」—— 错一条和错两条是两种问题。
| 颠倒边数 | child.start < parent.start 的父子边计数 | 用 end 判会把合法的异步与流式返回算成故障 | 371 / 400 |
| 颠倒占比 | 颠倒边数 ÷ 父子边总数 | 分母取边不取 trace,一条 trace 里可以只错一条边 | 92.8% |
| 最小父子间隔 | 全部边上 child.start – parent.start 的最小真实值 | 它是判序能力的物理下限,残差要跟它比 | 10 ms |
| 残差 | 估计偏移 − 真实偏移 | 「修完还剩多少」只能用它回答 | +0 ms / +1 ms |
「最小父子间隔 10 ms」比残差那一列更重要:残差小于它,顺序能分开;大于它,再准的算法也救不回来。
二、故障是怎么逐步放大的:三个阶段
偏移的危害不是一次到位的,它随机器数量和链路深度分三级放大,每一级的触发条件都能写成不等式。
阶段一:单机内部自洽,所以第一轮排查什么都没查到
span 的 duration 是同一台机器上 end – start 的结果,两个时间戳共用一个时钟,偏移在减法里抵消。所以每台机器自己的看板全绿:耗时正常、错误率为 0、P99 平稳。这个阶段没有任何信号,正是它危险的地方。触发条件:只看单机。不把两台机器的数据放进同一张图,偏移就一直不可见。
阶段二:两台机器一合并,root 永远排在 llm 后面
触发条件可以写成一条不等式:两端偏移之差 > 这一跳的最大真实延迟,这条边就必然颠倒,与流量、负载、代码都无关。
本次 gateway 与 agent 差 180 ms,这一跳真实间隔只有 10 到 60 ms,上限 60 小于 180,所以 200 条 root→llm 边一条不漏,全部颠倒 —— 这不是概率,是算术。
第二跳性质不同。llm 与 search 的偏移差 95 ms,真实间隔在 20 到 120 ms 之间,95 正好落在区间里 —— 间隔比 95 大的边顺序是对的,小的颠倒了。371 减第一跳的 200,剩 171 条全在第二跳。偏差与间隔同量级时,颠倒从必然变成概率。
阶段三:第三台机器进来,误差开始沿链累加
链式估计会把误差叠起来:tool 的偏移 = agent 的偏移(估的)+ tool 相对 agent 的偏移(估的),两跳残差相加,末端背两份。输出里 tool 的 -274 ms 就这么来的:-180 加 -94,真值是 -275。第三台机器本身只错 1 ms,但它继承的 -180 也是估算值,误差一路传下来。
规律有点反直觉:机器越多,误差不一定越大 —— 同层机器各自直连参考点,误差互不叠加;链路越深,误差一定越大。「加机器」和「加深调用链」性质不同,后者才放大时钟问题。
| 一:单机自洽 | 只在单机看 duration | 全部正常,P99 平稳,错误率为 0 | 偏移在同一个时钟的减法里抵消,问题被完全藏住 |
| 二:两机合并 | 偏移差 > 该跳最大真实延迟(本次 180 > 60) | root 永远排在 llm 后面,200 条边一条不漏 | 排序按记录时刻做,顺序由偏移符号决定,与性能无关 |
| 三:三机串联 | 链路深度 ≥ 2 且逐跳估计(本次 -180 与 -94 相加) | 总账 92.8%(371/400),第三台残差 1 ms | 上游残差沿链传递,末端背两跳误差 |
三、一个完整案例的复盘
修完之后颠倒归零,但该看的不是那个 0,是残差和它的上界。
复现只需要三个常量和一次循环
脚本结构就四块:三个常量定偏移(gateway +180、agent 0、tool -95)、造 200 条 trace、数颠倒、估偏移。估偏移用「往返时延最小的那条样本,以往返中点反推对端打点相对本端的差」—— 这就是把一次 NTP 式测量落到 trace 上。种子固定,换台机器跑出来的输出也一样。
🧪 实测环境:Python 3.13.12 / macOS (darwin) / 仅标准库(random 固定随机种子)
"""三台机器各自打点,按时间戳合并 trace:时钟偏移让父子顺序颠倒。"""
import random
random.seed(20261101)
OFFSET = {"gateway": 180, "agent": 0, "tool": –95} # 各机器时钟相对真值的偏移(毫秒)
N_TRACE = 200
def build():
"""每条 trace:gateway 记 root → 调 agent(llm)→ agent 调 tool(search)。"""
traces = []
for i in range(N_TRACE):
t0 = 1_700_000_000_000 + i * 5_000
df1, db1 = random.randint(10, 60), random.randint(10, 60)
df2, db2 = random.randint(10, 60), random.randint(10, 60)
dur1, dur2 = random.randint(5, 60), random.randint(5, 60)
root_true = t0
llm_true = t0 + df1
tool_true = llm_true + dur1 + df2
traces.append({
"root": {"svc": "gateway", "logged": root_true + OFFSET["gateway"], "true": root_true,
"send": t0 + OFFSET["gateway"], "recv": t0 + df1 + db1 + OFFSET["gateway"]},
"llm": {"svc": "agent", "logged": llm_true + OFFSET["agent"], "true": llm_true,
"send": llm_true + dur1 + OFFSET["agent"],
"recv": llm_true + dur1 + df2 + db2 + OFFSET["agent"]},
"search": {"svc": "tool", "logged": tool_true + OFFSET["tool"], "true": tool_true},
})
return traces
def inversions(traces, shift=None):
bad = 0
for t in traces:
ts = {k: t[k]["logged"] – (shift or {}).get(t[k]["svc"], 0) for k in t}
for a, b in [("root", "llm"), ("llm", "search")]:
if ts[a] > ts[b]:
bad += 1
return bad
def estimate(traces, parent, child):
"""Cristian:offset ≈ 对端打点 – 本端往返中点;取 RTT 最小的那个样本。"""
best = None
for t in traces:
p, c = t[parent], t[child]
rtt = p["recv"] – p["send"]
est = c["logged"] – (p["send"] + rtt // 2)
if best is None or rtt < best[0]:
best = (rtt, est)
return best
total = N_TRACE * 2
traces = build()
print(f"{N_TRACE} 条 trace × 3 个 span,父子边 {total} 条")
print(f"未校正:按日志时间戳排序,父子顺序颠倒 {inversions(traces)}/{total} 条"
f"({inversions(traces) / total:.1%})")
est = {"gateway": 0}
for parent, child in [("root", "llm"), ("llm", "search")]:
rtt, off = estimate(traces, parent, child)
child_svc = traces[0][child]["svc"]
est[child_svc] = off + est[traces[0][parent]["svc"]]
rel_true = OFFSET[child_svc] – OFFSET["gateway"]
print(f" {child_svc:7s} 最小 RTT {rtt:3d} ms → 累计偏移 {est[child_svc]:+.0f} ms"
f"(相对 gateway 真值 {rel_true:+d} ms,残差 {est[child_svc] – rel_true:+.0f} ms)")
print(f"按真值扣掉偏移:颠倒 {inversions(traces, OFFSET)}/{total} 条")
print(f"按最小 RTT 估计值扣:颠倒 {inversions(traces, est)}/{total} 条"
f"({inversions(traces, est) / total:.1%})")
🧪 实测环境:Python 3.13.12 / macOS (darwin) / 仅标准库(random 固定随机种子)
200 条 trace × 3 个 span,父子边 400 条
未校正:按日志时间戳排序,父子顺序颠倒 371/400 条(92.8%)
agent 最小 RTT 25 ms → 累计偏移 -180 ms(相对 gateway 真值 -180 ms,残差 +0 ms)
tool 最小 RTT 23 ms → 累计偏移 -274 ms(相对 gateway 真值 -275 ms,残差 +1 ms)
按真值扣掉偏移:颠倒 0/400 条
按最小 RTT 估计值扣:颠倒 0/400 条(0.0%)
六行输出,每一行对应一个判据
| 未校正,按日志时间戳排序 | 371 / 400 | 92.8% |
| 按真值扣掉偏移 | 0 / 400 | 0.0% |
| 按最小 RTT 估计的偏移扣 | 0 / 400 | 0.0% |
这张表有一处会让人误读:三行看着像「逐步变好」,其实是一步修好 —— 中间没有过渡带。估计误差小于间隔,颠倒就从 371 掉到 0;大于间隔,一条都修不好。0 是饱和值,说不了余量。
带余量信息的是输出里那两行估计过程:agent 最小 RTT 25 ms,估出 -180,对真值 -180,残差 +0;tool 最小 RTT 23 ms,估出 -274,对真值 -275,残差 +1。残差 1 ms 对最小间隔 10 ms,余量 10 倍 —— 0 条颠倒能站住,靠的不是算法准,是余量够。
还有一处要说清:第二行「按真值扣掉偏移」是上帝视角,只有造数据的人能写出来 —— 它给估计值当标尺,不是方案。
从 92.8% 到 0%:修好的是顺序,修不掉的是残差
估计式的来源是 RFC 5905 §8,原文两个式子:
theta = T(B) – T(A) = 1/2 * [(T2-T1) + (T3-T4)],delta = T(ABA) = (T4-T1) – (T3-T2).
四个时间戳对应四次打点:T1 本端发出请求、T2 对端收到、T3 对端回发、T4 本端收到。theta 是两端时钟差,delta 是一次完整往返的时延。estimate 是它的简化版:用 send 和 recv 夹出往返窗口,取中点当「对端打点的本端等效时刻」,相减得偏移,只取 RTT 最小的那条样本。
取最小 RTT 不是图省事,是挑「最接近对称的那一次测量」。delta 里同时含真实处理时间和排队,对称部分在 theta 的加减里抵消,不对称部分全部落进残差。估计精度不由算法决定,由那次测量的不对称程度决定。
上界在 RFC 5905 §4 里写得很直白:The synchronization distance (LAMBDA) equal to EPSILON + DELTA / 2 represents the maximum error due to all causes. 忽略 EPSILON,本次两个 δ 是 25 ms 和 23 ms,误差上界 12.5 ms 和 11.5 ms。
把 12.5 ms 和最小间隔 10 ms 摆在一起,结论有点难看:按上界判,这次不该保证 0 条颠倒。上界比间隔还大,理论上有整整 10 ms 的区间落进去就被判反。实测 0 条,是因为最小 RTT 那两次抽样的不对称恰好只有 0 到 1 ms。这是抽样运气,不是机制保证。
「能修到什么程度」的答案因此是:修到 δ/2 这个量级,不是修到 0。要让顺序可靠,需要 δ/2 < 最小间隔,也就是 δ < 20 ms;本次 25 和 23 都略微超线,把最小 RTT 压到 20 ms 以下才进安全区。压 δ 靠的不是更聪明的算法,是让测量更对称:同机房、低排队、多测几次取最小。
另一件事是偏移的相对性。est = {"gateway": 0} 是人为锚点,-180 和 -274 都是相对 gateway 的值。换成 agent 做参考点,三个数变成 +180、0、-95,整体平移 180,颠倒数不变 —— 排序只依赖差。绝对偏移不可观测,可观测的只有差,这句话决定了偏移字段的语义:必须带参考点,否则就是一群没意义的数字。
这份资料是什么:链路追踪里跨服务时间对齐的实践清单,从 span 字段设计、时钟源选择到合并前的校验规则,和本章讲的「偏移怎么估、残差留多少」是同一件事的上下游。放在资料包里,扫码即可获取:
四、我改了什么:四条硬规矩
这四条都能写成配置项、在合并前跑一次,也不依赖你把时钟调到多准。
规矩一和规矩二:把时间基准拆开,把参考点钉死
规矩一:墙钟只跨机比,单调钟只管机内。span 的 duration 一律用单调钟算,跨机排序用墙钟。判据写死:同一 span 用两种时钟算出的 duration 差超过 1 ms,按采样 bug 处理,不按性能问题处理 —— 同一段代码在同一台机器上跑,两种时钟的差只可能来自采样时刻错位或时钟跳变。
规矩二:偏移只对参考点直接估,不沿调用链累加。只估 agent→gateway、tool→gateway 两条,不估 tool→agent 再相加。判据:链路深度超过 2 时,残差上界按每跳 δ/2 累加,深度 3 就是 3δ/2;本次 tool 改成直连估计,残差只受一次 δ 影响。
规矩三:验收要两条线,只报残差等于没报
| ① 残差留余量 | 实测残差 ≤ 最小父子间隔 ÷ 5 | 1 ms ≤ 2 ms | 通过 |
| ② 上界压得住 | δ/2 ≤ 最小父子间隔 | 12.5 ms > 10 ms | 不通过 |
| ③ 颠倒率可接受 | 颠倒边数 ÷ 父子边总数 ≤ 1% | 0.0% | 通过 |
①③过了、②没过,结论不是「没问题」,而是「这次抽到对称样本,机制上不保证」—— 写进风险登记,不写进 SLA。
系数取 5 的理由:残差是系统性的,符号固定、方向固定,会持续把同一批边推向同一侧。只要有一批边的真实间隔小于残差,那批边就永远错,而且错得一致 —— 一致比随机更危险,因为它像规律。余量按最坏那条边定。
②这条绕不开的原因:残差在真实系统里观测不到,你手上只有 δ。用 δ/2 当上界,是不掌握真值时唯一能做的判断。
规矩四:时间戳只能排序,不能判因果
因果以 parent_id 为准,时间戳只用来画瀑布图和排「疑似」。任何「按时间戳推断谁调用了谁」的逻辑,颠倒率超过 1% 就关掉。1% 的来由:一条 trace 平均两条边,1% 的边错意味着每 50 条 trace 就有一条给出反向结论,这个量级下根因定位的方向不可信,还容易被当成偶发。
四条规矩落到配置上就这么几行:
trace_merge:
clock_source: wall # 跨机比较只用墙钟
duration_source: monotonic # 机内时长只用单调钟
reference_service: gateway # 偏移只对参考点直接估,不逐跳累加
estimate_samples: min_rtt # 取 RTT 最小的样本,不取平均
max_residual_ms: 2 # 判据①:残差 ≤ 最小父子间隔 / 5
max_half_rtt_ms: 10 # 判据②:δ/2 ≤ 最小父子间隔
inversion_budget_pct: 1 # 判据③:颠倒率超过 1% 关闭时间戳因果推断
五、比对齐时间更该先想清楚的事
时钟对齐解决的是「同一时刻」怎么定义,trace 要回答的是「谁调用了谁」,后者本来不需要前者。
排序是呈现,因果是数据
trace 最有价值的部分是 span_id 和 parent_id 构成的树,时间戳只是让瀑布图好看。先把树修好,图自然对;反过来先把图排对,树还是错的。
落到实现上就一条:合并时先按 trace_id 分组、按 parent_id 建树,再用时间戳校验;校验失败只降级时间线视图,不降级调用树视图。
按这个分工回看本文的数据,会得到一个荒谬的结论:371 条颠倒边里,没有一条边的父子关系真错了。父子关系写在 parent_id 里,从头到尾没被碰过;被写反的只是「图上的先后」,而图是给人看的。
偏差是属性,不是错误
偏移不会消失,只能被记录。每次合并前把估计的元数据存下来:参考点、哪次估计、δ 多少、残差上界多少、用了哪条样本。三个月后有人问「这条 trace 的时间可不可信」,你能回答;不存,就只能回答「当时看着没问题」。那个 -274 ms 就是这么来的:-180 与 -94 相加,每步的 δ 都留档,后面才不会有人拿它当绝对偏移用。
什么时候停手:残差压到最小间隔的五分之一
停手线:残差 ≤ 最小间隔 ÷ 5,且 δ/2 ≤ 最小间隔。两条都满足就停在软件层,NTP 够用。本次第一条满足、第二条差 2.5 ms,动作是把最小 RTT 从 25 ms 打到 20 ms 以下 —— 换同机房部署或降排队,都是工程动作。
继续投入的线:最小父子间隔小于 1 ms,出现在同一进程内的连续 span、高频轮询里的工具调用。这时 δ 本身大于间隔,RTT 估计直接失效,只能靠同一台机器产出父子 span,或者上硬件时间戳。
别做的事:残差从 1 ms 压到 0.1 ms,而最小间隔还是 10 ms。判序能力一点没变(10 倍余量和 100 倍余量,结论都是能分开),成本跳一个台阶。标准是间隔,不是残差 —— 残差比间隔小一个数量级就够,剩下的钱该花在缩短链路深度上。
回到标题:三台机器差 180 毫秒,trace 里的因果就全反了。反的不是因果,是排序;排序之所以被当成因果,是因为太多人只把 trace 当一张图看。
这份资料是什么:可观测性工程的学习路线,从指标、日志、链路三条线怎么分工,到 trace 字段与采样策略怎么设计,和本文讲的「排序与因果要分开」是同一条线上的取舍。放在资料包里,扫码即可获取:
附表 A:本文引用事实与出处对照表
| 1 | theta = T(B) – T(A) = 1/2 * [(T2-T1) + (T3-T4)] | RFC 5905 §8,IETF,https://www.rfc-editor.org/rfc/rfc5905 | 第三章第三节 |
| 2 | delta = T(ABA) = (T4-T1) – (T3-T2). | 同上,§8 | 第三章第三节 |
| 3 | The synchronization distance (LAMBDA) equal to EPSILON + DELTA / 2 represents the maximum error due to all causes. | 同上,§4 | 第三章第三节、第四章第二节 |
| 4 | 本次实测读数:200 条 trace × 3 个 span、400 条父子边;未校正颠倒 371/400(92.8%);按真值扣 0/400;按最小 RTT 估计扣 0/400,残差 +0 ms 与 +1 ms | 本文自测,e05_skew.py,输出为脚本原始 stdout | 第一章第一节、第三章第一至三节 |
| 5 | 脚本参数:gateway +180 ms、agent 0 ms、tool −95 ms;每跳转发与处理延迟取 10–60 ms;随机种子 20261101 固定,可复现 | 本文自测,e05_skew.py | 第二章第二、三节、第三章第一节 |
写在最后:这篇用到的资料
写这篇文章时,把相关的官方文档和源码又翻了一遍,顺手也整理了几份配套的东西:
- 大模型学习路线图:从零基础到能自己动手做 Agent,按阶段说明每一步该学什么、哪些可以先跳过
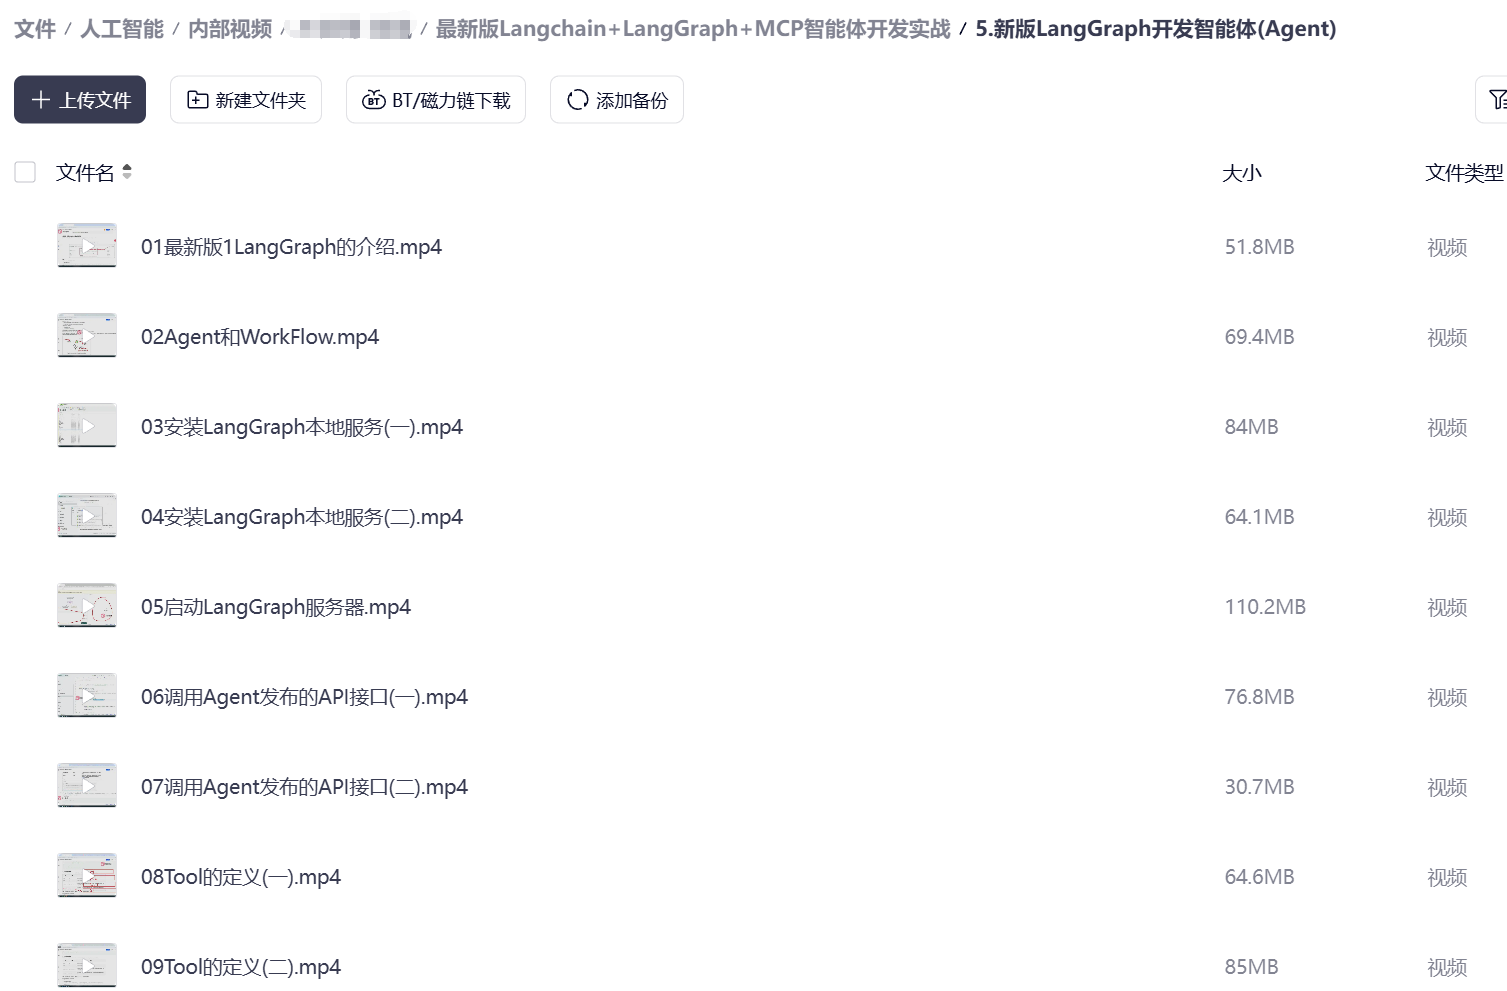
- 《LangChain + LangGraph + MCP 智能体开发实战》视频课:7 个模块,从私有化部署、Embedding+RAG 到 MCP+Agent 全流程
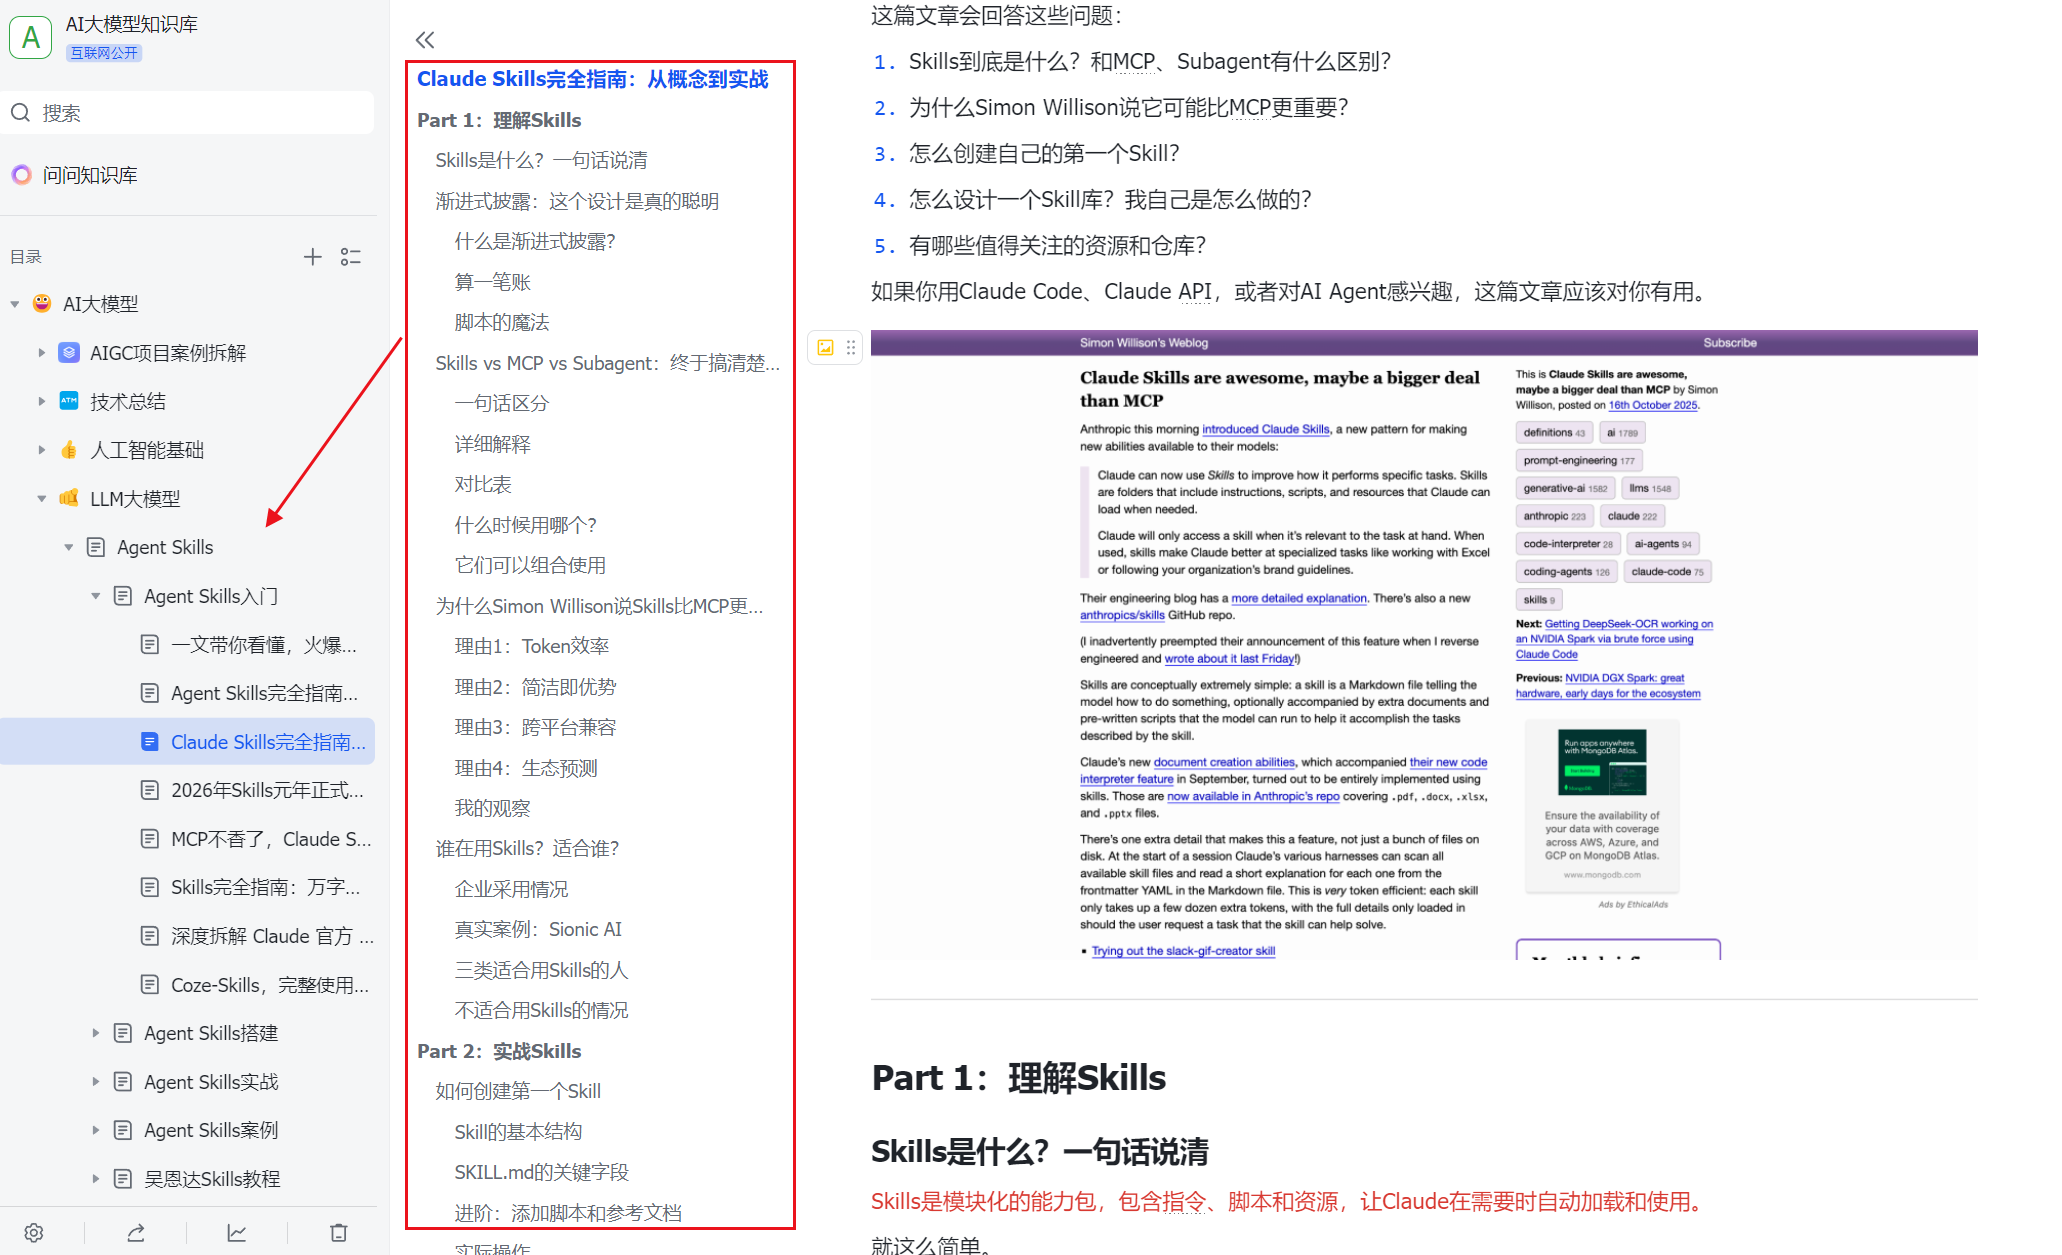
- AI 大模型知识库(在线可查):Agent Skills 从入门到落地、Claude Skills 完全指南等专题,按目录浏览即可
- 640 套 AI 大模型行业报告 + 经典 PDF 书籍:看行业落地案例和别人怎么做的时候用得上
- 大模型零基础到精通教学视频:跟着敲一遍,比只读文档快得多
资料是我自己整理的,放在下面这个码上,扫码即可获取:
添加时备注「AI」,优先通过。
资料按「先路线、再动手、最后查漏」的顺序整理好了,建议先看学习路线那一份,照着它挑一条适合自己当前基础的路径再往下看。