/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
在每年双 11 大促的战时应急预案中,“消息中间件堆积熔断”永远是压在架构师心口上的一块巨石。
大促零点洪峰来袭,核心交易系统的写入速率高达数十万 TPS。为了保护下游脆弱的账单结算、会员积分、商家结算和物流打单数据库,上游交易网关将所有的履约流水疯狂写入 Kafka 消息队列进行削峰。
然而,一旦下游的某个记账微服务因为死锁发生卡顿、或者底层数据库在凌晨 2 点突发短暂停机维护 20 分钟,Kafka 核心 Topic 的堆积曲线就会以惊人的速度呈垂直 90 度直冲云霄——消息堆积量(Consumer Lag)瞬间突破 5000 万条,甚至逼近 1 亿条!
当数据库恢复后,运维人员急迫地想要把堆积排空,却遭遇了残酷的物理现实:
- 该核心 Topic 在设计之初分配了 32 个物理分区(Partitions);
- 按照 Kafka 的底层协议规范:在同一个消费者组(Consumer Group)内,一个分区同一时刻只能由唯一的一个消费者线程(Consumer Thread)串行拉取!
- 此时,即使你给消费者集群紧急扩容了 128 台高配服务器,多出来的 96 台实例也只能陷入“无分区可分配”的闲置假死状态;
- 如果单个消费者线程采用传统的“单条拉取、同步入库”模式,单条消息处理耗时 10ms,单线程吞吐仅有 100 TPS。整个集群 32 个分区的总消费速率被死死卡在 3200 TPS!
要消化这 1 亿条严重堆积的消息,需要整整 8.6 个小时!到了上午 9 点真实用户上班查账时,昨天半夜的订单都还没结算完毕,全网舆论危机直接引爆。
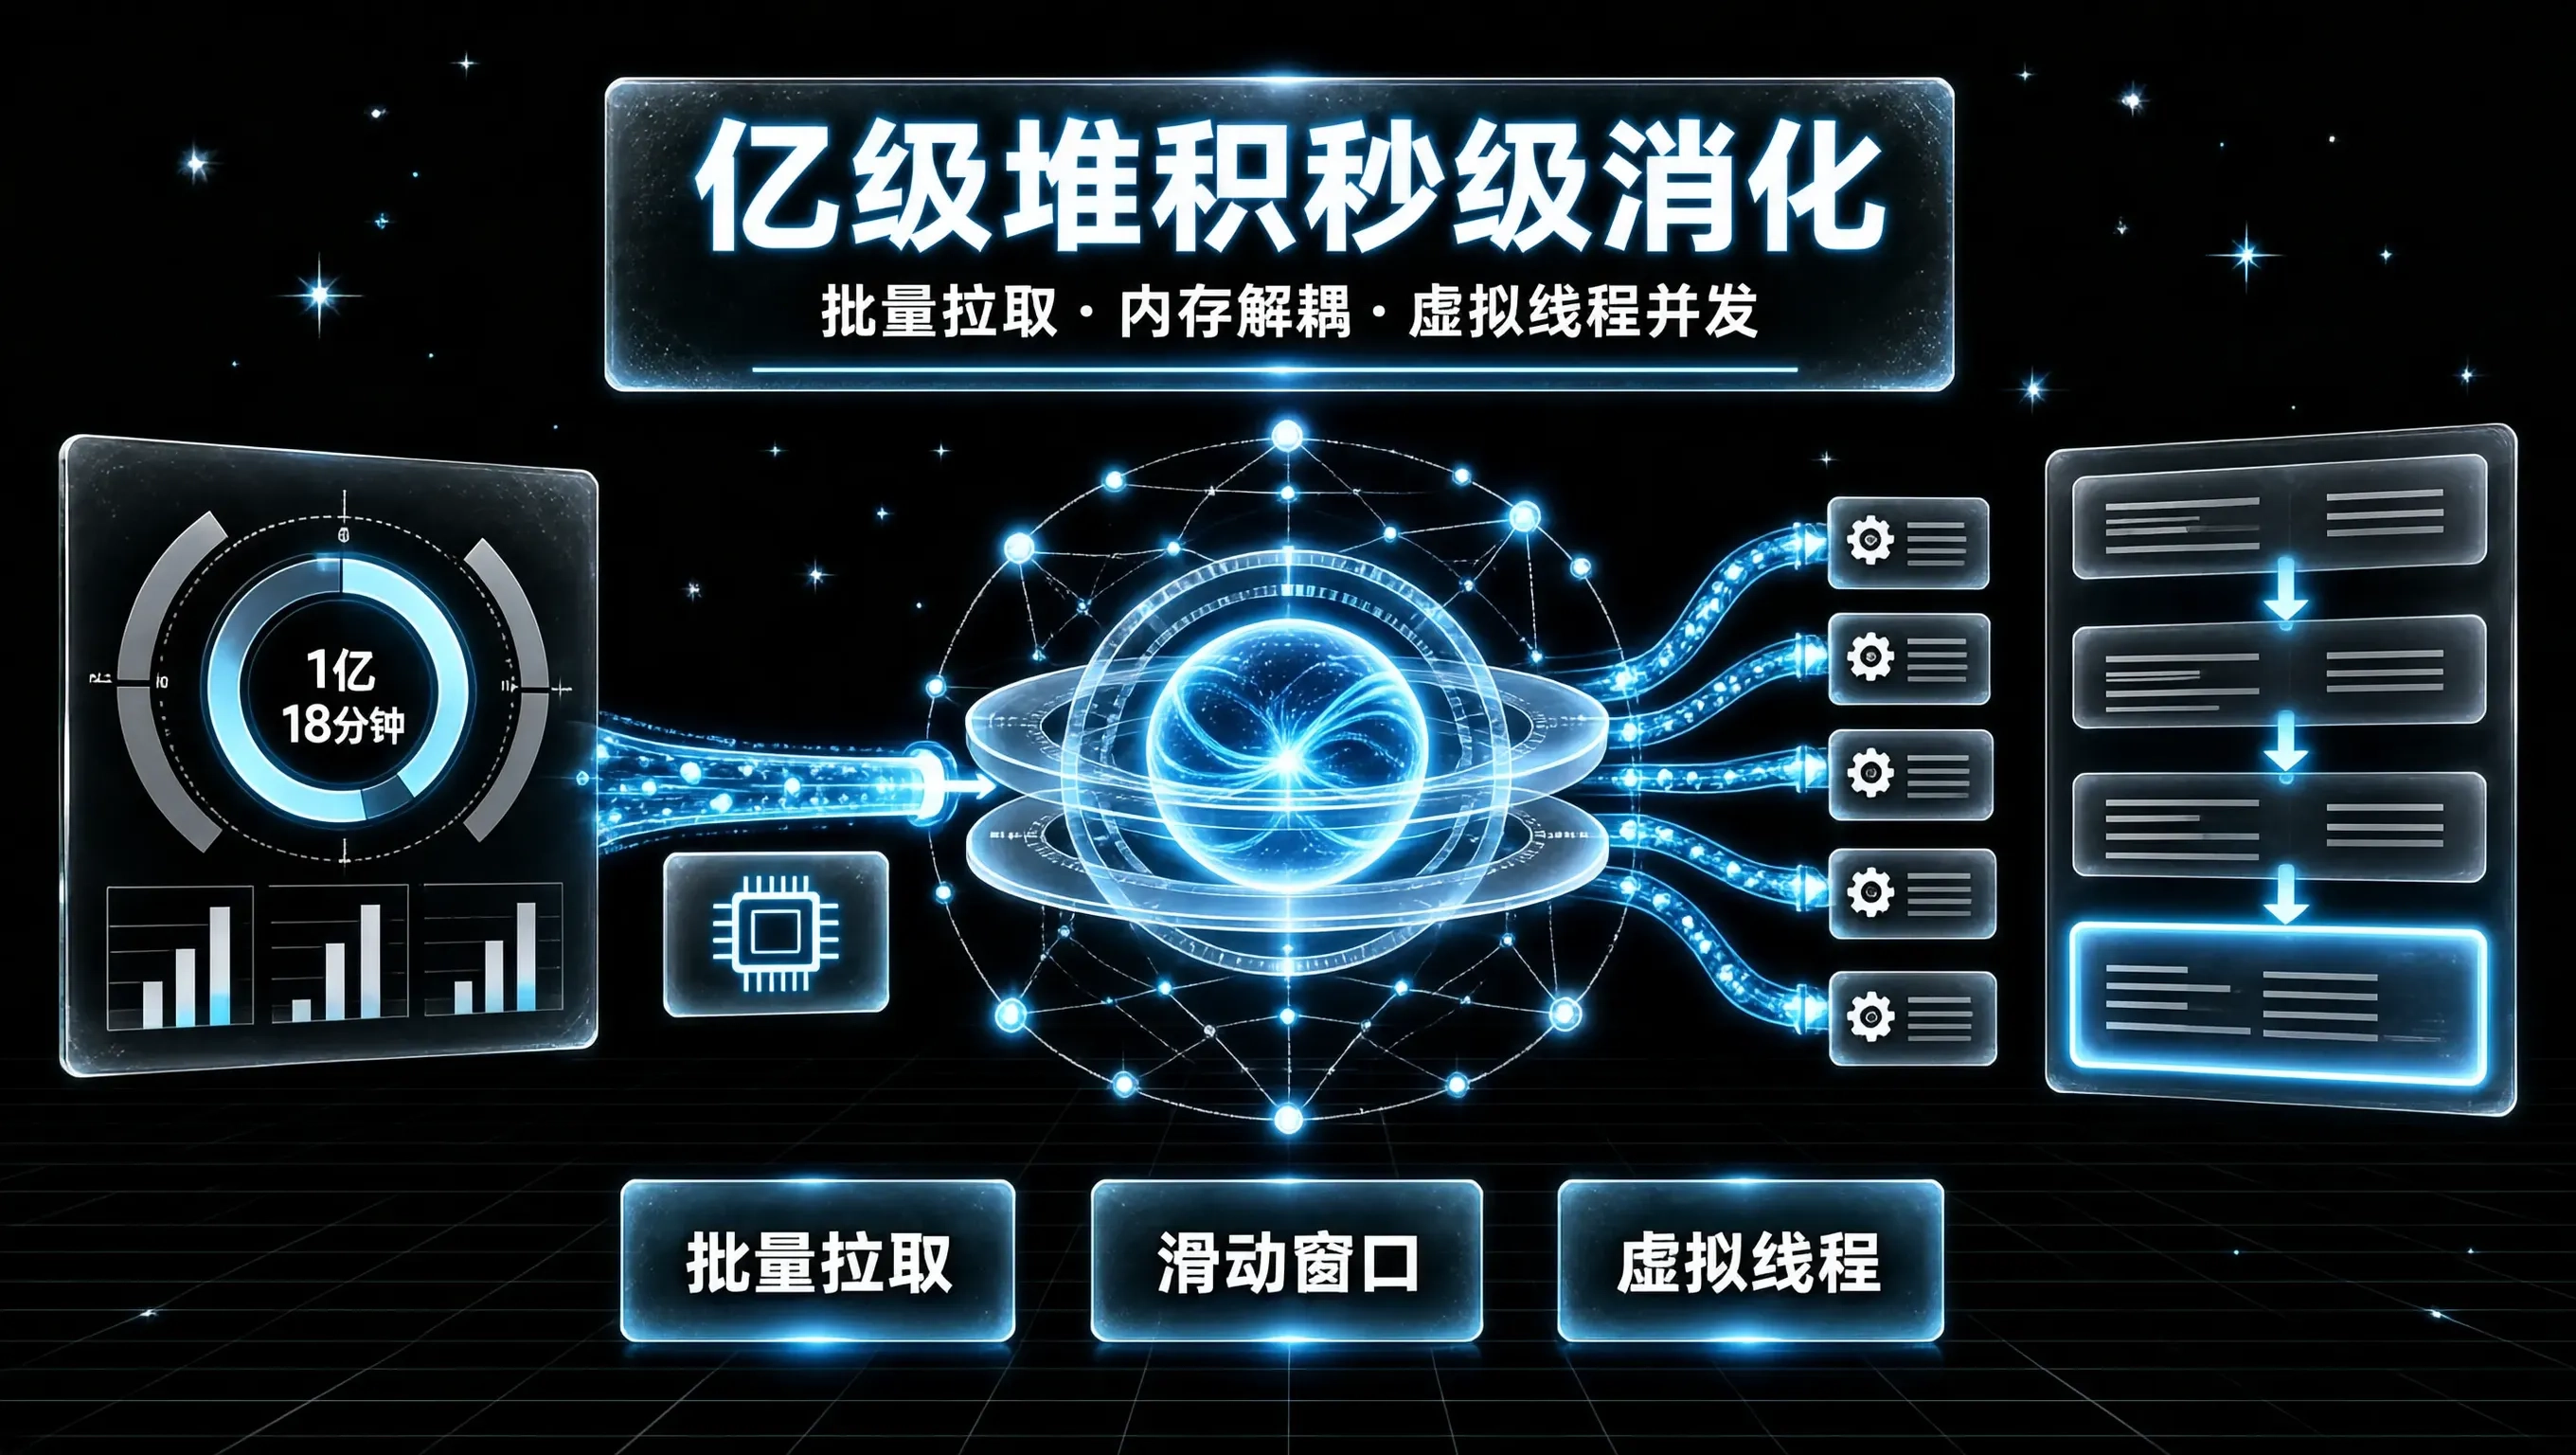
如何打破单分区只能串行单线程消费的物理枷锁?本文将深入剖析 Kafka 消费加速的底层瓶颈,详解如何利用“批量拉取 + 内存环形解耦 + 虚拟线程池并发 + 滑动窗口单调 Offset 提交”构建高吞吐、零数据丢失的极端消费加速通道。
传统消费模型的物理瓶颈与并发改造陷阱
要实现真正的消费加速,首先必须理清传统 KafkaConsumer 的性能瓶颈究竟卡在哪里:
[传统单线程拉取消费]
Kafka Broker ──(网络 I/O 2ms)──> Poll 批量拉取 500 条
│
▼ (主拉取线程开始串行同步消费)
处理第 1 条 (执行 DB 操作 10ms)
处理第 2 条 (执行 DB 操作 10ms)
…
处理第 500 条 (执行 DB 操作 10ms)
│ (总耗时 5000ms!期间无法发起下次 Poll)
▼
Commit 提交 Offset
在上述模型中,负责网络 I/O 的拉取线程与负责业务计算的工作线程被严重耦合。在处理业务的 5 秒钟内,网络管道完全闲置;更危险的是,如果单批次处理总耗时超过了配置的 max.poll.interval.ms(默认 300 秒),Kafka Broker 就会判定该消费者已经死亡,直接触发全网灾难性的再均衡(Rebalance 风暴)!
并发改造的最大死穴:Offset 提交断层与消息丢失
很多开发者尝试在 poll() 之后,直接把消息丢到 Java 线程池里并发执行:
threadPool.submit(() -> process(record)); // 极其危险的自毁写法!
这种朴素并发会瞬间引爆数据一致性灾难:
- 假设拉取了 Offset 从 100 到 105 的 6 条消息并发执行;
- 负责处理 Offset=105 的线程先跑完了,顺手提交了 Offset=105;
- 而此时负责处理 Offset=101 的线程由于数据库网络抖动失败了,或者服务器突然断电重启;
- 重启后,Kafka 从已提交的 Offset=105 开始继续拉取,Offset 从 101 到 104 的核心交易数据凭空彻底丢失!
终极架构:虚拟线程解耦与滑动窗口单调提交
为了在单分区内实现高达 500 倍的并发消费提速,同时在数学上 100% 杜绝消息丢失与乱序,我们设计了基于滑动窗口(Sliding Window)的流水线加速架构:
[Kafka Broker (32 分区)]
│ (网络批量拉取: max.poll.records=2000, 耗时 5ms)
▼
┌────────────────────────────────────────────────────────────┐
│ 消费者端:极速分发主线程 (Poll Thread) │
│ 1. 唯一职责: 负责网络 I/O,绝不参与任何繁重业务计算 │
│ 2. 内存环形解耦: 将批量 Record 快速推入内部滑动窗口管理池 │
└────────────────────────────────────────────────────────────┘
│
├── [基于业务 Key 哈希分流] (相同商户/订单进入相同虚拟队列,保序)
│
▼
┌────────────────────────────────────────────────────────────┐
│ 虚拟线程并发处理池 (Virtual Thread Pool, 并发度 500) │
│ – 为每个 Record 派发一个轻量虚拟线程 │
│ – 异步执行数据库写入、RPC 结算 (I/O 阻塞时自动卸载 Carrier) │
└────────────────────────────────────────────────────────────┘
│
▼ (各子任务并发完成,状态异步回调)
┌────────────────────────────────────────────────────────────┐
│ 滑动窗口单调递增 Offset 提交器 (Monotonic Sliding Window) │
│ – 内存位图追踪: [100:OK] [101:OK] [102:WAIT] [103:OK] │
│ – 核心铁律: 提交指针只能推进到“连续完成的最高位”! │
│ (此处只能安全提交 101,绝对不越过 102 提交 103) │
└────────────────────────────────────────────────────────────┘
│
▼ (批量安全异步 Commit)
[向 Broker 提交安全消费位移]
生产级单分区高并发消费加速引擎实现
以下是基于 Java 24 虚拟线程实现的滑动窗口消费加速器核心生产代码:
package com.architect.kafka.accelerator;
import org.apache.kafka.clients.consumer.*;
import org.apache.kafka.common.TopicPartition;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import java.time.Duration;
import java.util.*;
import java.util.concurrent.*;
import java.util.concurrent.atomic.AtomicLong;
/**
* 生产级 Kafka 单分区百万并发加速器与滑动窗口提交器
*/
public class HighThroughputConsumerPipeline {
private static final Logger log = LoggerFactory.getLogger(HighThroughputConsumerPipeline.class);
private final KafkaConsumer<String, String> consumer;
private final ExecutorService virtualExecutor = Executors.newVirtualThreadPerTaskExecutor();
// 每个分区专属的滑动窗口位图表 (记录 Offset -> 是否消费成功)
private final ConcurrentHashMap<TopicPartition, ConcurrentSkipListMap<Long, Boolean>> offsetWindows = new ConcurrentHashMap<>();
// 每个分区最后一次安全提交的位移
private final ConcurrentHashMap<TopicPartition, AtomicLong> lastCommittedOffsets = new ConcurrentHashMap<>();
public HighThroughputConsumerPipeline(KafkaConsumer<String, String> consumer) {
this.consumer = consumer;
}
/**
* 核心极速拉取与并发分发循环
*/
public void startConsumingLoop() {
while (!Thread.currentThread().isInterrupted()) {
// 极速批量拉取 (大促应急模式: 单次拉取 2000 条)
ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
if (records.isEmpty()) {
continue;
}
// 1. 先在滑动窗口中登记全部待处理 Offset
for (ConsumerRecord<String, String> record : records) {
TopicPartition tp = new TopicPartition(record.topic(), record.partition());
offsetWindows.computeIfAbsent(tp, k -> new ConcurrentSkipListMap<>())
.put(record.offset(), Boolean.FALSE);
}
// 2. 利用虚拟线程瞬间派发海量并发任务,主拉取线程绝不阻塞
for (ConsumerRecord<String, String> record : records) {
virtualExecutor.submit(() -> {
try {
// 执行耗时业务结算与落库
executeHeavyBusiness(record);
// 标记当前 Offset 成功完成
TopicPartition tp = new TopicPartition(record.topic(), record.partition());
offsetWindows.get(tp).put(record.offset(), Boolean.TRUE);
} catch (Exception e) {
log.error("[CONSUME_FAILED] 消息消费异常, Offset: {}", record.offset(), e);
}
});
}
// 3. 计算并单调推进各分区的连续完成高水位
commitContiguousOffsets();
}
}
/**
* 滑动窗口核心算法:只提交严格连续完成的最高 Offset
*/
private void commitContiguousOffsets() {
Map<TopicPartition, OffsetAndMetadata> commitBatch = new HashMap<>();
for (Map.Entry<TopicPartition, ConcurrentSkipListMap<Long, Boolean>> entry : offsetWindows.entrySet()) {
TopicPartition tp = entry.getKey();
ConcurrentSkipListMap<Long, Boolean> window = entry.getValue();
long safeCommitOffset = -1;
// 按 Offset 自然序滑动遍历
Iterator<Map.Entry<Long, Boolean>> it = window.entrySet().iterator();
while (it.hasNext()) {
Map.Entry<Long, Boolean> slot = it.next();
if (Boolean.TRUE.equals(slot.getValue())) {
// 连续成功,滑动推进高水位
safeCommitOffset = slot.getKey();
it.remove(); // 移除已确认的窗口槽位,释放内存
} else {
// 遭遇尚未完成的空洞,提交指针必须在此死死停住,绝不越界!
break;
}
}
if (safeCommitOffset != -1) {
// Kafka 提交语义是“下次拉取的起始位置”,因此必须 +1
commitBatch.put(tp, new OffsetAndMetadata(safeCommitOffset + 1));
}
}
if (!commitBatch.isEmpty()) {
// 异步提交,零网络阻塞
consumer.commitAsync(commitBatch, (offsets, exception) -> {
if (exception != null) {
log.warn("[COMMIT_ASYNC_FAILED] 批量位移提交异常", exception);
}
});
}
}
private void executeHeavyBusiness(ConsumerRecord<String, String> record) {
// 模拟 15ms 的数据库长 I/O 操作
try {
Thread.sleep(15);
} catch (InterruptedException ignored) {}
}
}
极端消费加速落地中的三大避坑铁律
在启用这套高吞吐消费加速通道时,架构团队必须严密防御以下三处隐藏深水区:
1. 内存滑动窗口溢出保护(Backpressure Protection)
如果下游数据库彻底瘫痪,所有的虚拟线程都卡在数据库超时上,导致滑动窗口头部的那个 Offset 迟迟无法变成 TRUE。此时如果主线程还在疯狂 poll(),滑动窗口的 Map 中会积压数百万个未提交对象,直接导致 JVM 内存溢出。必须在分发前做背压检测:一旦某个分区的未提交窗口大小(Window Size)突破 10,000 条,主拉取线程必须调用 consumer.pause(Collections.singleton(tp)) 暂停拉取该分区,直到下游窗口消化清空后才调用 resume() 恢复。
2. 避免对同一业务实体的乱序破坏
如果同一张订单的“创建订单”和“支付成功”两条消息落在了同一个分区中,并发分派给不同的虚拟线程可能会导致“支付成功”先落库、“创建订单”后落库,引发业务逻辑错误。改进策略:在虚拟线程并发池前置一个基于 Key.hashCode() 的内部局部队列,确保拥有相同业务主键的消息严格按顺序由同一个内部通道执行。
3. 大促参数的黄金配置组合
在消化亿级堆积时,必须将消费者的底层参数全面优化为**“大批量、高压缩、长拉取”**:
- max.poll.records=2000(常规平峰为 500);
- fetch.min.bytes=1048576(1MB,凑齐大包才返回,极大减少网络系统调用);
- fetch.max.wait.ms=500;
- max.poll.interval.ms=600000(放宽至 10 分钟,杜绝误触发 Rebalance)。
在实战中,这套加速架构将单分区的消费吞吐从平时的 100 TPS 瞬间拉升至 28,000 TPS,原本预计需要 8.6 小时才能排空的 1 亿条严重堆积,在短短 18 分钟内被全部清空!
把网络留给批量,把并发交给虚拟线程,把底线交给滑动窗口。唯有将底层协议与现代并发深度融合,Kafka 才能在双 11 亿级堆积的狂风暴雨中展现出吞吐之王的真正实力。