Ciallo(∠・ω< )⌒☆
| 🔤 C 语言 | 进入专栏 → |
| 🧱 数据结构 | 进入专栏 → |
| 🔧 C++ | 进入专栏 → |
| 🐍 Python | 进入专栏 → |
| 🔌 STM32 | 进入专栏 → |
| 🐧 Linux | 进入专栏 → |
🏠 博客主页:暖焰核心 📦 作者仓库:github | gitee
文章目录
- 引言
-
- 一、 冯诺依曼体系结构
- 二、 操作系统与「管理」
- 三、 进程与 PCB
-
- 3.1 进程是什么
- 3.2 描述进程:PCB 与 task_struct
- 3.3 组织进程:双链表与 container_of
- 四、 看见进程
- 五、 fork 与写时拷贝
- 六、 进程状态
-
- 6.1 源码里的状态表
- 6.2 逐个状态
- 6.3 状态在队列之间流动
- 6.4 实测
- 七、 僵尸进程
- 八、 孤儿进程
引言
在服务器上敲下 ./a.out,回车,程序跑起来了
这个文件之前一直躺在磁盘上,它不会自己动。从磁盘上的静态文件,到占着 CPU 在跑的东西,中间隔着一个绕不开的环节
更奇怪的是,同一个 a.out 可以同时在三个终端里跑三份,各自有各自的变量和输出,谁也不知道谁存在。磁盘上明明只有一份文件,内存里却站着三份互不相干的执行流。操作系统是怎么做到的
一、 冯诺依曼体系结构
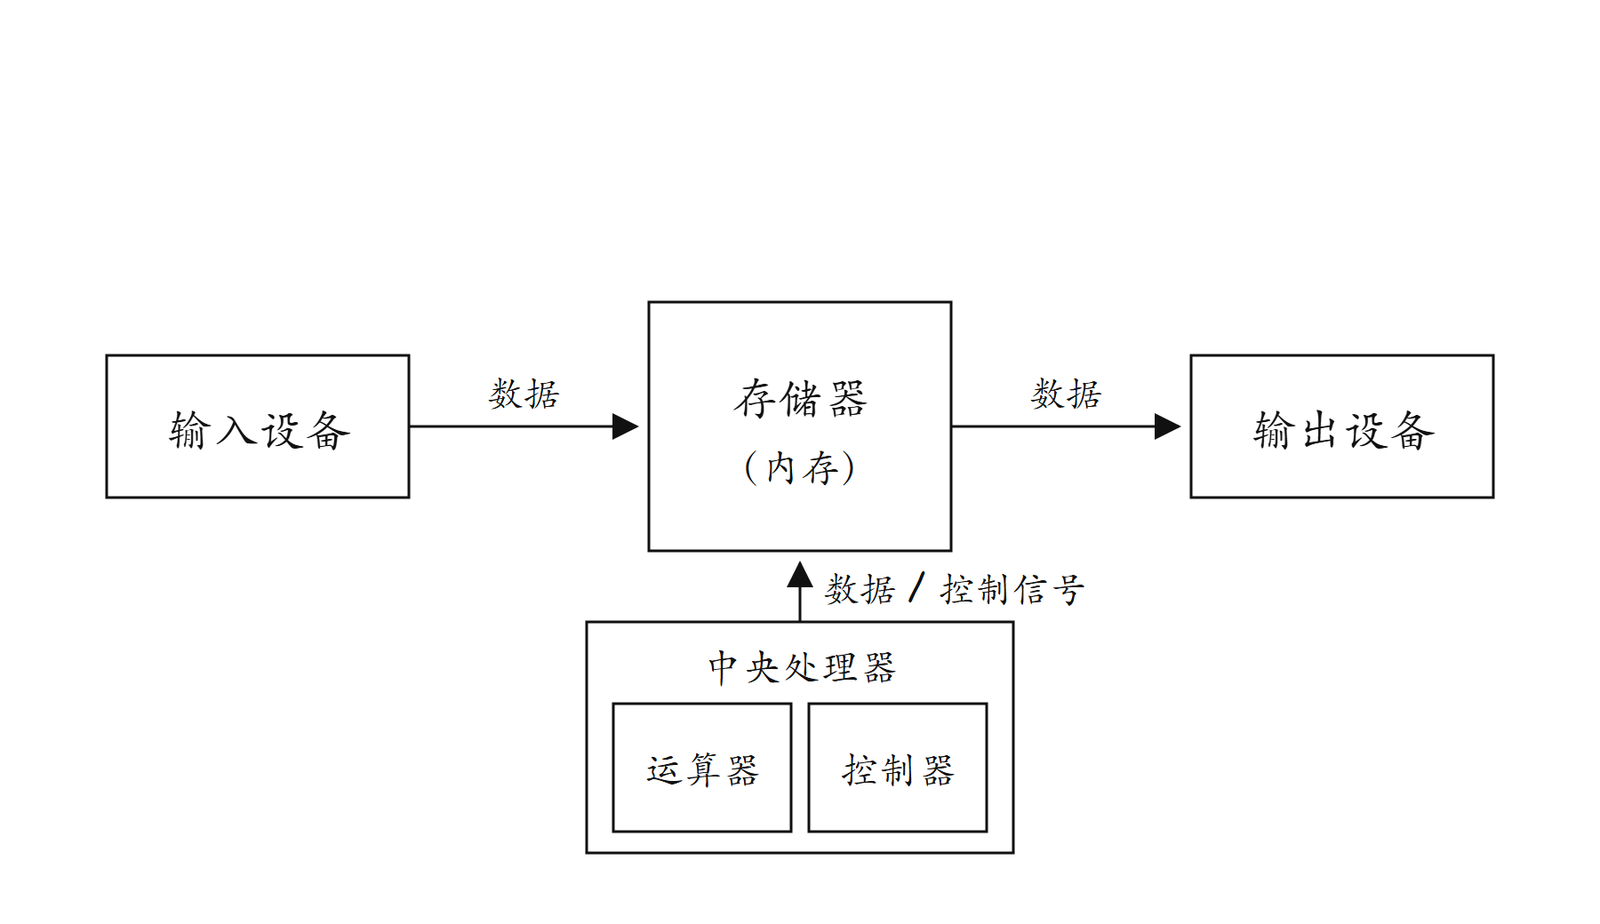
先看计算机由什么组成。运算器和控制器合起来是 CPU,再加上存储器、输入设备、输出设备,就是冯诺依曼体系里的五大部分。笔记本、服务器,绝大多数都遵守这套结构
| 输入设备 | 键盘、鼠标、扫描仪、网卡、磁盘 |
| 输出设备 | 显示器、打印机、网卡、磁盘 |
| 存储器 | 内存 |
| 运算器 | 算术运算与逻辑运算 |
| 控制器 | 取指令、译码、发出控制信号 |
这五部分之间有一条硬规矩:CPU 只能对内存读写,不能直接访问外设;外设要输入输出数据,也只能写进内存或者从内存里读。一句话,所有设备都只能直接和内存打交道
现代 CPU 把外设寄存器也映射进地址空间,用访存指令就能碰到它们,那是地址空间层面的机制。冯诺依曼模型本身的数据通路只有一条:过内存
这条规矩解释了两件事
一是程序为什么必须先加载到内存才能跑。程序躺在磁盘上,磁盘是外设,CPU 读不到它。要执行,就得先把代码和数据搬进内存,CPU 再从内存里取指令、取数据
二是 printf 到底在干什么。它最终是把数据写到了显示器对应的那块内存上,再由显示设备取走。严格说,printf 不是「打印到屏幕上」,是「把数据写进内存」
存储这块还有一层结构。CPU 内部有寄存器,外面依次是 L1、L2、L3 缓存,再往下才是内存和磁盘。越靠近 CPU 的越快也越贵,容量越小;越往下越慢越便宜,容量越大。整个层次是速度和成本折中的结果
这里的存储器特指内存,不是磁盘。不考虑缓存时,CPU 能且只能对内存进行读写
二、 操作系统与「管理」
进程是操作系统管的。操作系统不是一个程序,是一批程序的集合,笼统分两层:内核和内核之外的程序。内核负责进程管理、内存管理、文件管理、驱动管理;外面那层是函数库、shell 之类的程序
设计操作系统有两个方向的目的。对下,它和硬件打交道,管理所有软硬件资源;对上,它给应用程序提供一个能跑起来的环境
它的定位用一句话说,就是一款纯正的「搞管理」的软件
什么叫管理?拿学校举例。校长管几千个学生,不可能天天盯着每个人。他维护一张表:姓名、性别、年龄、各科成绩、班级。要查谁、要评奖、要统计,都是对这张表做增删查改。辅导员负责执行,校长负责决策。校长真正管理的,是这张表
换成程序的说法,管理的动作只有两步:
整个「管理」在代码层面就是「对数据结构的增删查改」
再说系统调用。操作系统对外表现为一个整体,但不会把内部实现直接暴露给用户。它开几个固定的窗口,用户程序通过窗口请求服务,这些窗口就是系统调用
可以想成银行。银行内部有金库、有账本、有各种流程,普通客户进不去;客户只能到柜台,递单子、说需求,柜员在里面办。系统调用就是那个柜台
系统调用本身比较基础,直接用起来门槛高。于是有人在上面包一层,形成库函数。printf 就是库函数,它底层最终会落到 write 这样的系统调用上。库函数是封装,系统调用是入口
操作系统要管进程,用的还是那两步:先把进程描述出来,再把进程组织起来
三、 进程与 PCB
3.1 进程是什么
同一个词,三个角度有三种说法
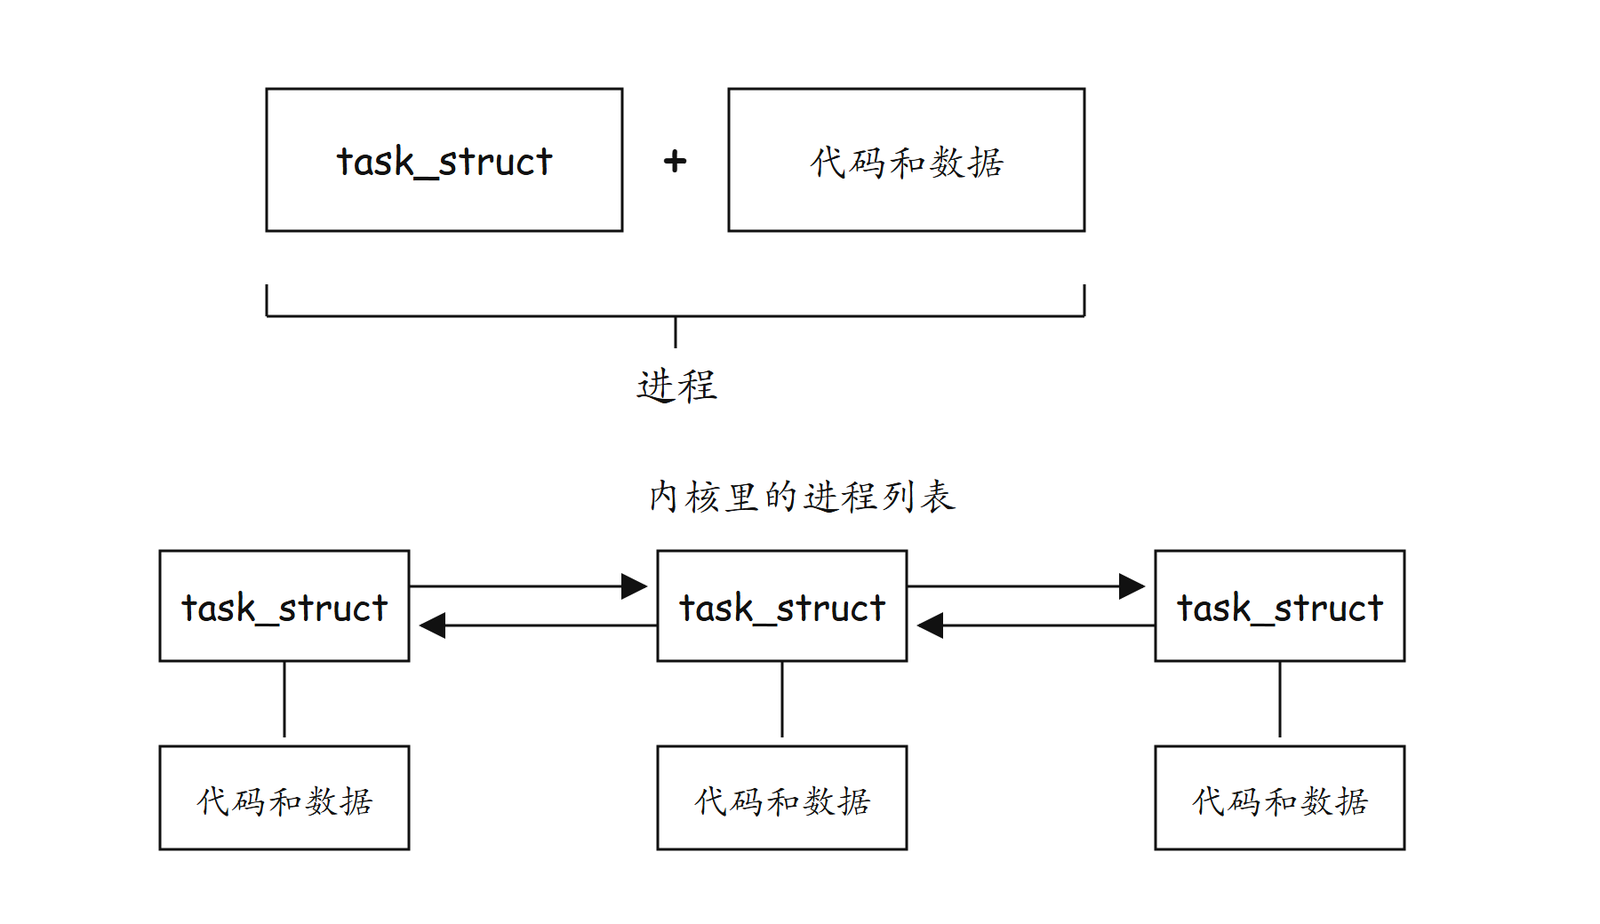
一种常见的说法是:进程是程序的一个执行实例,是正在执行的程序。从内核的角度看:进程是担当分配系统资源(CPU 时间、内存)的实体。现在的理解更直白:进程 = 内核数据结构 + 自己的程序代码和数据
第三种说法最有用。它把进程拆成两半,一半是内核里描述它的结构体,一半是它自己真正在跑的代码和数据
程序不等于进程。程序是磁盘上的静态文件,进程是它跑起来之后的实例。磁盘上只有一份文件,内存里可以同时站着好几份进程,各自有各自的变量和状态
3.2 描述进程:PCB 与 task_struct
内核用一块数据结构装下进程的全部属性,这块东西叫进程控制块,PCB(Process Control Block)。Linux 下的 PCB 是 task_struct
task_struct 是内核里定义的结构体类型,会被装进内存,里面装着进程的各种信息。字段很多,按用途可以归成几类:
| 标示符 | 进程的唯一标识,用来和其他进程区分,也就是 PID |
| 状态 | 任务状态、退出代码、退出信号 |
| 优先级 | 相对其他进程的优先级 |
| 程序计数器 | 下一条要执行的指令地址 |
| 内存指针 | 代码、数据、共享内存块的指针 |
| 上下文数据 | 进程运行时 CPU 寄存器里的数据 |
| I/O 状态信息 | 打开的文件、申请的 I/O 设备 |
| 记账信息 | CPU 时间总和、时钟数、时间限制 |
打开内核源码 include/linux/sched.h,task_struct 的头几个字段是这样(省略表示节选):
struct task_struct {
volatile long state;/* -1 unrunnable, 0 runnable, >0 stopped */
void *stack;
atomic_t usage;
unsigned int flags;
unsigned int ptrace;
int prio, static_prio, normal_prio;
unsigned int rt_priority;
struct list_head tasks;
struct mm_struct *mm, *active_mm;
pid_t pid;
pid_t tgid;
/* … */
};
state 是状态,prio 系列是优先级,mm 指向地址空间,pid 是进程号,tasks 是链表节点
3.3 组织进程:双链表与 container_of
一个进程用 task_struct 描述,一堆进程怎么组织?Linux 的答案是双链表。所有运行在系统里的进程,都以 task_struct 双链表的形式挂在核心里
内核链表的写法有点特别。它没有把 next、prev 直接写进 task_struct,而是先定义了一个单独的小结构:
struct list_head {
struct list_head *next, *prev;
};
再把它嵌进 task_struct:
struct task_struct {
/* … */
struct list_head tasks;
/* … */
};
链表里串的是 list_head,不是 task_struct。顺着 next 走,走到的都是一个个 list_head 节点。可我们真正要的是节点所属的那个 task_struct,它比节点大得多
靠偏移量。tasks 在 task_struct 里的位置是固定的,从节点地址减去这个偏移,就得到结构体首地址。内核用 container_of 这个宏完成这件事,原理就是一个指针减法和一次强制类型转换:
#define container_of(ptr, type, member) \\
((type *)((char *)(ptr) – offsetof(type, member)))
offsetof 算的是成员在结构体里的字节偏移。知道节点地址、知道成员偏移,宿主地址就唯一确定了:
结构体首地址 = 节点地址 – offset
struct task_struct
+————————————+
| state prio pid |
| … |
| struct list_head tasks; <——–+— 节点地址
| … |
| mm pid tgid |
+————————————+
链表里串的是 tasks 节点,不是 task_struct
+——–+ +——–+ +——–+
| next |—>| next |—>| next |
| prev |<—| prev |<—| prev |
+——–+ +——–+ +——–+
这套设计的好处是链表节点和业务结构解耦。同一套 list_head 可以嵌进任何结构体,链表的增删查改代码只跟 list_head 打交道,不用为每种结构体重写一遍
创建一个进程,是往这条链表里加节点;进程退出,是从链表里摘节点
四、 看见进程
进程看不见摸不着,内核给它留了几个查看的窗口
第一个是 /proc。这是一个虚拟文件系统,每个进程在 /proc 下有一个以 PID 命名的目录,/proc/1 就是 1 号进程。目录里 status 记状态,cmdline 记命令行,cwd 链到工作目录,exe 链到可执行文件
第二个是 ps 和 top。ps aux 看所有进程,ps -l 看当前终端的详细格式,top 动态刷新。两者格式不同,数据来源都是内核
第三个是系统调用。getpid 取自己的 PID,getppid 取父进程的 PID
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main(void)
{
printf("pid: %d\\n", getpid());
printf("ppid: %d\\n", getppid());
return 0;
}
PID 是进程的唯一编号,PPID 是父进程的编号。用户态进程都是被别的进程创建出来的,只有 1 号不是。顺着 PPID 往上追,能追到一棵进程树
$ ps -o pid,ppid,comm -p $$
PID PPID COMMAND
201105 201104 bash
$ ps -o pid,ppid,comm -p 201104
PID PPID COMMAND
201104 201097 timeout
$ ps -o pid,ppid,comm -p 1
PID PPID COMMAND
1 0 systemd
bash 的父进程是一层外层进程,再往上最终到 1 号 systemd。命令行里敲的每条命令,都是 bash 这个进程创建出来的子进程
/proc 里还能看到两样东西:
$ readlink /proc/201105/cwd /proc/201105/exe
/tmp
/usr/bin/bash
cwd 指向进程当前的工作目录,exe 指向它对应的可执行文件。进程会记住自己从哪个目录启动、跑的是哪个文件
/proc 里的内容不是存在磁盘上的文件,是内核现场拼出来的。读一次,内核现算一次
五、 fork 与写时拷贝
创建进程用 fork
#include <unistd.h>
pid_t fork(void);
man 里的描述只有一句:create a child process。它没有参数,返回情况却有三路:
- 父进程里,返回新子进程的 PID
- 子进程里,返回 0
- 失败时,父进程返回 -1,不创建子进程
一个函数返回两次,平时写代码想都不敢想。第一次见 fork 的时候,我卡住的就是这里
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main(void)
{
pid_t id = fork();
if (id < 0) {
perror("fork");
return 1;
} else if (id == 0) {
printf("child : pid=%d, ppid=%d\\n", getpid(), getppid());
} else {
printf("parent: pid=%d, ppid=%d\\n", getpid(), getppid());
}
return 0;
}
这段代码里有三个绕不开的问题:
答案都在 fork 在内核里做的事上
fork 被调用时,内核先申请一个新的 PCB,把父进程的 PCB 拷贝一份给子进程,然后把子 PCB 挂进进程列表,甚至直接放进调度队列。到这一步,系统里已经有两个执行流了,子进程甚至可能已经被调度过
返回值不是「返回一次给两个人」,而是两个执行流各自从 fork 调用点继续往下走,各自在自己的地址空间里写了一次返回值。父进程那边写的是子进程 PID,子进程那边写的是 0。所谓「返回两次」,是「两个执行流各返回一次」
那为什么变量 id 能同时是 0 和大于 0?因为父子进程的数据是各自一份的。fork 之后,父子共享同一份代码,但数据在写的时候会分开:谁先写,操作系统就给谁拷贝一份新的数据页,这叫写时拷贝(Copy-On-Write)。好处很直接,fork 的时候不用立刻把父进程几个 G 的内存全拷一遍,父子先共享只读,真正写了才拷那一页。子进程如果只是 exec 换掉自己,那些拷贝根本不会发生
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
int g_val = 100;
int main(void)
{
printf("parent before fork : pid=%d ppid=%d g_val=%d &g_val=%p\\n",
getpid(), getppid(), g_val, (void *)&g_val);
fflush(stdout);
pid_t id = fork();
if (id == 0) {
g_val = 200;
printf("child after write: pid=%d ppid=%d g_val=%d &g_val=%p\\n",
getpid(), getppid(), g_val, (void *)&g_val);
fflush(stdout);
_exit(0);
} else if (id > 0) {
sleep(1);
printf("parent after child: pid=%d ppid=%d g_val=%d &g_val=%p\\n",
getpid(), getppid(), g_val, (void *)&g_val);
}
return 0;
}
输出:
parent before fork : pid=188822 ppid=188798 g_val=100 &g_val=0x5a17955d7010
child after write: pid=188823 ppid=188822 g_val=200 &g_val=0x5a17955d7010
parent after child: pid=188822 ppid=188798 g_val=100 &g_val=0x5a17955d7010
子进程把 g_val 改成 200,父进程读到的还是 100,可两边打印出来的地址一模一样。地址相同、内容不同,说明这个地址不是物理地址,是虚拟地址。每个进程有自己的地址空间,同一个虚拟地址在父子两个进程里映射到不同的物理内存。物理地址用户看不到,由操作系统统一管理
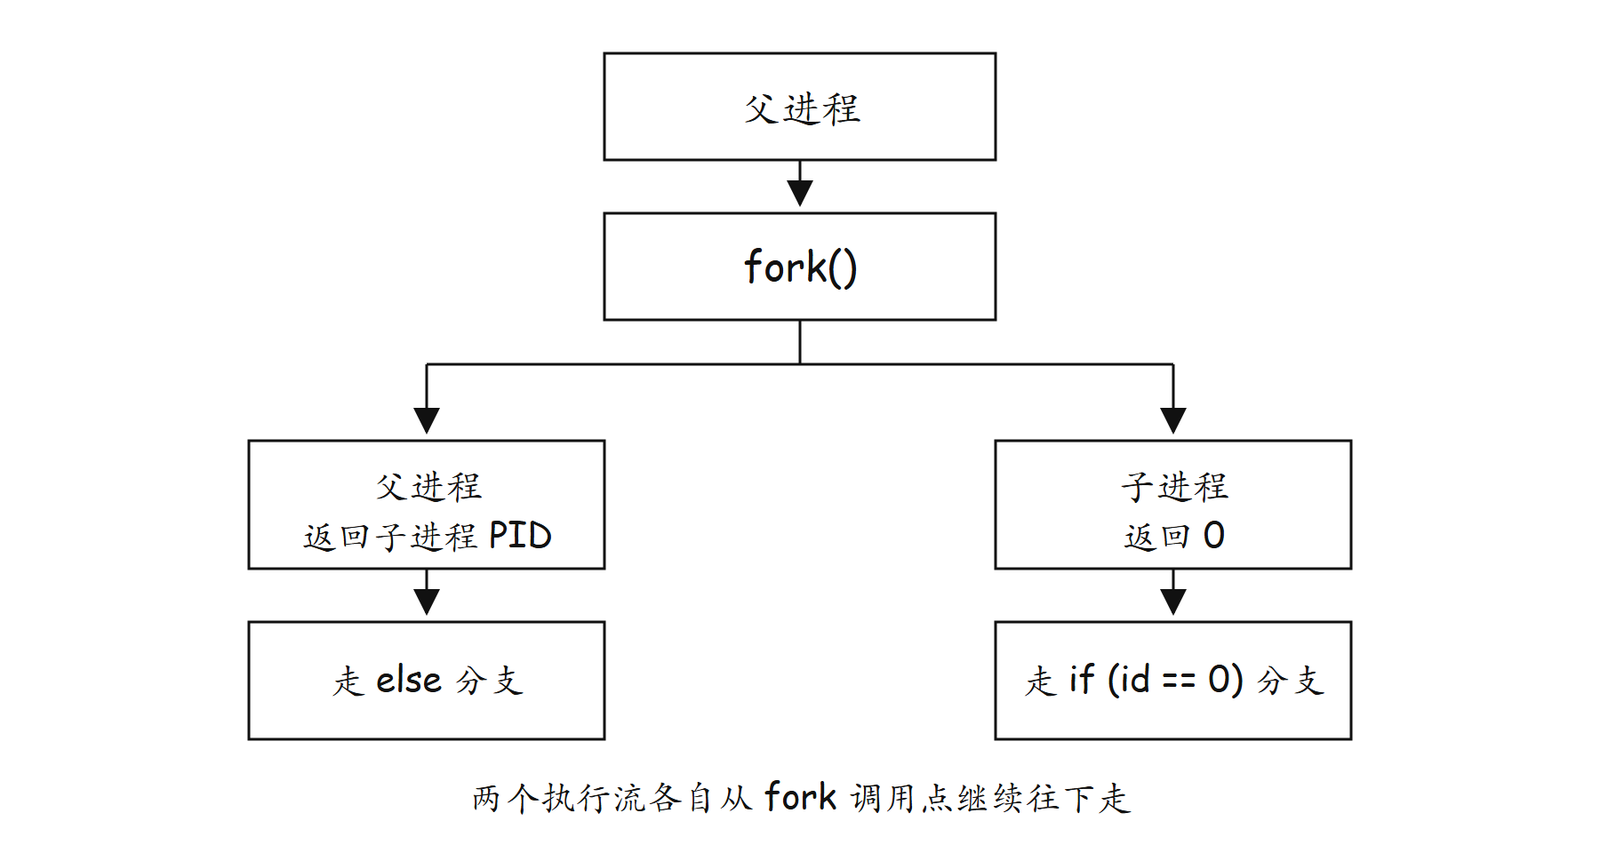
fork 之后通常要用 if 分流,让父子走不同的代码。这也是 shell 能执行命令的基础:shell 自己 fork 一个子进程,子进程 exec 成要跑的程序,父进程等它结束
六、 进程状态
6.1 源码里的状态表
进程有几种状态,内核里有一张表:
/*
* The task state array is a strange "bitmap" of
* reasons to sleep. Thus "running" is zero, and
* you can test for combinations of others with
* simple bit tests.
*/
static const char *task_state_array[] = {
"R (running)",/* 0 */
"S (sleeping)",/* 1 */
"D (disk sleep)",/* 2 */
"T (stopped)",/* 4 */
"T (tracing stop)",/* 8 */
"Z (zombie)",/* 16 */
"X (dead)"/* 32 */
};
注释说得很清楚:这张表是一个「奇怪」的位图,记录的是「睡眠的理由」。运行是 0,其他状态各占一位,可以用简单的位测试判断组合
数值是 0、1、2、4、8、16、32,从 1 之后每次翻倍。这不是随手排的,是位标志:每一位代表一个「睡眠的理由」,组合起来就是一个掩码,判断某个进程处于哪类等待时,按位与一下就行
6.2 逐个状态
| R running | 运行中,或者在运行队列里等着被调度。看到 R 不代表它此刻正占着 CPU |
| S sleeping | 可中断睡眠,等某个事件完成,能被信号唤醒 |
| D disk sleep | 不可中断睡眠,通常在等 I/O。这个状态连 kill -9 都杀不掉,要等 I/O 结束 |
| T stopped | 停止,收到 SIGSTOP 后进入,SIGCONT 恢复 |
| T tracing stop | 被 ptrace 追踪,ptrace 是调试器控制进程的系统调用,断点就是它把进程按在这里 |
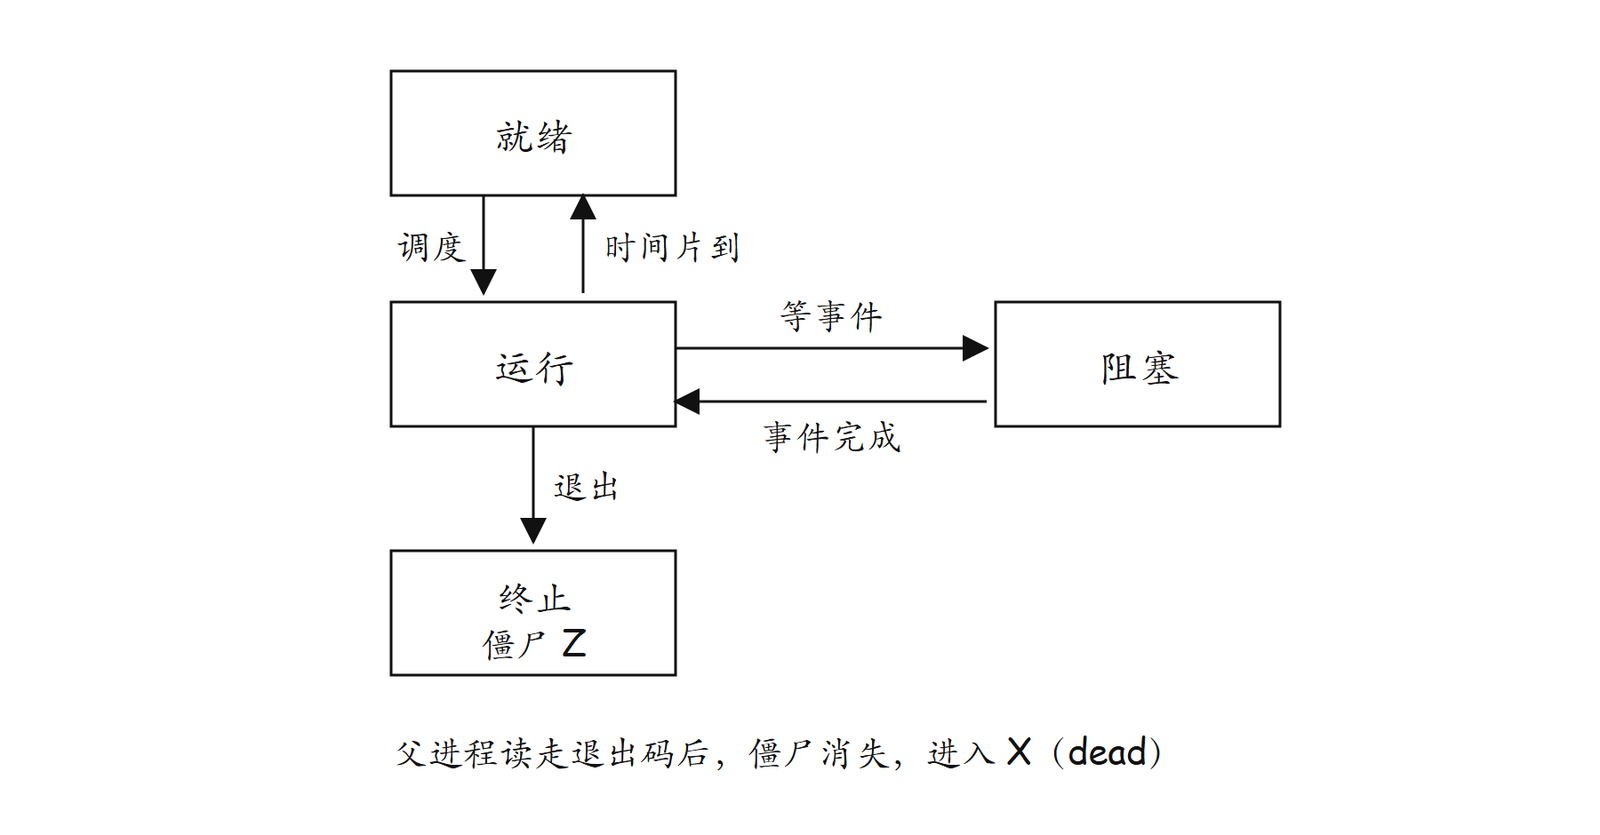
| Z zombie | 僵尸,进程已退出,但退出码还没被父进程读走 |
| X dead | 死亡,只是一个返回状态,任务列表里看不到 |
ps 的 STAT 列显示这些字母,还会带修饰符:
| + | 前台进程 |
| s | 会话首进程 |
| l | 多线程 |
| < | 高优先级 |
| N | 低优先级 |
6.3 状态在队列之间流动
常见的说法把进程分成就绪、运行、阻塞三种。放到 Linux 里,这三种对应的是进程挂在不同队列上
运行队列里的进程是 R,这个 R 同时覆盖两种情况:真正占着 CPU 的,和排在队列里等 CPU 的。等设备、等事件的进程挂在阻塞队列上,是 S 或 D。状态变化,本质是进程节点从一个队列挪到另一个队列
6.4 实测
用一个 SIGSTOP 停掉 201116 号进程:
$ kill -STOP 201116
$ ps -o pid,stat,comm -p 201116
PID STAT COMMAND
201116 T sleep
$ grep '^State' /proc/201116/status
State:T (stopped)
dd 往磁盘写 200 MB,写盘期间采样同一个进程:
sample 1: pid=201146 stat=R
sample 2: pid=201146 stat=R
sample 3: pid=201146 stat=R
这次没碰到 D。D 只在真正卡在 I/O 上的那一瞬出现,采样间隔稍微错开就抓不到。R 说明它正在等 CPU 或者正在跑,还没进入不可中断的等待
七、 僵尸进程
子进程退出,父进程没有读走它的退出码,子进程就变成僵尸,状态 Z
为什么退出码不能随进程一起消失?因为父进程得知道子进程干得怎么样:正常结束还是异常退出,退出码是多少。这些信息要留在 task_struct 里等父进程来取。父进程一直不取,task_struct 就一直留着
僵尸进程占的不是普通数据内存,是内核里那个 task_struct。一个两个无所谓,父进程不停创建子进程又不停不回收,task_struct 越堆越多,就是内存泄漏
一个最简的僵尸:
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
int main(void)
{
pid_t id = fork();
if (id == 0) {
exit(0); /* 子进程立刻退出 */
}
sleep(8); /* 父进程不回收,睡 8 秒 */
return 0;
}
用 ps 看 201127 和它的子进程 201129:
$ ps -o pid,ppid,stat,comm -p 201127,201129
PID PPID STAT COMMAND
201127 201105 S z
201129 201127 Z z
$ ps -o pid,ppid,stat,cmd -p 201129
PID PPID STAT CMD
201129 201127 Z [z] <defunct>
子进程的 STAT 是 Z,命令名被方括号包起来,后面还跟着 <defunct>。父进程是 S,活得好好的
父进程把退出码读走,僵尸才会消失
八、 孤儿进程
反过来,父进程先退出,子进程还在跑,子进程就成了孤儿
孤儿进程会被 1 号进程领养。1 号进程是 init 或者 systemd,系统启动后第一个用户态进程。领养之后,子进程的 PPID 变成 1,将来它退出时由 1 号进程负责回收
不领养不行。没有父进程,退出码没人读,就又多一个僵尸。总得有个兜底的
父进程还在时,子进程 198103 的 PPID 指向父进程 198101:
$ ps -o pid,ppid,stat,comm -C orphan2
PID PPID STAT COMMAND
198101 198092 S orphan2
198103 198101 S orphan2
父进程退出之后,同一个子进程的 PPID 变成了 1:
$ ps -o pid,ppid,stat,comm -C orphan2
PID PPID STAT COMMAND
198103 1 S orphan2
$ ps -o pid,comm -p 1
PID COMMAND
1 systemd
子进程的父进程从 198101 换成了 1 号 systemd
孤儿和僵尸不是一回事:
| 进程状态 | 已经退出,Z | 还活着,S 或 R |
| 成因 | 子进程退出,父进程不回收 | 父进程先退出 |
| 归宿 | 父进程读走退出码后消失 | 被 1 号进程领养 |