/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
Hive作为构建在Hadoop之上的数据仓库工具,其存储格式和压缩方式选择,直接影响着查询性能、存储成本和计算效率。本文将带您了解行式存储与列式存储的区别、Hive的存储格式与压缩格式,以及它们在实际应用中的搭配策略。
一、什么是行式存储和列式存储
1. 行式存储 VS 列式存储
- 行式存储:数据按“行”连续存储,每行所有字段集中在一起。例如,传统关系型数据库(如 MySQL)采用行式存储,适用于事务处理(OLTP)。
- 列式存储:数据按“列”拆分存储,相同列的数据连续存放。例如,数据仓库(如Hive)中的列式存储,适用于分析型查询(OLAP)。

2. 行列存储优缺点
|
存储方式 |
优点 |
缺点 |
|
行式存储 |
• 单条记录的插入、更新、删除非常高效 (定位到行即可操作) |
• 查询少数字段时需读取整行所有列,I/O 开销大 |
|
列式存储 |
• 查询时只需读取涉及的列,大幅减少 I/O |
• 重建一行数据需跨列读取合并,网络和运算开销大 |
📌 举例讲解:
假设有一张 用户表 (id, name, age, city),行存储逻辑如下:
[1, 张三, 28, 北京] | [2, 李四, 32, 上海] | [3, 王五, 25, 广州]
场景:执行 SELECT * FROM users WHERE id = 2。行存只需定位到第二个数据块,一次性读出整行(1,2,3列全部拿到)。
场景:执行 SELECT AVG(age) FROM users。行存必须把整张表的[1,2,3,4]列全部读进内存,然后只取age列计算,浪费了大量IO读取name和city的数据。
📌 列存存储逻辑如下,同样以上述 用户表 为例:
[1, 2, 3] (id列) | [张三, 李四, 王五] (name列) | [28, 32, 25] (age列) | [北京, 上海, 广州] (city列)
场景:执行 SELECT AVG(age) FROM users。列存只读取 age 列([28, 32, 25])这一个连续的数据块,其余列完全不动。数据量是行存的 1/4,速度自然快。
场景:执行 INSERT INTO users VALUES (4, '赵六', 30, '深圳')。列存需要将 4 追加到id列的末尾,'赵六'追加到name列末尾,30追加到age列末尾… 涉及4个不同的物理文件写入,十分笨重。
二、 Hive 的存储格式
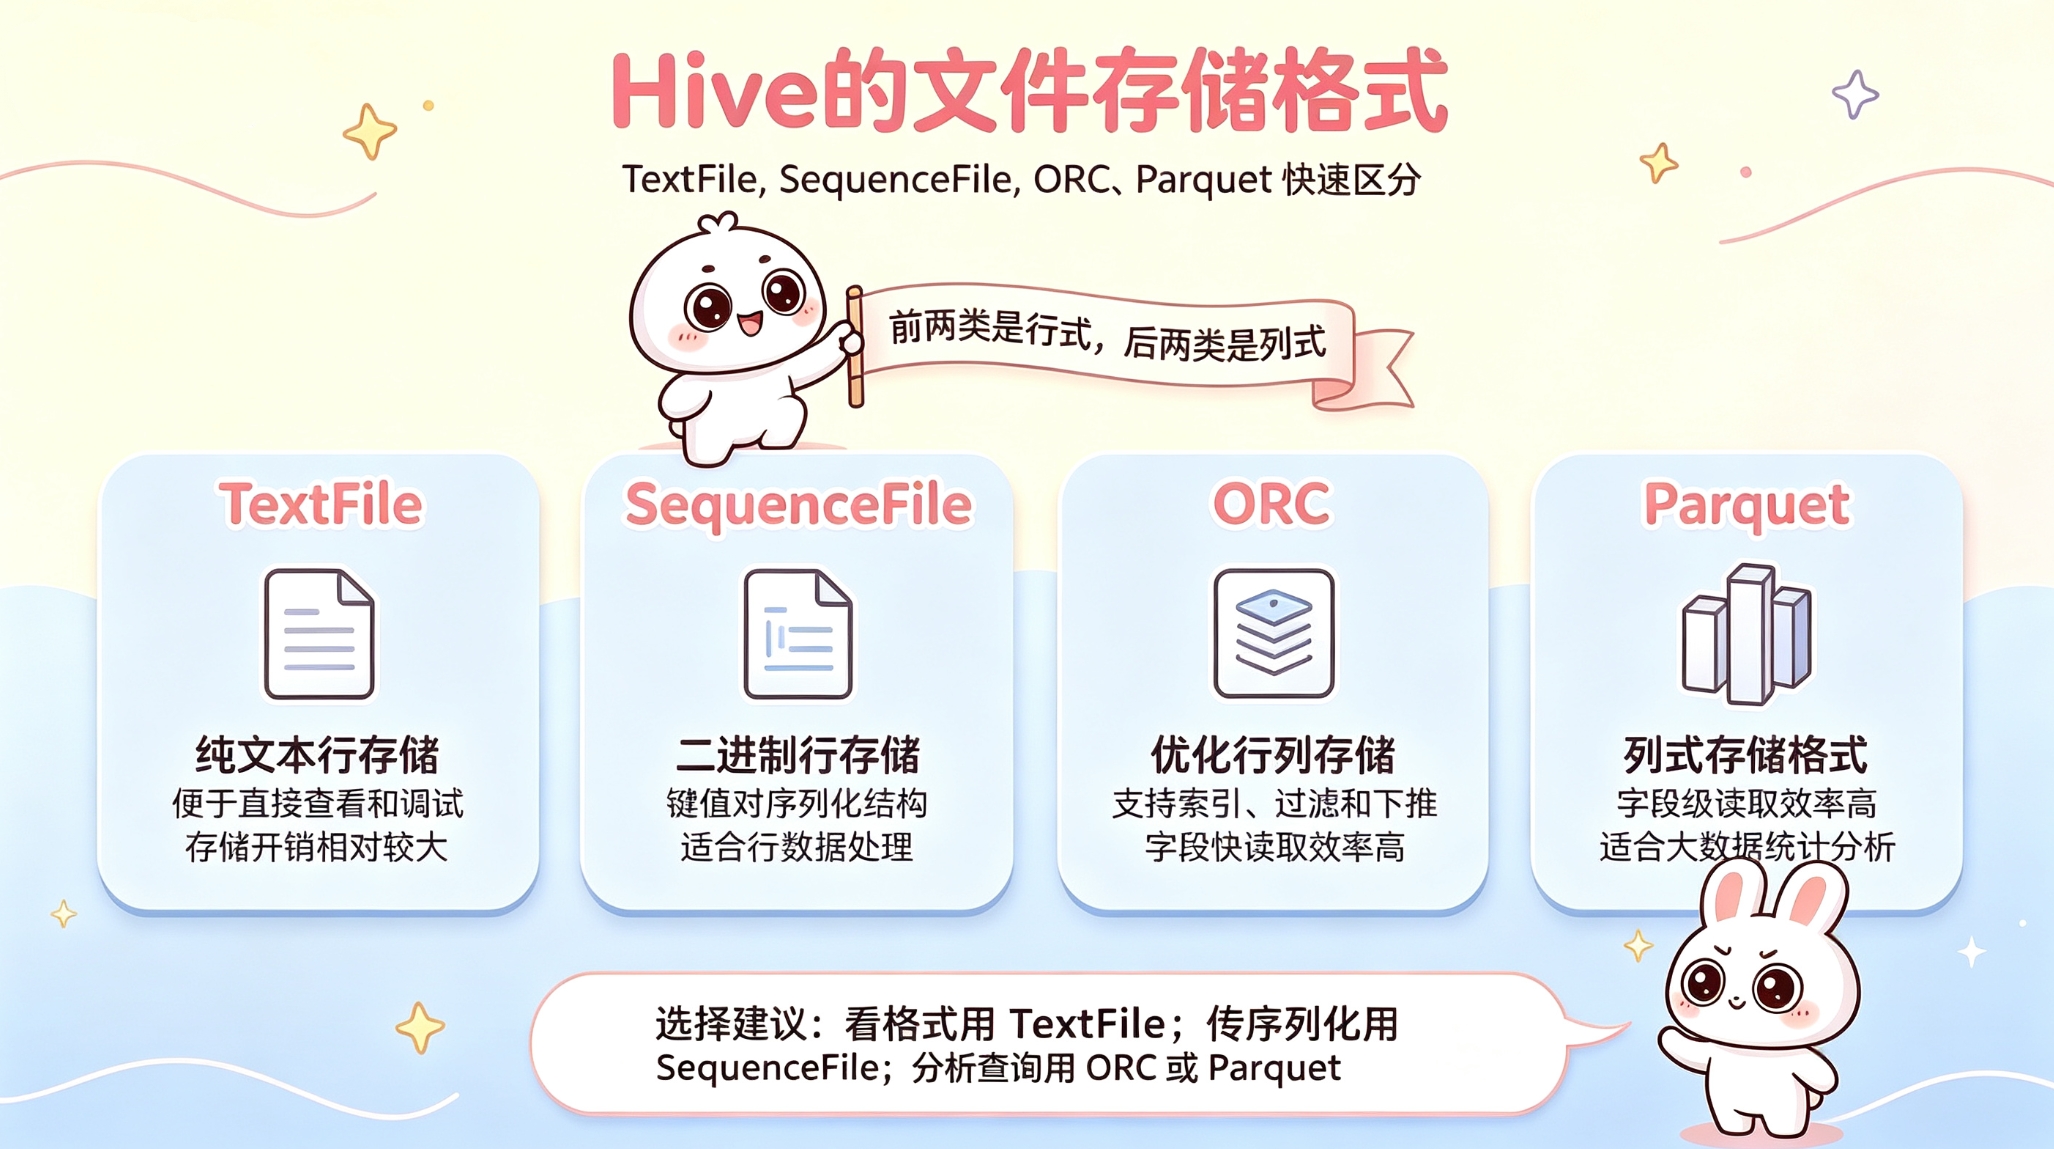
Hive的文件存储格式有多种,主要包括TextFile、SequenceFile、ORC、Parquet、RCFile和Avro。其中常见的 TextFile和SequenceFile是行式存储,ORC和Parquet是列式存储。
1. TextFile(行式存储)
TextFile是Hive的默认存储格式,数据以纯文本形式存储,即 txt 文件,每行代表一条记录。
特点:
- 行式存储,数据不做压缩
- 人类可读,支持自定义分隔符
- 直接load数据不需要走MapReduce
- 磁盘开销大,数据解析开销大
适用场景: 数据交换和临时存储、需要人工查看原始数据的场景、作为数据导入导出时的中转表
2. SequenceFile(行式存储)
SequenceFile是Hadoop API提供的一种二进制文件格式,以键值对的形式序列化到文件中。
特点:
- 行式存储,二进制格式
- 支持压缩(NONE、RECORD、BLOCK三种级别),推荐使用BLOCK压缩
- 可分割(Splittable),适合MapReduce并行处理
适用场景: 目前基本已被淘汰,新项目不推荐使用
3. ORC(列式存储)
ORC是RCFile的改良版本,由Hive社区贡献,专为Hive查询优化而设计。
核心特性:
- 列式存储,数据按行分块、每块按列存储
- 内置轻量级索引(行索引、布隆过滤器、最大值/最小值统计)
- 支持ACID事务操作(插入、更新、删除)
- 支持谓词下推和向量化执行
- 压缩快,查询效率在Hive各格式中最高
文件结构: Stripe(条带)- Column(列块)- Page(页)三层架构
适用场景: 纯Hive数仓的首选格式,适合高压缩率+ Hive查询优化的场景
4. Parquet(列式存储)
Parquet是Apache生态系统中的通用列式存储格式,是 Spark 的默认存储格式。
核心特性:
- 列式存储,以二进制方式存储
- 为复杂嵌套数据结构设计
- 跨平台兼容性好,Hadoop生态系统中大部分工程都支持
三、 Hive 的压缩格式
1. 常用压缩算法对比
|
压缩算法 |
压缩比 |
解压速度 |
是否支持切片 |
适用场景 |
|
Zlib |
高 |
慢 |
❌ 不支持 |
高压缩需求场景 |
|
Gzip |
高 |
慢 |
❌ 不支持 |
存储空间敏感、冷数据 |
|
Snappy |
中等 |
极快 |
取决于存储格式 |
实时查询、热数据分析 |
|
LZO |
中高 |
快 |
✅ 支持 |
大文件处理、需要切片 |
|
BZip2 |
极高 |
极慢 |
✅ 支持 |
归档、不频繁访问数据 |
2. 各算法详解
None:不进行任何压缩,数据以原始大小存储。CPU开销为零,读写速度完全取决于磁盘I/O。由于无压缩,存储空间占用最大。
Zlib:基于DEFLATE算法。ORC格式的默认压缩算法,Parquet不支持。
Gzip:基于DEFLATE算法,通用性好。但压缩/解压速度慢,CPU开销高,不可分割,大文件只能单任务处理。适用于存储空间敏感的冷数据归档、历史数据备份。
Snappy:Google开发,TextFile中不可分割,ORC/Parquet中因格式自身分块而可并行处理。适用于热数据、实时交互查询,是生产环境最主流的压缩选择。
LZO:解压速度快,压缩率和速度介于Gzip和Snappy之间。通过建立索引(.lzo.index)可实现文件分割。适用于需要分割的大文件场景,但热度正逐渐被Snappy取代。
BZip2:压缩比极高,但压缩和解压速度都非常慢,CPU开销极高。支持文件分割。适用于归档存储、极少访问的历史冷数据,实际生产中很少使用。
四、存储格式和压缩方式的搭配问题
存储格式和压缩方式的选择需要综合考虑存储成本、查询性能、CPU开销三者之间的平衡
推荐搭配组合
选择合适的组合需考虑场景特点:
-
- ORC + Snappy:兼顾查询速度和压缩效率,适合实时分析。
- Parquet + Gzip:高压缩比,降低存储成本,但查询稍慢。
-
- TextFile + LZO:写入快,支持数据分片,便于后续处理。
-
- SequenceFile + Bzip2:极致压缩,节省存储,容忍低读写性能。
五、数据存储格式和压缩格式在数仓中的应用
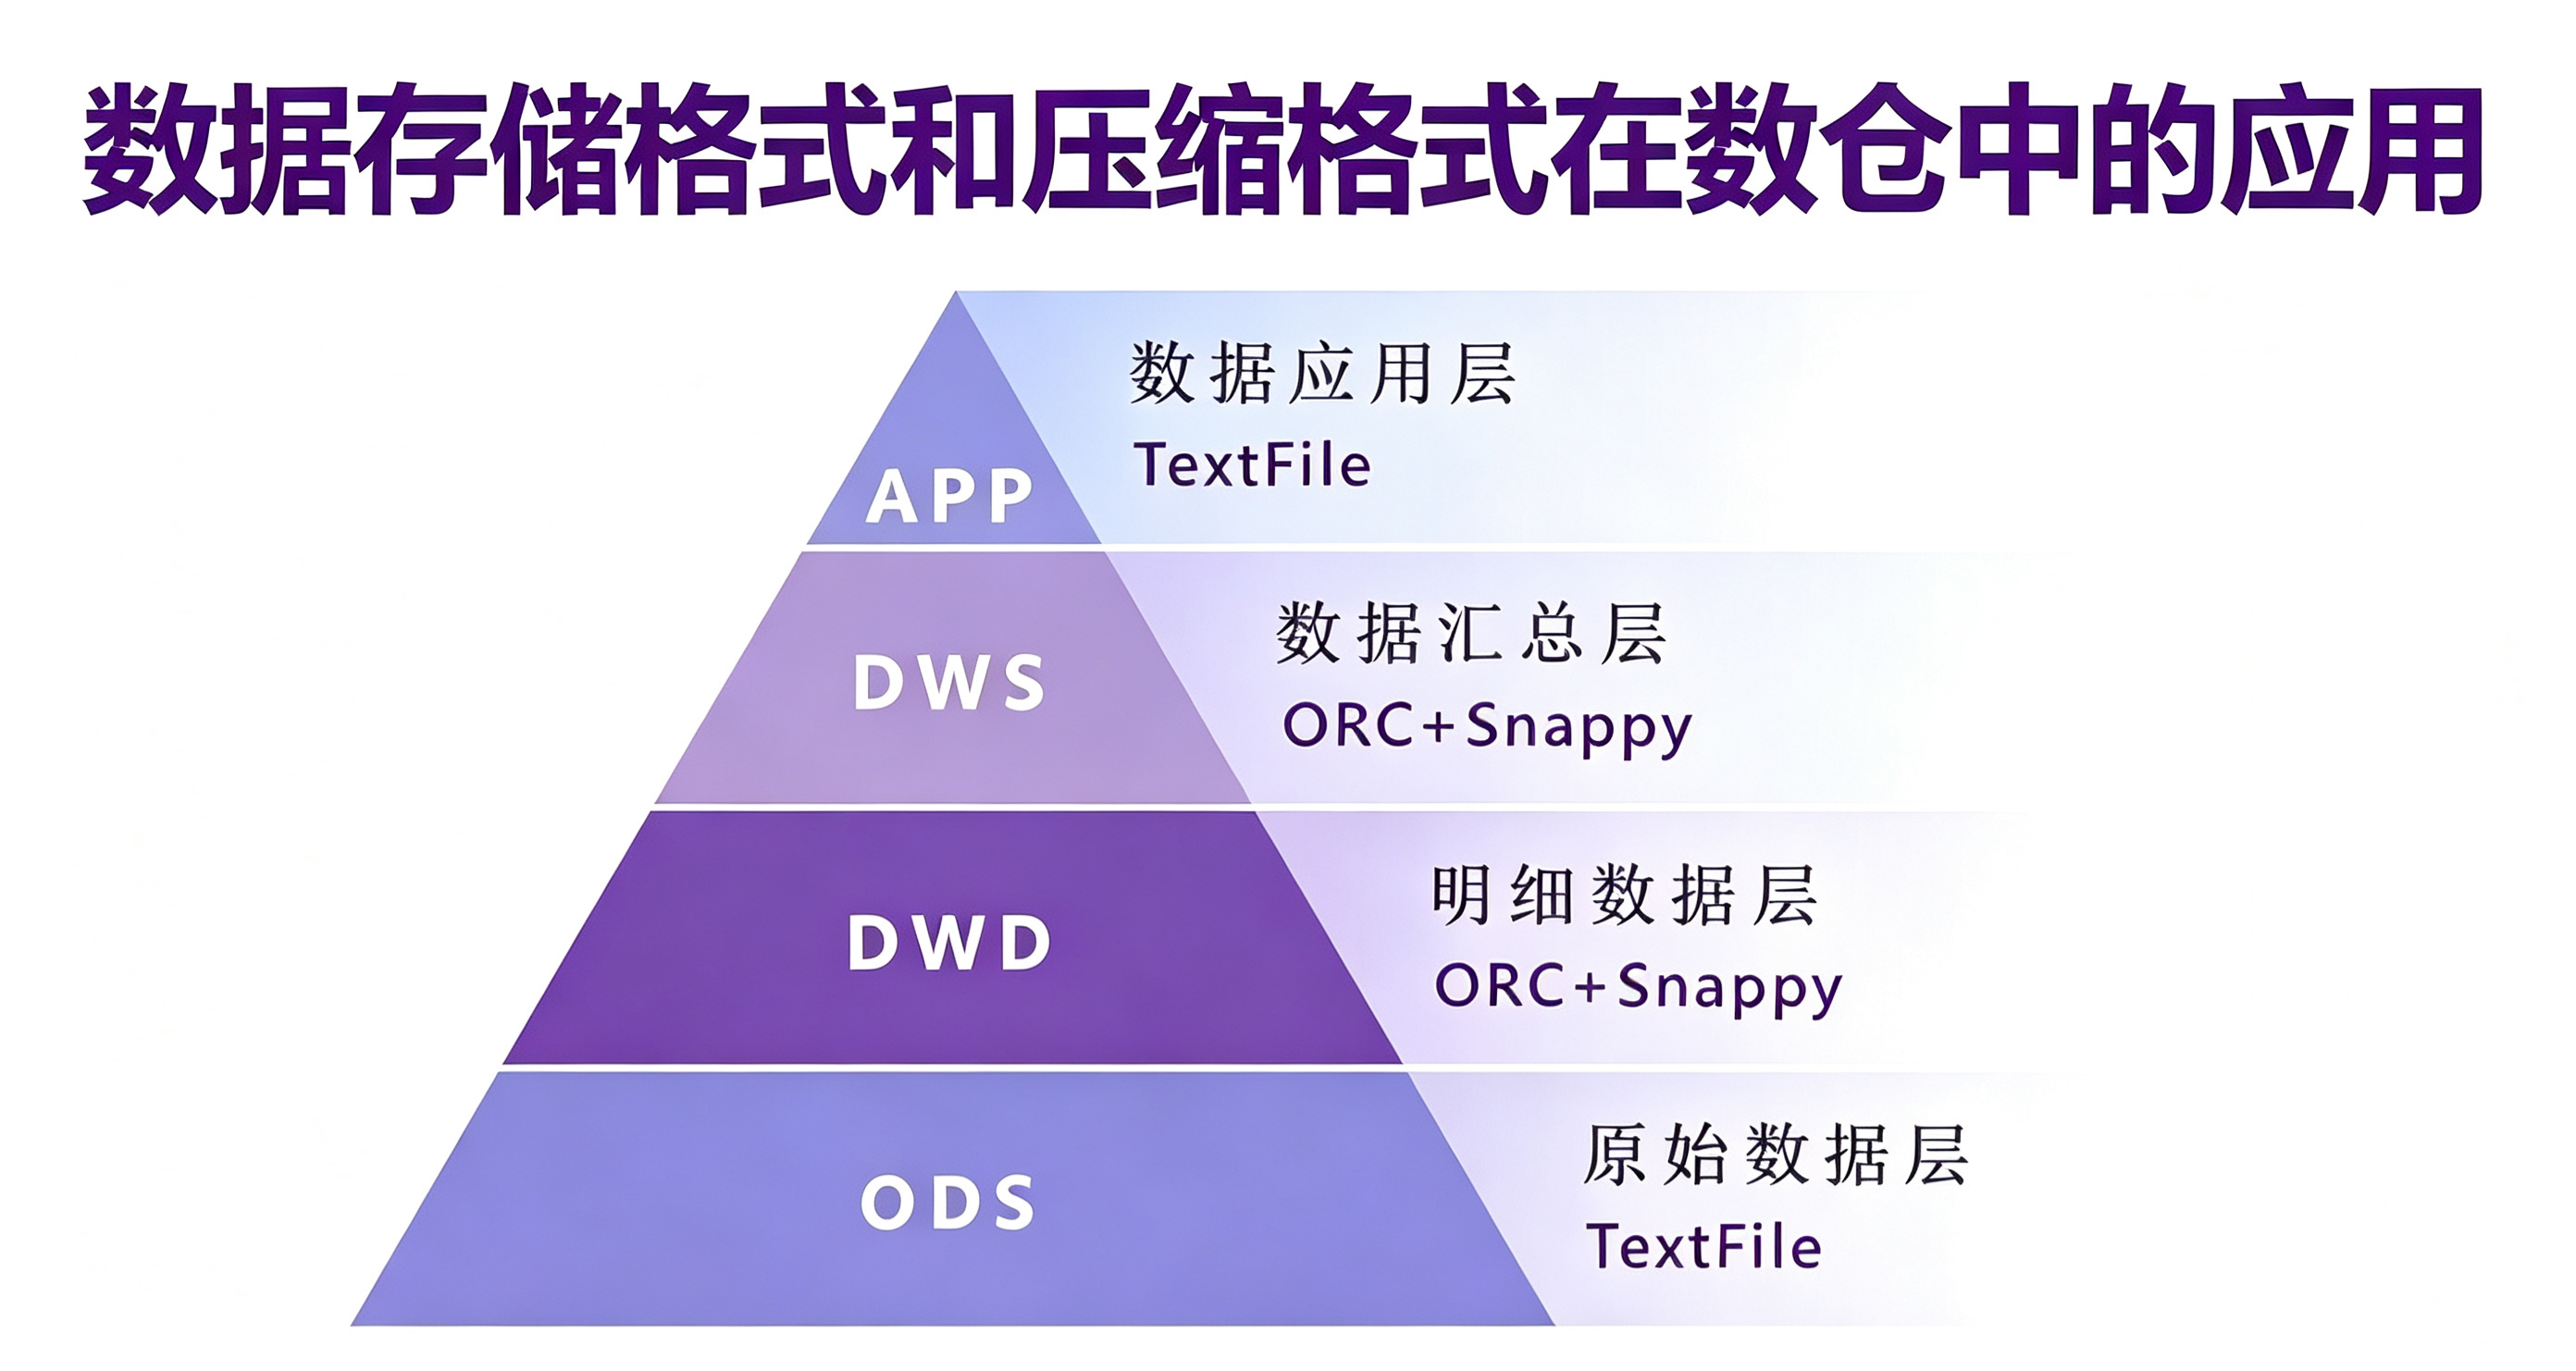
数据仓库通常分层设计,不同层采用不同策略:
- ODS层(原始数据层):多用行存储textfile,因为能够保持数据的原始结构,写入性能较好。一般不采用压缩方式,因为数据体量大,频繁写入操作的解压缩会增加不必要的开销。
- DW层( 数据仓库层 ):推荐"ORC+Snappy"或者"Parquet+Snappy",因为有大量的计算操作,列存储的聚合计算速度快。压缩方式一般用snappy跨平台性能好
- ADS层(报表层):用行存储,数据量少且需要向外写入数据,不需要压缩,加速报表生成和BI分析。
总结
在大数据场景中,行式与列式存储、不同压缩算法的选择并非“非黑即白”,而是基于业务需求(读写频率、查询模式、资源限制)的权衡。理解底层技术的原理,合理搭配存储与压缩格式,能显著提升数据仓库的效率和成本效益。