/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
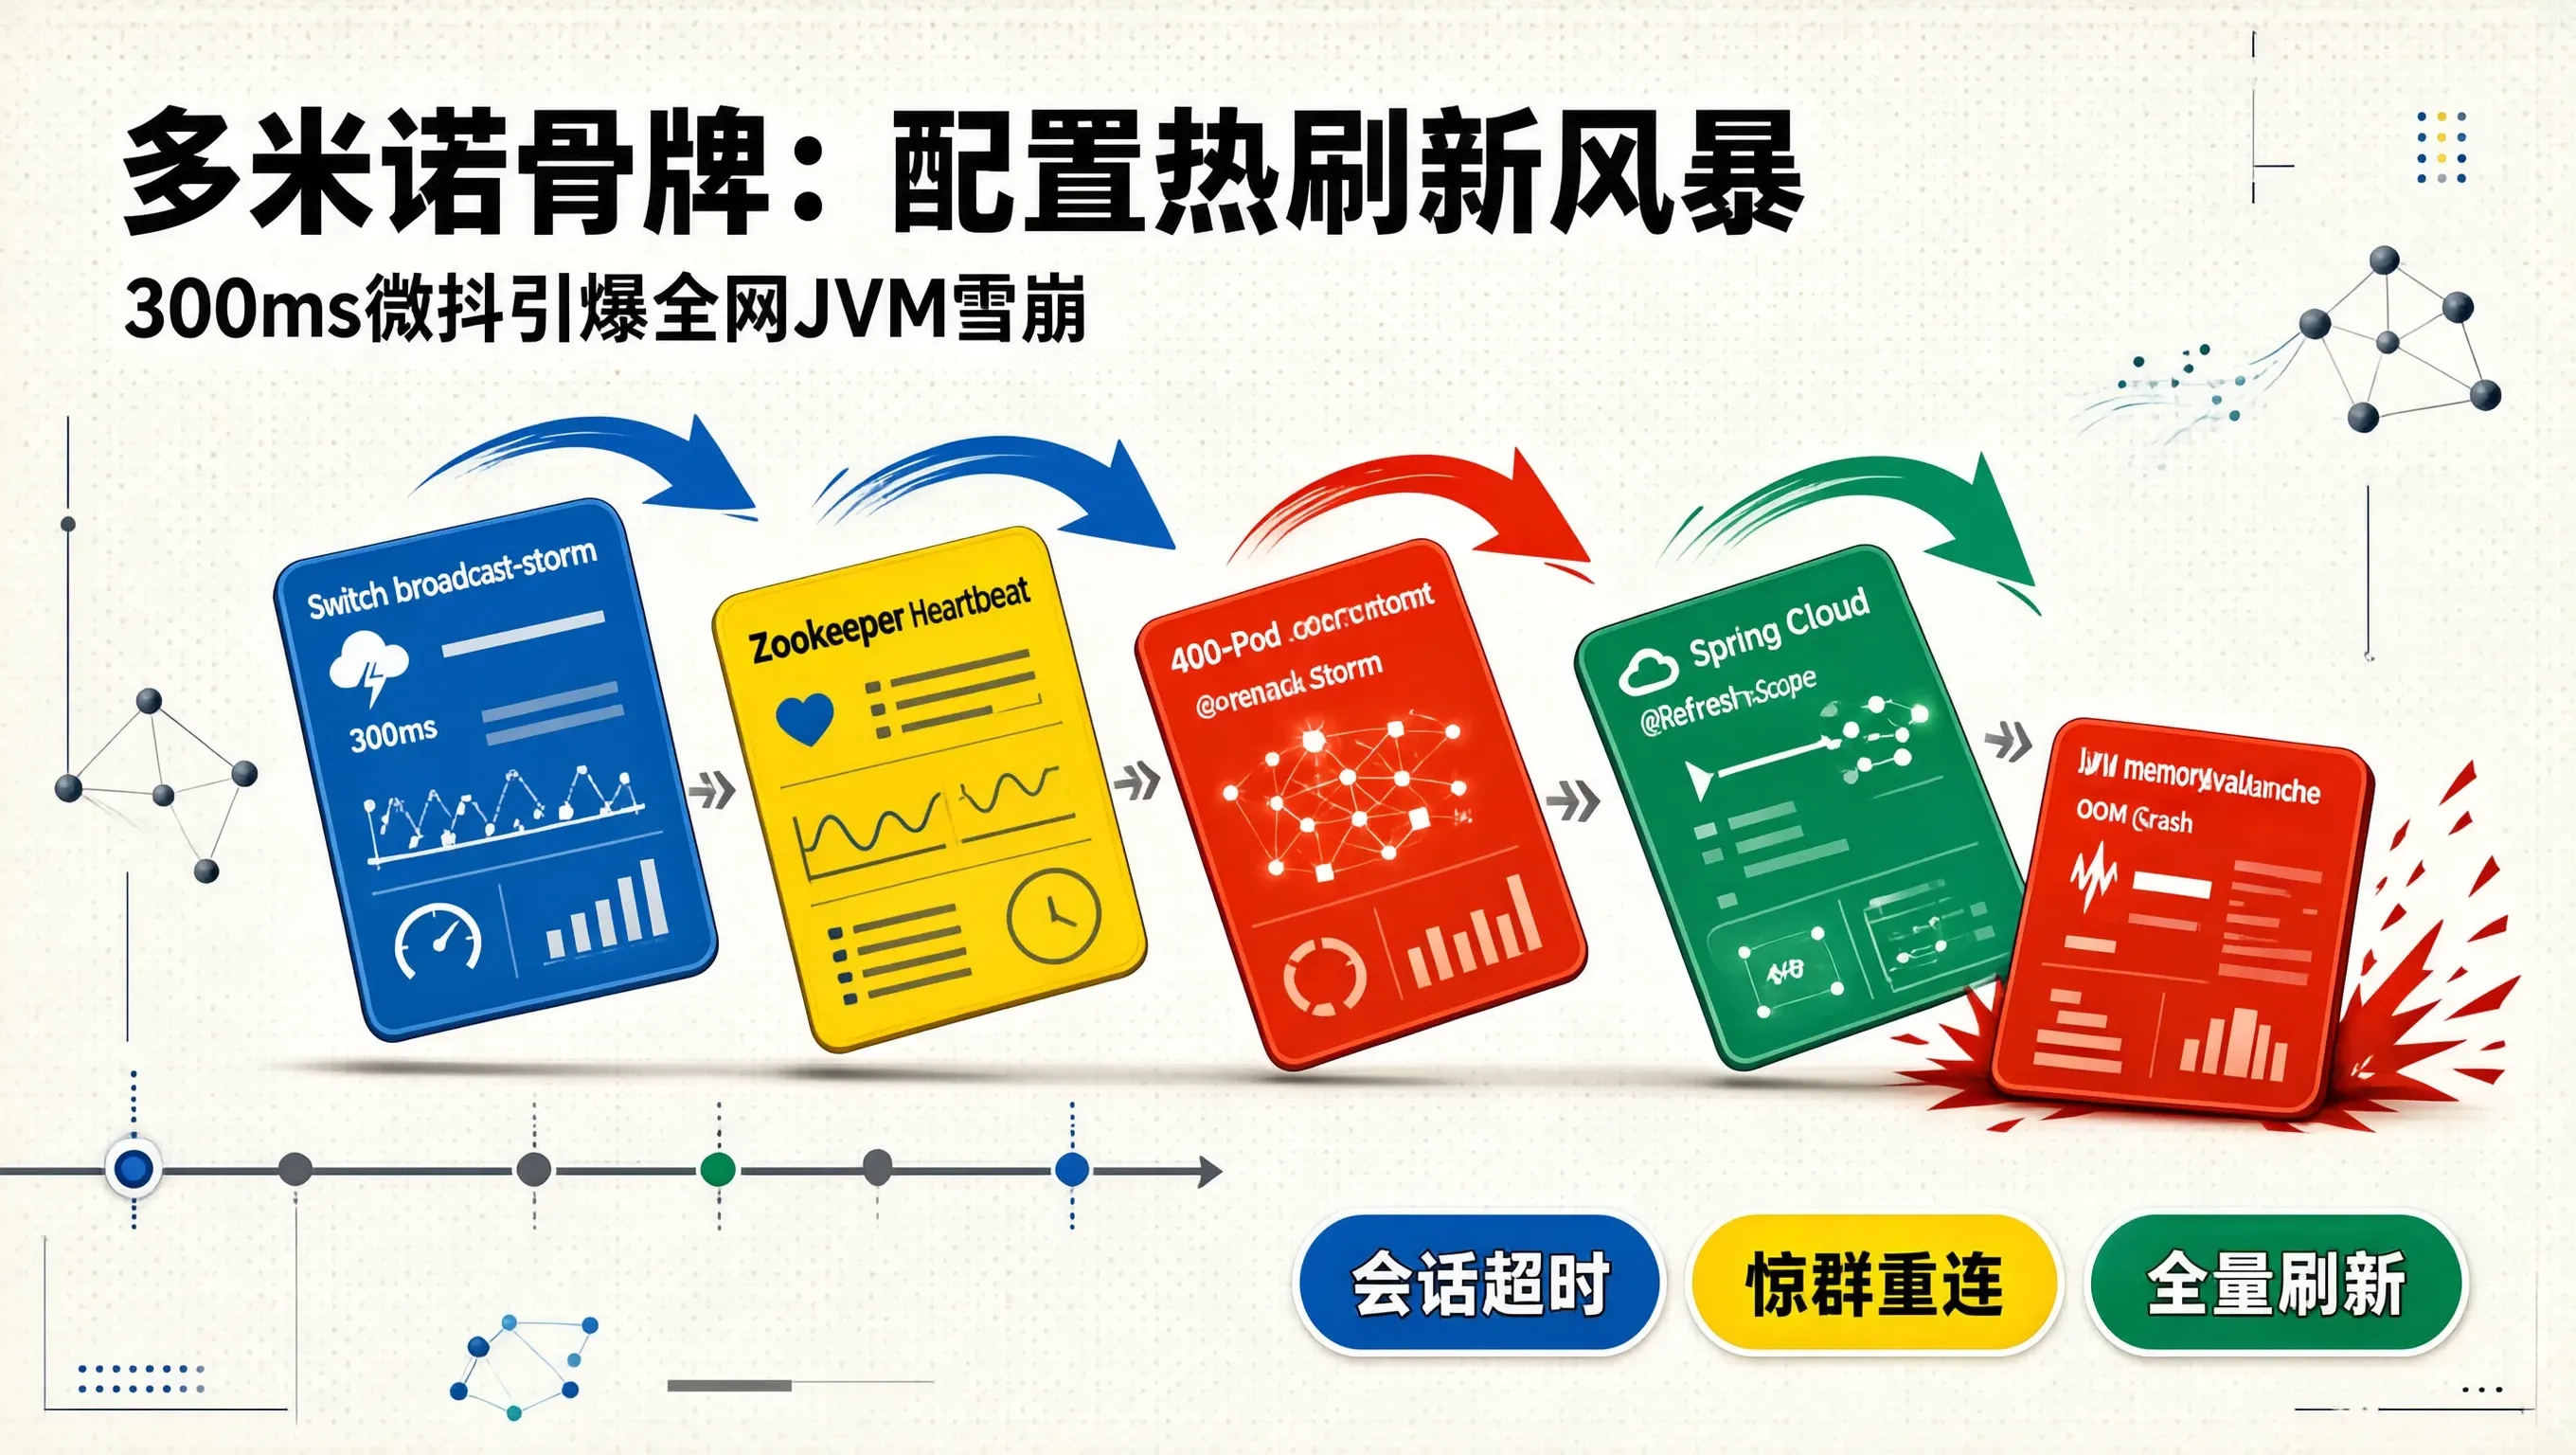
在分布式微服务体系的架构演进中,“配置中心动态热刷新(Dynamic Configuration Refresh)”曾被视作一项极其优雅的高级特性:无需重新打包、无需滚动重启微服务容器,只需在配置中心界面轻轻点击“发布”,全网数以千计的微服务 Pod 就能在几百毫秒内实时感知变更并无缝热生效。
然而,在面对高并发大促这种极端复杂的物理生产环境时,这种“全自动的实时热响应”,却往往会以最惨烈的方式背刺系统本身。
这是我们在备战大促夜间全链路演练中亲历的一起真实 P0 级生产浩劫。机房的核心交换机仅仅发生了一次持续不到 300 毫秒的广播风暴抖动,网络专线在 1 秒之内便完全恢复了平静。然而,正是这微不足道的 300 毫秒,在底层的分布式协调集群中推倒了第一块骨牌,进而引发了一场横扫全网 400 多个核心微服务 Pod 的**“配置全量热刷新风暴与 JVM 内存雪崩”**,导致数十个核心微服务在五分钟之内相继发生 Full GC 假死,最终惨遭 Kubernetes OOM Killer 批量团灭。
这是一份带着血与火教训的硬核复盘手记。
一、风暴来袭:网络已平息,服务却相继暴毙
深夜 23:45,大促混合全链路压测正平稳运行在 60,000 QPS 的基线水位。
23:47:10,核心网络交换机上报了一个极其短暂的 CPU 突刺,两台接入交换机之间发生了持续 300ms 的二层网络环路收敛,随后立即自愈,丢包率迅速归零。
然而,网络恢复正常的几十秒后,监控大屏上的微服务集群却像被推倒的多米诺骨牌一样,拉响了全网级别的最高火警:
- 支付网关、商品中心、用户服务的 CPU 使用率在 10 秒内齐刷刷从 35% 垂直拉满至 100%;
- 各微服务容器的物理内存(RSS)呈现出恐怖的垂直暴涨,瞬间撞碎了 cgroup 设置的 8GB 限制;
- 监控探针开始疯狂捕获长达 5 到 8 秒的全局 Full GC 停顿(Stop-The-World);
- Kubernetes 控制器因为健康检查超时(Readiness/Liveness Probe Failed),判定 Pod 集体死亡,开始以每秒数十个的狂暴速度盲目杀死并重建容器!整个集群陷入了无法终止的“重启-雪崩-再重启”死亡螺旋!
二、多米诺骨牌的链式倾覆推导
通过下钻各应用节点的 JVM 堆转储文件(Heap Dump)、Zookeeper 审计日志以及 Spring 框架的事件发布链路,我们终于还原了那场令人触目惊心的系统自我毁灭链条:
[骨牌 1: 交换机 300ms 广播风暴微抖]
│
▼
[骨牌 2: Zookeeper 客户端心跳超时断连]
– 客户端配置的 sessionTimeout 过于激进 (仅 3000ms)
– 判定心跳丢失,抛出 SessionExpiredException,连接瞬间被切断!
│
▼
[骨牌 3: 全网 400 个 Pod 并发重连风暴 (Reconnection Storm)]
– 网络恢复瞬间,数百个微服务同时向 Zookeeper 节点发起 TCP 握手重连
– 重新挂载全量 NodeChildrenChanged 与 NodeDataChanged 的 Watcher 监听!
│
▼
[骨牌 4: 致命机制触发——Spring Cloud @RefreshScope 全量广播]
– 重新挂载 Watcher 时,客户端误判配置节点发生变动
– 向 Spring 容器发布 ContextRefreshedEvent 事件!
– 全网 400 个 Pod 同时拉取数万行配置,并在内存中强行销毁全部既有 Bean!
│
▼
[骨牌 5: 类重载与连接池重建引发全集群 OOM 暴毙]
– 销毁旧 Bean 并重新执行反射初始化、重建数据库连接池与线程池
– 堆内存与元空间 (Metaspace) 瞬间被垃圾填满,触发毁灭性 Full GC 停顿!
– 健康检查超时,K8s 批量杀容器,全链路彻底瘫痪!
骨牌 1 & 2:激进的心跳超时与误判脑裂
在微服务的默认配置中,开发团队为了追求“极致灵敏的故障感知”,将 Zookeeper 客户端的 sessionTimeout 硬编码为了 3000 毫秒(3 秒)。当底层交换机发生 300ms 的网络抖动时,瞬间积压的突发数据包导致连续两次的心跳 Ping 报文被延迟投递。Zookeeper 客户端的单线程状态机立刻判定“与服务端的会话已永久超时死亡”,向应用抛出 KeeperState.Expired 异常,强行断开并注销了底层 Socket 连接。
骨牌 3:惊群效应与重连风暴
网络恢复后,全机房 400 多个微服务 Pod 在几乎同一绝对毫秒内,启动了重连逻辑。成千上万个并发连接瞬间撞向 Zookeeper 的 3 个主从节点。各个应用在重新建立 Session 后,开始疯狂拉取各自监听的数十个配置路径,并重新全量向 Zookeeper 注册 Watcher 监听器。
骨牌 4:Spring Cloud @RefreshScope 的致命自残机制
这是导致整个微服务集群瞬间脑死亡的终极推手。在 Spring Cloud 体系中,许多开发者为了图省事,在需要读取配置的类上无脑打上 @RefreshScope 注解。当 Zookeeper 的 Watcher 在重连后重新同步元数据时,由于版本号对齐与事件广播,Spring 容器捕获到了配置刷新事件,触发了核心方法:
// 致命的全局热刷新代码底层:
contextRefresher.refresh();
@RefreshScope 的底层实现本质是什么?它根本不是温和地去修改某个变量的值,而是把当前 Spring 容器中所有打了该注解的单例 Bean 全部从缓存池中物理销毁(Destroy)!当下一次业务请求进门时,Spring 必须通过重度 Java 反射(Reflection)与 CGLIB 动态代理,把这些被销毁的 Bean 重新从头实例化一遍!
骨牌 5:内存与类加载器的瞬间雪崩
在面对每秒数万 QPS 的压测流量冲击下,系统正在处理成千上万个并发订单。就在这一瞬间,应用底层的数据库数据源(HikariDataSource)、Redis 客户端(Lettuce 连接池)、以及数百个复杂的业务 Service Bean 被 Spring 粗暴地原地销毁并尝试重建!
- 连接池雪崩:旧的连接池还在排空,新的连接池又向 MySQL 发起数百个新连接握手,数据库瞬间被打爆;
- 元空间与堆内存暴击:频繁的反射重载生成了海量的临时类元数据(Anonymous Classes)与临时对象,直接把 JVM 的 Metaspace 与年轻代打穿!
- Full GC 绞杀:全集群的所有 JVM 几乎在同一秒内集体切入 Full GC 停顿,业务线程全线冻结 5 秒以上。Kubernetes 的健康检查探测失败,开始在集群中疯狂杀容器……多米诺骨牌彻底坍塌!
三、现场抢救与紧急止血
在明晰了是热刷新机制在微服务内部自残后,指挥室下达了紧急抢救指令:
四、生产级根治方案与工程铁律
要彻底终绝动态配置热刷新引发的全网雪崩,必须在通信协议、刷新机制与业务代码三层构筑绝对的防抖隔离水坝。
1. 调大底层会话超时与重连退避(Backoff)
坚决杜绝在跨网络分布式系统中使用 3 秒级别的敏感会话。标准化配置如下:
# 将 Zookeeper 会话超时放宽至 20 秒,天然免疫机房瞬时微抖
zookeeper.session.timeout = 20000
# 开启带有随机扰动因子的指数退避重连,杜绝瞬间惊群风暴
zookeeper.retry.policy = ExponentialBackoffRetry(1000, 5, 5000)
2. 彻底废弃粗暴的 @RefreshScope,改用细粒度属性热绑定
严禁在包含数据库连接池、网络客户端或复杂有状态服务的核心类上使用 @RefreshScope!最佳实践:仅使用 @ConfigurationProperties 配合原子变量动态读取:
// ✅ 生产级安全热配置:仅更新纯内存标量,零 Bean 重建!
@Component
@ConfigurationProperties(prefix = "biz.risk")
public class SafeDynamicProperties {
// 底层直接修改 volatile 基础变量,纳秒级生效,绝对不会销毁 Bean!
private volatile int maxOrderLimit = 5000;
private volatile boolean enableDegrade = false;
public int getMaxOrderLimit() { return maxOrderLimit; }
public void setMaxOrderLimit(int maxOrderLimit) { this.maxOrderLimit = maxOrderLimit; }
}
3. 引入客户端热刷新防抖水坝(Debounce Barrier)
在配置监听器中注入防抖机制,严禁在网络震荡期间连续触发多次刷新:
import time
import logging
class ConfigRefreshDebounceBarrier:
def __init__(self, debounce_window_sec: float = 30.0):
self.debounce_window = debounce_window_sec
self.last_refresh_ts = 0.0
def try_trigger_refresh(self) -> bool:
"""
防抖水坝:30 秒内最多允许执行一次配置热加载
"""
now = time.monotonic()
if now – self.last_refresh_ts < self.debounce_window:
logger.warning(
"🛑 拦截到高频密集配置刷新请求!距离上次刷新仅 %.2f 秒,处于防抖冷却期,直接丢弃!",
now – self.last_refresh_ts
)
return False
self.last_refresh_ts = now
logger.info("🛡️ 防抖核验通过,放行本次动态配置更新。")
return True
五、咕咕的复盘反思
这场通宵达旦的线上抢险,给所有热衷于“炫技”的架构师留下了永恒的警钟:

