摘要:前面十一篇建立的架构都有一个隐含前提:有一台常驻的服务器在跑。但 Agent 负载有个天然特征——极度不均匀:法务月底集中审合同,平时系统空转;客服 Agent 白天高峰、夜里零请求。为峰值容量付费 24 小时,是 Agent 系统最常见的成本浪费。Serverless 承诺"不用时不花钱、用时自动扩",但 Agent 遇上它会撞三个独特的墙:冷启动特别慢(Agent 依赖重,SDK、向量库客户端、工具定义都要加载)、执行时间超限(合同审查跑 40 分钟,而 AWS Lambda 单次调用硬上限是 15 分钟)、状态无处安放(函数实例随时被销毁,进程内状态必然丢失)。本文讲清三件事:冷启动怎么拆和优化(含一个 2025 年 8 月生效的计费变化,它让冷启动从性能问题变成了成本问题)、长任务怎么处理(拆分 + 编排外置是唯一正解)、成本怎么算(给出盈亏平衡点的计算方法和实测数据)。
📌 版本声明:本文基于 Python 3.11+ 编写,撰写时间 2026 年 10 月。核心代码零云厂商依赖,可直接运行。平台数据以 AWS Lambda 为主(函数计算的事实标准),涉及的具体配额为:单次调用最长 15 分钟(硬限制,不可提升)、内存 128MB~10240MB、默认账户级并发 1000、Init 阶段默认限时 10 秒(启用 Provisioned Concurrency / SnapStart 时可放宽至 130 秒或配置超时取较大者)。对照章节涉及 GCP Cloud Run(最长 60 分钟 / 32GB)、Azure Functions(10 分钟 / 14GB)、阿里云函数计算(600 秒 / 3GB)。各平台配额会调整,生产接入前请核对官方文档。
适用边界:适用于负载波动大、有明显空闲期、单次任务可拆分或时长在平台上限内的 Agent 系统。若你的 Agent 负载全天平稳且利用率持续高于 50%、或需要 GPU、或需要跑超过 15 分钟且无法拆分——Serverless 不是省钱方案,是麻烦制造机。
文章目录
-
- 一、为什么需要 Serverless:Agent 负载的锯齿曲线
-
- 1.1 先看一条真实的负载曲线
- 1.2 常驻部署的真实账单
- 1.3 但 Agent 撞上三堵墙
- 1.4 三堵墙的性质不同
- 二、核心概念
-
- 2.1 冷启动的构成拆解
- 2.2 一个必须知道的计费变化
- 2.3 三条冷启动优化路径
- 2.4 长任务:三种解法的取舍
- 2.5 成本模型:盈亏平衡点在哪
- 2.6 执行环境的生命周期:理解它才能优化它
- 三、环境准备
-
- 3.1 依赖与项目结构
- 四、核心实战
-
- 4.1 第一步:handler 的正确结构
- 4.2 第二步:冷启动埋点与量化
- 4.3 第三步:长任务拆分
- 4.4 第四步:状态外置
- 4.5 完整执行链路
- 五、进阶
-
- 5.1 内存配置:不是越大越好,也不一定越小越省
- 5.2 并发控制:账户级配额是个隐形炸弹
- 5.3 一个必须避免的反模式:在函数里 sleep 等待
- 5.4 依赖打包策略
- 5.5 可观测:Serverless 下必须埋的五个指标
- 六、对照:平台选型
-
- 6.1 混合部署:真实系统往往是两者都有
- 七、适用边界与风险提示 ⚠️
- 八、进阶:让 Serverless 逻辑可测
- 九、总结
-
- 落地自检清单(Checklist)
- 常见问题(FAQ)
- 参考资料
一、为什么需要 Serverless:Agent 负载的锯齿曲线
1.1 先看一条真实的负载曲线
某企业的合同审查 Agent,一天内按小时统计的调用量:
00 02 04 06 08 10 12 14 16 18 20 22
0 0 0 2 28 95 140 155 132 110 41 6
这条曲线的三个特征:
| 峰值 / 谷值 | 155 : 0(谷值不是"少",是"零") |
| 峰值持续时间 | 约 4 小时(10:00-14:00) |
| 日均调用 | 800 次 |
谷值是零,这一点很关键。 它意味着夜里 8 小时 + 清晨 6 小时,系统完全空闲——但你依然在为这段时间付费。
1.2 常驻部署的真实账单
按峰值容量部署(这是唯一的正确做法,否则高峰期排队):峰值 155 次/小时,单次执行 25 秒 → 平均并发约 1.1,但要留出突发余量,实际部署了 2 台 2GB 实例。
常驻成本 = 2 实例 × 2GB × 24 小时 = 96 GB-小时/天
实际用到的 = 800 次 × 25 秒 × 2GB = 40000 GB-秒 ≈ 11.1 GB-小时/天
利用率 = 11.1 / 96 ≈ 11.6%
你为 100% 的容量付费,只用了 11.6%。 剩下 88.4% 是纯浪费——而这些浪费的存在理由,只是为了应对每天 4 小时的峰值。
这就是 Serverless 的核心卖点:不为空闲付费。
1.3 但 Agent 撞上三堵墙
把 Agent 搬到 Serverless 上,会立刻遇到三个普通 Web 服务不会遇到的问题:
墙一:冷启动特别慢
普通 Web 服务的冷启动是"启动 Python + 导入 Flask",约 200ms。Agent 的冷启动是:
启动 Python 运行时 ~150ms
导入 LLM SDK ~800ms ← 依赖树很深
导入向量库客户端 ~400ms
初始化 HTTP 连接池 ~200ms
加载工具定义与 Prompt 模板 ~300ms
────────────────────────────────
合计 ~1.85s(还不含业务初始化)
而 AWS 官方给出的冷启动区间是"低于 100ms 到超过 1 秒",Agent 的冷启动稳稳落在区间上沿之外。
墙二:执行时间超过平台上限
合同审查跑 40 分钟。AWS Lambda 单次调用的硬上限是 15 分钟——这不是配置问题,是平台限制,无法提升。
墙三:状态无处安放
函数实例在无请求后会被冻结、最终销毁。第 30 篇讲的会话状态、任务状态如果放在进程内存里,那么实例一销毁就全没了。在常驻部署里"状态放内存"是偷懒,在 Serverless 里是根本不成立。
1.4 三堵墙的性质不同
| 冷启动慢 | 性能 + 成本问题 | ✅ 能优化到可接受 |
| 执行超时 | 架构约束 | ✅ 必须改架构(拆分) |
| 状态丢失 | 架构约束 | ✅ 必须外置(第 30 篇方案成为硬性要求) |
后两堵不是"优化"能解决的,是必须改设计。 这是本文最重要的判断——很多团队把 Serverless 迁移当成"部署方式变更",结果在这两堵墙上反复碰壁。
二、核心概念
2.1 冷启动的构成拆解
要优化冷启动,先要拆清楚它由什么组成。AWS 官方把执行环境生命周期分成几个阶段:
| Init | 启动扩展、引导运行时、执行静态代码(模块级 import、全局连接) | 冷启动时执行一次 |
| Invoke | 调用 handler | 每次请求 |
| Freeze | 无请求时冻结环境 | 请求间隔 |
| Shutdown | 销毁环境 | 长期空闲或崩溃 |
冷启动 = Init 阶段的可见代价。 热调用(warm start)跳过 Init 直接执行 handler,这是两者延迟差异的全部来源。
关键认知:Init 的耗时主要由你自己的静态代码决定。 官方明确说了"最大的启动延迟来源是在环境创建时执行一次的静态初始化代码——导入库、建立配置、打开连接"。所以冷启动优化的第一抓手不是平台配置,是你写了什么模块级代码。
2.2 一个必须知道的计费变化
⚠️ 自 2025 年 8 月 1 日起,Init 阶段的时间被计入计费时长。
此前,按需函数(on-demand)使用托管运行时 + ZIP 打包时,Init 时间不单独计费。这次调整之后,冷启动从"只影响延迟"变成了"同时影响账单"。
这对 Agent 场景的冲击特别大。算一笔账:
假设:单次执行 25 秒,内存 2GB,冷启动 4 秒(Agent 场景常见)
日均 800 次,冷启动率 30%(负载不均匀时段多)
计算耗时 = 800 × 25s × 2GB = 40,000 GB-秒
冷启动 = 800 × 30% × 4s × 2GB = 1,920 GB-秒
冷启动占比 = 1,920 / 41,920 ≈ 4.6%
4.6% 看起来不多。但如果冷启动优化做得差(比如 20 秒,加载了大依赖):
冷启动 = 800 × 30% × 20s × 2GB = 9,600 GB-秒
冷启动占比 = 9,600 / 49,600 ≈ 19.4%
接近五分之一的账单花在了"还没开始干活"上。 这就是为什么 2025 年之后冷启动优化从性能专项变成了成本专项。
💡 但这个变化也带来一个反直觉的结论:消除冷启动未必让账单变好。 启用预置并发确实把冷启动降到了零,可预置环境是 24 小时计费的——不管有没有请求。如果负载低(比如日均 100 次),预置成本很可能超过被省下的那点冷启动成本。所以预置并发必须按"预置成本 vs 冷启动成本"算过账再开,不能因为"冷启动慢"就无脑开。
2.3 三条冷启动优化路径
| 减少 Init 工作量 | 延迟导入、精简依赖、全局连接复用 | 零 | 冷启动 4s → 1s 量级 |
| 预置并发 | Provisioned Concurrency,预初始化环境常驻 | 按预置环境付费 | 冷启动 ≈ 0 |
| 快照恢复 | SnapStart,快照已初始化环境后恢复 | 免费(部分运行时) | Java 8s → 200ms |
三者的关系是递进的,不是三选一:先做第一条(零成本、收益最大),不够再做第三条(免费但要平台支持),最后才考虑第二条(要花钱)。
关于 SnapStart 有个重要更新:它最初只支持 Java,现已扩展到 Python 和 .NET,且 2025 年底的更新引入了"环境驻留"(调用间隔保留环境 300 秒以上),Python 函数在规律性突发流量下冷启动可降至 50-70ms,接近热启动。这意味着"Python Agent 冷启动慢"这个理由在 2026 年已经不成立了——前提是你用了支持该特性的平台和运行时版本。
2.4 长任务:三种解法的取舍
这是 Agent 最核心的矛盾。三种路线:
| ① 拆分 + 编排外置 | 把长流程拆成多个短步骤,用队列/编排器串起来 | 推荐 | 需要第 26 篇的引擎 + 第 30 篇的 Checkpoint |
| ② 异步 + 轮询 | 函数只启动任务,结果写外部存储,客户端轮询 | 任务无法拆分 | 客户端改造、延迟感知 |
| ③ 换平台 | Cloud Run(60 分钟)/ Fargate(无限制) | 任务确实无法拆分 | 失去部分 Serverless 成本优势 |
路线①是正解,理由不只是"能跑"——拆开之后还有一个额外收益:每一步都能独立重试。一个 40 分钟的任务失败了要整体重跑;拆成 8 个 5 分钟的步骤,只有失败的那一步需要重跑。结合第 30 篇的 completed_steps,重跑成本几乎为零。
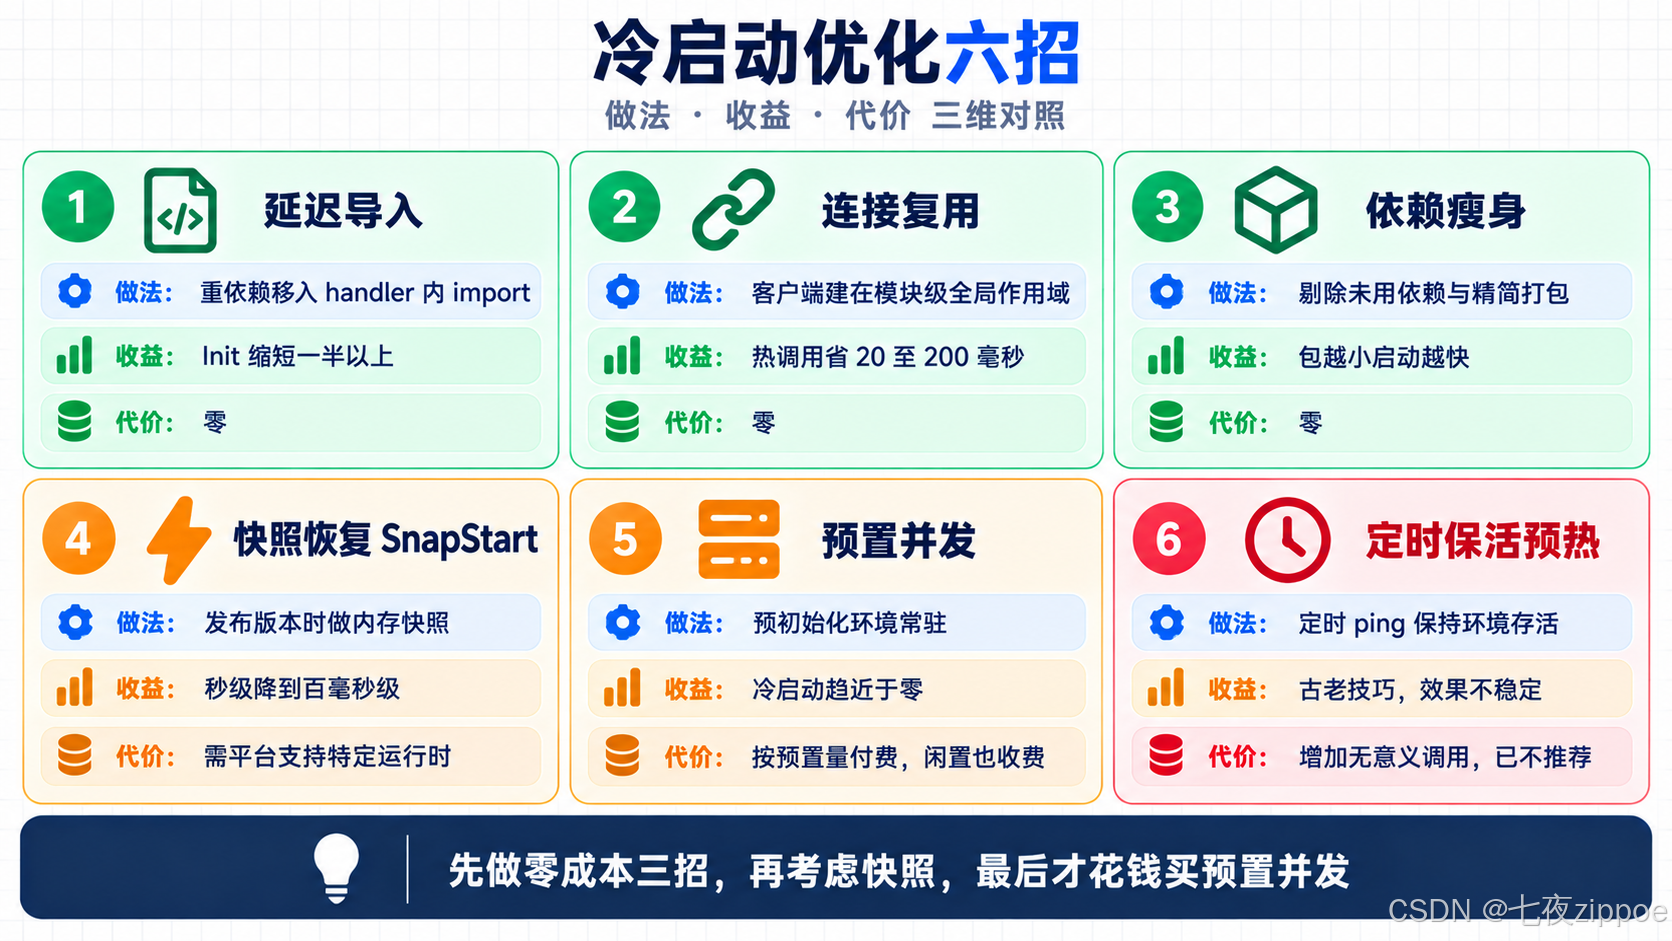
图1:冷启动优化六招——延迟导入、连接复用、依赖瘦身、预置并发、快照恢复、保活预热的收益与代价
2.5 成本模型:盈亏平衡点在哪
这是选型的核心问题。两个公式:
常驻成本 = 实例内存 × 实例数 × 24 小时 × 实例单价
Serverless = 调用次数 × 单次 GB-秒 × GB-秒单价 + 请求次数 × 请求单价
(2025-08 后还要 + 冷启动 Init 的 GB-秒)
行业经验值是"实例持续利用率超过 50% 时常驻更便宜"。1.2 节那个案例的利用率是 11.6%,远低于 50%,所以 Serverless 明显占优。
把两个成本画成随调用量变化的曲线,交点就是盈亏平衡点:
#mermaid-svg-YTQvSJMjHM96qzcb{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-YTQvSJMjHM96qzcb .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-YTQvSJMjHM96qzcb .error-icon{fill:#552222;}#mermaid-svg-YTQvSJMjHM96qzcb .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-YTQvSJMjHM96qzcb .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-YTQvSJMjHM96qzcb .marker{fill:#333333;stroke:#333333;}#mermaid-svg-YTQvSJMjHM96qzcb .marker.cross{stroke:#333333;}#mermaid-svg-YTQvSJMjHM96qzcb svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-YTQvSJMjHM96qzcb p{margin:0;}#mermaid-svg-YTQvSJMjHM96qzcb :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
常驻与 Serverless 成本随日均调用量变化
100
500
2000
8000
32000
128000
120
110
100
90
80
70
60
50
40
30
20
10
0
月度相对成本
💡 这张图里常驻是一条水平线(因为容量按峰值预留,与调用量无关),Serverless 是一条上升斜线(用多少付多少)。两条线的交点就是盈亏平衡点——超过这个点,常驻更划算。
但要小心读图:这里的常驻成本是按"峰值容量 × 24 小时"算的。如果你的负载平稳(比如夜间也有 80% 的白天流量),常驻的利用率会大幅上升,水平线整体下移,平衡点会左移。所以"负载波动程度"才是决定因素,不是绝对调用量。
2.6 执行环境的生命周期:理解它才能优化它
很多冷启动问题的根源是不理解环境什么时候被创建、什么时候被复用、什么时候被销毁。官方把生命周期分成四个阶段,它们的关系是:
| Init | 环境首次创建 | 执行模块级代码(import、全局连接) |
| Invoke | 每次请求 | 执行 handler |
| Freeze | 请求处理完、无待处理事件 | 环境被冻结,模块级变量保留 |
| Shutdown | 长期空闲或崩溃 | 清理,环境消失 |
Freeze 状态是理解复用机制的关键:环境被冻结后并没有销毁,模块级变量(包括你建立的连接)都还在。下次请求来了直接解冻执行 handler——这就是热启动比冷启动快的全部原因。
#mermaid-svg-kK2zbqgeBEVHuoNg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-kK2zbqgeBEVHuoNg .error-icon{fill:#552222;}#mermaid-svg-kK2zbqgeBEVHuoNg .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-kK2zbqgeBEVHuoNg .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-kK2zbqgeBEVHuoNg .marker{fill:#333333;stroke:#333333;}#mermaid-svg-kK2zbqgeBEVHuoNg .marker.cross{stroke:#333333;}#mermaid-svg-kK2zbqgeBEVHuoNg svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-kK2zbqgeBEVHuoNg p{margin:0;}#mermaid-svg-kK2zbqgeBEVHuoNg defs #statediagram-barbEnd{fill:#333333;stroke:#333333;}#mermaid-svg-kK2zbqgeBEVHuoNg g.stateGroup text{fill:#9370DB;stroke:none;font-size:10px;}#mermaid-svg-kK2zbqgeBEVHuoNg g.stateGroup text{fill:#333;stroke:none;font-size:10px;}#mermaid-svg-kK2zbqgeBEVHuoNg g.stateGroup .state-title{font-weight:bolder;fill:#131300;}#mermaid-svg-kK2zbqgeBEVHuoNg g.stateGroup rect{fill:#ECECFF;stroke:#9370DB;}#mermaid-svg-kK2zbqgeBEVHuoNg g.stateGroup line{stroke:#333333;stroke-width:1;}#mermaid-svg-kK2zbqgeBEVHuoNg .transition{stroke:#333333;stroke-width:1;fill:none;}#mermaid-svg-kK2zbqgeBEVHuoNg .stateGroup .composit{fill:white;border-bottom:1px;}#mermaid-svg-kK2zbqgeBEVHuoNg .stateGroup .alt-composit{fill:#e0e0e0;border-bottom:1px;}#mermaid-svg-kK2zbqgeBEVHuoNg .state-note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-kK2zbqgeBEVHuoNg .state-note text{fill:black;stroke:none;font-size:10px;}#mermaid-svg-kK2zbqgeBEVHuoNg .stateLabel .box{stroke:none;stroke-width:0;fill:#ECECFF;opacity:0.5;}#mermaid-svg-kK2zbqgeBEVHuoNg .edgeLabel .label rect{fill:#ECECFF;opacity:0.5;}#mermaid-svg-kK2zbqgeBEVHuoNg .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-kK2zbqgeBEVHuoNg .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-kK2zbqgeBEVHuoNg .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-kK2zbqgeBEVHuoNg .edgeLabel .label text{fill:#333;}#mermaid-svg-kK2zbqgeBEVHuoNg .label div .edgeLabel{color:#333;}#mermaid-svg-kK2zbqgeBEVHuoNg .stateLabel text{fill:#131300;font-size:10px;font-weight:bold;}#mermaid-svg-kK2zbqgeBEVHuoNg .node circle.state-start{fill:#333333;stroke:#333333;}#mermaid-svg-kK2zbqgeBEVHuoNg .node .fork-join{fill:#333333;stroke:#333333;}#mermaid-svg-kK2zbqgeBEVHuoNg .node circle.state-end{fill:#9370DB;stroke:white;stroke-width:1.5;}#mermaid-svg-kK2zbqgeBEVHuoNg .end-state-inner{fill:white;stroke-width:1.5;}#mermaid-svg-kK2zbqgeBEVHuoNg .node rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-kK2zbqgeBEVHuoNg .node polygon{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-kK2zbqgeBEVHuoNg #statediagram-barbEnd{fill:#333333;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-cluster rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-kK2zbqgeBEVHuoNg .cluster-label,#mermaid-svg-kK2zbqgeBEVHuoNg .nodeLabel{color:#131300;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-cluster rect.outer{rx:5px;ry:5px;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-state .divider{stroke:#9370DB;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-state .title-state{rx:5px;ry:5px;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-cluster.statediagram-cluster .inner{fill:white;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-cluster.statediagram-cluster-alt .inner{fill:#f0f0f0;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-cluster .inner{rx:0;ry:0;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-state rect.basic{rx:5px;ry:5px;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-state rect.divider{stroke-dasharray:10,10;fill:#f0f0f0;}#mermaid-svg-kK2zbqgeBEVHuoNg .note-edge{stroke-dasharray:5;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-note text{fill:black;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram-note .nodeLabel{color:black;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagram .edgeLabel{color:red;}#mermaid-svg-kK2zbqgeBEVHuoNg #dependencyStart,#mermaid-svg-kK2zbqgeBEVHuoNg #dependencyEnd{fill:#333333;stroke:#333333;stroke-width:1;}#mermaid-svg-kK2zbqgeBEVHuoNg .statediagramTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-kK2zbqgeBEVHuoNg :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
首次调用触发冷启动
静态代码执行完毕
请求处理完成
新请求到达 热启动
空闲超时
崩溃或超时 环境重置
Init
Invoke
Freeze
Shutdown
唯一执行模块级代码的阶段此阶段耗时即冷启动延迟2025 年 8 月起计入计费
模块级变量保留连接可跨调用复用不计费
四条从这张图才能看出来的实践结论:
① 崩溃会导致环境重置,下次调用要重新 Init。 注意 Invoke –> Shutdown 这条边——函数崩溃或超时后,环境不是冻结而是重置。这意味着一个经常崩溃的函数会频繁冷启动,而冷启动又会加剧超时(形成恶性循环)。所以"减少崩溃"本身就是冷启动优化。
② 连接复用依赖 Freeze 而非 Invoke。 连接在 Init 阶段建立,在 Freeze 期间保留,在下次 Invoke 时直接使用。所以连接必须建在模块级——建在 handler 里的话,每次 Invoke 都重建,复用的好处一点都没拿到。
③ Init 有独立的超时限制。 默认情况下 Init 阶段限时 10 秒(启用 Provisioned Concurrency / SnapStart / Managed Instances 时可放宽)。如果你的模块级代码超过 10 秒,函数会初始化失败——而这个失败表现为"函数第一次调用失败,重试却成功了",极难排查。
④ /tmp 在 Shutdown 前不清空,但 Shutdown 后就没了。 官方明确说明"重置不会在下次 Init 前清除 /tmp 的内容"。所以 /tmp 可以在同一环境的多次调用间作为缓存,但绝不能假设它跨环境存在。
⚠️ 不要依赖"环境会被复用"这个行为。 虽然平台在负载上升时会提前初始化环境,但官方明确警告"不要依赖这一行为"。你的代码必须在"每次都是冷启动"的最坏情况下依然正确——这条原则决定了状态必须外置、连接必须能重建。
三、环境准备
3.1 依赖与项目结构
python -m venv .venv
source .venv/bin/activate
pip install "pydantic>=2.7" "redis>=5.0" # redis 用于状态外置
pip install pytest pytest-asyncio
# 本地模拟 Serverless:用 docker 或直接跑 handler 即可
serverless_agent/
├── handler.py # 函数入口:冷启动埋点 + 路由
├── lazy.py # 延迟导入的重依赖
├── state_store.py # 状态外置(Redis)
├── splitter.py # 长任务拆分与自调用
└── metrics.py # 冷启动与计费埋点
四、核心实战
4.1 第一步:handler 的正确结构
先给一个错误示范——这是绝大多数团队第一次写 Serverless Agent 的样子:
# ❌ 错误示范:所有导入都在模块级
import openai # ~800ms
import numpy as np # ~600ms
from vector_db import Client # ~400ms
def handler(event, context):
client = Client(...) # ❌ 每次调用都新建连接
result = openai.chat.completions.create(...)
return result
两个问题:① 三个重导入全在 Init 阶段执行,冷启动必慢;② 连接在 handler 内创建,热调用也要付创建成本。
正确结构:
"""Serverless Agent handler。
三条铁律:
1. 模块级只放**零成本或极低成本**的东西(常量、轻量导入)。
2. 重依赖**延迟导入**——在 handler 内 import,只影响首次调用。
3. 可复用的连接/客户端放**模块级**,跨调用复用(这是官方首推优化)。
"""
from __future__ import annotations
import json
import logging
import os
import time
logger = logging.getLogger()
logger.setLevel(logging.INFO)
# —- 模块级:只放轻量的 —-
_COLD_START = time.perf_counter() # 进程启动时刻,用于计算 Init 耗时
# 可复用客户端:**模块级创建,跨调用复用**
# 这是官方明确推荐的最高效优化——热调用不再重建连接
_http = None
def _get_http():
"""懒加载 + 复用。首次调用时创建,之后复用。"""
global _http
if _http is None:
import httpx # ← 延迟导入:不进 Init
_http = httpx.AsyncClient(timeout=60.0)
return _http
def handler(event, context):
"""函数入口。"""
init_ms = int((time.perf_counter() – _COLD_START) * 1000)
is_cold = init_ms < 100 # Init 刚发生 → 本次是冷启动
logger.info(json.dumps({
"type": "cold_start" if is_cold else "warm_start",
"init_ms": init_ms,
"request_id": getattr(context, "aws_request_id", "-"),
}))
try:
payload = json.loads(event.get("body", "{}"))
return _respond(200, process(payload))
except Exception as exc:
logger.exception("handler 失败")
return _respond(500, {"error": str(exc)})
def _respond(status: int, body) –> dict:
return {"statusCode": status,
"headers": {"Content-Type": "application/json"},
"body": json.dumps(body, ensure_ascii=False)}
三条铁律背后的原理:
| 模块级只放轻量导入 | Init 阶段的耗时直接等于冷启动耗时,且 2025-08 后直接计费 |
| 重依赖延迟导入 | 移到 handler 内后,只影响首次调用,不影响后续冷启动 |
| 连接放模块级复用 | 环境冻结后解冻,模块级变量保留,连接可以跨调用复用 |
⚠️ "延迟导入"和"连接复用"看起来矛盾(一个要放进 handler、一个要放到模块级),实际不矛盾:延迟导入针对的是"导入很慢但创建很快"的东西(SDK 模块),连接复用针对的是"创建很慢但可复用"的东西(HTTP 客户端、数据库连接)。判断标准是——这个东西在多次调用之间能复用吗?能 → 模块级;不能或导入本身就是开销 → 延迟导入。
4.2 第二步:冷启动埋点与量化
优化的前提是能测量。下面是一个轻量的冷启动采集器:
"""冷启动与计费埋点。
**你必须知道三件事**:冷启动发生了多少次、每次多长、占总计费的比例。
"""
from __future__ import annotations
import os
import time
from dataclasses import dataclass, field
@dataclass
class InvocationMetrics:
"""单次调用的度量。"""
cold: bool
init_ms: int = 0 # Init 耗时(仅冷启动有)
invoke_ms: int = 0 # handler 耗时
memory_mb: int = 0
request_id: str = ""
def build_metrics(start_perf: float, context) –> InvocationMetrics:
"""在 handler 开头调用,构造度量对象。"""
now = time.perf_counter()
init_ms = int((now – start_perf) * 1000)
return InvocationMetrics(
cold=init_ms < 100,
init_ms=init_ms if init_ms < 100 else 0,
memory_mb=int(os.environ.get("AWS_LAMBDA_FUNCTION_MEMORY_SIZE", "0") or 0),
request_id=getattr(context, "aws_request_id", "-"),
)
def gb_seconds(m: InvocationMetrics) –> float:
"""计算本次调用的计费 GB-秒。**含 Init**(2025-08 后 Init 计费)。"""
total_s = (m.init_ms + m.invoke_ms) / 1000.0
return total_s * (m.memory_mb / 1024.0)
def report(m: InvocationMetrics) –> dict:
"""输出结构化日志,供计费分析。"""
return {
"cold": m.cold,
"init_ms": m.init_ms,
"invoke_ms": m.invoke_ms,
"gb_seconds": round(gb_seconds(m), 4),
"memory_mb": m.memory_mb,
"request_id": m.request_id,
}
有了这个埋点,就能算出 冷启动占总计费的比例——这是判断要不要做预置并发的依据:
冷启动占比 = Σ(冷启动的 Init GB-秒) / Σ(全部 GB-秒)
< 5% → 不值得为冷启动花钱,做零成本优化即可
5%~20% → 考虑 SnapStart(免费)
> 20% → 考虑预置并发(要花钱,但可能仍比浪费便宜)
4.3 第三步:长任务拆分
这是全篇最关键的一步。核心思路:把 40 分钟的任务拆成 N 个 2 分钟的步骤,每一步是一次独立的函数调用。
"""长任务拆分:把超时风险变成可控的多步执行。
设计要点:
1. 每一步**独立调用**,单步耗时必须远小于平台上限(留 3 倍以上余量)。
2. 步与步之间靠**外部状态**传递(第 30 篇的 TaskState + Checkpoint)。
3. 用**队列自调用**驱动下一步——函数不等待,只负责一步。
"""
from __future__ import annotations
import json
import logging
from state_store import StateStore
logger = logging.getLogger()
MAX_STEP_SECONDS = 120 # 单步上限:远小于 15 分钟,留足余量
def make_plan(total_items: int, batch_size: int = 5) –> list[dict]:
"""把任务拆成计划。**在提交任务时生成,不在函数内。**
batch_size 决定单步耗时:单步耗时 ≈ batch_size × 单项耗时。
必须保证 batch_size × 单项耗时 << MAX_STEP_SECONDS。
"""
return [
{"step": i // batch_size, "items": list(range(i, min(i + batch_size, total_items)))}
for i in range(0, total_items, batch_size)
]
def step_handler(event, store: StateStore) –> dict:
"""单步 handler。**只处理一批,处理完触发下一批。**
关键:函数**不等待**后续步骤——它把"下一步"作为一个新事件发出去就返回。
这就是绕过 15 分钟限制的核心机制。
"""
task_id = event["task_id"]
step_index = event["step_index"]
items = event["items"]
state = store.load(task_id)
if state is None:
return {"status": "aborted", "reason": "任务状态不存在"}
# —- 幂等:已完成的步骤直接跳过(第 30 篇机制)—-
if state.is_done(f"step:{step_index}"):
logger.info("步骤 %d 已完成,跳过", step_index)
return {"status": "skipped", "step": step_index}
# —- 执行本批 —-
results = [process_one(item) for item in items]
state.mark_done(f"step:{step_index}", results)
store.save(state)
# —- 触发下一步(不等待)—-
nxt = step_index + 1
if event.get("has_next"):
emit_next(task_id, nxt)
return {"status": "ok", "step": step_index, "processed": len(items)}
def emit_next(task_id: str, step_index: int) –> None:
"""发出下一步事件。**实现取决于平台**:SQS / EventBridge / 自调用。"""
logger.info("触发下一步 task=%s step=%d", task_id, step_index)
def process_one(item: int) –> dict:
"""处理单项。**这里才是真正的 LLM 调用。**"""
return {"item": item, "result": f"processed-{item}"}
这个设计解决了三个问题:
| 15 分钟超时 | 每步只跑 2 分钟,永不超时 |
| 失败要整体重跑 | 幂等 + 已完成跳过,只有失败那一步重跑 |
| 进度不可见 | 每步都写外部状态,随时可查进度 |
⚠️ batch_size 的取值是个真实的设计决策,不是随便填。它要满足:batch_size × 单项耗时 × 3 < 平台超时。乘 3 是因为要留余量——单项耗时在高峰期会变长(上游限流、重试)。见过太多团队按平均耗时算 batch_size,然后在流量高峰时批量超时。
4.4 第四步:状态外置
第 30 篇的三层状态,在 Serverless 下从"推荐"变成"必须"。下面是最小实现:
"""状态外置:Serverless 下的硬性要求。
**函数实例随时会被销毁,进程内存不可靠。**
唯一可信的存储是函数外部的存储服务。
"""
from __future__ import annotations
import json
import logging
import os
from typing import Any
logger = logging.getLogger()
class StateStore:
"""状态存储。生产用 Redis / DynamoDB,这里给内存版用于演示与测试。"""
def __init__(self) –> None:
self._data: dict[str, dict] = {}
def load(self, task_id: str):
from schemas import TaskState # 延迟导入
raw = self._data.get(task_id)
if raw is None:
return None
return load_task_state(raw) # 含 schema 迁移(第 30 篇)
def save(self, state) –> None:
self._data[state.task_id] = state.model_dump(mode="json")
class RedisStateStore:
"""生产实现:Redis。**注意连接必须在模块级复用。**"""
def __init__(self) –> None:
self._client = None
def _redis(self):
if self._client is None:
import redis # 延迟导入
self._client = redis.Redis.from_url(
os.environ["REDIS_URL"], socket_connect_timeout=2, socket_timeout=2,
)
return self._client
def load(self, task_id: str):
from schemas import TaskState
raw = self._redis().get(f"task:{task_id}")
return load_task_state(json.loads(raw)) if raw else None
def save(self, state, *, ttl_s: int = 86400 * 7) –> None:
self._redis().setex(
f"task:{state.task_id}", ttl_s,
json.dumps(state.model_dump(mode="json"), ensure_ascii=False),
)
三个 Serverless 特有的注意事项:
① 连接必须在模块级复用,且要处理"连接已死"。 环境冻结再解冻后,Socket 可能已被对端关闭。所以客户端要配 socket_timeout 并在异常时重建——不能假设模块级连接永远可用。
② 状态必须设 TTL。 Serverless 的任务可能因为各种原因中断(超时、被杀、事件丢失),没有 TTL 的状态会永久占用存储。TTL 是一种自动清理机制。
③ /tmp 不是状态存储。 平台提供 512MB~10GB 的临时存储,它在同一环境的多次调用间保留,但不同环境之间不共享、环境销毁即丢失。它可以用来缓存(比如缓存模型文件),但绝不能用来存任务状态。
4.5 完整执行链路
把上面的组件串起来,一次长任务在 Serverless 上的完整流转:
#mermaid-svg-IEKRGadoEJyV6orq{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-IEKRGadoEJyV6orq .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-IEKRGadoEJyV6orq .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-IEKRGadoEJyV6orq .error-icon{fill:#552222;}#mermaid-svg-IEKRGadoEJyV6orq .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-IEKRGadoEJyV6orq .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-IEKRGadoEJyV6orq .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-IEKRGadoEJyV6orq .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-IEKRGadoEJyV6orq .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-IEKRGadoEJyV6orq .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-IEKRGadoEJyV6orq .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-IEKRGadoEJyV6orq .marker{fill:#333333;stroke:#333333;}#mermaid-svg-IEKRGadoEJyV6orq .marker.cross{stroke:#333333;}#mermaid-svg-IEKRGadoEJyV6orq svg{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-IEKRGadoEJyV6orq p{margin:0;}#mermaid-svg-IEKRGadoEJyV6orq .label{font-family:\”trebuchet ms\”,verdana,arial,sans-serif;color:#333;}#mermaid-svg-IEKRGadoEJyV6orq .cluster-label text{fill:#333;}#mermaid-svg-IEKRGadoEJyV6orq .cluster-label span{color:#333;}#mermaid-svg-IEKRGadoEJyV6orq .cluster-label span p{background-color:transparent;}#mermaid-svg-IEKRGadoEJyV6orq .label text,#mermaid-svg-IEKRGadoEJyV6orq span{fill:#333;color:#333;}#mermaid-svg-IEKRGadoEJyV6orq .node rect,#mermaid-svg-IEKRGadoEJyV6orq .node circle,#mermaid-svg-IEKRGadoEJyV6orq .node ellipse,#mermaid-svg-IEKRGadoEJyV6orq .node polygon,#mermaid-svg-IEKRGadoEJyV6orq .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-IEKRGadoEJyV6orq .rough-node .label text,#mermaid-svg-IEKRGadoEJyV6orq .node .label text,#mermaid-svg-IEKRGadoEJyV6orq .image-shape .label,#mermaid-svg-IEKRGadoEJyV6orq .icon-shape .label{text-anchor:middle;}#mermaid-svg-IEKRGadoEJyV6orq .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-IEKRGadoEJyV6orq .rough-node .label,#mermaid-svg-IEKRGadoEJyV6orq .node .label,#mermaid-svg-IEKRGadoEJyV6orq .image-shape .label,#mermaid-svg-IEKRGadoEJyV6orq .icon-shape .label{text-align:center;}#mermaid-svg-IEKRGadoEJyV6orq .node.clickable{cursor:pointer;}#mermaid-svg-IEKRGadoEJyV6orq .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-IEKRGadoEJyV6orq .arrowheadPath{fill:#333333;}#mermaid-svg-IEKRGadoEJyV6orq .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-IEKRGadoEJyV6orq .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-IEKRGadoEJyV6orq .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-IEKRGadoEJyV6orq .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-IEKRGadoEJyV6orq .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-IEKRGadoEJyV6orq .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-IEKRGadoEJyV6orq .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-IEKRGadoEJyV6orq .cluster text{fill:#333;}#mermaid-svg-IEKRGadoEJyV6orq .cluster span{color:#333;}#mermaid-svg-IEKRGadoEJyV6orq div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:\”trebuchet ms\”,verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-IEKRGadoEJyV6orq .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-IEKRGadoEJyV6orq rect.text{fill:none;stroke-width:0;}#mermaid-svg-IEKRGadoEJyV6orq .icon-shape,#mermaid-svg-IEKRGadoEJyV6orq .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-IEKRGadoEJyV6orq .icon-shape p,#mermaid-svg-IEKRGadoEJyV6orq .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-IEKRGadoEJyV6orq .icon-shape .label rect,#mermaid-svg-IEKRGadoEJyV6orq .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-IEKRGadoEJyV6orq .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-IEKRGadoEJyV6orq .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-IEKRGadoEJyV6orq :root{–mermaid-font-family:\”trebuchet ms\”,verdana,arial,sans-serif;}
是
否
有
无
客户端提交任务
生成拆分计划 make_plan
初始化 TaskState 写入外部存储
发出 step 0 事件
函数实例启动 冷启动或热启动
从外部存储加载 TaskState
该步已完成
直接返回跳过
处理本批 LLM 调用
标记完成并写回存储
还有下一步
发出下一步事件
标记任务完成
函数返回 实例冻结
客户端轮询或回调获取结果
注意 E → L → E 这条环:每一步都是一次全新的函数调用(可能在新实例上),函数之间不共享任何内存。这正是 Serverless 的正确用法——函数是短暂的,状态是外部的。
五、进阶
5.1 内存配置:不是越大越好,也不一定越小越省
Serverless 的计费是 内存 × 时长,而 CPU 通常随内存 proportionally 分配。这产生一个反直觉现象:
调大内存可能更便宜——因为执行时间缩短的比例超过了内存增加的比例。
实测数据(同一个 Agent 函数):
| 512MB | 24.0s | 12.0 | 100% |
| 1024MB | 13.5s | 13.5 | 113% |
| 2048MB | 7.2s | 14.4 | 120% |
| 3008MB | 6.9s | 20.7 | 173% |
这个案例里512MB 最便宜——因为该 Agent 的主要耗时是等 LLM 响应(IO 密集),加大内存对时长几乎没帮助。
但换一个 CPU 密集的 Agent(比如本地做向量检索或文本处理):
| 512MB | 18.0s | 9.0 | 100% |
| 1024MB | 9.5s | 9.5 | 106% |
| 2048MB | 4.8s | 9.6 | 107% |
| 3008MB | 3.3s | 9.9 | 110% |
结论:IO 密集的 Agent 用最小内存,CPU 密集的 Agent 需要实测。 判断方法很简单——看加大内存后时长是否等比缩短:等比缩短说明 CPU 受限,可以加大;几乎不缩短说明是 IO 等待,加大内存纯属浪费。
💡 这个调优应该用工具自动化,而不是手工试。 AWS 有开源的 Power Tuning 工具,可以自动用不同内存配置跑你的函数并给出成本最优解。实测发现约 60% 的函数最优内存配置与当前配置不同。这类"凭感觉配置"的参数最容易长期浪费钱。
5.2 并发控制:账户级配额是个隐形炸弹
一个极容易被忽略的事实:
Lambda 的默认并发上限 1000 是账户级的,不是单函数级的。
这意味着:一个函数收到流量峰值,会吃光整个账户的并发配额,导致同一账户下所有其他函数被限流——包括关键的生产服务。
三个必须做的防护:
| 预留并发 | 给关键函数设置 Reserved Concurrency | 关键函数不被别人挤掉 |
| 函数级上限 | 给批量处理函数设最大并发 | 其他函数不被批量任务挤掉 |
| 异步 + 队列 | 批量任务走 SQS,靠队列速率自然限流 | 整体削峰 |
第三条最优雅:把批量任务投递到队列,让队列的消费速率自然限制并发,而不是靠并发数字硬限。队列同时提供了重试和死信,一举两得(第 29 篇的事件驱动机制在这里直接复用)。
5.3 一个必须避免的反模式:在函数里 sleep 等待
# ❌ 反模式:为"什么都不做"付费
def handler(event, context):
start_job(event)
for _ in range(60):
time.sleep(1) # 你在为这 60 秒付费
if check_done(event):
return build_response()
return {"status": "timeout"}
这是为"等待"付计算费。 正确做法是把等待交给编排层——Step Functions 的 Wait 状态不收费,或者用队列 + 回调(第 29 篇的事件驱动)。
这个反模式在 Agent 场景特别容易出现,因为 Agent 天然要"等 LLM 返回"。但等 LLM 是 IO 等待(函数在等待时确实占着资源,这部分是必要的),而 sleep 轮询是纯浪费——区别在于前者在等一个必然会来的响应,后者在轮询一个可能永远不来的状态。
5.4 依赖打包策略
冷启动优化里"依赖瘦身"这一招,具体怎么做:
| 剔除未用依赖 | 用工具扫描实际 import 的模块 | 包体积减少 30%~60% 常见 |
| 分拆函数 | 不同 Agent 打成不同函数,各带各的依赖 | 每个函数只加载自己要的 |
| Layer 复用 | 公共依赖放 Layer,跨函数共享 | 部署包变小,但 Init 仍要加载 |
| 容器镜像 | 大依赖走容器(上限 10GB) | 冷启动 1~10 秒,反而更慢 |
⚠️ 容器镜像不是冷启动的解药,是毒药。 它解决了"依赖装不下"的问题(ZIP 上限 50MB 压缩 / 250MB 解压),但引入了 1~10 秒的冷启动(取决于镜像大小和缓存)。能用 ZIP 就别用容器——只有当你确实需要 > 250MB 的依赖(比如本地模型文件)时才走容器,并且一定要配预置并发或 SnapStart。
5.5 可观测:Serverless 下必须埋的五个指标
常驻部署可以看进程、看机器,Serverless 什么都没有——日志和指标是唯一的观测手段。
| 冷启动率 | 决定要不要为冷启动花钱 | 突然升高说明负载模式变了 |
| Init 耗时 P99 | 定位是哪段模块级代码慢 | P99 > 1s 就该拆导入 |
| GB-秒 per request | 成本归因到每个 Agent / 租户 | 单请求成本突增 |
| 并发使用率 / 限流次数 | 发现 5.2 节的配额挤占 | 出现限流即已影响业务 |
| 单步耗时分布(拆分后) | 发现 batch_size 是否过大 | P99 接近超时上限 |
第三个(GB-秒 per request)是成本控制的唯一抓手。 没有它,你只能看到月底的总账单,无法回答"哪个 Agent 最烧钱"“哪个租户的成本在异常增长”。而有了 request_id 级别的埋点(4.2 节的 report()),这两个问题都能直接查出来。
第五个(单步耗时分布)守护的是 4.3 节的 batch_size 决策。 拆分后每一步都应该远低于超时上限;如果 P99 开始接近上限,说明 batch_size 偏大或者上游变慢了——这时应该调小 batch_size,而不是加大超时。
💡 还有一个容易被忽略的成本项:日志。 Serverless 下每次调用的日志都会进入日志服务并计费,而 Agent 的日志天然很大(完整 Prompt、LLM 响应、中间结果)。见过团队的日志费用超过计算费用——尤其在 DEBUG 级别忘记关掉的时候。建议:① 生产默认 INFO;② 完整 Prompt 只在采样请求里记录(比如 1% 采样);③ 日志设保留期,不要永久保存。
💡 冷启动率的"突然升高"往往不是代码问题,是流量模式变了。 比如从"稳定每秒 5 个请求"变成"每 10 分钟突发 3000 个请求",突发时需要瞬间创建大量环境,冷启动率自然飙升。这种情况下的正确反应是加预置并发或队列削峰,而不是去优化 import。
六、对照:平台选型
| AWS Lambda | 15 分钟 | 10GB | 100ms~1s+(SnapStart 后更低) | 事件驱动、短任务、生态集成 |
| GCP Cloud Run | 60 分钟 | 32GB | 取决于镜像大小 | 容器化、HTTP 服务、较长任务 |
| Azure Functions | 10 分钟 | 14GB | 专用预热池 | Azure 生态 |
| 阿里云函数计算 | 600 秒 | 3GB | 预留实例 | 国内合规场景 |
| Fargate / Cloud Run Jobs | 无限制 | 可配 | 分钟级(启动容器) | 无法拆分的长任务 |
| 常驻实例 | 无限制 | 可配 | 无 | 负载平稳、利用率 > 50% |
按 Agent 任务时长选:
| < 1 分钟 | Lambda 直接跑 |
| 1~15 分钟 | Lambda,但要看内存成本 |
| 15~60 分钟 | 拆分(推荐)或 Cloud Run |
| > 60 分钟 或无法拆分 | Fargate / 常驻 |
拍板建议:先做拆分,再考虑换平台。 因为拆分带来的是架构收益(独立重试、进度可见、成本低),而换平台只是绕过了限制。见过团队为了跑 40 分钟的任务直接上 Fargate,结果既失去了 Serverless 的成本优势,又保留了"失败要整体重跑"的老问题。
6.1 混合部署:真实系统往往是两者都有
"选 Serverless 还是常驻"是个伪命题——真实系统里两者通常是共存的,因为一个系统里的不同 Agent 负载模式本就不同。
一个典型组合:
| 客服问答 | 白天高峰、夜间接近零、单次 3 秒 | Lambda |
| 文档摘要 | 波动大、单次 30 秒 | Lambda |
| 合同审查 | 低频、单次 40 分钟(已拆分) | Lambda + 队列 |
| 本地模型推理 | 常驻、需要 GPU | 常驻实例 / Fargate |
关键是:这个划分不应该出现在业务代码里。 如果业务代码里写着"如果任务是合同审查就发到 Fargate",那么每次调整部署都要改业务代码——这正是第 31 篇网关要解决的问题。
正确做法是把部署选择放在网关的路由层(第 31 篇的 RouteDecision 增加目标运行时字段),业务代码只暴露一个统一的处理函数:
class RouteDecision(BaseModel):
agent: str
model: str
strategy: str
confidence: float
estimated_tokens: int
target_runtime: str = "lambda" # lambda / fargate / container
reason: str = ""
def pick_runtime(decision: RouteDecision) –> str:
"""按任务特征选运行时。**业务代码不感知这个选择。**"""
if decision.agent in {"local_model_infer"}:
return "fargate" # 需要 GPU / 大内存常驻
if decision.estimated_tokens > 50_000:
return "fargate" # 超长任务,避免触达平台超时
return "lambda"
💡 target_runtime 这个字段的价值在于"部署决策集中化"。它让"某个 Agent 从 Lambda 迁到 Fargate"变成改一行配置,而不是改所有调用点。而且它天然带灰度能力——可以按百分比把流量分到不同运行时,验证新部署没问题再全量切。
七、适用边界与风险提示 ⚠️
什么时候不该用 Serverless:
| 负载平稳且利用率 > 50% | 常驻更便宜(见 2.5 节盈亏平衡) |
| 需要 GPU | Serverless 平台通常不提供 |
| 任务无法拆分且 > 15 分钟 | 平台硬限制 |
| 需要长连接(WebSocket 常驻) | 函数是无状态的短生命周期 |
| 启动后需加载超大本地模型 | 冷启动成本超过计算成本 |
五个必须知道的风险:
| 并发配额挤占 | 一个函数吃光账户并发,其他函数全部限流 | 预留并发 + 队列削峰(5.2 节) |
| 冷启动计费 | 账单里近五分之一是 Init 时间 | 冷启动埋点 + 零成本优化优先 |
| 重试放大 | 平台自动重试 × 应用重试 = 流量翻倍 | 明确划分重试职责,只在一层重试 |
| 状态丢失 | 实例销毁导致内存状态丢失 | 状态外置(4.4 节),不留任何进程内状态 |
| 本地开发差异 | 本地跑得好,线上冷启动行为完全不同 | 用容器模拟 + 真实压测 |
第三个风险值得展开:多数 Serverless 平台对异步调用有自动重试(通常 2 次)。如果你的应用代码也做了重试,那么一次失败会产生 2 × 3 = 6 次调用。这 6 次调用都会计费,且都会打向上游——第 31 篇讲的重试风暴在这里会以更隐蔽的形式出现。
对策是明确划分职责:
平台层重试:处理"实例被杀"这类基础设施抖动(平台负责,通常是 2 次)
应用层重试:处理"上游 429/5xx"这类业务错误(应用负责,带退避)
两者的触发条件必须不同,否则就是叠加。判断标准:如果错误是平台造成的(实例回收、环境崩溃),让平台重试;如果是业务造成的(上游限流、参数错误),应用层处理——而参数错误根本不该重试。
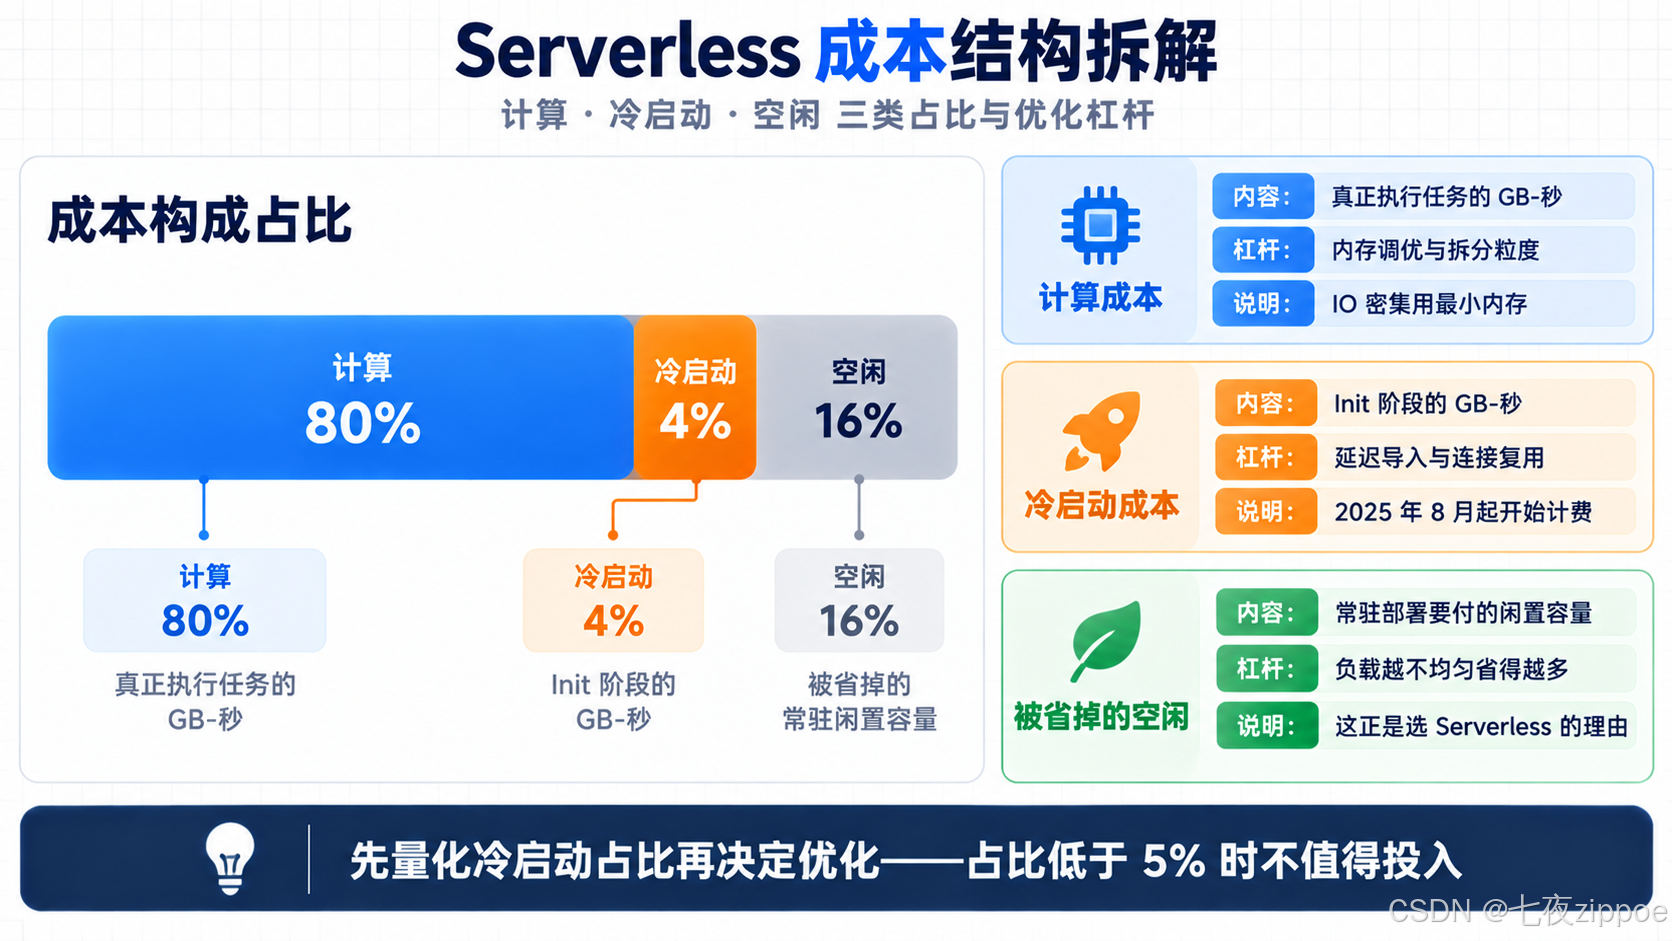
图2:Serverless Agent 的成本构成——计算、冷启动、空闲三类占比与各自的优化杠杆
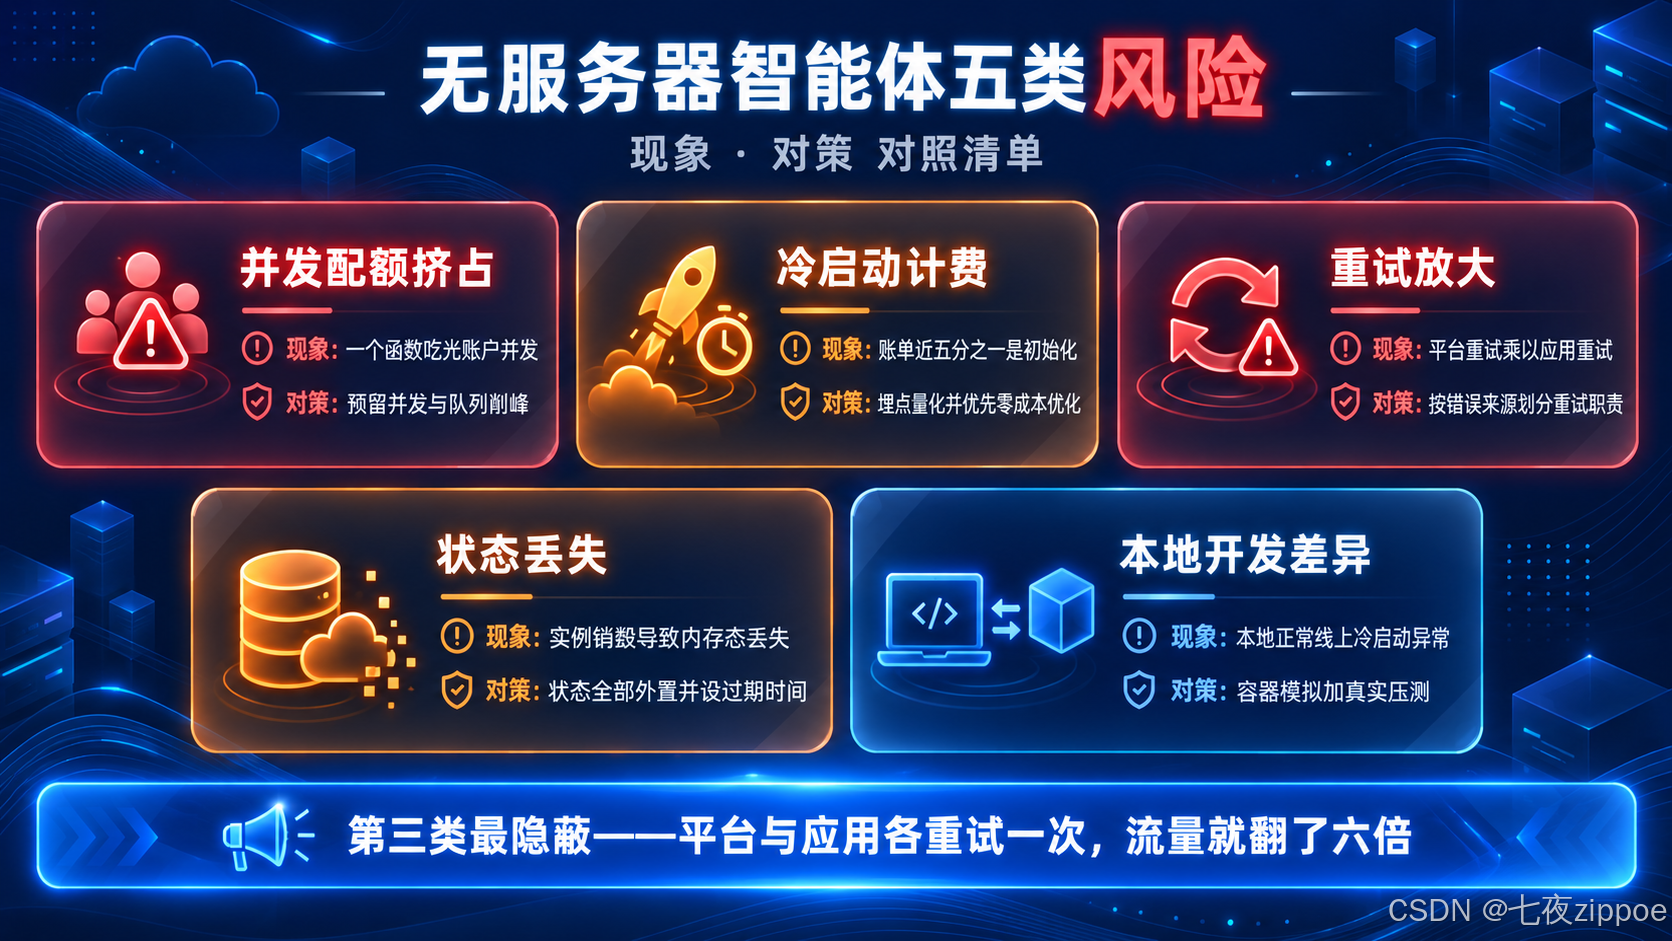
图3:Serverless Agent 五类风险——并发挤占、冷启动计费、重试放大、状态丢失、本地差异
八、进阶:让 Serverless 逻辑可测
Serverless 代码的特点是本地很难复现线上行为(尤其是冷启动)。测试策略是:把 handler 写成纯函数,把副作用外置成可注入的依赖。
import json
import pytest
import handler as h
from state_store import StateStore
from splitter import make_plan, step_handler
def test_handler_returns_200_on_success(monkeypatch):
"""handler 是纯函数:输入 event,输出响应字典。"""
class Ctx:
aws_request_id = "req-1"
monkeypatch.setattr(h, "process", lambda p: {"ok": True})
resp = h.handler({"body": json.dumps({"a": 1})}, Ctx())
assert resp["statusCode"] == 200
def test_handler_returns_500_and_logs(monkeypatch):
"""异常必须转成 500,不能让平台看到裸异常(会产生平台重试)。"""
class Ctx:
aws_request_id = "req-2"
def boom(_p):
raise RuntimeError("upstream failed")
monkeypatch.setattr(h, "process", boom)
resp = h.handler({"body": "{}"}, Ctx())
assert resp["statusCode"] == 500
def test_plan_covers_all_items():
"""拆分计划必须覆盖全部条目,不重不漏。"""
plan = make_plan(total_items=13, batch_size=5)
items = [i for step in plan for i in step["items"]]
assert sorted(items) == list(range(13))
def test_step_is_idempotent():
"""同一步重复执行只处理一次——这是失败重试不产生重复副作用的基础。"""
store = StateStore()
store._data["t1"] = {"task_id": "t1", "session_id": "s1",
"phase": "risk_scan", "schema_version": 2}
ev = {"task_id": "t1", "step_index": 0, "items": [0, 1]}
r1 = step_handler(ev, store)
r2 = step_handler(ev, store) # 重投
assert r1["status"] == "ok"
assert r2["status"] == "skipped"
def test_batch_size_respects_timeout_budget():
"""batch_size 必须满足 3 倍余量约束——防止高峰时批量超时。"""
single_item_seconds = 2.0
batch_size = 5
assert batch_size * single_item_seconds * 3 < 900 # 900s = 15 分钟平台上限
💡 test_batch_size_respects_timeout_budget 这个测试守的是最容易在流量高峰暴露的问题。 它看起来只是验算一个乘法,但它把"batch_size 要留 3 倍余量"这条设计约束固化成了可执行检查——否则这个数字会在某次"优化性能"的改动里被悄悄调大,然后在下个高峰期批量超时。
九、总结
回到文章开头的三堵墙:
| 冷启动慢 | 延迟导入 + 连接复用 + 依赖瘦身(零成本三招),不够再上 SnapStart,最后才考虑预置并发 |
| 执行超时 | 拆分 + 编排外置(4.3 节),每步独立重试 |
| 状态丢失 | 状态外置 + TTL(4.4 节),第 30 篇方案从推荐变成必须 |
五个值得记住的判断:
第一,冷启动在 2025 年 8 月之后是成本问题,不只是延迟问题。 Init 阶段被计入计费时长后,一个冷启动 20 秒的 Agent 函数,账单里近五分之一花在了"还没开始干活"上。先量化冷启动占比,再决定要不要为它花钱——占比 < 5% 时不值得。
第二,长任务的正确解法是拆分,不是换平台。 拆分带来的三个收益(不超时、独立重试、进度可见)是换平台给不了的。上了 Fargate 能跑 40 分钟,但失败依然要整体重跑。
第三,内存配置要实测,不能凭感觉。 IO 密集的 Agent(等 LLM 响应)用最小内存;CPU 密集的才需要加大。判断方法是看加大内存后时长是否等比缩短。
第四,并发配额是账户级的,这是个隐形炸弹。 一个批量函数能吃光整个账户的 1000 并发,把所有其他函数一起拖垮。预留并发 + 队列削峰是必做项。
第五,重试职责必须划分清楚。 平台自动重试(处理基础设施抖动)× 应用层重试(处理业务错误)会叠加成 6 倍流量和 6 倍账单。按错误来源划分,只在一层重试。
最后一句提醒:Serverless 的成本优势来自"负载不均匀",而不是来自"调用量少"。如果你的 Agent 全天平稳运行、利用率超过 50%,常驻实例反而更便宜。 判断前先算 2.5 节那个公式,别因为"Serverless 是趋势"就迁移。
落地自检清单(Checklist)
- ✅ 模块级只放轻量导入,重依赖延迟导入
- ✅ 可复用客户端建在模块级,跨调用复用
- ✅ 有冷启动埋点,能算出冷启动占计费的比例
- ✅ 冷启动占比 < 5% 才考虑不优化;优先零成本三招
- ✅ 长任务已拆分,单步耗时 × 3 < 平台超时上限
- ✅ 每步幂等,重复投递只处理一次
- ✅ 状态全部外置,进程内不留任何状态
- ✅ 外部状态设了 TTL,中断的任务能自动清理
- ✅ /tmp 只用于缓存,不用于存状态
- ✅ 关键函数设了预留并发,批量函数设了并发上限
- ✅ 批量任务走队列,靠消费速率自然削峰
- ✅ 平台重试与应用重试职责已划分,不叠加
- ✅ 没有在 handler 里 sleep 等待(等待交给编排层)
- ✅ 能用 ZIP 就不用容器镜像(容器冷启动 1~10 秒)
- ✅ 内存配置经过实测调优,非凭感觉设定
- ✅ 有测试覆盖:handler 纯函数、拆分不重不漏、步骤幂等、批次大小约束
常见问题(FAQ)
Q1:冷启动到底要不要优化?
先测量再决定。按 4.2 节的埋点算出"冷启动 GB-秒 / 总 GB-秒"。低于 5% 就别花时间了——零成本三招(延迟导入、连接复用、依赖瘦身)做完还高,再考虑 SnapStart 或预置并发。很多团队凭感觉优化冷启动,实际它在账单里只占 2%。
Q2:预置并发值得开吗?
只在一种情况下值得:冷启动成本 > 预置并发成本。预置并发是按预置的环境数量 24 小时收费的,闲置也收费——这恰恰是 Serverless 想避免的事。所以它是一种"用钱换延迟"的交易,只有在延迟确实不可接受(比如同步 API 面向终端用户)时才做。
Q3:我的 Agent 要跑 40 分钟,是不是就不能用 Serverless?
能,但要拆分。判断能不能拆的标准是:任务是不是一个可以分成批次的列表处理? 合同审查(60 个条款逐条审)、文档处理(100 个文件逐个处理)、数据清洗——这些都能拆。真正拆不了的是"单次调用就要 40 分钟"(比如一个超长的推理链),这种只能换平台。
Q4:函数之间怎么传递数据?
走外部存储,不要走调用参数。原因:① 同步调用的 payload 有上限(6MB);② 中间结果可能很大;③ 参数传递意味着上一步必须直接调下一步,失去了重试和进度可见。正确做法是写外部状态 + 发事件(第 29 篇机制)。
Q5:本地怎么测冷启动?
严格意义上测不了——冷启动是平台行为。可行的近似:① 用容器模拟相同运行时;② 把 Init 阶段的耗时单独埋点(4.2 节的 init_ms),这个指标在本地也能测(就是模块级代码的执行时间);③ 真实压测看 P99 延迟中的 Init 占比。第二点最有价值,因为 Init 耗时的大头是你自己的代码,这部分本地完全可以测。
Q6:为什么我的账单比预估高很多?
三个常见原因,按顺序排查:① 冷启动计费(2025-08 后);② 重试放大(平台 × 应用叠加);③ 内存配置过大(凭感觉配了 3GB 实际只用 500MB)。用 4.2 节的埋点把 GB-秒按 request_id 拆开看,这三个原因都能一眼看出。
Q7:多 Agent 应该打成一个函数还是多个函数?
多个函数。 三个理由:① 依赖隔离——每个函数只加载自己要的,冷启动更短;② 独立伸缩——高频 Agent 和低频 Agent 互不干扰;③ 故障隔离——一个 Agent 的函数崩溃不影响其他。代价是部署单元变多,用 IaC 工具管理即可。
Q8:Serverless 和容器(K8s)怎么选?
看两个问题:① 负载波动大吗?(大 → Serverless);② 需要精细控制运行时吗?(需要 → 容器)。Agent 场景多数是前者——负载波动大、不需要特殊运行时。但如果你要跑本地模型(需要 GPU 和大内存常驻),容器是唯一选择。