/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
服务上线一段时间后,最常见的诉求不是"加个功能",而是"帮我查一下昨天下午三点左右那批请求为什么超时"。如果日志只是 print 到 stdout 再被容器运行时收走,这时候就只能 grep,而且 grep 的对象往往已经轮转删掉了。
我这边的情况是:一个 Python 写的 API 服务,跑在几台机器上,日志分散在各自主机的文件里。最开始用 grep + awk 也能凑合,但一旦要按 request_id 串起一次完整调用、或者统计某个接口的 P95 耗时,手写脚本就不太够用了。于是把日志收进 ELK。
这篇不讲 ELK 的概念科普,讲我实际怎么接进去的,索引怎么设计,以及哪些地方不设计好后面会很疼。
ELK 三个组件各自干什么
先把职责分清楚,不然配置写起来容易乱。
| Elasticsearch | 存储 + 检索 | 存日志文档,提供查询和聚合 |
| Logstash | 采集 + 解析 + 转换 | 从文件读日志,解析成结构化字段,写入 ES |
| Kibana | 查询 + 可视化 | 按接口、状态码、耗时做图表和检索 |
三者不是必须同时上。如果日志已经是 JSON 格式,其实可以跳过 Logstash,用 Filebeat 直接发到 ES,或者应用直接用 Python 的 elasticsearch 客户端写。我之所以还是用 Logstash,是因为历史日志是纯文本格式,需要在采集侧做正则解析,而且后面还要做字段增删,放在 Logstash 里改配置比改应用代码方便。
如果你的服务从一开始就输出 JSON 日志,我的建议是别上 Logstash,Filebeat 或者直接写 ES 都更轻。Logstash 是 JVM 进程,内存开销不小,为了一行正则养一个 JVM 不太划算。
用 docker compose 起一套能跑的环境
本地验证阶段我用 docker compose 起单节点,版本上 Elasticsearch 和 Kibana 必须一致,Logstash 也建议对齐大版本。我用的 8.x 系列,具体小版本以你拉到的镜像为准。
# docker-compose.yml
version: "3.8"
services:
elasticsearch:
image: docker.elastic.co/elasticsearch/elasticsearch:8.13.4
environment:
– discovery.type=single–node
– xpack.security.enabled=false
– ES_JAVA_OPTS=–Xms1g –Xmx1g
ports:
– "9200:9200"
volumes:
– es_data:/usr/share/elasticsearch/data
kibana:
image: docker.elastic.co/kibana/kibana:8.13.4
environment:
– ELASTICSEARCH_HOSTS=http://elasticsearch:9200
ports:
– "5601:5601"
depends_on:
– elasticsearch
logstash:
image: docker.elastic.co/logstash/logstash:8.13.4
volumes:
– ./logstash/pipeline:/usr/share/logstash/pipeline
– ./app–logs:/var/log/app:ro
ports:
– "5000:5000"
depends_on:
– elasticsearch
volumes:
es_data:
【注意】这里 xpack.security.enabled=false 只是为了本地跑通,生产环境一定要开安全认证,否则 9200 端口暴露出去等于把数据裸奔。这一点不用我多说。
ES_JAVA_OPTS 限制堆内存是必要的。ES 默认会按机器内存去推算堆大小,在开发机上经常把内存吃满。单节点测试 1g 够用。
索引设计:先想清楚按什么维度切
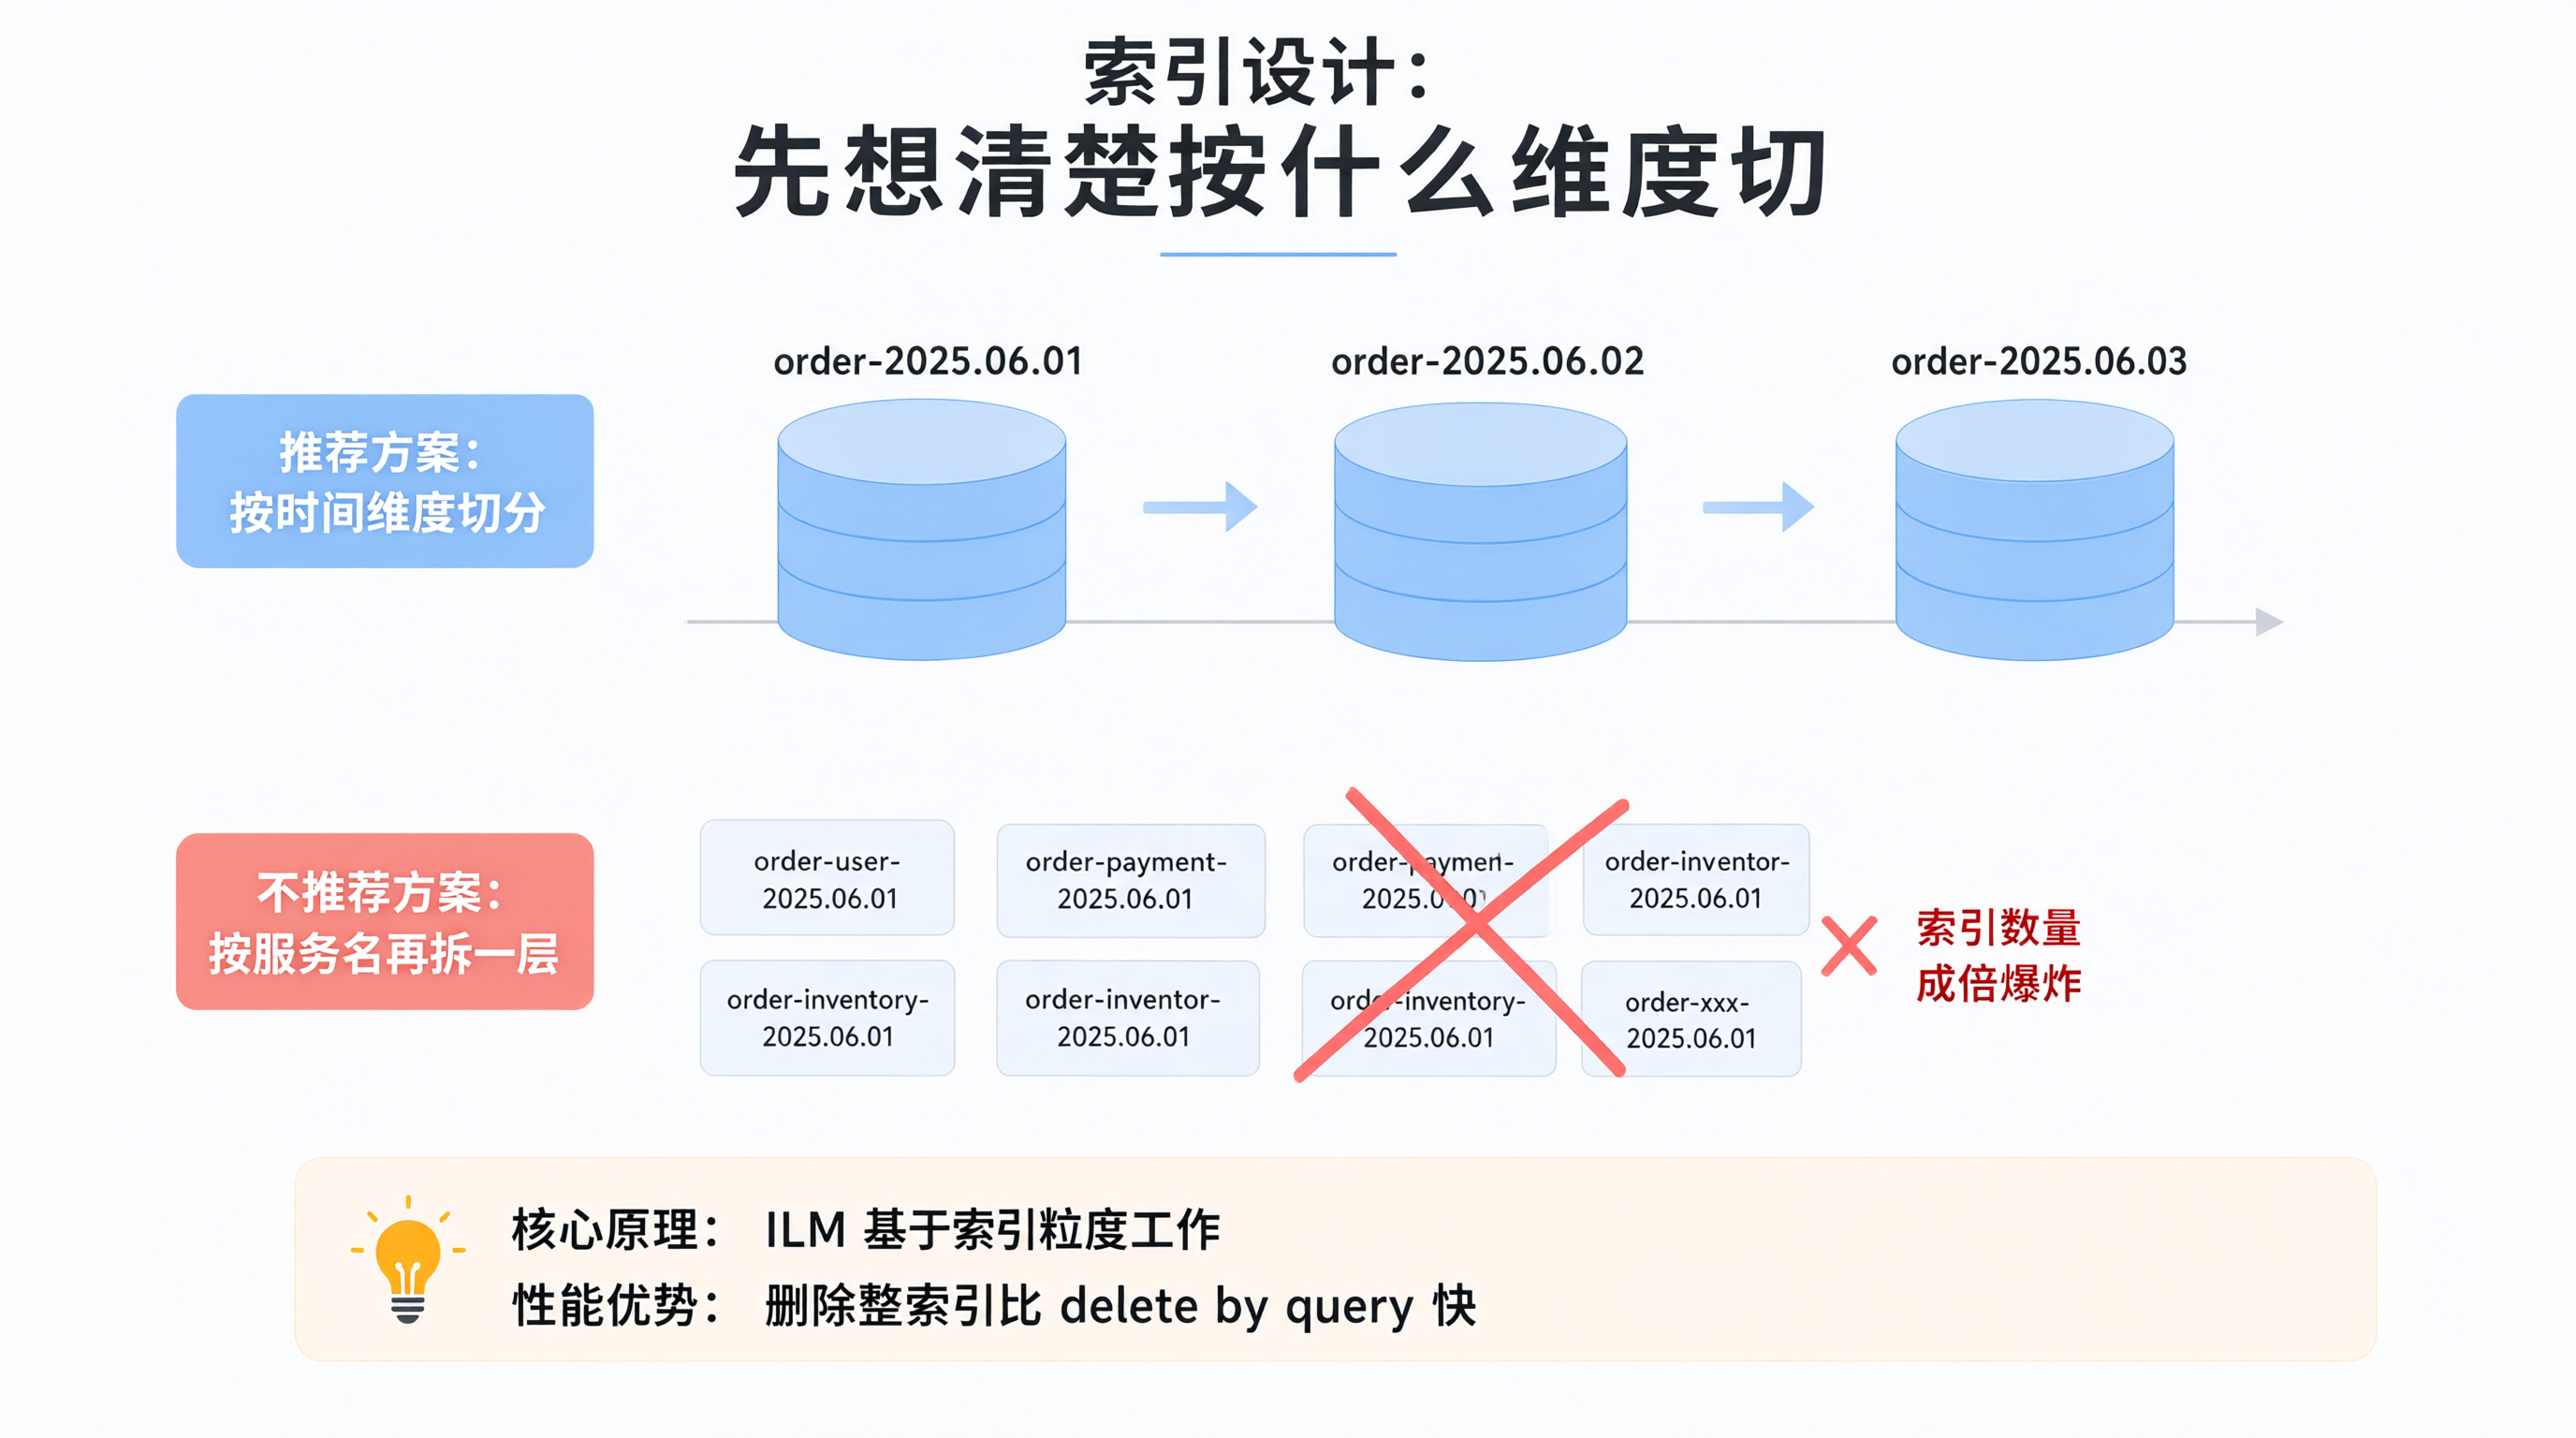
这是我觉得最容易做错的地方。很多人上来就用默认的 logstash-* 索引,所有日志混在一起,跑几个月之后发现索引大得没法管,删也删不动。
先说索引命名。日志类数据几乎都是时间序列,按天切索引是最常见的做法:
app-log-2025.06.01
app-log-2025.06.02
好处很直接:删老数据直接删整个索引,比 delete by query 快得多,也不会产生大量段合并压力。ES 的 ILM(索引生命周期管理)也是基于索引粒度工作的。
我一开始想的是按服务名再拆一层,比如 order-service-2025.06.01、user-service-2025.06.01。后来没这么做,因为服务数量一多,索引数量会爆炸,每个索引都有分片开销,集群的 shard 数量是有上限压力的。服务名做成字段,查询时用 filter 过滤就够了。
然后是 mapping。这一步必须在建索引之前定好,因为 ES 的字段类型一旦确定,后续只能有限地改。默认的动态 mapping 会把第一个见到的值决定类型,这就埋雷了。
举个实际的坑:日志里有个 http_status 字段,大部分时候是数字 200、404,动态 mapping 会把它识别成 long。但某天某个中间件在异常时打了一条 http_status: "-",这时候写入就会报错,整条日志被丢掉。反过来如果先见到字符串,后面又想按数值范围聚合(比如统计 5xx 数量),就聚合不了。
所以关键字段我都是显式定义 mapping,用索引模板:
PUT _index_template/app_log_template
{
"index_patterns": ["app-log-*"],
"template": {
"settings": {
"number_of_shards": 1,
"number_of_replicas": 0
},
"mappings": {
"properties": {
"@timestamp": { "type": "date" },
"service": { "type": "keyword" },
"level": { "type": "keyword" },
"logger": { "type": "keyword" },
"message": { "type": "text" },
"request_id": { "type": "keyword" },
"trace_id": { "type": "keyword" },
"path": { "type": "keyword" },
"method": { "type": "keyword" },
"http_status": { "type": "integer" },
"duration_ms": { "type": "float" },
"client_ip": { "type": "ip" }
}
}
}
}
几个字段类型的判断依据:
service、level、path、method 用 keyword。这些是要做精确过滤和聚合的,keyword 不分词,term 查询和 terms 聚合都快。如果用了 text,聚合时 ES 会报 fielddata 相关的错误,或者需要开 fielddata 吃内存。
message 用 text。这是唯一需要全文检索的字段,用户会搜关键词。如果同时也想对 message 做精确匹配,可以加一个 message.keyword 子字段,但日志正文通常很长,加子字段会让索引明显变大,我这边没加。
http_status 用 integer 而不是 keyword。因为要做范围查询,比如"查所有 5xx",用 http_status >= 500 比 http_status IN (500,501,…) 干净。前提是采集侧保证这个字段要么是合法整数,要么就不写入,不能塞 – 这种值。
duration_ms 用 float。耗时统计要算平均值、百分位,必须是数值类型。
client_ip 用 ip 类型。这样能支持 CIDR 范围查询,比如查某个网段的请求。
【踩坑提醒】http_status 这个字段,我在 Logstash 里做了强制转换,转不了的直接丢弃该字段而不是整条日志。具体做法后面 filter 部分说。
Logstash 管道:input、filter、output
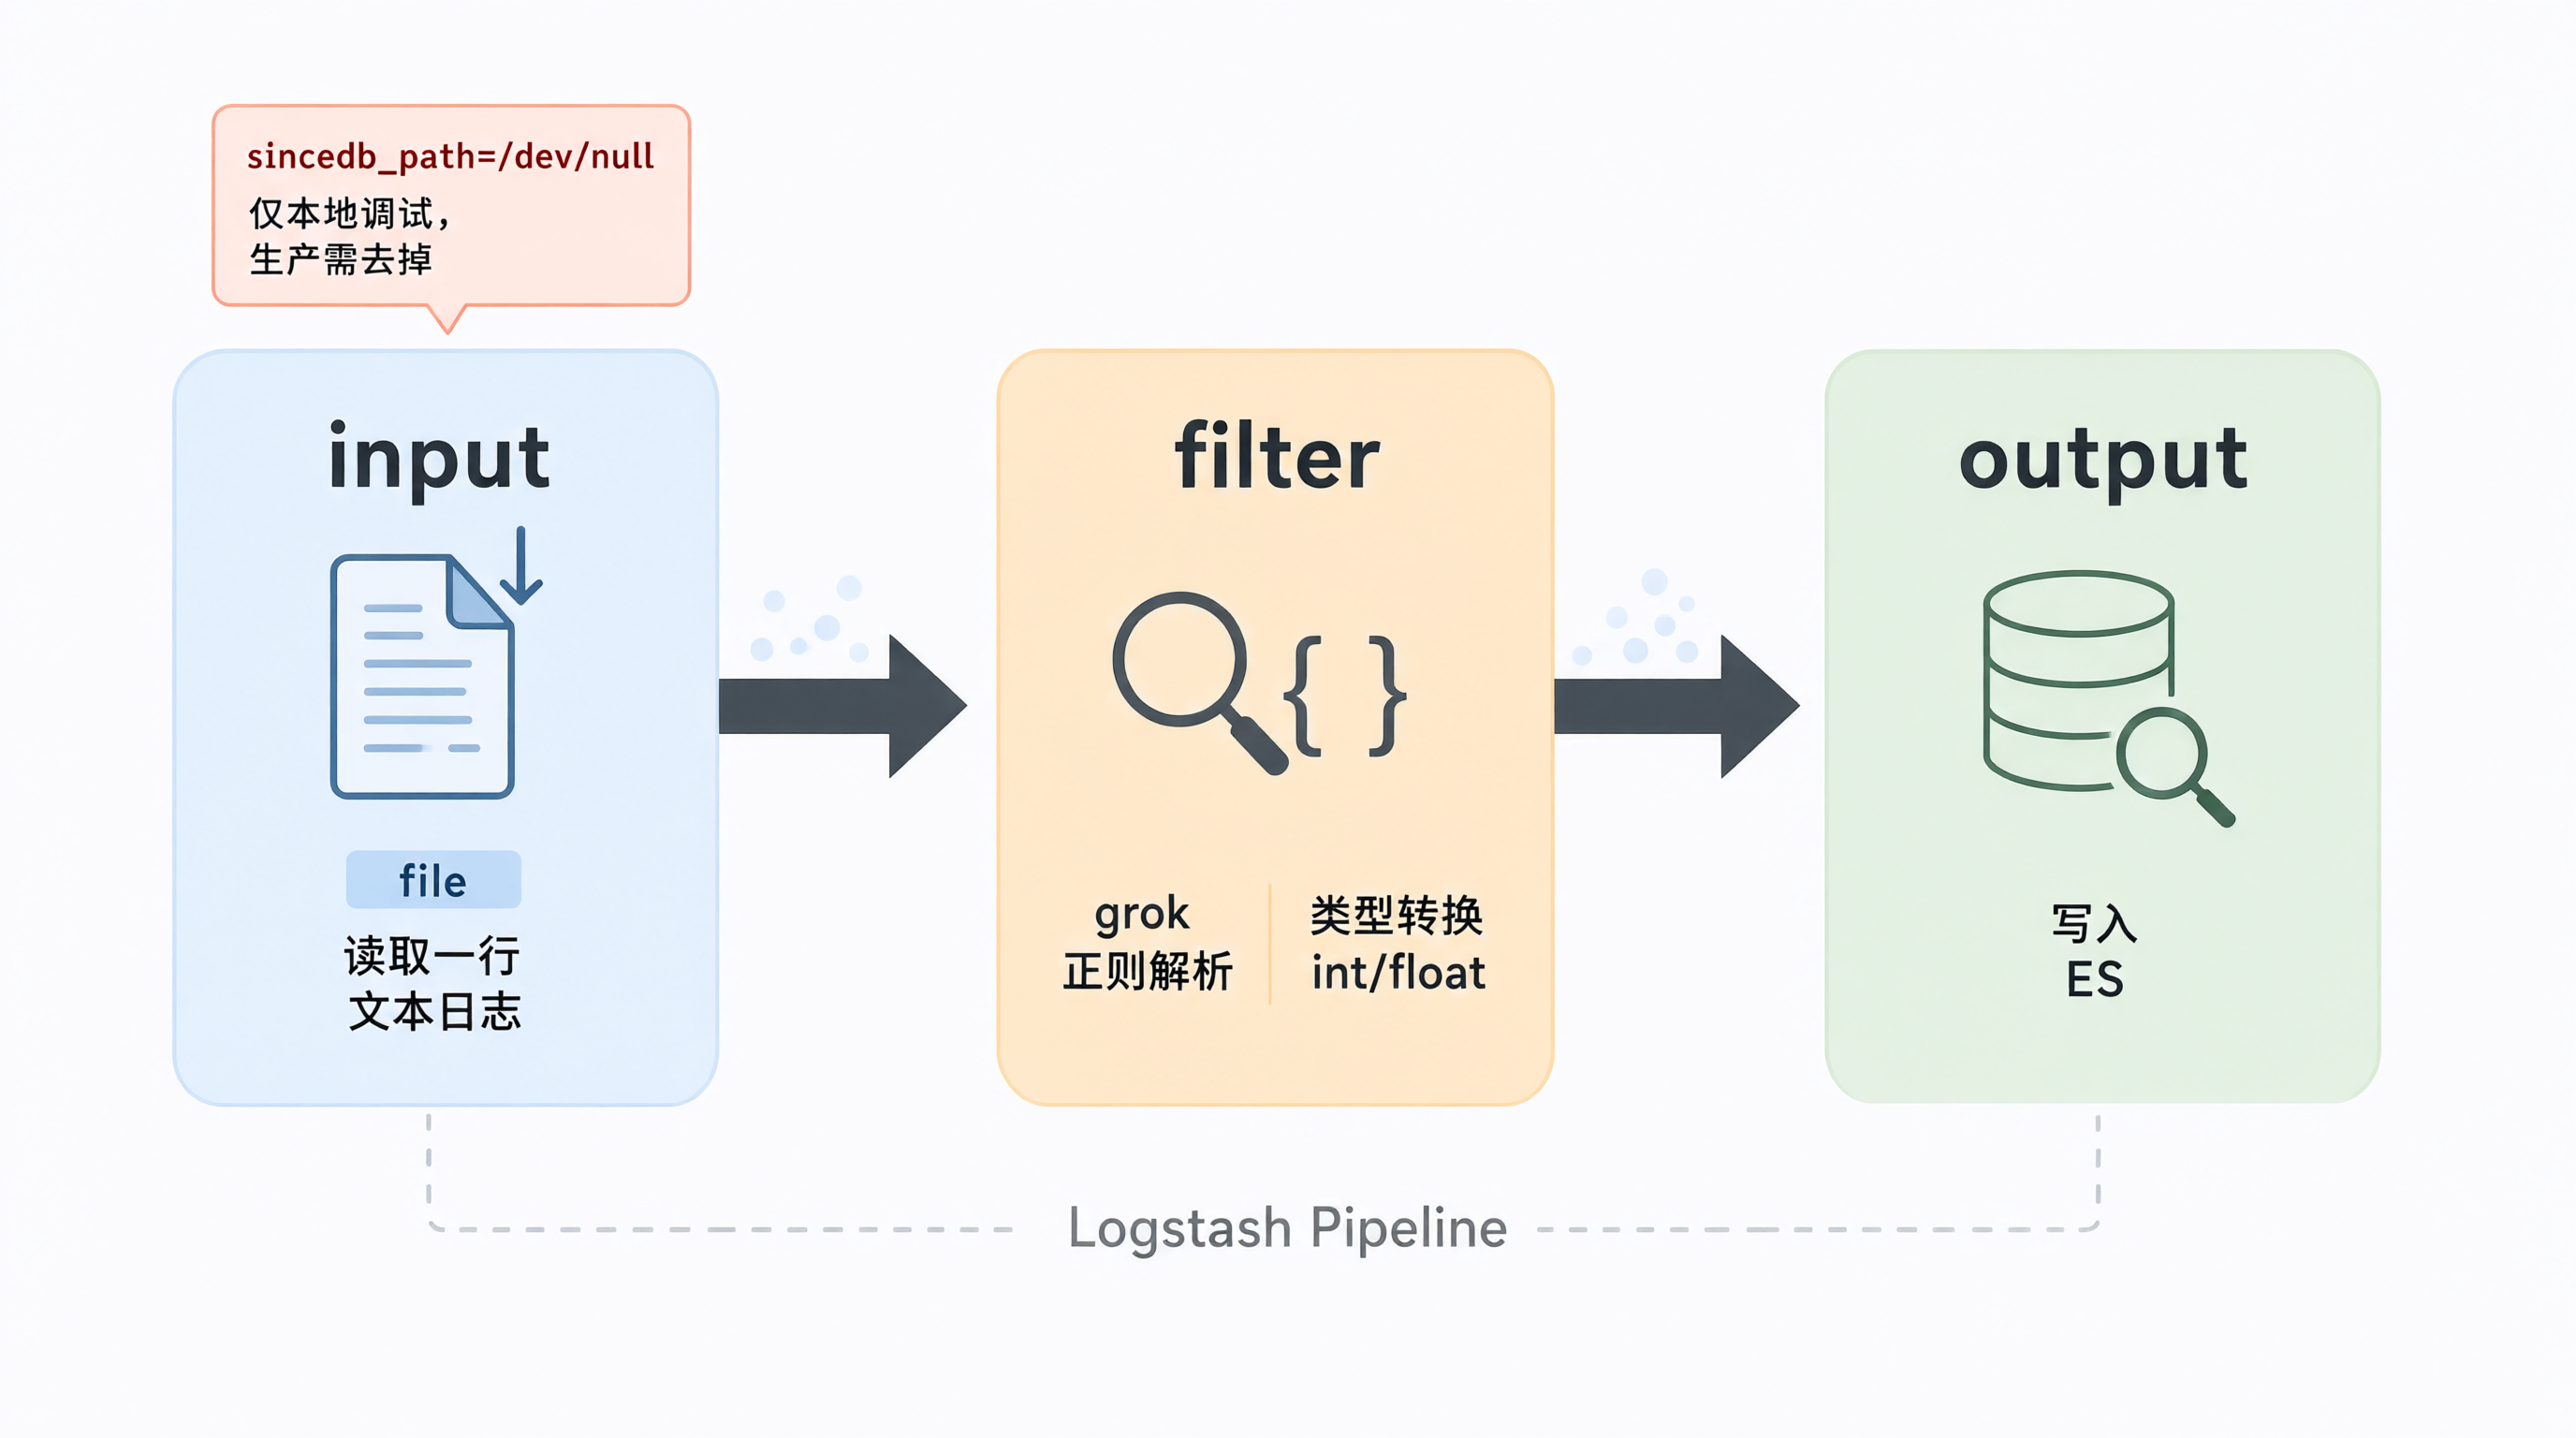
Logstash 的配置就三段。我的日志格式是这样的一行文本:
2025-06-01 14:23:11,234 INFO [order.service] [req-8f3a2b] POST /api/order/create 200 45.2ms
对应写正则解析。
# logstash/pipeline/app-log.conf
input {
file {
path => "/var/log/app/*.log"
start_position => "beginning"
sincedb_path => "/dev/null"
codec => plain {
charset => "UTF-8"
}
}
}
filter {
grok {
match => {
"message" => "%{TIMESTAMP_ISO8601:log_time} %{LOGLEVEL:level} \\[%{DATA:logger}\\] \\[%{DATA:request_id}\\] %{WORD:method} %{NOTSPACE:path} %{NUMBER:http_status:int} %{NUMBER:duration_ms:float}ms"
}
}
date {
match => ["log_time", "yyyy-MM-dd HH:mm:ss,SSS"]
target => "@timestamp"
timezone => "Asia/Shanghai"
}
if ![http_status] {
mutate {
remove_field => ["http_status"]
}
}
mutate {
remove_field => ["log_time", "event", "host", "path"]
add_field => { "service" => "order-service" }
}
}
output {
elasticsearch {
hosts => ["http://elasticsearch:9200"]
index => "app-log-%{+YYYY.MM.dd}"
}
}
逐段说下为什么这么写。
sincedb_path => "/dev/null" 是本地调试用的,它让 Logstash 每次都从头读文件,方便反复测试。生产环境必须去掉这行,否则每次重启都会重读全部日志,产生大量重复文档。
grok 里的类型转换 %{NUMBER:http_status:int} 和 %{NUMBER:duration_ms:float} 是 grok 自带的语法,匹配的同时做类型转换。如果日志里 http_status 位置是 -,这条 grok 就匹配不上,整条日志会落到 _grokparsefailure 标签里。所以我加了个判断,匹配失败时把不合法字段删掉,避免写入 ES 时因为类型不符被拒。
【关键结论】grok 匹配失败不会报错,它只是给文档打上 _grokparsefailure 标签然后继续往下走。如果你不主动检查,这些日志会静默地以非结构化形式进 ES,等你去 Kibana 查的时候才发现字段是空的。上线前一定要先看有没有这个标签的文档。
date 过滤器里 timezone 这一项很关键。日志里的时间是本地时间(东八区),ES 内部统一按 UTC 存。如果不指定时区,Logstash 会按它所在容器的时区去解析,容器默认通常是 UTC,结果就是所有日志时间差 8 小时。这个偏差在 Kibana 里看时间轴图会非常明显。
mutate 里删掉 path 字段是因为它和 Logstash 自动加的 [log][file][path] 重复了,而且我 grok 里的 path 其实是 URL 路径,和文件路径同名会冲突。这个命名冲突我一开始没注意,导致 Kibana 里按 path 过滤时数据对不上。
output 里 index => "app-log-%{+YYYY.MM.dd}" 用的是 Logstash 的事件时间,不是写入时间。这样补历史日志时索引日期才对得上。
在 Kibana 里建索引模式和可视化
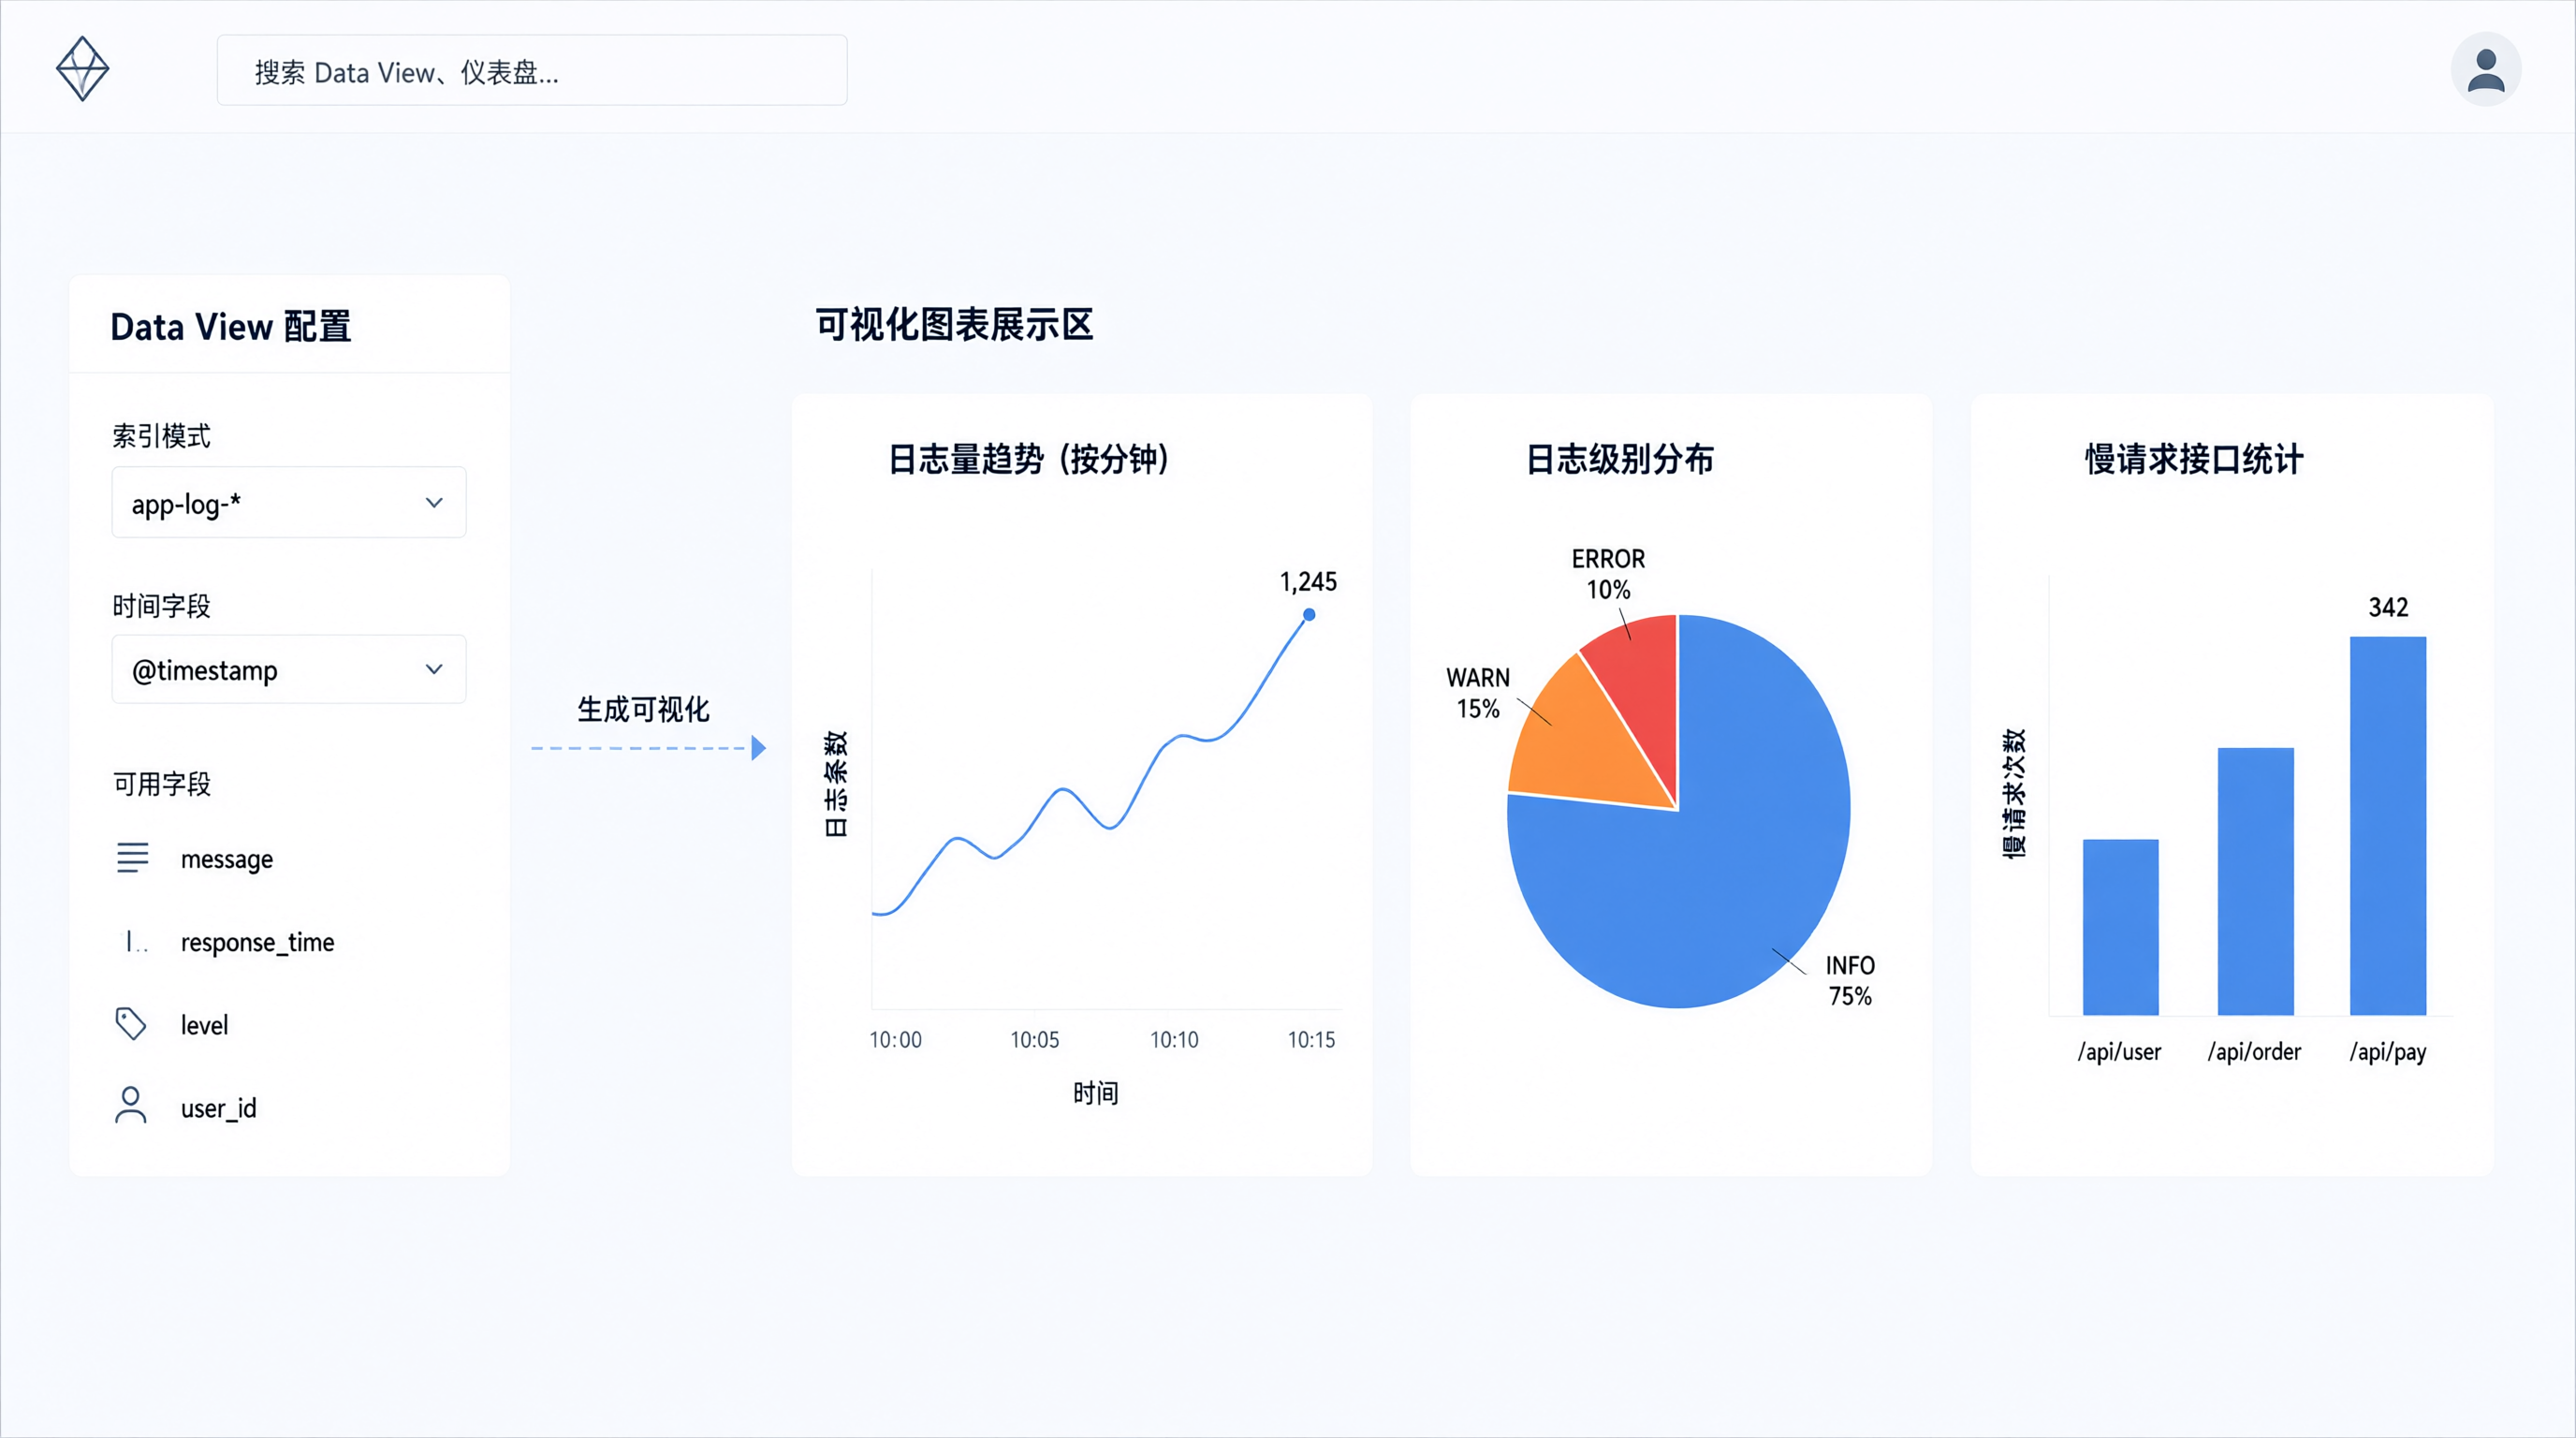
Kibana 8.x 里叫 Data View(老版本叫 Index Pattern)。建一个 app-log-* 的 Data View,时间字段选 @timestamp。
然后就可以在 Discover 里查了。几个我常用的查询:
按 request_id 串起一次调用:
request_id: "req-8f3a2b"
查某个接口的错误请求:
path: "/api/order/create" and http_status >= 500
查慢请求:
duration_ms > 1000
可视化方面,我建了几个基础图表:
耗时百分位这个需求,Kibana 的 Visualize 里可以用 Percentiles 聚合,选 duration_ms 字段,设 50、95、99 三个百分位。这个比平均值有意义得多,因为平均值会被少数极慢请求拉偏,也可能被大量极快请求掩盖。
【注意】duration_ms 要能做百分位聚合,前提是它真的是数值类型。如果前面 mapping 没定好被识别成了 keyword,这里会直接聚合不出来,只能重建索引。
几个实际会遇到的问题
索引数量膨胀。按天切索引,如果还按服务名再切一层,几百个服务就是几百个索引一天。每个索引至少一个分片,分片数上千之后集群的元数据管理压力就上来了。我的处理是索引只按天切,服务名做字段。
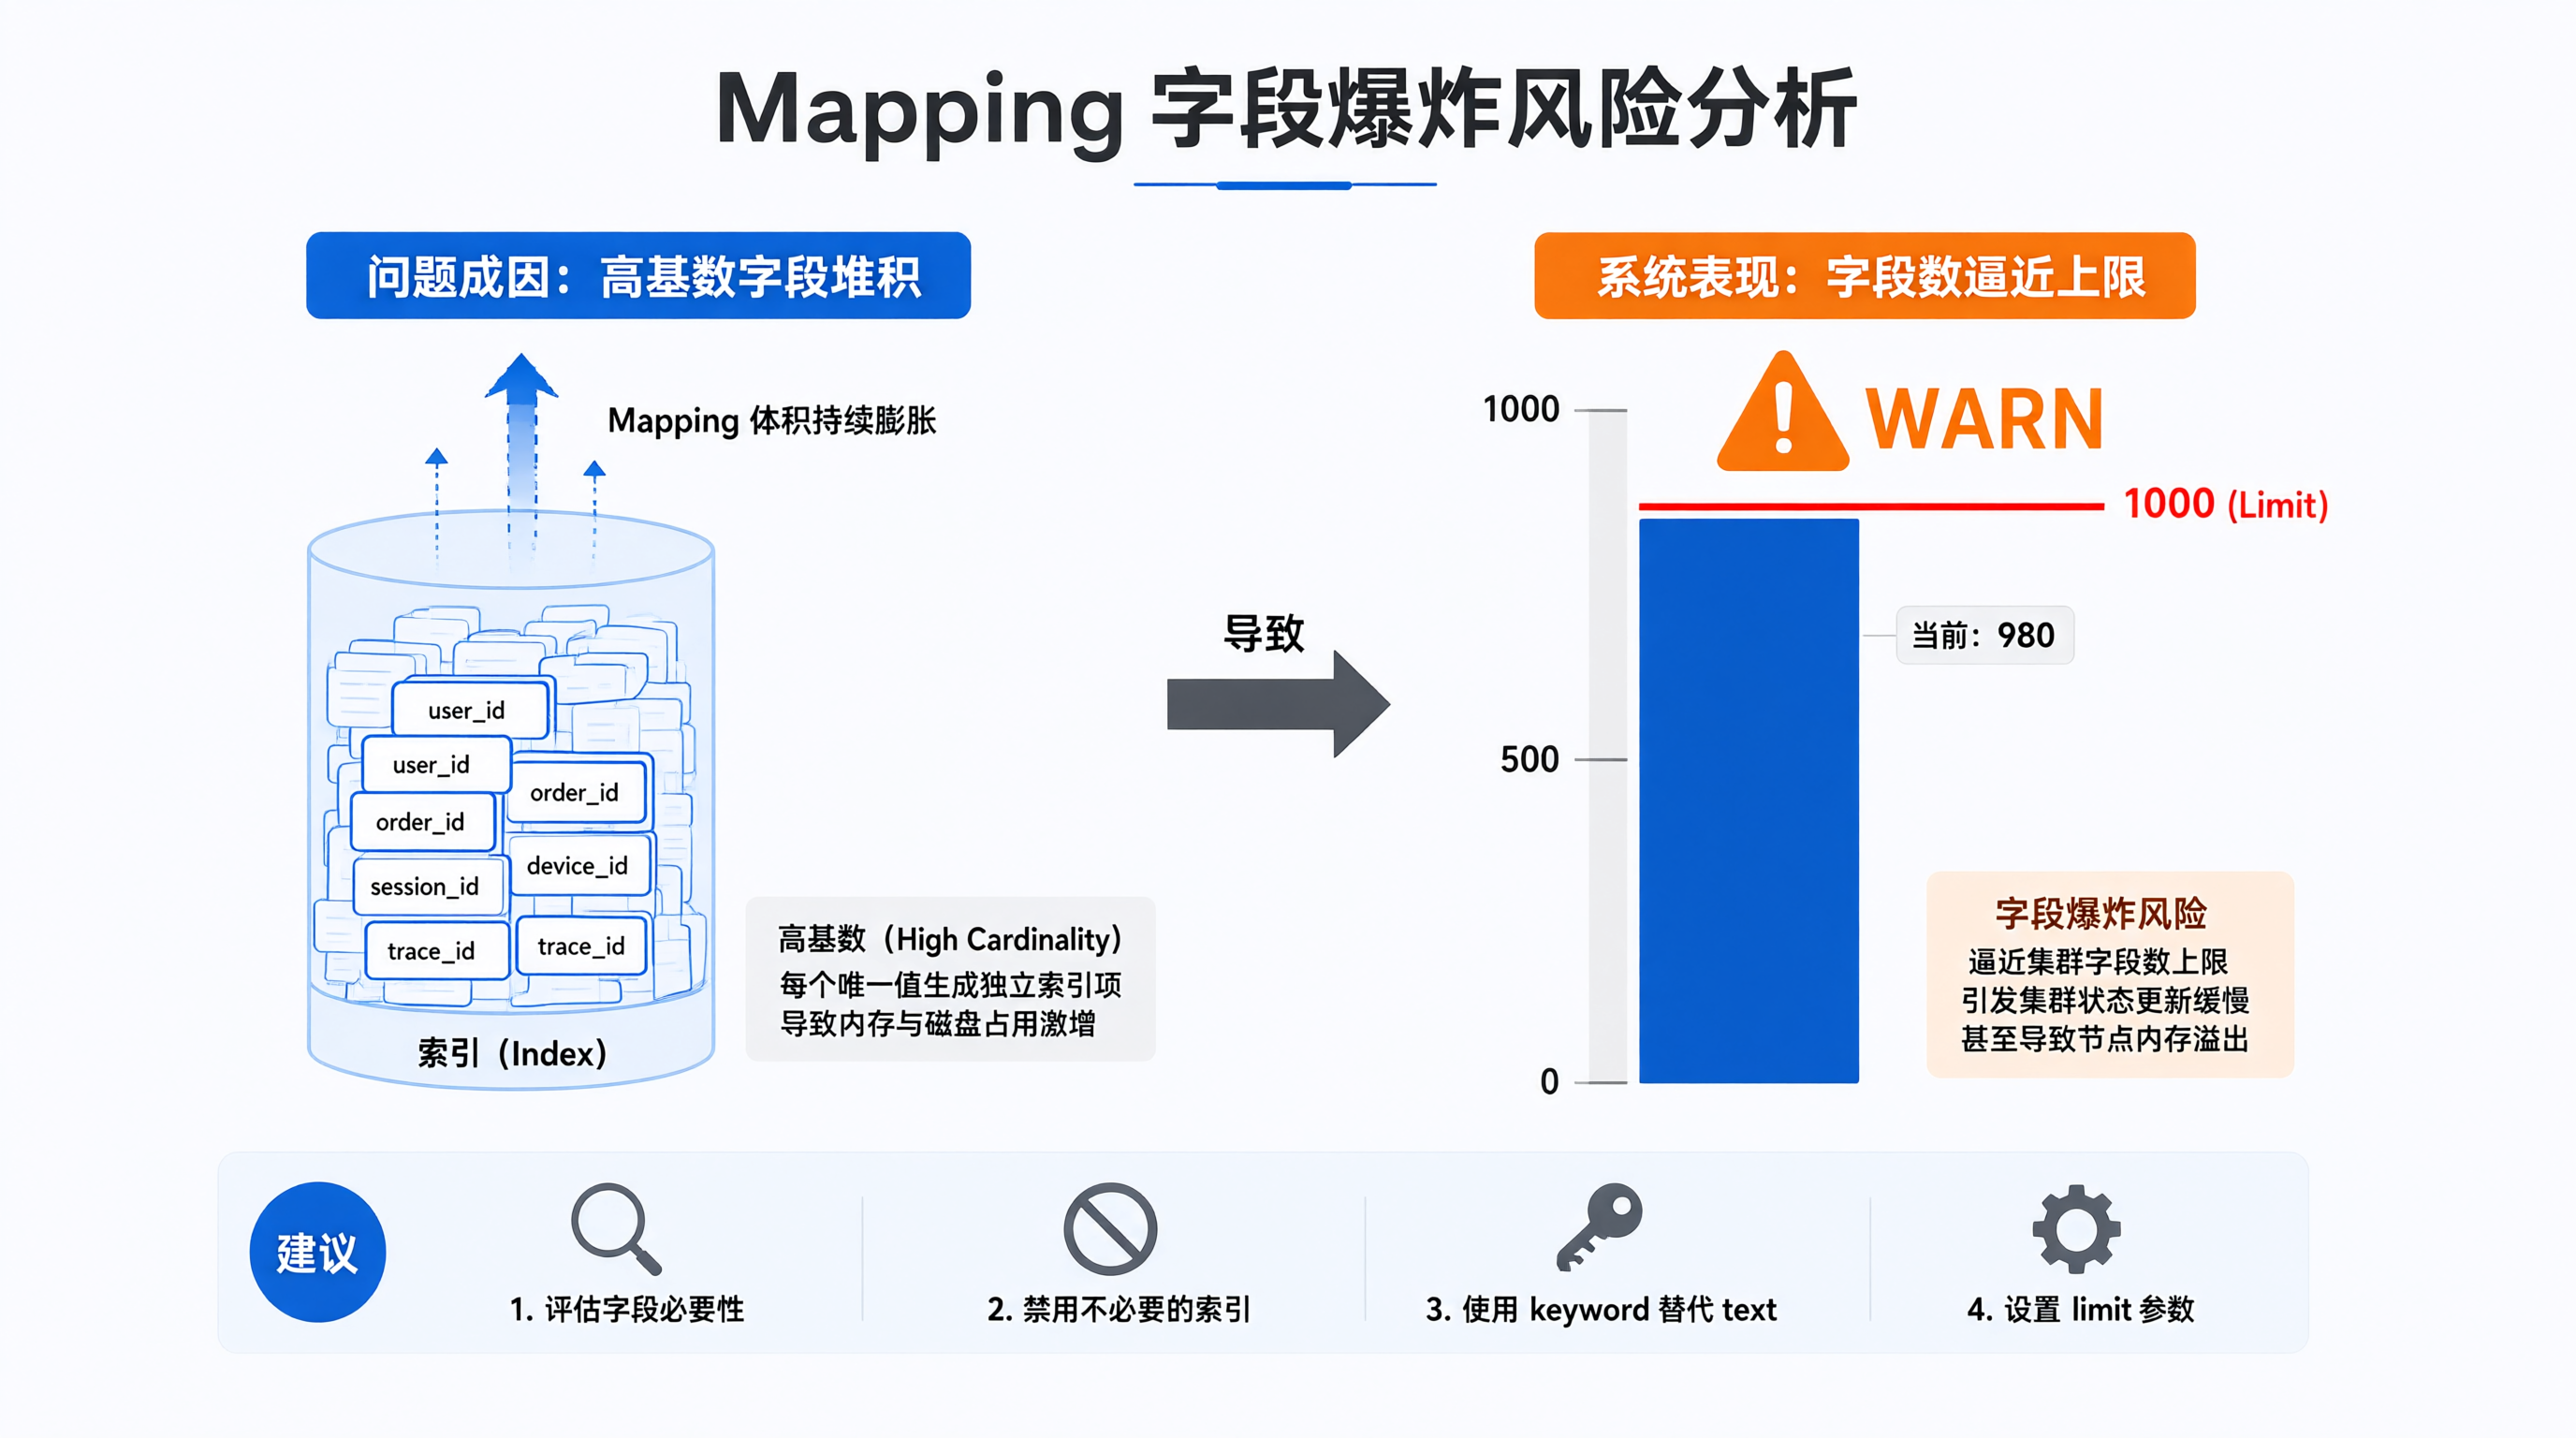
字段爆炸。如果日志里把用户 ID、订单 ID 这种高基数字段也写进去,而且没控制好,ES 的 mapping 会越来越大。更糟的是如果字段名本身是动态的(比如 user_12345_name 这种),ES 默认有个 mapping 字段数上限(index.mapping.total_fields.limit,默认 1000),超了会直接拒绝写入。所以日志字段要克制,别把业务对象整个 dump 进去。
磁盘和保留策略。日志是只增不减的,不设保留策略磁盘迟早满。我这边是配了 ILM,超过 30 天的索引自动删除。测试环境保留 7 天。这个值根据你的磁盘容量和实际排查需求定,没有标准答案。
写入压力。如果日志量大,Logstash 单实例可能成为瓶颈。可以横向扩多个 Logstash 实例消费同一批文件,或者中间加一层 Kafka 削峰。我这边日志量不大,单实例够用,没有实际压测过 Logstash 的吞吐上限,这一点我没有验证,需要按你的量级自己测。
说下取舍
ELK 不是唯一选择,也不一定是最优选择。如果只是想要一个能搜索的日志系统,Loki + Grafana 的资源占用比 ELK 小很多,查询语法也不难学。ELK 的优势在于全文检索能力和聚合分析的灵活度,如果你的需求里"按字段做复杂聚合和可视化"占比很高,ELK 更合适。
另外,如果日志本身已经是 JSON 结构,真的没必要上 Logstash 做正则解析。让应用直接写 ES,或者用 Filebeat 采集,链路更短,出问题的环节更少。Logstash 的价值在解析和转换,用不上这部分能力就别引入它。
最后一点:mapping 和索引模板要提前定,不要等数据进去了再改。字段类型改起来是真的麻烦,很多时候只能重建索引再 reindex。这个成本比一开始花半小时想清楚字段类型高得多。