把一个维度为 1 的轴删掉,通常不需要搬数据;把一个转置矩阵的两个轴合并,则通常不能只改 shape。二者表面上都像“合并维度”,底层是否连续却不同。判断条件必须来自实际 stride,而不是维度名字。
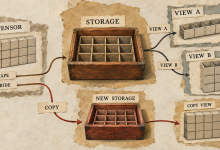
TorchTPU 的视图语义说明讨论了 PyTorch 的共享存储与 StableHLO 不可变值之间的衔接。对于系统程序员,最先要追的是:这两个视图是否指向同一份字节,写入从哪里可见。
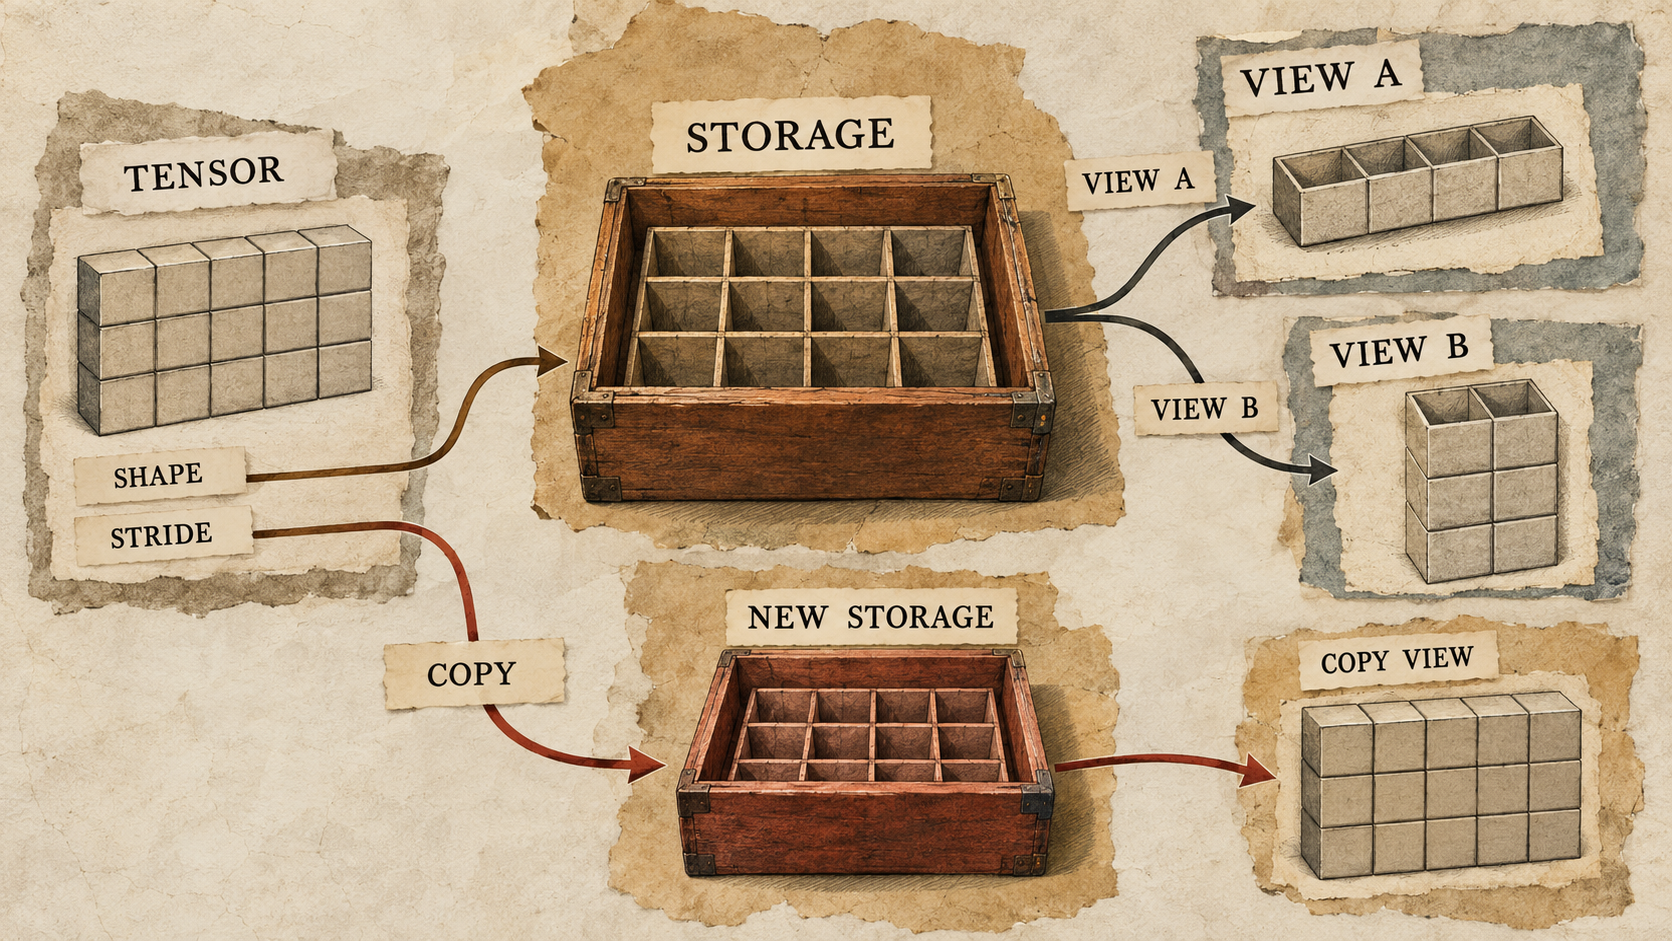
shape 和 stride 描述共享存储的视图,复制才会建立新存储。图中的托盘表示逻辑视图,改变 stride 本身不会自动触发复制。
下面检查的是正 stride、行主序连续布局;长度为 1 的轴不约束 stride。零维度张量的处理在不同框架中存在细节差异,本例不纳入合同。
def is_contiguous(shape,stride):
if len(shape)!=len(stride) or any(d<=0 for d in shape):
raise ValueError("positive shape required")
expected=1
for d,s in reversed(list(zip(shape,stride))):
if d!=1:
if s!=expected: return False
expected*=d
return True
assert is_contiguous((2,1,3),(3,99,1))
assert is_contiguous((2,3),(3,1))
assert not is_contiguous((3,2),(1,3))
# Shape (2,3), stride (1,2) traverses the shared storage differently.
assert [i*1+j*2 for i in range(2) for j in range(3)]==[0,2,4,1,3,5]
print("stride: singleton axis and transpose cases passed")
合并条件只在局部成立
对两个非单例相邻轴,如果想按原逻辑顺序合并,一般需要外轴 stride 等于内轴长度乘以内轴 stride。满足这个关系说明这一段可以折叠,不意味着整个张量已经连续。负 stride、广播的零 stride、存储偏移和重叠视图还要另外处理。
算子可以接受非连续视图,也可以要求连续后复制。前者把索引成本带进内核,后者支付物化成本;哪个更合适取决于形状与复用次数。去掉一次复制的字节数,应只记那次复制,不能把整个算子的内存流量写成零。
Rust 的 &mut [T] 不允许任意重叠可变借用。若自己用裸指针实现张量视图,需要在安全包装层证明访问范围、对齐和别名条件,不能用 shape/stride 的正确性替代这些证明。
视图共享会让写入变成可观察的行为
两个视图形状不同,并不代表它们互相独立。若都引用同一底层存储,向一个视图写入后,另一个视图应该按各自 stride 看到相应变化。优化器若擅自把其中一个视图复制成独立数组,就可能改变程序可观察行为;反过来,将本应独立的结果改成共享视图,也可能引入意外联动。
因此“消除复制”需要一个语义前提:复制之后的独立性是否被后续代码使用。只读路径比较容易分析,可变路径则要追踪所有别名和写入。若底层代码经过 FFI,语言层面的借用约束未必能看见外部保留的指针,安全包装必须把这些约定写出来。
连续性检查也不能代替存储范围检查。一个视图可能 stride 关系正确,却带着超出缓冲区的 offset。对正 stride,可以根据各轴长度和 stride 算出最大访问偏移,再与存储长度比较;存在负 stride 时,还要同时计算最小偏移。重叠视图则另涉及写入顺序,不能只看范围合法。
对于部署决策,可以先统计实际出现的布局类型。少数常见转置也许值得专门内核,极少出现的任意 stride 路径则可以走显式复制回退。让接口诚实表达支持范围,比为了“零复制”保留一条难以验证、又没有真实负载的通用路径更容易维护。
广播视图的零 stride 是另一个容易混淆的情况:多个逻辑位置可能读取同一个存储位置。只读广播可以节省空间,但把同样的视图当成可独立写入的数组,会让不同输出互相覆盖。接口若不支持重叠写入,应在进入内核之前拒绝,而不是等错误结果出现后再猜原因。
此处验证布局判定与索引次序,没有接入 PyTorch、设备运行时或自动微分。模型端到端的复制消除效果仍未测量。