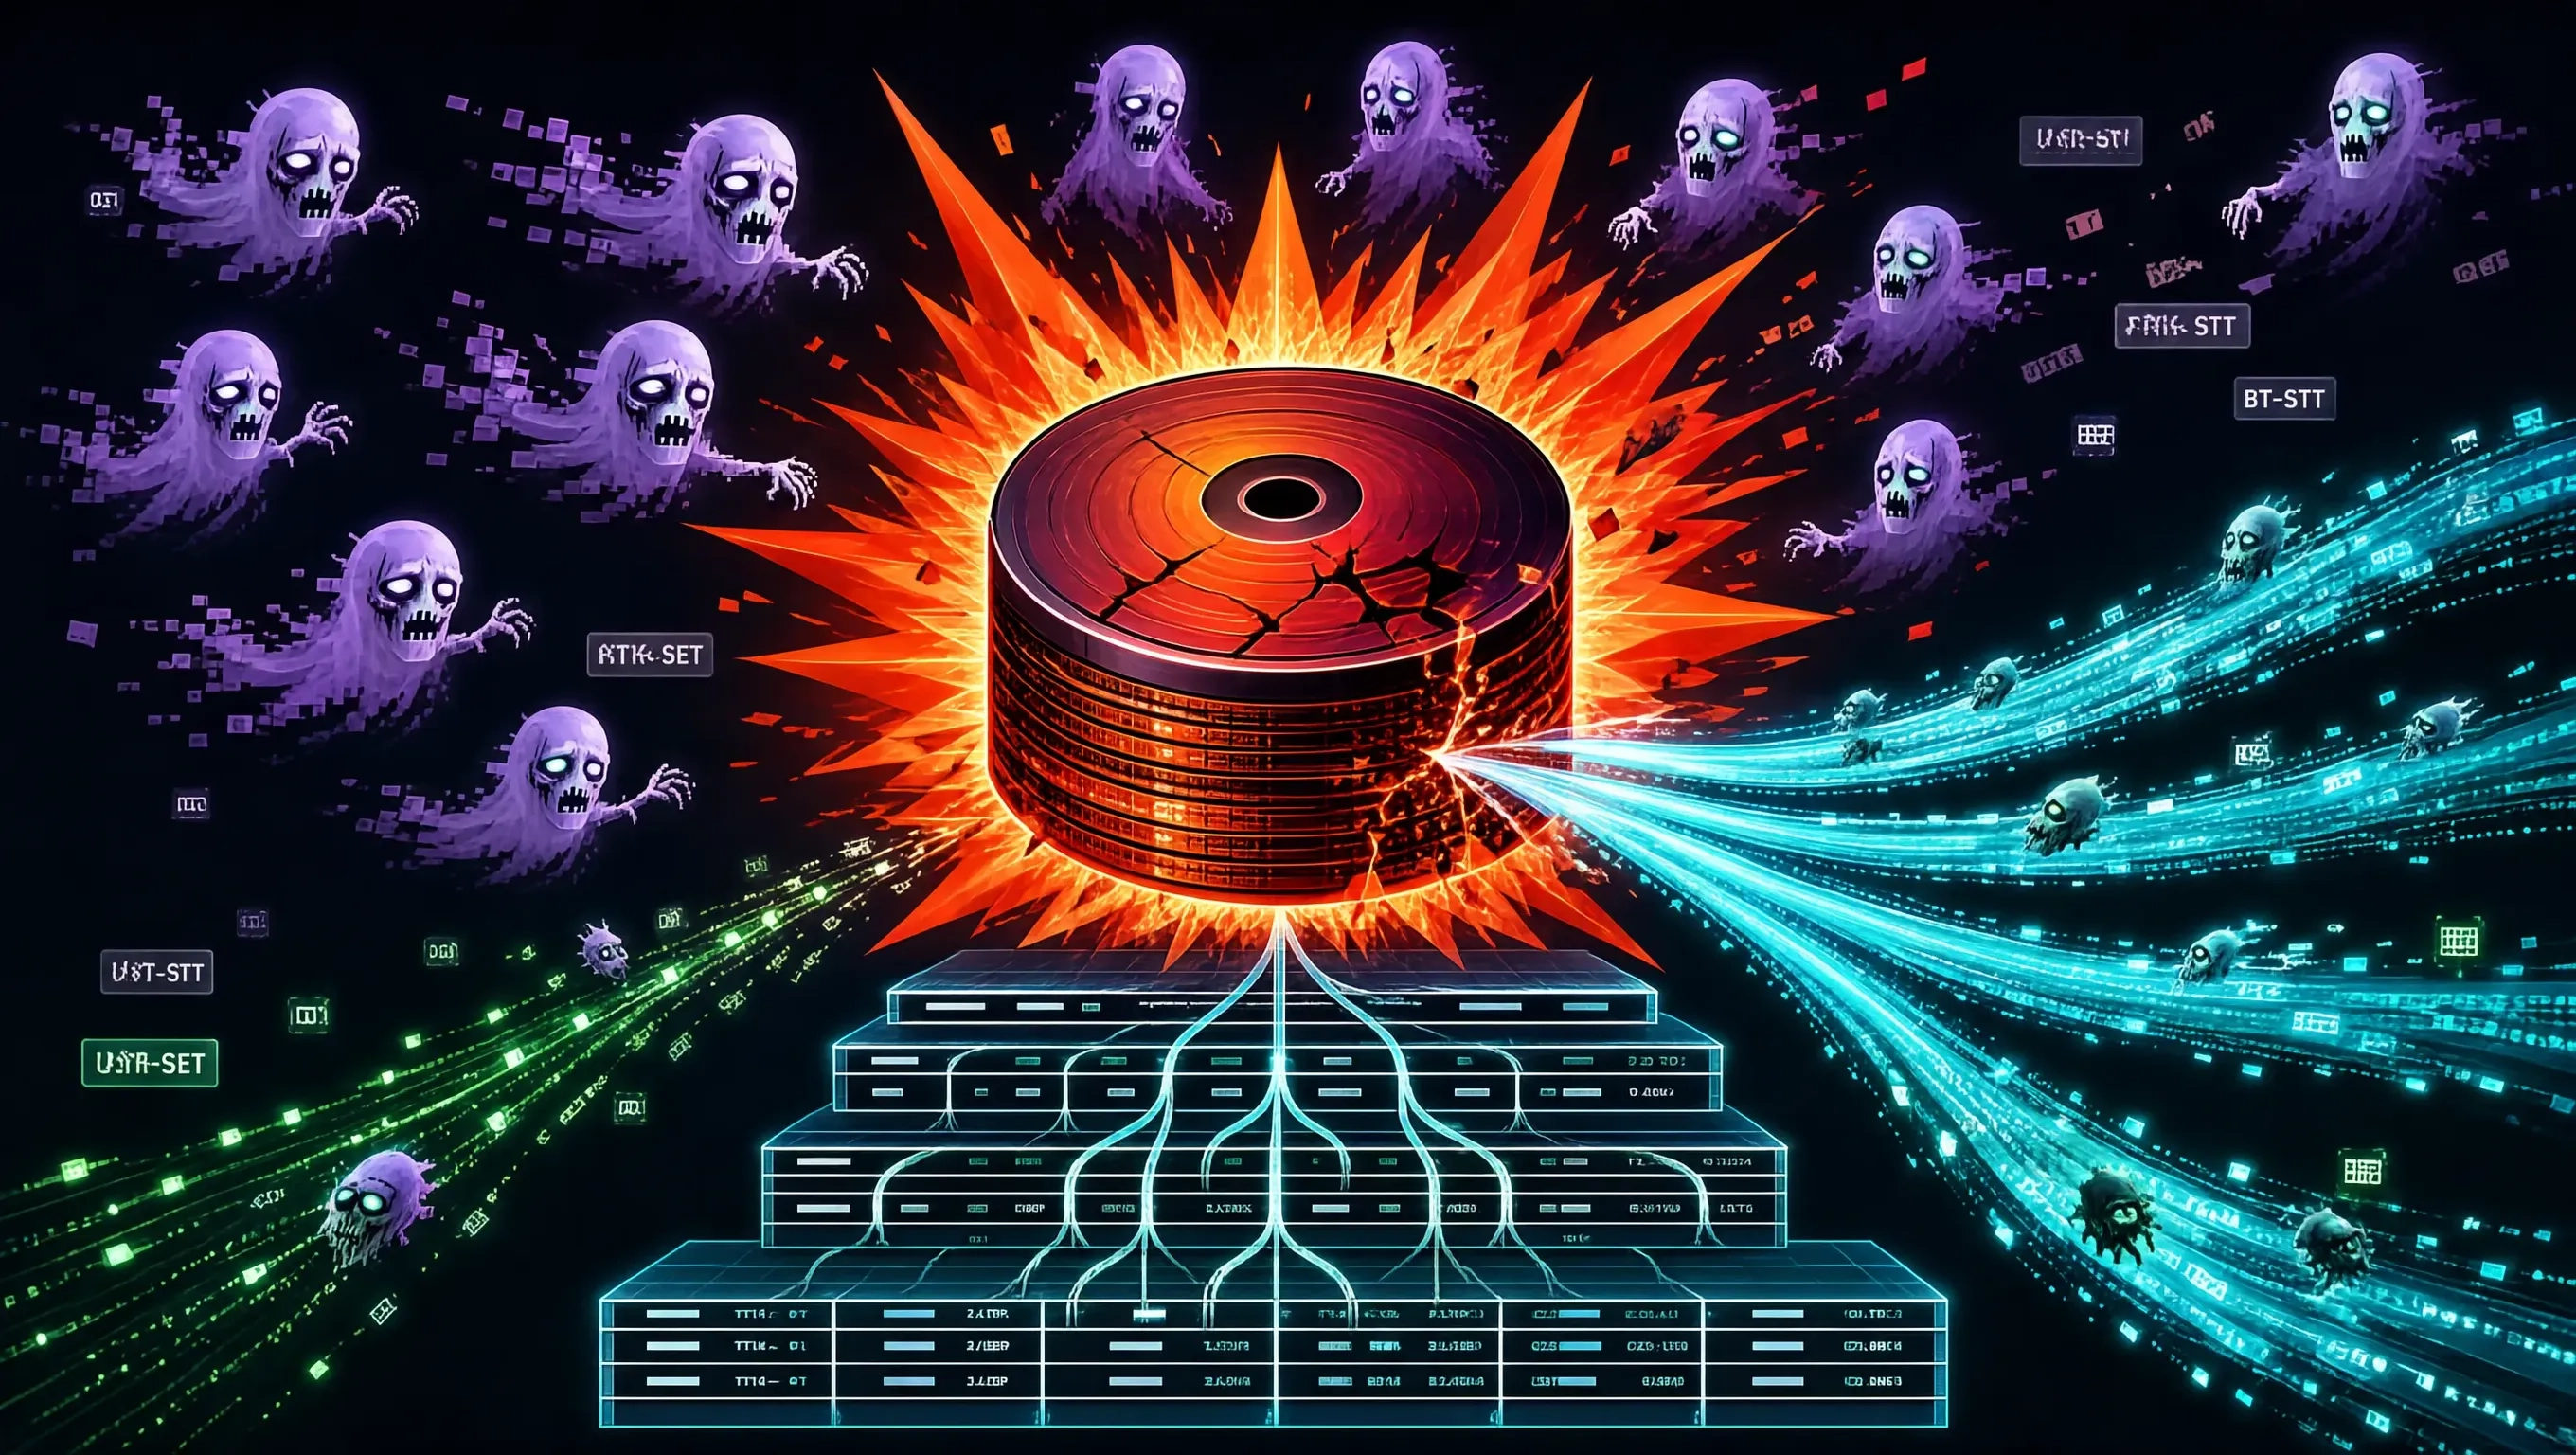
在基于 Apache Flink 构建的大型实时数仓与流计算体系中,基于嵌入式 RocksDB 的状态后端(RocksDBStateBackend / EmbeddedRocksDBStateBackend)是支撑大规模有状态计算(Stateful Stream Processing)的定海神针。无论是双流 JOIN、事件窗口聚合(Window Aggregation),还是自定义算子中的 ValueState、MapState,凡是单任务状态达到数百吉字节(GB)乃至数太字节(TB)级别时,RocksDB 都是唯一可行的工业级选择。
然而在生产运维实践中,一个极其凶险且隐蔽的故障模式是:作业在刚上线的两三天内平稳运行,但随着时间推移,TaskManager 节点的本地磁盘空间以惊人的斜率单调暴涨,最终在某个深夜将服务器磁盘全部撑满(Disk Full 100%),引发 Checkpoint 连续超时失败、Pod 驱逐甚至整个实时链路雪崩。
更令人困惑的是:许多开发同学拿着代码委屈地辩解:“我明明已经在状态配置里开启了 StateTtlConfig,明确设置了 24 小时过期,为什么一个月过去了,磁盘上的 RocksDB 目录体积还在无限膨胀?!”
本文将深入 RocksDB 底层 LSM-Tree 的物理存储与压实机制(Compaction),揭开 State TTL “伪失效”的根本原因,并给出彻底根治状态爆炸的生产级实战指南。
一、 认知误区:Flink 的 State TTL 是如何“惰性工作”的
要彻底排查状态爆炸,首先必须打破对“过期自动删除”的天真幻想。
1. 默认的“惰性读取清除(Lazy Cleanup on Read)”
当你朴素地写下如下代码时:
StateTtlConfig ttlConfig = StateTtlConfig
.newBuilder(Time.days(1))
.setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
.setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
.build();
ValueStateDescriptor<UserEvent> desc = new ValueStateDescriptor<>("user-state", UserEvent.class);
desc.enableTimeToLive(ttlConfig);
在默认情况下,Flink 的 TTL 机制是高度惰性的(Lazy):
- 每一条状态值在写入 RocksDB 时,被透明地追加了一个 8 字节的时间戳前缀:(StateValue + ExpirationTimestamp);
- 只有当下游算子再次显式调用 state.value() 读取该特定 Key 时,Flink 才会检查当前时间是否超过了过期时间戳;
- 如果已过期,返回 null,并在内存中标记待删除。
致命的死穴:如果这个 Key 永远不再被读取呢?
在绝大多数真实业务中(例如“统计新用户的首次登录行为”或“双流 JOIN 中只来了一侧的孤儿订单”),超过 80% 的状态 Key 在其生命周期内只被写入一次,此后随着用户流失或订单结束,永远不会再有新的流事件去主动读取该 Key!这就意味着:在默认配置下,数以亿计的僵尸状态(Zombie State)虽然逻辑上早已过期,但物理上依然完好无损地死锁在 RocksDB 的磁盘文件之中,根本不会被触发删除!
flowchart TD
subgraph 默认惰性机制 (导致磁盘打满)
W[写入 Key_A: TTL=1天] –> Disk[(RocksDB 磁盘 SST 文件)]
TimePass[时间过去 30 天 (Key_A 已过期)]
Disk –> Ghost[Key_A 永远不再被业务读取!]
Ghost –> Bloat[物理空间永不释放, 磁盘持续膨胀 100%]
end
subgraph 生产主动压实清理机制
W2[写入 Key_B: 开启 Compaction Filter] –> Disk2[(RocksDB 磁盘 SST 文件)]
Compaction[后台后台压实线程扫描 SST]
Compaction –> Check{读取时间戳已过期?}
Check — 是 –> Drop[直接物理丢弃, 空间立即回收]
Check — 否 –> Keep[保留至新 SST]
end
二、 深度解密:RocksDB LSM-Tree 的物理压实与过期回收
即便你得知需要依赖 RocksDB 的后台合并(Compaction)来清理过期数据,如果没理解 LSM-Tree 的层级压实机理,依然会掉进第二个大坑。
1. 为什么后台压实没有回收过期数据?
RocksDB 采用分层日志结构合并树(LSM-Tree),数据从 Level 0 逐步合并下沉到 Level 6:
- Compaction 的触发条件是“写放大与体积配额”,而不是“时间过期”。只有当某一层的大小超过阈值时,RocksDB 才会挑选部分 SST 文件与下一层进行归并排序。
- 如果底层的某个历史 SST 文件深锁在 Level 5 或 Level 6 中,而近期该区间的 Key 没有新的写入,RocksDB 可能连续几周都不会挑选这个 SST 文件去执行 Compaction。这些包含海量过期状态的文件就成了“永久钉子户”。
三、 彻底根治:生产级 TTL 治理三板斧
要彻底解决 RocksDB 磁盘膨胀,必须在代码配置、引擎参数以及快照三个维度同时建立主动清理通道。
第一板斧:开启 RocksDB 原生 Compaction Filter(核心死命令)
必须显式开启 cleanupInRocksdbCompactFilter!这是 Flink 与 RocksDB 底层 C++ 压实引擎深度打通的主动清理机制。在 RocksDB 执行后台多路归并时,C++ 层的 Filter 会在流式反序列化数据块的瞬间,逐行比对时间戳,一旦发现时间戳早于当前系统物理时钟,直接就地物理丢弃,绝不写入新 SST 文件!
StateTtlConfig ttlConfig = StateTtlConfig
.newBuilder(Time.days(1))
.setUpdateType(StateTtlConfig.UpdateType.OnCreateAndWrite)
.setStateVisibility(StateTtlConfig.StateVisibility.NeverReturnExpired)
// 【生产核心加固 1】: 启用 RocksDB 原生后台压实清理过滤器 (零额外 CPU 开销)
.cleanupInRocksdbCompactFilter(1000) // 每处理 1000 个 Key 刷新一次系统时钟
// 【生产核心加固 2】: 启用全量 Checkpoint 时的增量快照清理
.cleanupFullSnapshot()
.build();
注意:cleanupInRocksdbCompactFilter(queryTimeAfterNumEntries) 中的入参代表查询系统时钟的频率。如果设为 1,每次读 Key 都去调用一次底层 System.currentTimeMillis() 会产生微小的系统调用开销;设为 1000 ~ 2000 是兼顾精度与极高吞吐的工业黄金平衡点。
第二板斧:强制定期全层 Compaction(消除底层僵尸 SST)
为了防止某些冷数据 SST 长期驻留在底层不被调度压实,可以通过自定义 RocksDBOptionsFactory,命令 RocksDB 开启周期性的后台巡检清理:
public class CustomRocksDBOptionsFactory implements ConfigurableRocksDBOptionsFactory {
@Override
public DBOptions createDBOptions(DBOptions currentOptions, Collection<ClassLoader> classLoaders) {
// 允许后台最多启动 4 个并发线程专职负责 Compaction 垃圾回收
currentOptions.setMaxBackgroundJobs(4);
return currentOptions;
}
@Override
public ColumnFamilyOptions createColumnFamilyOptions(ColumnFamilyOptions currentOptions, Collection<ClassLoader> classLoaders) {
// 设置底层 SST 文件的最大存活生命周期 (例如 7 天强制触发一次重压缩)
currentOptions.setPeriodicCompactionSeconds(7 * 24 * 3600);
return currentOptions;
}
@Override
public RocksDBOptionsFactory configure(ReadableConfig configuration) {
return this;
}
}
第三板斧:识别复杂状态类型的结构性膨胀
在定义复杂状态时,严禁将超大集合塞入单行 ValueState<List<T>> 或 ValueState<Map<K, V>> 中!
- ValueState<Map<K, V>> 的致命缺陷:TTL 作用在整行记录上。只要你向 Map 里哪怕修改了一个键,整张包含十万个键的 Map 的过期时间戳就会被全量延后!而且每次读取都需要将整行反序列化,极易撑爆 JVM 堆内存。
- 正解:全面重构成原生的 MapState<K, V>。在 MapState 中,每一个独立的子键(Sub-key)在 RocksDB 内部对应一条独立的底层物理记录,拥有彼此完全独立的 TTL 生命周期,清理粒度精细且支持增量回收。
四、 应急排障:生产磁盘即将 100% 时的抢救手段
当线上报警 TaskManager 磁盘已经达到 95% 且无法等待几天后的自然压实时:
bin/flink stop –savepointPath hdfs:///flink/savepoints/job_01 <job_id>
# 2. 清理挂载点磁盘上的历史脏数据,从干净的 Savepoint 重新拉起作业
bin/flink run -s hdfs:///flink/savepoints/job_01/…
重启后的 RocksDB 会以最紧凑的物理布局重新构建,磁盘占用通常会直接从 95% 瞬间暴降至 20% 以下!
五、 总结
Flink 状态治理是实时数仓架构师从初阶走向资深的必修课。记住两条军规:


