在基于 Apache Flink 构建现代化实时数仓(Real-Time Lakehouse / Data Warehouse)的工程实践中,构建实时大宽表(如将交易流、支付流、物流流通过窗口多流 JOIN 拼装为明细宽表)是决定下游实时大屏与风控模型时效性的核心中枢。
然而,在分布式移动互联网与边缘计算的真实世界里,“数据乱序(Out-of-Order)”与“极端迟到(Late Data)”是不可避免的客观物理规律:
- 用户的手机在进入电梯、地下车库或隧道时发生弱网断连,原本应当在 10:00:00 上报的加购行为事件,直到 10:15:30 重新连上 Wi-Fi 时才批量补发冲入 Kafka;
- 上游不同业务微服务的服务器时钟漂移、或者不同 Kafka 分区(Partition)消费速率不均匀,导致业务发生时间(Event Time)在流中呈现出强烈的非单调交织错乱。
如果流处理系统无法妥善处理乱序与迟到数据,就会引发两类致命后果:
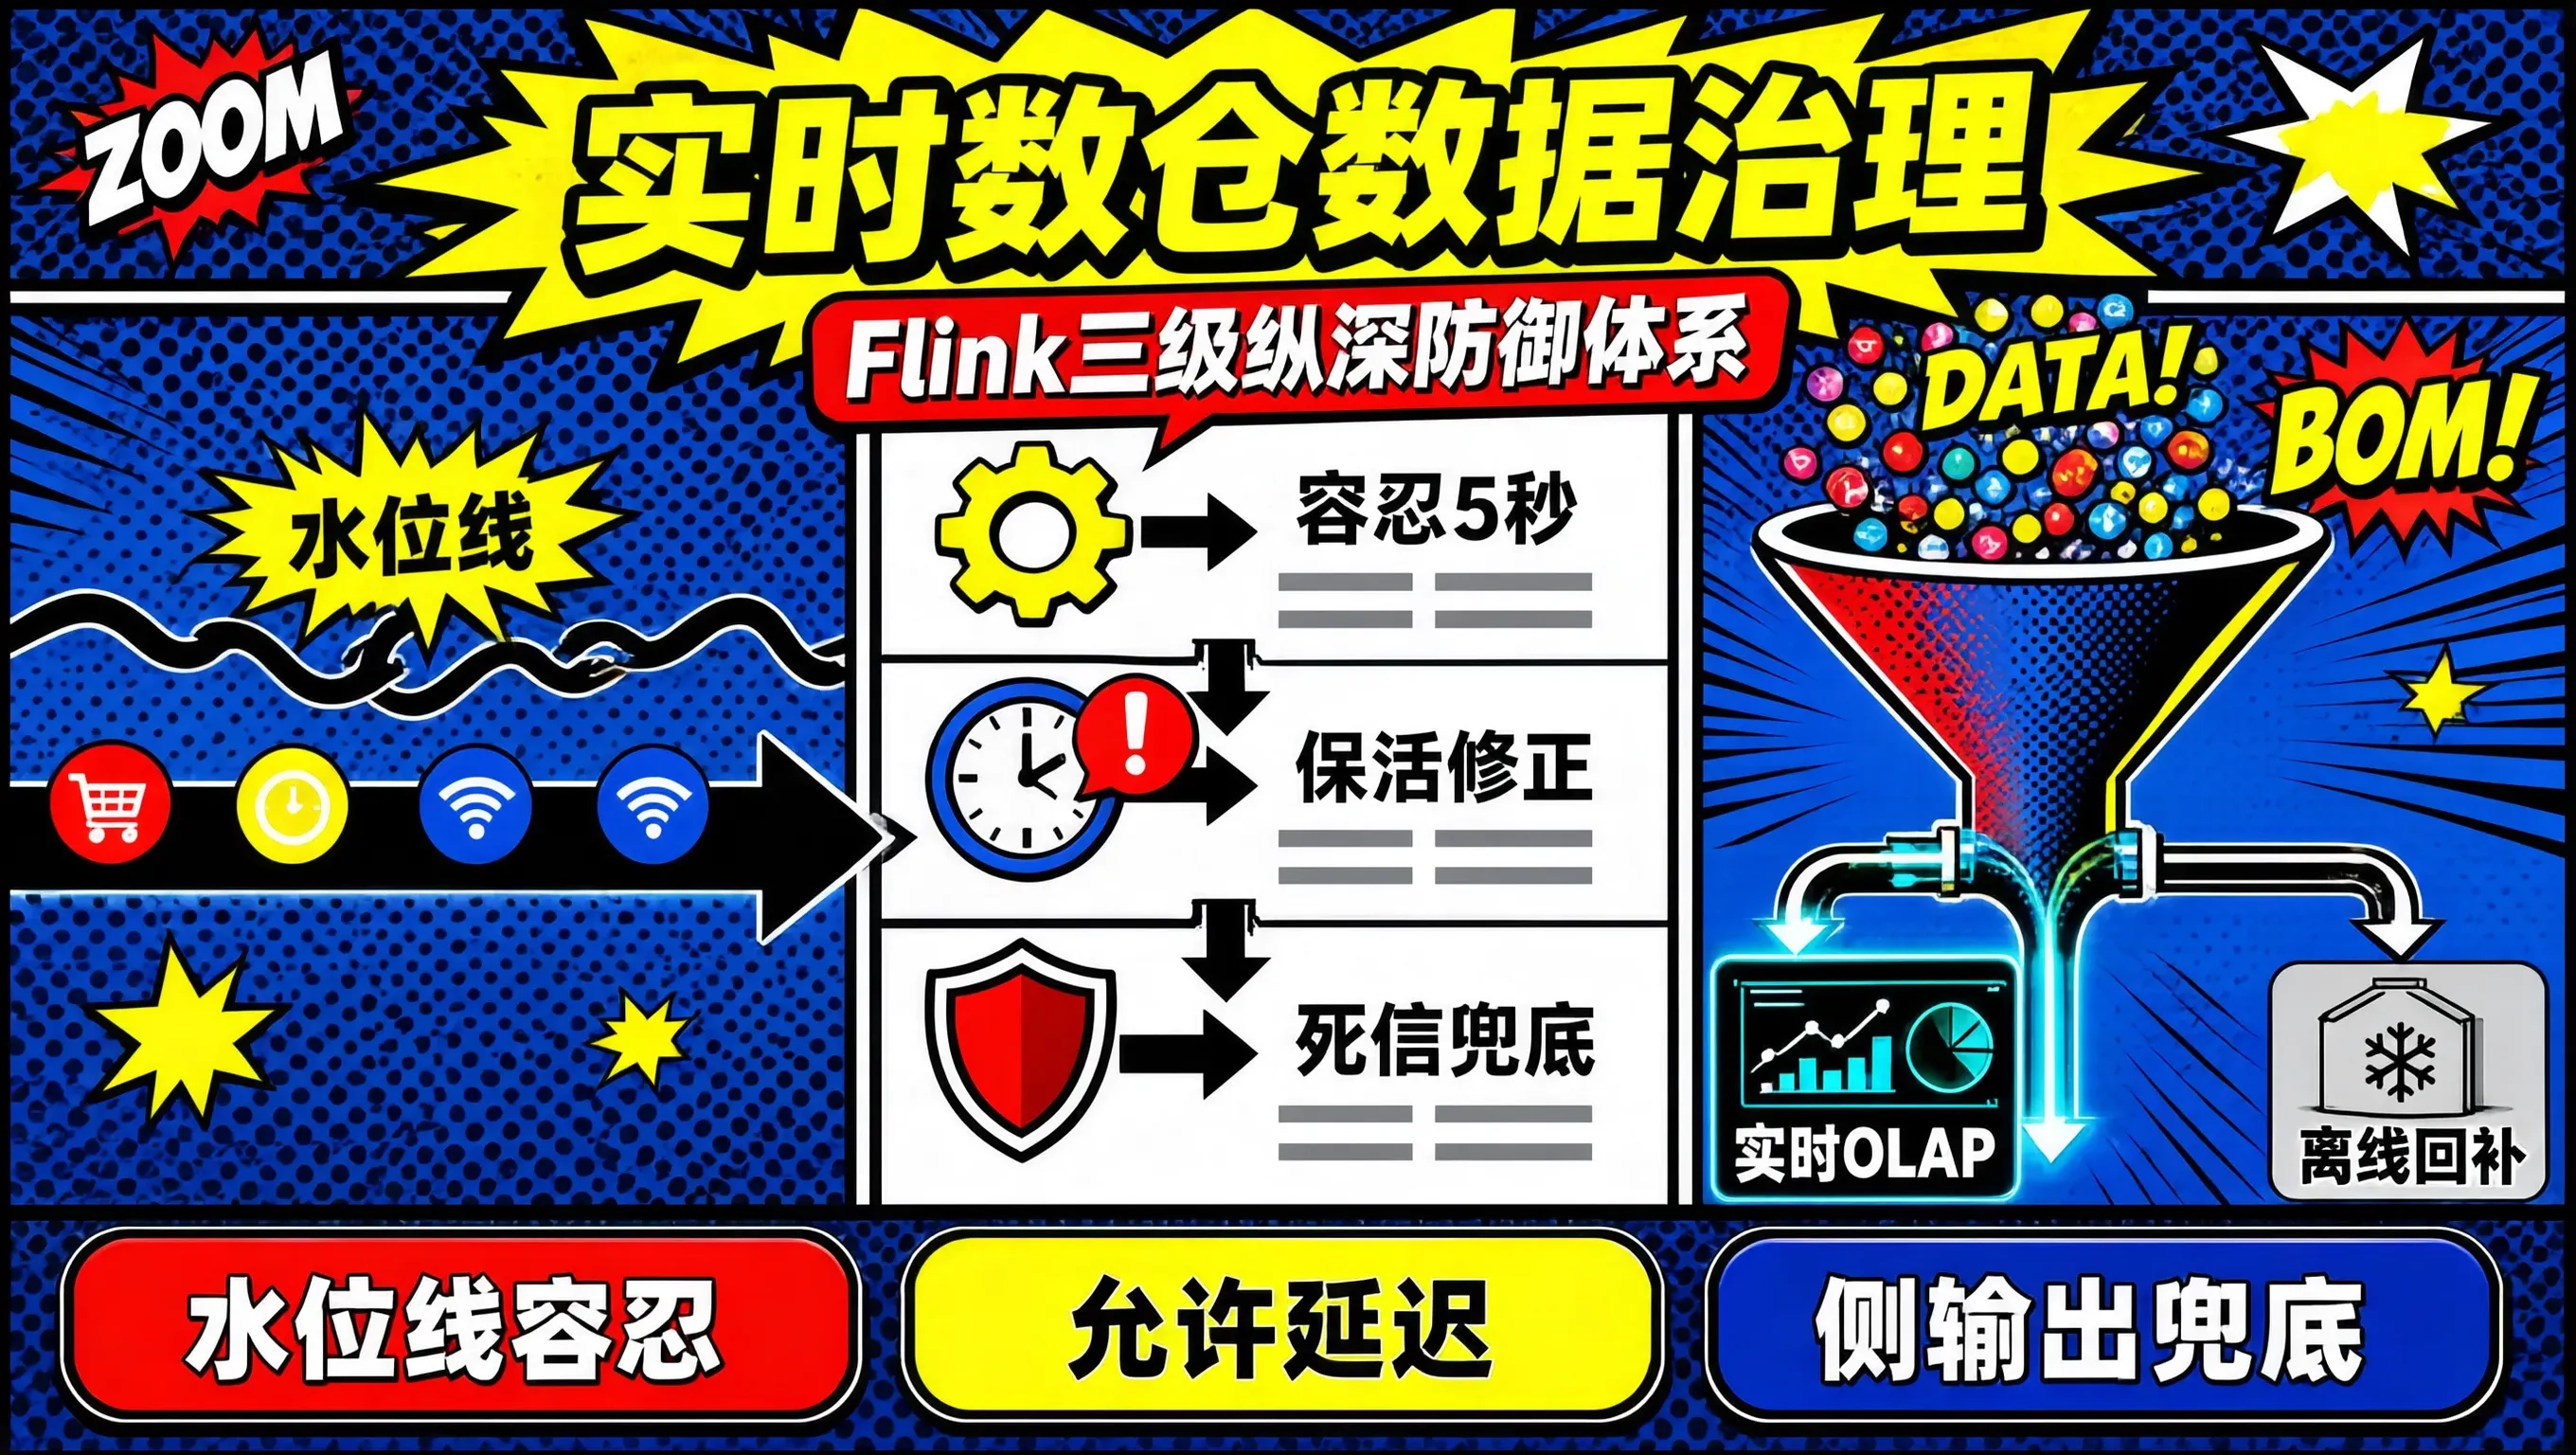
本文将深入拆解 Flink 事件时间(Event Time)与水位线推进的内在物理机理,展示如何通过**“BoundedOutOfOrderness 水位线容忍 + 允许延迟触发(Allowed Lateness) + 侧输出流兜底回收(Side Output)”**的三级纵深防御体系,在实时性与数据精准度之间实现完美平衡。
一、 事件时间体系与 Watermark 推进机制
在 Flink 体系中,时间被划分为三种类型:摄入时间(Ingestion Time)、处理时间(Processing Time)与事件时间(Event Time)。为了保证多次计算结果的幂等性与可重放性(Replayability),实时数仓构建必须坚定不移地以数据载荷内自带的事件时间作为唯一基准。
flowchart LR
subgraph 实时事件时间流
E1["事件 1: TS=10:00:05"] –> E2["事件 2: TS=10:00:02 (轻微乱序)"]
E2 –> E3["事件 3: TS=10:00:08"]
E3 –> WM["Watermark(TS=10:00:03)<br/>允许 5 秒最大乱序容忍"]
end
1. 什么是 Watermark(水位线)?
Watermark 本质上是一条插入在普通数据流中的特殊时间控制元数据标记。
- 当算子接收到一个时间戳为 $T_w$ 的 Watermark 时,系统在数学上做出断言:“在此之后,时间戳早于等于 $T_w$ 的事件已经基本全部到达,下游窗口可以安全地触发计算了!”
2. 单调递增的水位线推进方程
如果设置了允许最大乱序延迟为 $\\Delta t$(例如 5 秒),那么当前算子发射出的水位线为:$$\\text{Watermark} = \\max(\\text{Observed_Event_Time}) – \\Delta t$$随着流中最大的事件时间向前推进,水位线也单调向前跳动。任何事件时间早于当前水位线但仍在窗口允许范围内的事件,都会被吸纳进当前窗口并平滑参与聚合。
二、 三级纵深防御体系架构设计
对于真实生产中长尾迟到的数据(例如迟到了 10 分钟甚至 1 小时的孤儿事件),绝不能采用单一手段处理,必须构建三层渐进式闭环:
flowchart TD
InStream[Kafka 原始事件流] –> WMGen[第一级: Watermark 设定 5s 乱序容忍]
WMGen –> Window[切分 1 分钟滚动窗口: [10:00, 10:01)]
Window –> Cond1{事件时间 < 10:01 + 5s?}
Cond1 — 是 (正常/轻微乱序) –> Calc1[吸纳进窗口, 并在水位线到达时首次输出]
Cond1 — 否 –> Cond2{延迟时间 < allowedLateness(1分钟)?}
Cond2 — 是 (中度迟到) –> Calc2[窗口重开, 增量触发发出 UPDATE 修正结果]
Cond2 — 否 (极端超长迟到) –> SideOutput[第三级: 侧输出流 (Side Output) 兜底捕捉]
SideOutput –> DeadLetter[(Kafka 迟到死信队列 / 离线批处理回补)]
Calc1 –> RealtimeSink[(实时 OLAP: ClickHouse / StarRocks)]
Calc2 –> RealtimeSink
三、 生产完整代码实战实现
以下为一个高并发订单宽表流处理作业的完整代码,演示三级防御机制的装配:
package com.datastudio.stream.lakehouse;
import org.apache.flink.api.common.eventtime.*;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.util.OutputTag;
import java.time.Duration;
public class ResilientOrderStreamJob {
// 定义用于承接极端超长迟到事件的侧输出流标签 (Side Output Tag)
public static final OutputTag<OrderEvent> EXTREME_LATE_TAG =
new OutputTag<OrderEvent>("extreme-late-orders") {};
public static void main(String[] args) throws Exception {
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.setParallelism(8);
// 1. 从 Kafka 消费原始流
DataStream<OrderEvent> rawStream = env.addSource(new KafkaOrderEventConsumer());
// 2. 第一级防御: 配置最大容忍 5 秒乱序的 Watermark 生成策略
DataStream<OrderEvent> watermarkedStream = rawStream.assignTimestampsAndWatermarks(
WatermarkStrategy.<OrderEvent>forBoundedOutOfOrderness(Duration.ofSeconds(5))
.withTimestampAssigner((event, recordTimestamp) -> event.getEventTimestamp())
.withIdleness(Duration.ofMinutes(1)) // 核心加固: 防止闲置分区阻塞全局水位线推进
);
// 3. 第二级与第三级防御: 窗口关联、允许延迟与侧输出流配置
SingleOutputStreamOperator<AggregatedMetric> mainStream = watermarkedStream
.keyBy(OrderEvent::getMerchantId)
.window(TumblingEventTimeWindows.of(Time.minutes(1)))
// 第二级: 允许窗口状态在关闭后额外保活 60 秒,接收中度迟到数据并增量更新
.allowedLateness(Time.seconds(60))
// 第三级: 超过 60 秒后彻底关闭窗口,后续极端迟到数据自动重定向至侧输出流
.sideOutputLateData(EXTREME_LATE_TAG)
.aggregate(new OrderAggregatorFunc(), new OrderWindowResultFunc());
// 4. 主干流写出到下游实时 OLAP (如 ClickHouse / StarRocks)
mainStream.addSink(new ClickHouseUpsertSink());
// 5. 提取侧输出流: 写入死信 Kafka Topic 或持久化至对象存储冷归档
DataStream<OrderEvent> lateDataStream = mainStream.getSideOutput(EXTREME_LATE_TAG);
lateDataStream.addSink(new DeadLetterKafkaSink("topic_late_orders_audit"));
env.execute("Resilient Order Stream Processing");
}
}
四、 生产调优关键陷阱与防御守则
在部署该架构时,必须格外警惕以下两个引发严重故障的暗坑:
1. 警惕“闲置分区(Idle Partition)”冻结全局水位线
如果上游 Kafka 包含 32 个分区,但在业务低峰期,其中某 2 个分区长达数分钟没有产生任何新订单。
- 灾难表现:由于下游 Task 汇聚的水位线取决于所有上游 Channel 中最小的那个(Min Watermark),只要这 2 个空闲分区不产生数据,其水位线就会停滞在原点,导致下游所有的窗口算子彻底停止触发!
- 防御准则:必须在 WatermarkStrategy 中显式追加 .withIdleness(Duration.ofMinutes(1))!声明在分区空闲超过 1 分钟时暂时将其剔除出水位线计算,解除全局封锁。
2. allowedLateness 导致的状态与写放大风暴
不要盲目将 allowedLateness 设置得过大(例如设为 1 天)。因为窗口保活意味着每一个窗口内的中间聚合状态都必须完整保留在 RocksDB 内存和磁盘中。如果设置过长,活跃窗口数量会成千上万倍膨胀,直接引发状态爆炸(State OOM)。对于需要回补数小时前数据的场景,交给侧输出流与离线批处理才是最具性价比的解法。
五、 总结
实时计算的魅力在于极速,而实时数仓的威严则立足于严谨。面对物理网络无法抹平的客观延迟,通过构建 Watermark 吸收瞬态抖动 + Allowed Lateness 保活微调 + Side Output 兜底止损 的立体防御架构,实时数仓团队不仅能为业务一线交付秒级响应的极速看板,更能守住财务与风控体系对数据绝对准确的最后底线。