/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
在现代多任务操作系统中,虚拟内存(Virtual Memory)是支撑整个软件世界最伟大的抽象之一。无论用户态程序调用 malloc() 分配了多大的连续空间,操作系统向你许诺的都只是一张张“虚拟地址白条”。
在调用 malloc(1024 * 1024 * 100)(申请 100MB)的那一瞬间,Linux 内核根本没有在物理内存(RAM)中为你划拨哪怕一个真实的物理页框(Page Frame)!内核仅仅是在当前进程的内存描述符中,开辟了一段合法的虚拟内存区域(struct vm_area_struct, VMA)。
真正的物理内存绑定,被巧妙地推迟到了进程第一次真正通过指令去读取或写入这块地址的瞬间。
而驱动这一“按需装载(Demand Paging)”与“懒分配(Lazy Allocation)”奇迹的核心引擎,正是硬件 CPU 与操作系统内核之间协同最紧密、同时也是引发系统性能抖动最频繁的机制——缺页异常(Page Fault, x86 下的 14 号异常中断)。
硬件层面的触发机理:MMU 与 CR2 寄存器的精密配合
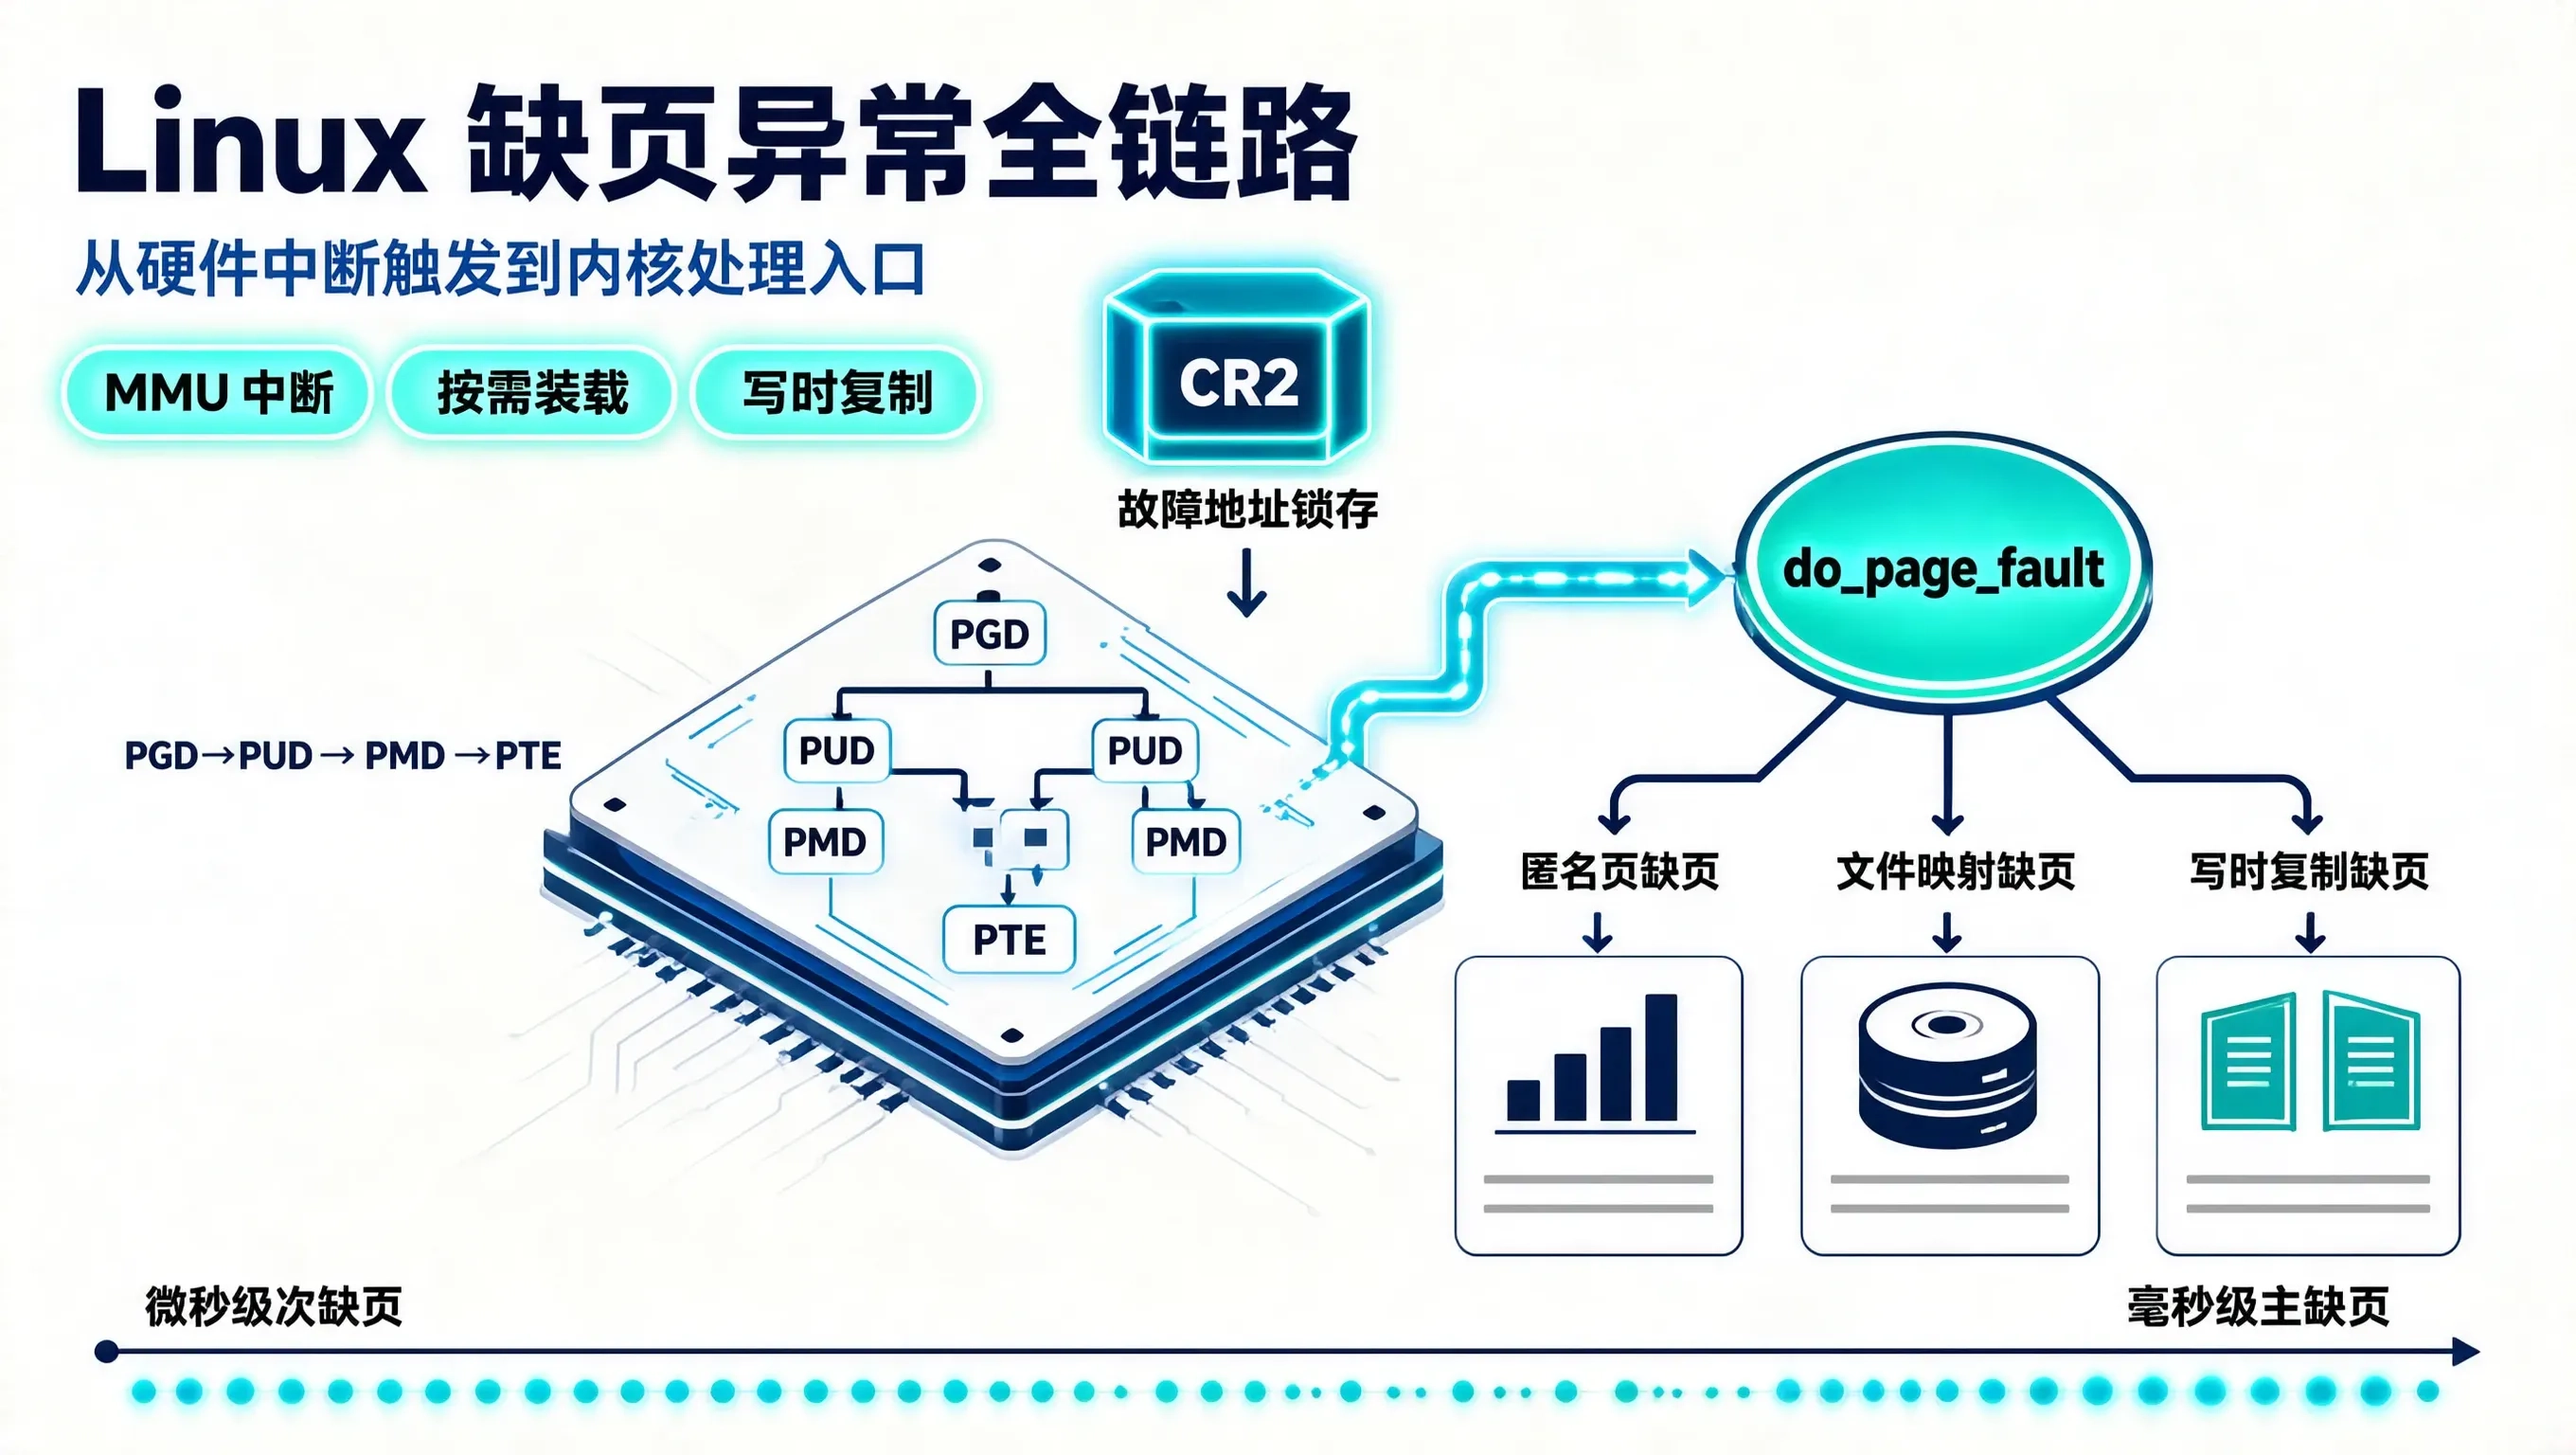
缺页异常不是软件层面的普通函数调用,它是由 CPU 硬件的内存管理单元(MMU)在硬件时钟周期内直接抛出的硬件级故障中断(Fault Exception):
+————————————————————-+
| Hardware Memory Translation Flow |
+————————————————————-+
| |
| 1. Instruction Execution: `mov [rax], 0x42` |
| (Virtual Address VA stored in RAX) |
| |
| 2. Hardware MMU traverses Page Table: |
| CR3 —> PGD —> P4D —> PUD —> PMD —> PTE |
| |
| 3. MMU checks PTE Flags: |
| – `PTE_PRESENT` bit == 0? (Physical page not mapped!) |
| OR |
| – Write operation, but `PTE_RW` bit == 0? (Permission!)|
| |
| =================== HARDWARE EXCEPTION ================= |
| |
| 4. CPU Hardware Actions in Single Cycle: |
| – Latches faulting Virtual Address into CR2 register! |
| – Pushes Error Code onto Kernel Stack |
| – Jumps to Interrupt Vector 14 (IDT Gate) |
| |
| =================== KERNEL ENTRY ======================= |
| |
| 5. Linux Kernel: `exc_page_fault()` —> `do_user_addr_fault()`
| |
+————————————————————-+
硬件层面的核心步骤如下:
内核态总入口:do_user_addr_fault 的核心分流裁决
在内核源码中(arch/x86/mm/fault.c),汇编代码保存寄存器上下文后,调用统一的 C 语言入口函数 do_user_addr_fault(struct pt_regs *regs, unsigned long error_code):
/* 概念展示:内核缺页异常的核心仲裁裁决树 */
void do_user_addr_fault(struct pt_regs *regs, unsigned long error_code)
{
struct task_struct *tsk = current;
struct mm_struct *mm = tsk->mm;
struct vm_area_struct *vma;
unsigned long address = read_cr2(); // 从硬件 CR2 寄存器读取案发现场地址
// 1. 查找故障地址是否落在合法的 VMA 虚拟内存区间内
vma = find_vma(mm, address);
if (unlikely(!vma)) {
// 地址根本不在任何合法的进程地址空间内!段错误!
bad_area(regs, error_code, address);
// 发送 SIGSEGV 信号将进程击杀 (Segmentation Fault)
return;
}
// 2. 检查访问权限是否合法 (例如试图向只读代码段写入)
if (unlikely(access_error(error_code, vma))) {
bad_area_access_error(regs, error_code, address);
return;
}
// 3. 权限合法,进入真正的内核物理缺页核心处理引擎
handle_mm_fault(vma, address, flags, regs);
}
handle_mm_fault:三大核心缺页类型处理
当确认该次访问属于合法行为后,内核进入 handle_mm_fault(),并根据 VMA 的类型将其分流到三个完全不同的物理路径:
1. 匿名页缺页(do_anonymous_page)
这是 malloc 或局部变量分配最常见的场景。
- 内核调用伙伴系统分配一个全新的 Order-0 物理页框;
- 如果这是一次纯读操作,为了节省内存,内核甚至不会真正分配页,而是直接将虚拟页指向系统全局唯一的全零页(Zero Page);
- 如果是一次写操作,内核分配物理页后将其彻底清零,并把物理页的 PFN 填入该进程的页表项(PTE),并将 PTE_PRESENT 标记置为 1;
- 中断返回,CPU 重新执行刚才失败的指令,此时顺利读写,用户态对此过程完全无感知!
2. 文件映射缺页(filemap_fault)
这是执行 mmap 读取可执行二进制段、动态链接库或文件的场景。
- 目标物理数据并不在内存中。内核触发 VFS 虚拟文件系统与块设备驱动的 I/O 链路(read_folio);
- 进程进入深度休眠状态(TASK_UNINTERRUPTIBLE),等待底层 NVMe 磁盘通过 DMA 将 4KB 数据搬运至 Page Cache;
- I/O 完成产生硬件中断唤醒进程,内核将其 PTE 映射到该 Page Cache 页上。这就是为什么该场景通常被称为**“主缺页异常(Major Page Fault)”**,耗时往往高达数毫秒!
3. 写时复制缺页(do_wp_page / Copy-On-Write)
在进程执行 fork() 后,父子进程的虚拟内存空间完全相同,且对应的页表项全部被内核故意标记为只读(PTE_RW = 0)。
- 当父进程或子进程尝试写入该页时,硬件抛出只读保护异常;
- 内核在缺页处理中检测到该 VMA 是可写的,判定为 COW 动作;
- 内核在物理 RAM 中新分配一个物理页,将旧页的数据完整 memcpy 到新页中,更新当前进程的 PTE 指向新页,并放开写权限;
- 父子进程自此拥有了各自物理上独立的副本,实现了极低开销的进程克隆。
生产观测与性能优化法则
作为架构老兵,读懂系统中的缺页异常指标是定位性能瓶颈的必备技能:
- min_flt(次缺页异常):物理页其实就在内存中(如匿名页首次分配、Page Cache 已命中),只需更新页表项。单次耗时通常在 0.5~2 微秒,但如果在极端高频下每秒发生数百万次,也会严重消耗 CPU;
- maj_flt(主缺页异常):必须从磁盘同步拉取数据。单次耗时在微秒至毫秒级。在延迟敏感的高频交易与核心网关中,大促期间必须严格实现“零主缺页”。
强制内核在服务启动时立即把所有代码段、堆栈与全局数据预先分配物理页并建立映射,禁止内核将其换出,从源头消灭业务请求处理路径上的任何缺页中断延迟。
虚拟与物理的精妙舞蹈,全部凝结在 14 号异常的纳秒流转之中。看透这一底层链路,系统调优才算真正进入了自由王国。