在对白停顿处加入一点气声,可能让角色更自然,也可能把每个逗号都变成刺耳的吸气。声音效果不能靠“物理声门模型”这个名字自动成立。
更稳妥的起点是将呼吸作为独立可控声部:发生在什么位置、持续多久、幅度多大、何时静音,都可以单独检查。
区分来源与混音行为
呼吸可以来自授权录音、模型生成或合成噪声;它们有不同的许可、音色和质量约束。简单噪声调制并不是完整人体发声模型,不应据此声称复现声带生理。
Web Audio草案以节点路由图组织音频处理。即使最终使用原生DSP,分开语音、气声、增益和输出的思路仍便于定位问题;草案本身也不是所有平台的性能承诺。
从零幅度开始,再慢慢抬起
突变的包络容易引入点击声。用首尾为零的平滑窗控制一段噪声,至少可以避免硬切入、硬切出的不连续。混合后仍需检查峰值,不能只看每个输入声部都没超限。
这里选择Hann形状的包络。随机噪声只用于构造可重复的数学输入;它没有经过声学训练,也没有被主观评为真实呼吸。
情绪不宜绑定一组万能参数
恐惧、运动、疲惫以及不同角色的呼吸习惯需要实际素材和听审。剧情里连续喘息也可能妨碍对白可懂度。应比较同一段对白的干声、加气声与最终混音,记录漏字、遮盖和不适感,而不是只填一个MOS提升数字。
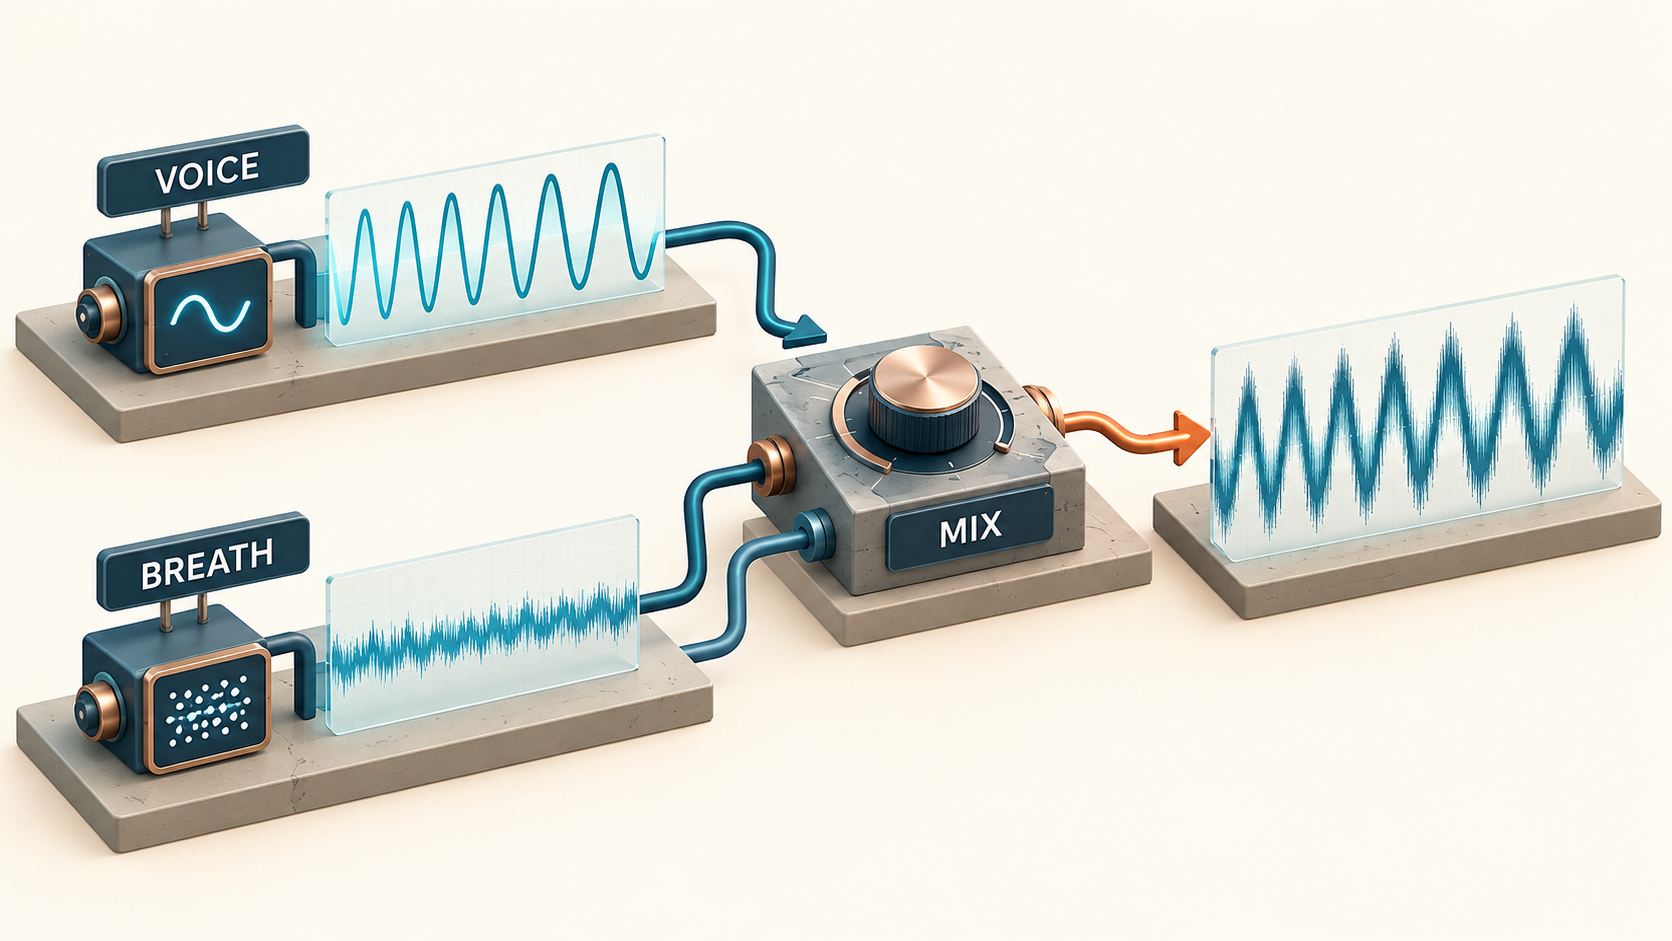
周期语音与气声使用独立增益,再经混合输出;呼吸包络不能硬切开关。
把关键规则缩成一个可运行例子
下面使用 Python 3 标准库表达算法规则,保存为 example.py 后运行 python3 example.py。它便于观察输入和输出,不替代引擎中的 C++、Shader 或模型实现。
from math import cos, pi
from random import Random
rng = Random(4)
n = 64
breath = [(2 * rng.random() – 1) * 0.05 *
(0.5 – 0.5 * cos(2*pi*i/(n-1))) for i in range(n)]
voice = [0.2] * n
mixed = [a + b for a, b in zip(voice, breath)]
assert abs(breath[0]) < 1e-12 and abs(breath[-1]) < 1e-12
assert max(abs(x) for x in mixed) <= 1.0
print("envelope endpoints: zero; mixed peak below 1")
本例输出:
envelope endpoints: zero; mixed peak below 1
这个小检查不能代替耳朵,但能先挡住可预测的问题。试听时保留原始音频和处理参数,允许听审结论是“这一段不需要呼吸声”。不是每个角色都应被同一种效果覆盖。
适用范围
未生成真实TTS、未试听音频,也没有进行生理建模、MOS双盲或设备CPU测试。
相关资料
- W3C Web Audio API 1.1草案