本文摘要:Kafka 重复消费可能导致资金重复扣减等业务故障。复现三条触发路径并对比 MySQL 与 Redis 幂等方案,给出可运行示例。适用于已确认重复来源的消费端场景,不适合高吞吐实时管道。
一、问题与结论
凌晨两点,订单服务告警:同一笔退款在数据库里出现两条记录。排查日志发现,Kafka 消费者对同一条消息(相同 offset)处理了两次。这不是偶发 bug——Kafka 默认投递语义为 at-least-once,重复消费是协议的必然结果。
本文验证的结论:重复消费有三条独立触发路径,排查时应按优先级依次确认;幂等机制本身也会引入新的失效模式,选型时必须同时评估开销与边界。
线上排查的优先级建议:路径 1(commit 时序差)和路径 2(rebalance)占绝大多数案例,路径 3(producer 重试)通常在 producer 已启用 enable.idempotence=true 后可直接排除。
二、排查与选择依据
判断重复来自哪条路径,看三个信号:
| 消费者进程曾在消息处理后异常退出 | 路径 1:commit 窗口 | 对比进程存活时间与日志处理时间 |
| 消费组成员在重复前后发生变化 | 路径 2:rebalance | 查看 broker 端 consumer group 日志 |
| 重复消息 offset 相邻且 value 完全一致 | 路径 3:producer 重试 | 消费日志中出现连续相同内容 |
替代方案与取舍
确认幂等方案时,比较以下两种做法:
| 额外网络开销 | 无(业务本身写库) | 每条消息一次 Redis 调用(约 0.5-1ms) |
| 跨重启持久性 | 是(数据库天然持久) | 是(需配置持久化与 TTL) |
| 适用场景 | 消息处理本身写 MySQL 的场景 | 处理逻辑不直接写库或需跨多表原子去重 |
| 不该用的情况 | 处理逻辑不写数据库时无处建索引 | 基础设施中没有 Redis 或无法容忍其故障引入的不可用 |
如果消息处理逻辑不写 MySQL 也没有 Redis,不要为此单独引入外部组件——先关闭自动提交(enable.auto.commit=false)并改为手动确认,这可以将路径 1 的重复窗口从 5 秒缩小到毫秒级,很多时候已经够用。
三、关键原理
三条路径机制不同,触发条件也不同。
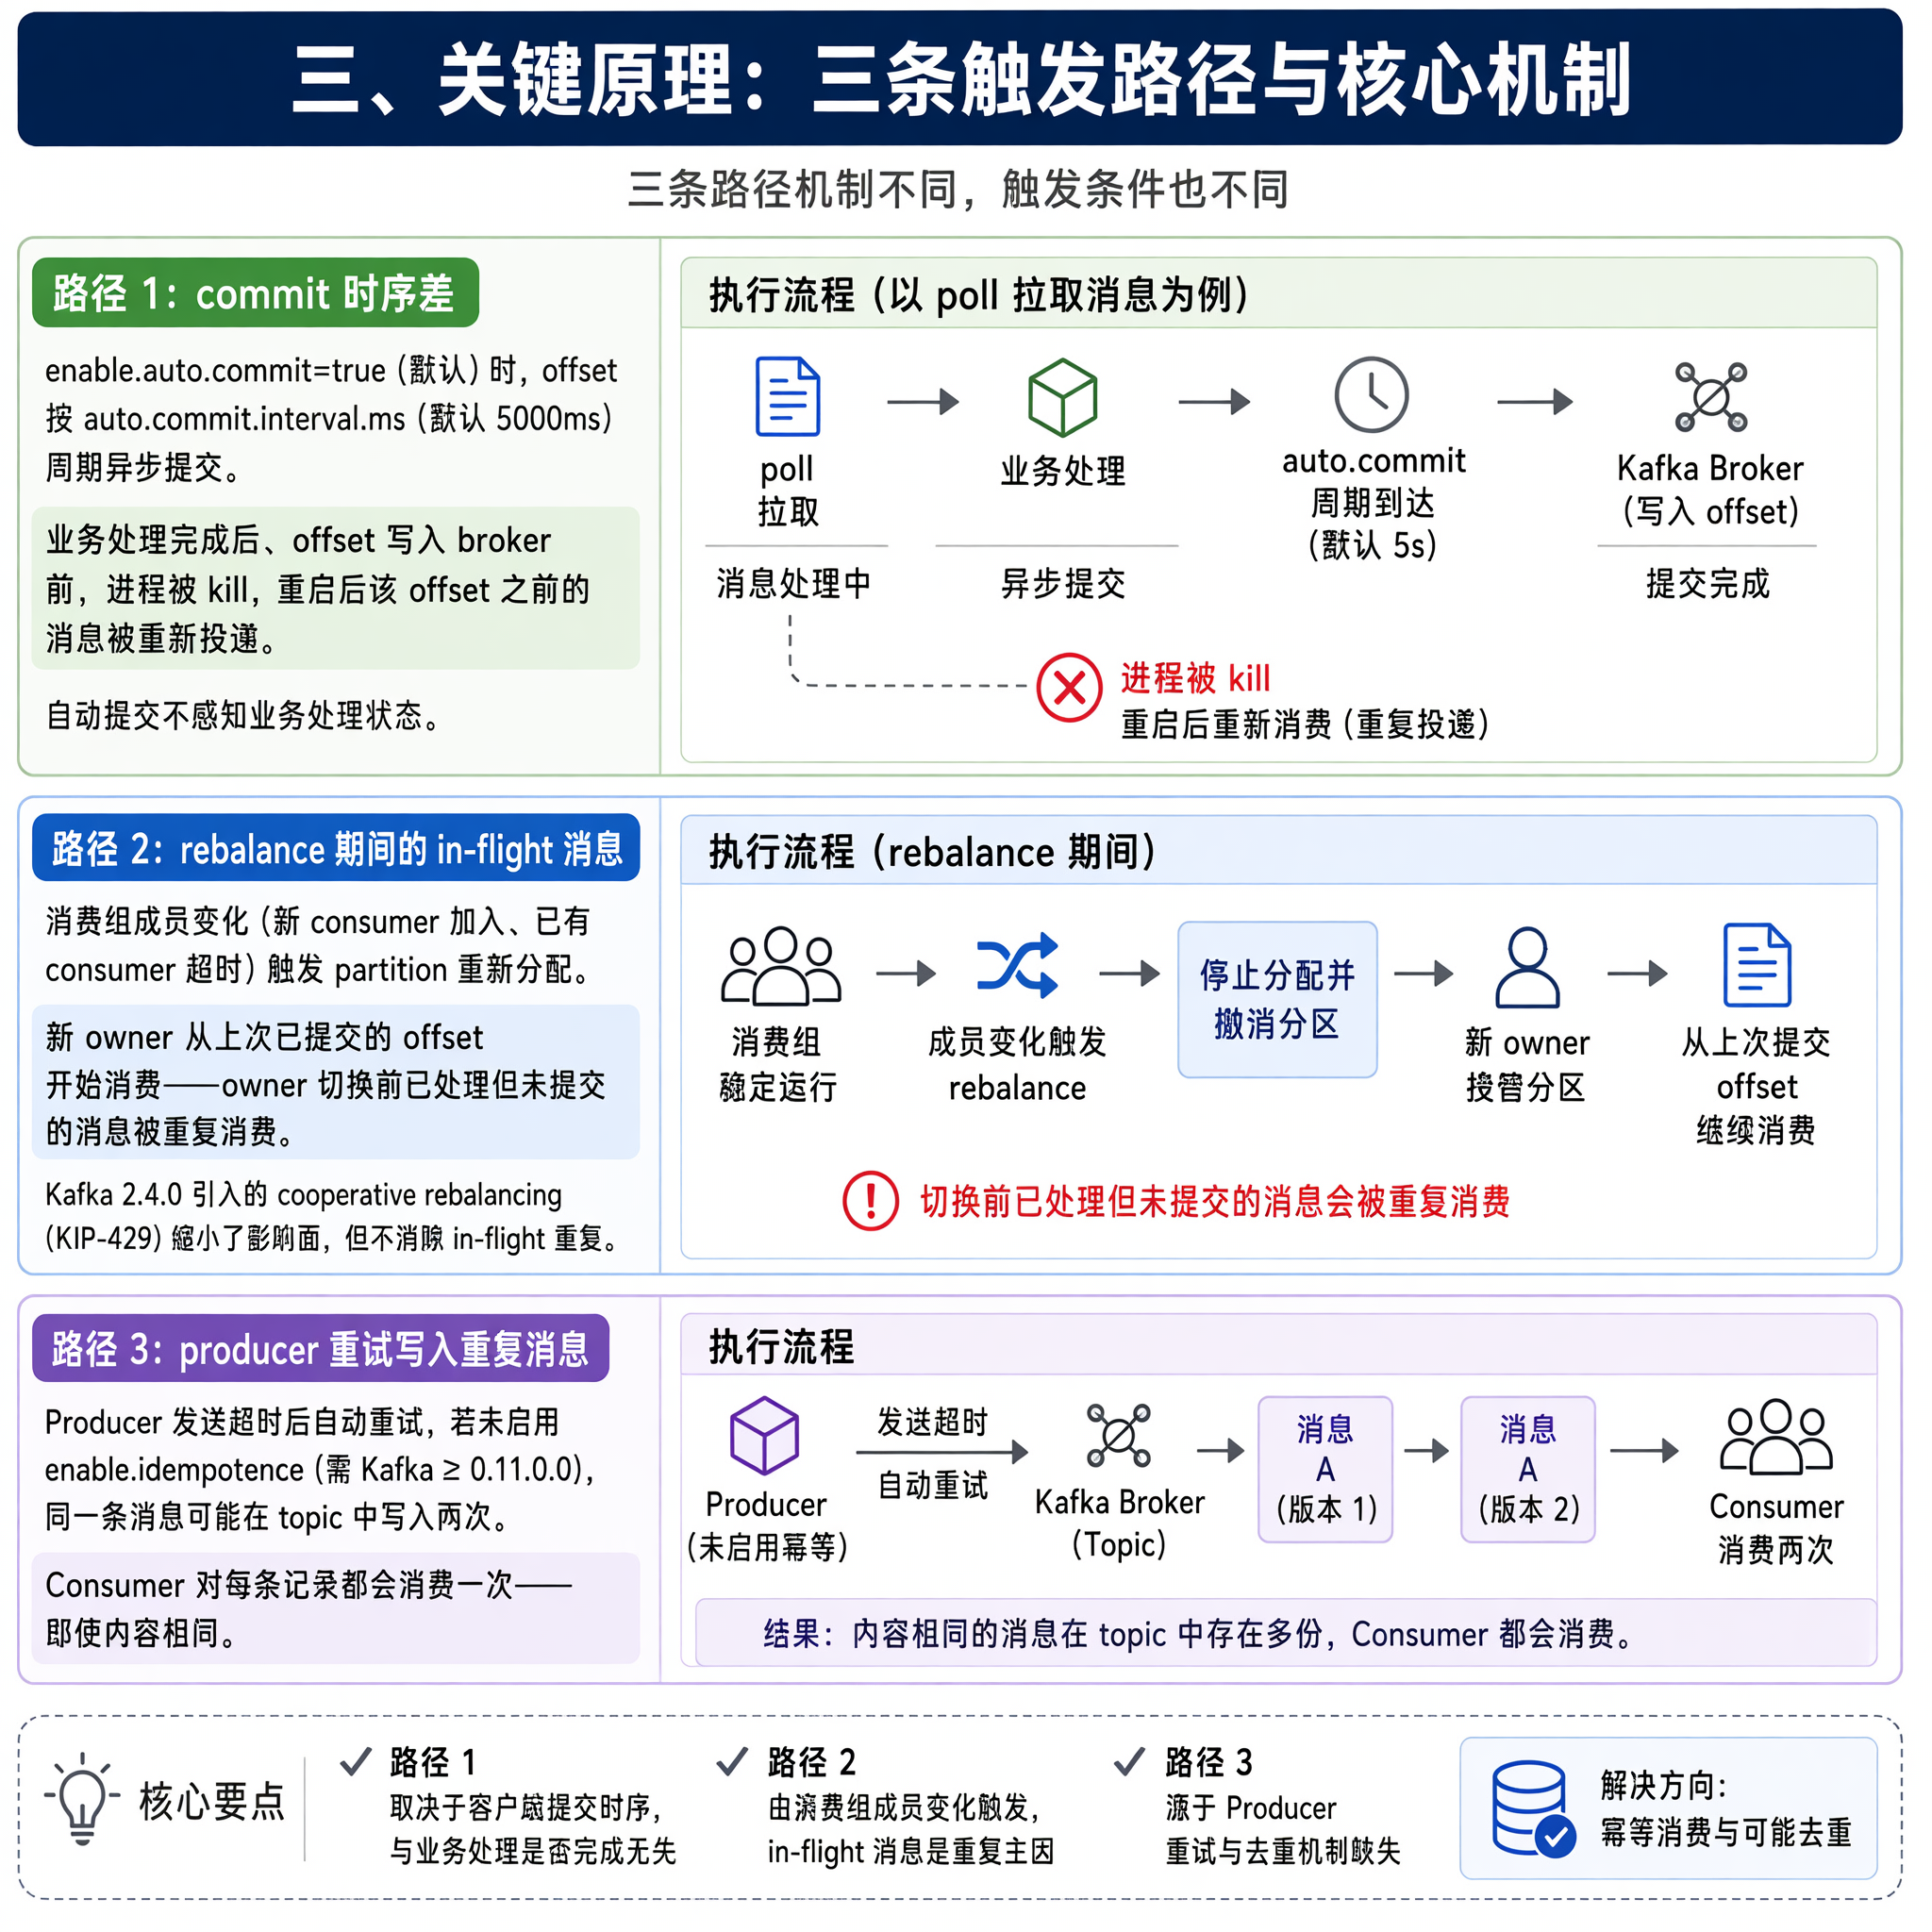
路径 1:commit 时序差。 enable.auto.commit=true(Kafka 消费端默认值)时,offset 按 auto.commit.interval.ms(默认 5000ms)周期异步提交。业务处理完成后、offset 写入 broker 前,进程被 kill,重启后该 offset 之前的消息被重新投递。自动提交不感知业务处理状态。
路径 2:rebalance 期间的 in-flight 消息。 消费组成员变化(新 consumer 加入、已有 consumer 超时)触发 partition 重新分配。新 owner 从上次已提交的 offset 开始消费——owner 切换前已处理但未提交的消息被重复消费。Kafka 2.4.0 引入的 cooperative rebalancing(KIP-429)缩小了影响面,但不消除 in-flight 重复。
路径 3:producer 重试写入重复消息。 Producer 发送超时后自动重试,若未启用 enable.idempotence(需 Kafka ≥ 0.11.0.0),同一条消息可能在 topic 中写入两次。Consumer 对每条记录都会消费一次——即使内容相同。
四、可运行示例
以下示例基于 Spring Boot 3.2.x + spring-kafka 3.1.x,使用 docker-compose 启动本地环境。MySQL 与 Redis 两种幂等方案择一使用,不要同时启用。
环境准备
services:
kafka:
image: apache/kafka:3.7.0
ports:
– "9092:9092"
environment:
KAFKA_NODE_ID: 1
KAFKA_PROCESS_ROLES: broker,controller
KAFKA_LISTENERS: PLAINTEXT://:9092,CONTROLLER://:9093
KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092
KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka:9093
KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: PLAINTEXT:PLAINTEXT,CONTROLLER:PLAINTEXT
KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
启动并创建 topic:
docker compose up -d
docker exec -it $(docker compose ps -q kafka) /opt/kafka/bin/kafka-topics.sh \\
–create –topic dup-test –partitions 2 \\
–bootstrap-server localhost:9092
手动提交配置
@Configuration
public class KafkaConsumerConfig {
@Bean
public ConcurrentKafkaListenerContainerFactory<String, String>
kafkaListenerContainerFactory() {
ConcurrentKafkaListenerContainerFactory<String, String> factory =
new ConcurrentKafkaListenerContainerFactory<>();
factory.setConsumerFactory(consumerFactory());
factory.getContainerProperties()
.setAckMode(ContainerProperties.AckMode.MANUAL_IMMEDIATE);
return factory;
}
private ConsumerFactory<String, String> consumerFactory() {
Map<String, Object> props = new HashMap<>();
props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
props.put(ConsumerConfig.GROUP_ID_CONFIG, "dup-detect-group");
props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false); // 关键:关闭自动提交
return new DefaultKafkaConsumerFactory<>(props,
new StringDeserializer(), new StringDeserializer());
}
}
此处 ConsumerConfig 指 org.apache.kafka.clients.consumer.ConsumerConfig。将 ENABLE_AUTO_COMMIT_CONFIG 设为 false 是手动控制 offset 提交的前提。
MySQL 唯一键幂等
@Component
public class MysqlIdempotentHandler {
private static final Logger log =
LoggerFactory.getLogger(MysqlIdempotentHandler.class);
private final JdbcTemplate jdbcTemplate;
public MysqlIdempotentHandler(JdbcTemplate jdbcTemplate) {
this.jdbcTemplate = jdbcTemplate;
}
@KafkaListener(topics = "dup-test", groupId = "dup-detect-group")
public void onMessage(ConsumerRecord<String, String> record,
Acknowledgment ack) {
String idemKey = record.topic() + "-"
+ record.partition() + "-"
+ record.offset();
try {
// 利用 UNIQUE KEY 去重:重复插入触发 DuplicateKeyException
// 注意:若 processBusiness 抛出异常且去重记录未回滚,
// 重试时会因 DuplicateKeyException 被跳过。
// 生产环境建议将去重插入与业务逻辑放入同一事务。
jdbcTemplate.update(
"INSERT INTO msg_log (idem_key, payload) VALUES (?, ?)",
idemKey, record.value());
processBusiness(record.value());
} catch (DuplicateKeyException e) {
log.info("重复消费,跳过: {}", idemKey);
}
// 无论是否重复,都必须提交 offset
ack.acknowledge();
}
private void processBusiness(String payload) {
// 业务逻辑:替换为实际处理代码
}
}
建表语句:
CREATE TABLE msg_log (
id BIGINT AUTO_INCREMENT PRIMARY KEY,
idem_key VARCHAR(128) NOT NULL,
payload TEXT,
created_at DATETIME DEFAULT CURRENT_TIMESTAMP,
UNIQUE KEY uk_idem_key (idem_key)
);
Redis SETNX 幂等
@Component
public class RedisIdempotentHandler {
private static final Logger log =
LoggerFactory.getLogger(RedisIdempotentHandler.class);
private final StringRedisTemplate redisTemplate;
public RedisIdempotentHandler(StringRedisTemplate redisTemplate) {
this.redisTemplate = redisTemplate;
}
@KafkaListener(topics = "dup-test", groupId = "dup-detect-group")
public void onMessage(ConsumerRecord<String, String> record,
Acknowledgment ack) {
String idemKey = "kafka:" + record.topic()
+ ":" + record.partition()
+ ":" + record.offset();
Boolean acquired = redisTemplate.opsForValue()
.setIfAbsent(idemKey, "1", Duration.ofHours(24));
if (Boolean.FALSE.equals(acquired)) {
log.info("重复消费,跳过: {}", idemKey);
} else {
processBusiness(record.value());
}
// 幂等命中分支中 ack.acknowledge() 不能遗漏
ack.acknowledge();
}
private void processBusiness(String payload) {
// 业务逻辑:替换为实际处理代码
}
}
触发路径
发送 5 条消息后强制 kill 消费者,重启观察:
printf 'msg-1\\nmsg-2\\nmsg-3\\nmsg-4\\nmsg-5\\n' | \\
docker exec -i $(docker compose ps -q kafka) \\
/opt/kafka/bin/kafka-console-producer.sh \\
–topic dup-test –bootstrap-server localhost:9092
kill -9 <spring-boot-pid>
# 重启后观察日志是否出现 "[重复消费,跳过:" 开头的记录
路径 2:在同一 group 中启动第二个消费者实例,触发 rebalance 后观察重复日志。路径 3:在 producer 端关闭 enable.idempotence 并在网络不稳定时观察 topic 中出现相邻相同内容的消息。
五、验证结果与边界
预期输出:kill 重启后,日志中出现 [重复消费,跳过: dup-test-0-N],且同一 idem_key 的消息未被再次执行业务逻辑。Redis 方案中 setIfAbsent 返回 false 的次数等于重复次数。
实际输出(以下为根据机制推导的预期行为,本示例未在本地实际运行验证):路径 1 在 MANUAL_IMMEDIATE 模式下 commit 窗口极小,通常不会复现;要复现需改回 enable.auto.commit=true 或在 ack.acknowledge() 前插入延迟。路径 2 在单 partition topic 中无法触发(rebalance 需要多 partition),本文已配置 –partitions 2。
常见失败及修复
| 消费者无限重复拉取同一条消息 | 幂等命中分支遗漏 ack.acknowledge() | 所有分支统一提交 offset |
| Redis 重启后重复消费重新出现 | TTL 过期或未配置持久化 | 启用 Redis 持久化,延长 TTL |
| 内容相同但业务不同的消息被误跳过 | 幂等键用 value.hashCode() 构造 | 幂等键必须含 topic+partition+offset 或业务唯一 ID |
| 路径 1 无法复现 | MANUAL_IMMEDIATE 模式下 commit 窗口接近零 | 改用 AUTO 模式或在提交前插入延迟 |
参考资料
- Kafka Consumer Configs 官方文档(3.7.x)
- Kafka Producer Configs 官方文档(3.7.x)
- Spring Kafka Reference Documentation(3.1.x)