摘要:从 Acceptor 接连接到响应写回客户端,前八篇把 Kafka Broker 网络层的每个环节拆开讲了一遍。这篇不再抠某个方法,而是退后一步做一次整体鉴赏——1+N+M 线程模型怎么分工、六大经典并发手段如何环环相扣、这套设计对我们写中间件有什么可迁移的启示。
关键词:Kafka网络设计、Reactor模式、IO业务分离、事件驱动、背压、线程封闭、高并发
为什么值得专门鉴赏一次
很多中间件的网络层都是"能用就行",Kafka 的网络层却值得当成教科书来读。原因很直接:它要在上万条长连接、每秒几十万请求的压力下,同时做到低延迟、不丢数据、慢客户端不拖垮整体。
更难得的是,它没有用任何花哨的框架——Broker 网络层就是基于 Java NIO 手写的一千多个类协作,靠的全是经典并发模型的精准落地。前面八篇我们逐个看过零件,这篇把它们装回整机,看看这台机器为什么转得这么顺。
01 整机结构:1 + N + M 线程模型
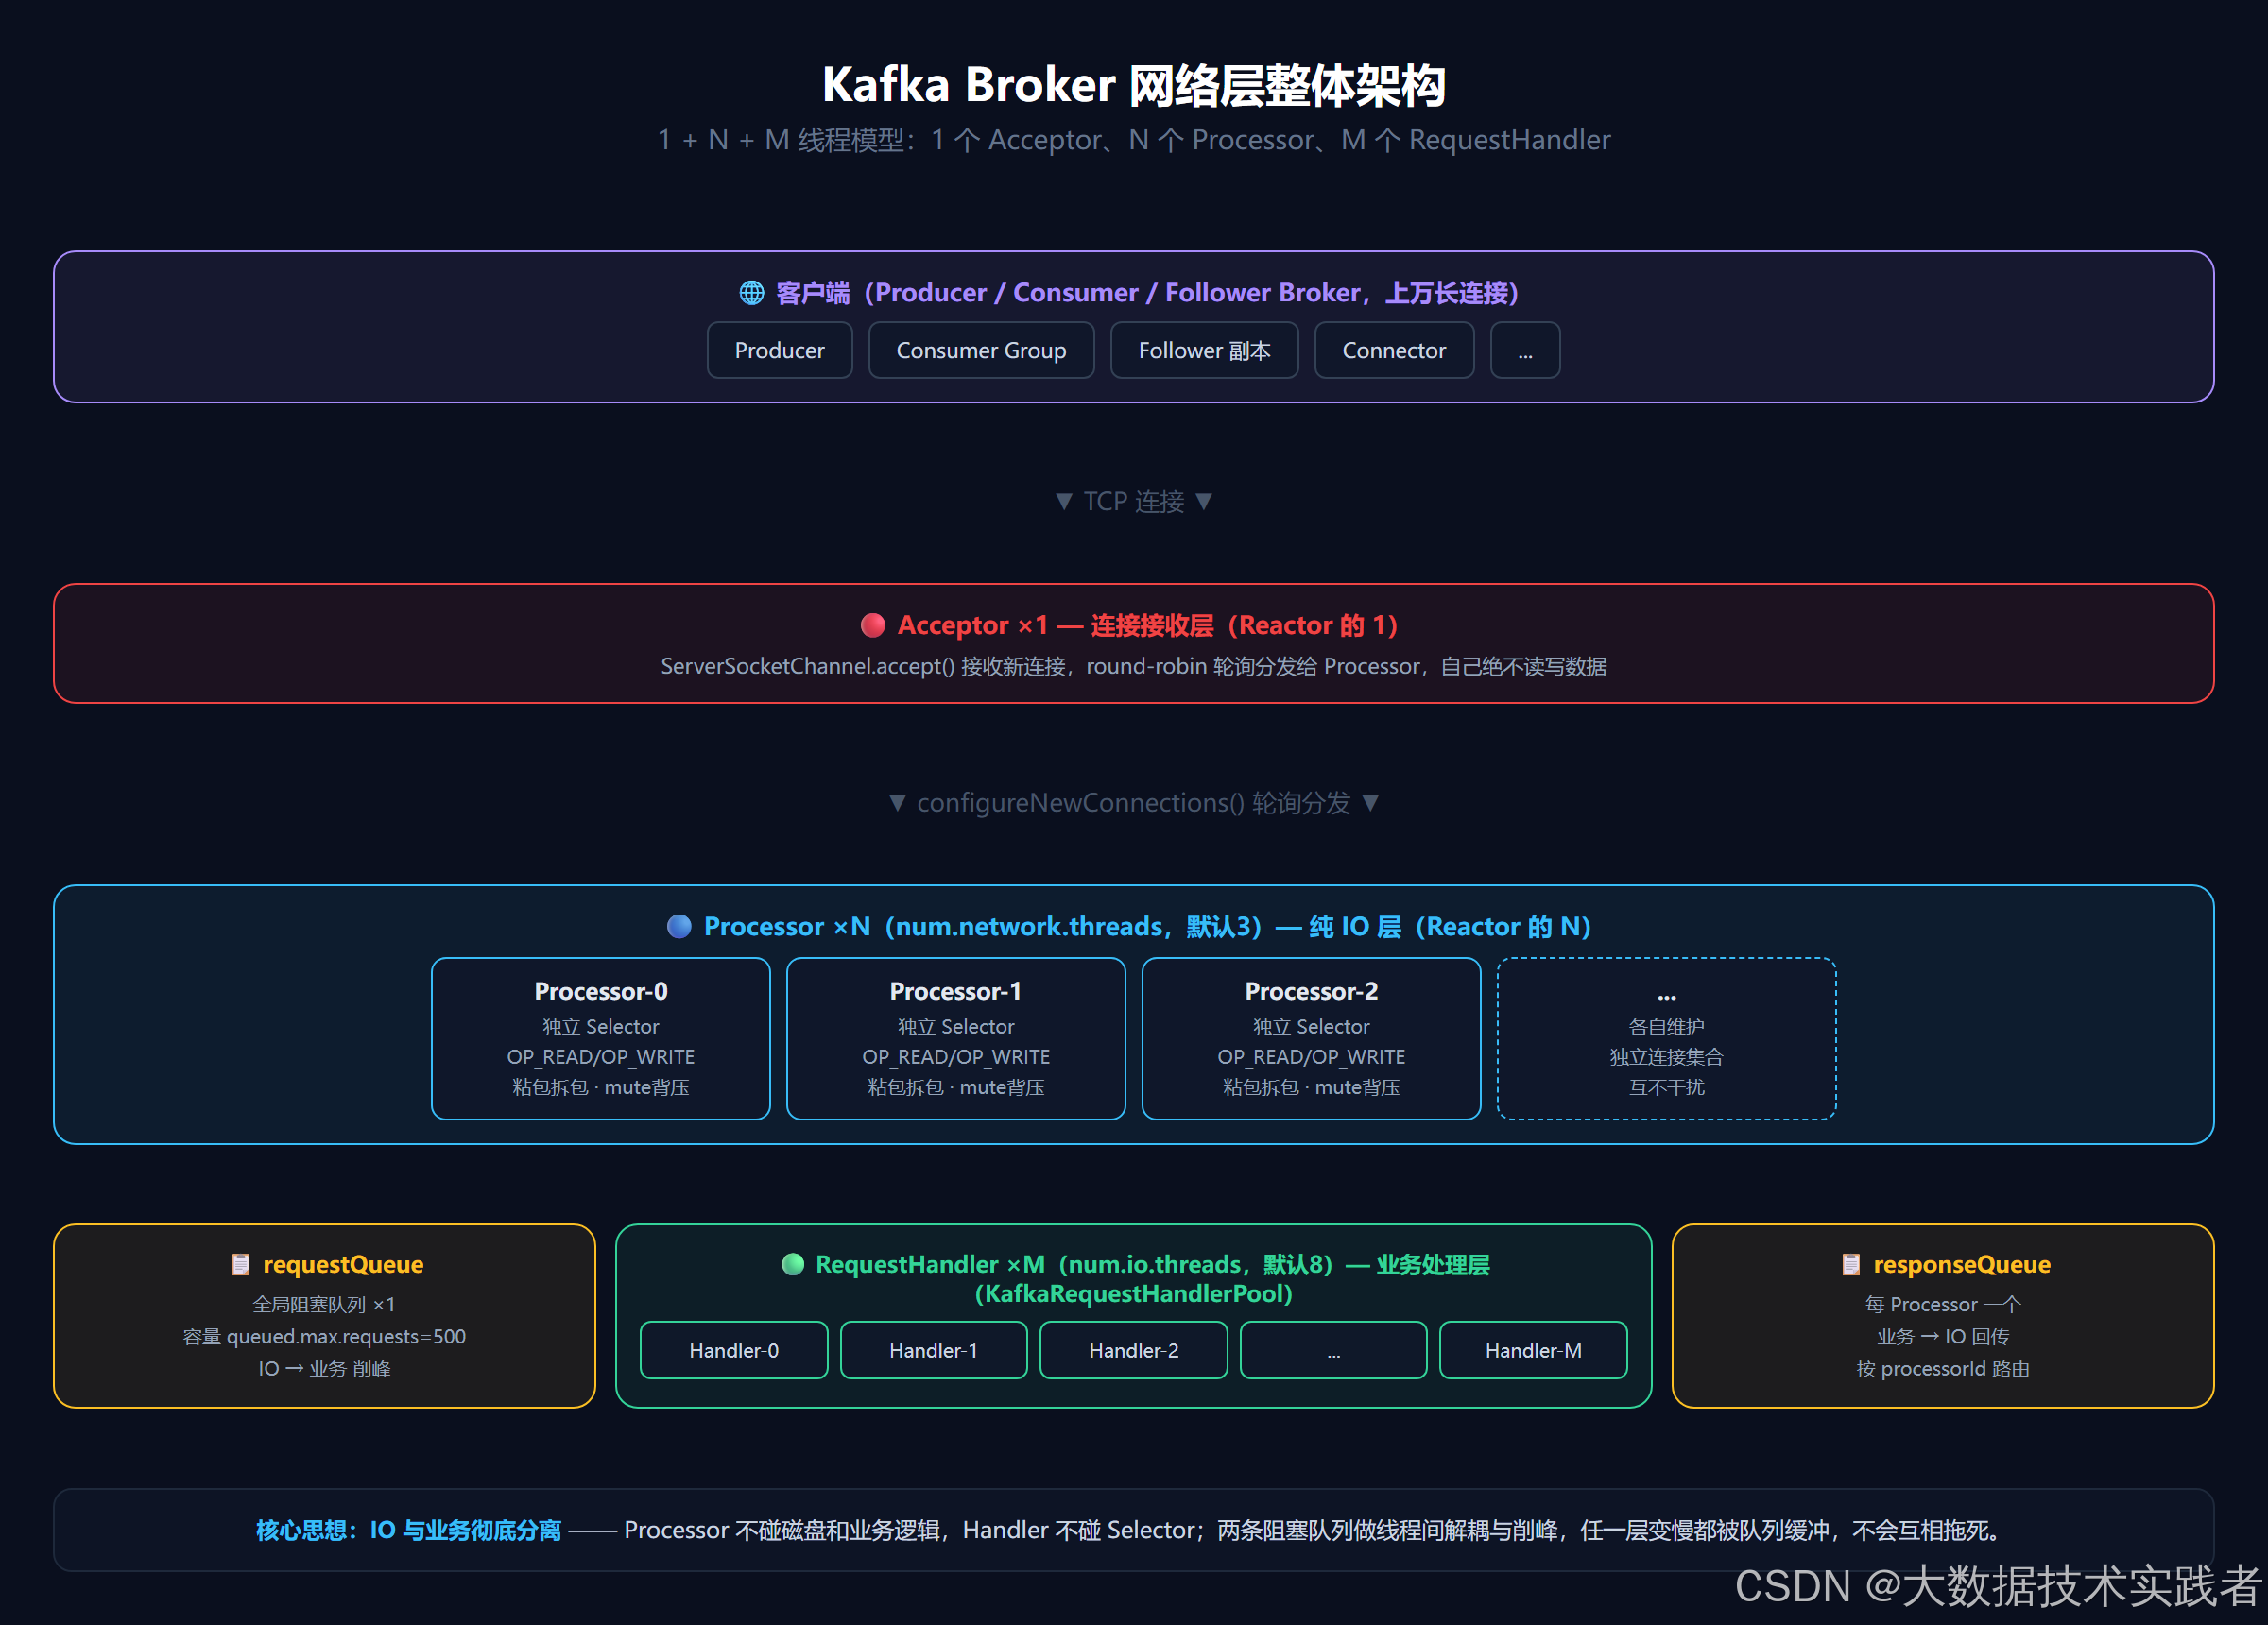
Kafka Broker 的网络层是一个标准的 1+N+M 线程模型,本质是主从 Reactor(Reactor 多线程模式)的落地:
Acceptor ×1 只负责 accept() 接连接,轮询分发
Processor ×N 只负责 IO(读写字节、协议解析),默认3个
RequestHandler ×M 只负责业务(写盘/读盘/协调),默认8个
三类线程之间用两条队列衔接:Processor 把解析好的 Request 放进全局 requestQueue;RequestHandler 处理完,按 processorId 把 Response 放进对应 Processor 的 responseQueue。
这个结构最妙的地方是职责的绝对单一:
- Acceptor 永远不读写数据,接完连接就撒手,不会因为某个连接的数据量大而耽误接新连接
- Processor 永远不碰磁盘和业务逻辑,一次 poll 处理成百上千连接的就绪事件,每个动作都是微秒级
- RequestHandler 永远不碰 Selector,慢就慢在自己这层,阻塞的是 take() 出来的业务线程,网络收发照常转
很多人自己写 NIO 服务会把"读数据+处理业务+写结果"全塞进 IO 线程,结果一个慢查询把整个 Selector 卡住,所有连接一起延迟。Kafka 从架构上就杜绝了这个可能。
02 六大设计手段,各治一个病

鉴赏这套网络层,最有价值的是看清每个设计手段对应解决哪个具体瓶颈:
① Reactor 多路复用——治"连接多"。 一个 Processor 用一个 Selector 同时监听上千连接,线程数和连接数彻底解耦。没有它,上万连接就得上万线程,光上下文切换就崩了。
② IO 与业务分离——治"慢操作阻塞"。 磁盘读写是毫秒级,网络收发是微秒级,混在一起必然互相拖累。分两层、各自独立扩线程数,是最朴素也最有效的隔离。
③ 事件驱动非阻塞——治"线程空等"。 OP_READ 有数据才读,OP_WRITE 缓冲区有空才写,线程永远在处理"已经就绪"的事件,不做任何主动等待。半包靠 ByteBuffer 的 position 游标续传,没读全/没写完,下次事件接着来。
④ 连接级背压——治"慢客户端拖垮内存"。 这是最容易被忽略、却最关键的一个。Processor 读入请求后立刻 mute 这个连接(取消 OP_READ),直到响应完全发完才 unmute。慢客户端只会让自己的请求排队,Broker 不会为它无限缓冲响应。
⑤ 队列削峰——治"流量突增"。 requestQueue 容量 500,请求洪峰来了先排队而不是直接压垮业务线程;队列满了反过来触发 mute,从 TCP 源头限流。队列同时是缓冲器和熔断器。
⑥ 线程封闭免锁——治"锁竞争"。 每个 Selector、每条连接只被所属的 Processor 线程操作,Handler 处理完按 processorId 把响应放回对应队列,跨线程只通过队列传递不可变的 Request/Response。整个网络层几乎没有显式锁,这是单线程 Reactor 能跑出高吞吐的根本。
这六点不是六个孤立的技巧,而是一条因果链:多路复用带来海量连接 → 海量连接要求 IO 业务分离 → 分离后靠队列衔接 → 队列配合背压防内存失控 → 全程事件驱动 + 线程封闭避免锁和阻塞。抽掉任何一环,其余设计都会出问题。
03 顺着线程泳道看一次完整流转

把一个 Produce 请求从进来到响应出去,按线程泳道拉一遍,跨线程的边界看得最清楚:
Acceptor线程: accept() → 轮询选 Processor → 撒手
Processor线程: 注册连接(OP_READ+mute) → poll读字节 → 粘包拆包 → 组装Request → 入requestQueue
⋮(Processor 转头继续服务其他连接,不等结果)
RequestHandler: take()阻塞取出 → apiKey策略路由 → 写日志+等副本 → 组装Response → 按processorId入responseQueue
Processor线程: processNewResponses取出 → 序列化(写length前缀) → 注册OP_WRITE
→ poll可写 → writeToSocket(可能半包续传多次) → completedSends回调 → unmute
注意两次跨线程的边界:Processor→队列→Handler,Handler→队列→Processor。跨线程传递的只有 Request/Response 这类数据对象,没有任何可变的 Selector 状态穿过线程边界。这就是线程封闭能成立的前提——状态不跨线程,跨线程的只有消息。
04 可迁移的工程启示
鉴赏最终要落到自己的代码上。这套设计里有三条经验,写任何高并发服务都用得上:
第一,先分层隔离,再谈优化。 Kafka 没有一上来就堆性能技巧,而是先用线程模型把"连接接收、网络IO、业务处理"三种节奏完全不同的工作隔离开。分层做对了,后面的调优才有地方使力;分层做错了,再多优化都是在给耦合打补丁。
第二,背压要设计在离源头最近的地方。 Kafka 的限流不是在业务层拒绝请求,而是在 Processor 层直接 mute 掉 TCP 连接的读事件——让数据停在客户端/内核缓冲区,而不是进了应用内存再想办法。背压越靠近数据源,需要自己扛的内存就越少。
第三,能用队列传递就别共享可变状态。 requestQueue/responseQueue 本质是生产者-消费者模式,它把"多个 IO 线程和多个业务线程协作"这个看似需要大量锁的问题,化成了线程各自操作自己那一端的无锁结构。中间件里凡是出现多线程协作,先想能不能用队列 + 不可变消息替代共享状态加锁,十有八九能更简单也更快。
写在最后
Kafka 网络层给我最大的触动是:高并发不靠某个黑科技,靠的是把每个经典模型都用在正确的位置。Reactor、生产者消费者、线程封闭、背压,全是教科书里的老面孔,但能像 Kafka 这样把它们严丝合缝拼成一台机器、并且每个细节(半包、mute、length 前缀、processorId 路由)都自洽的系统,并不多见。
读源码读到这个层次,记住的就不再是某个类叫什么,而是"遇到这类问题,顶级工程师是怎么拆的"。这大概才是读 Kafka 源码真正的回报。