/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目
目录
- 基于大数据的城市尾气排放数据可视化分析介绍
- 基于大数据的城市尾气排放数据可视化分析演示视频
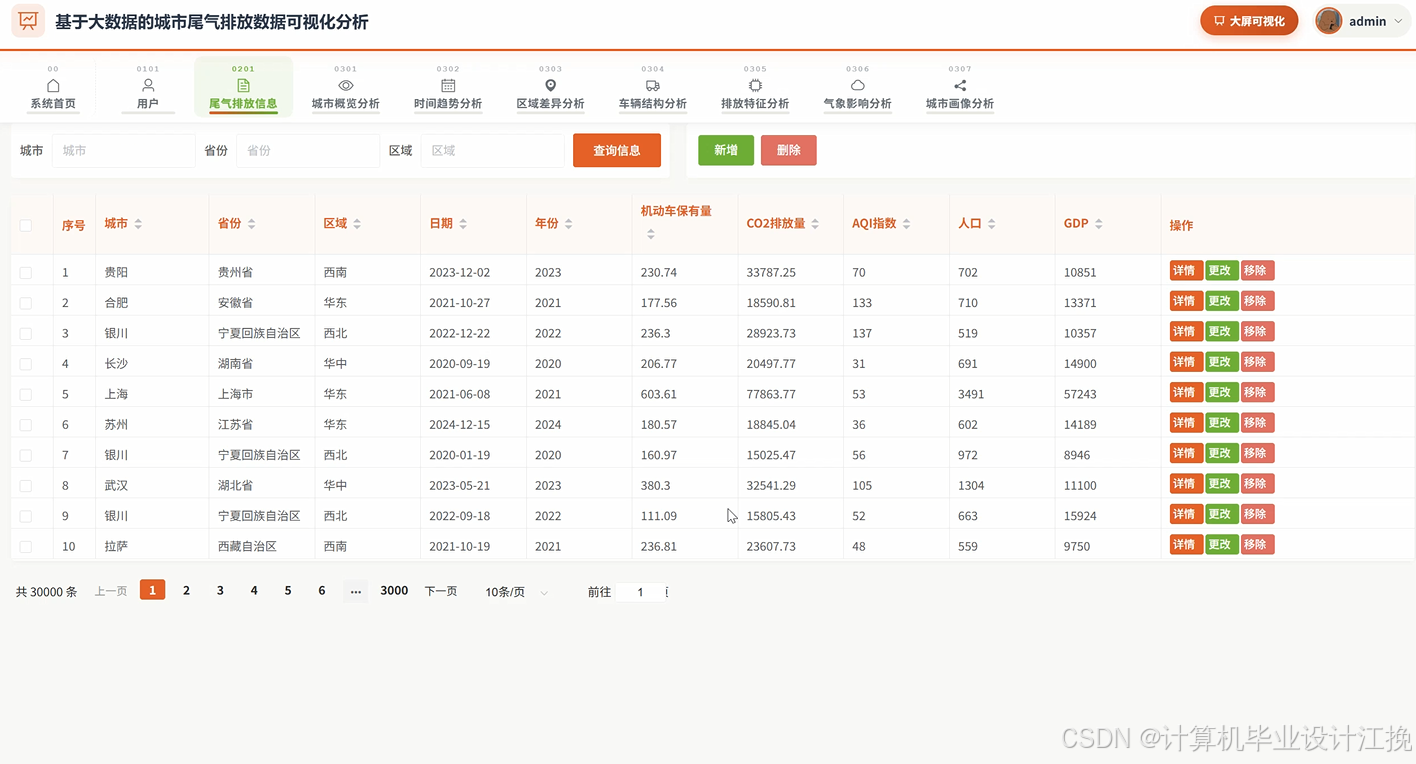
- 基于大数据的城市尾气排放数据可视化分析演示图片
- 基于大数据的城市尾气排放数据可视化分析代码展示
- 基于大数据的城市尾气排放数据可视化分析文档展示
基于大数据的城市尾气排放数据可视化分析介绍
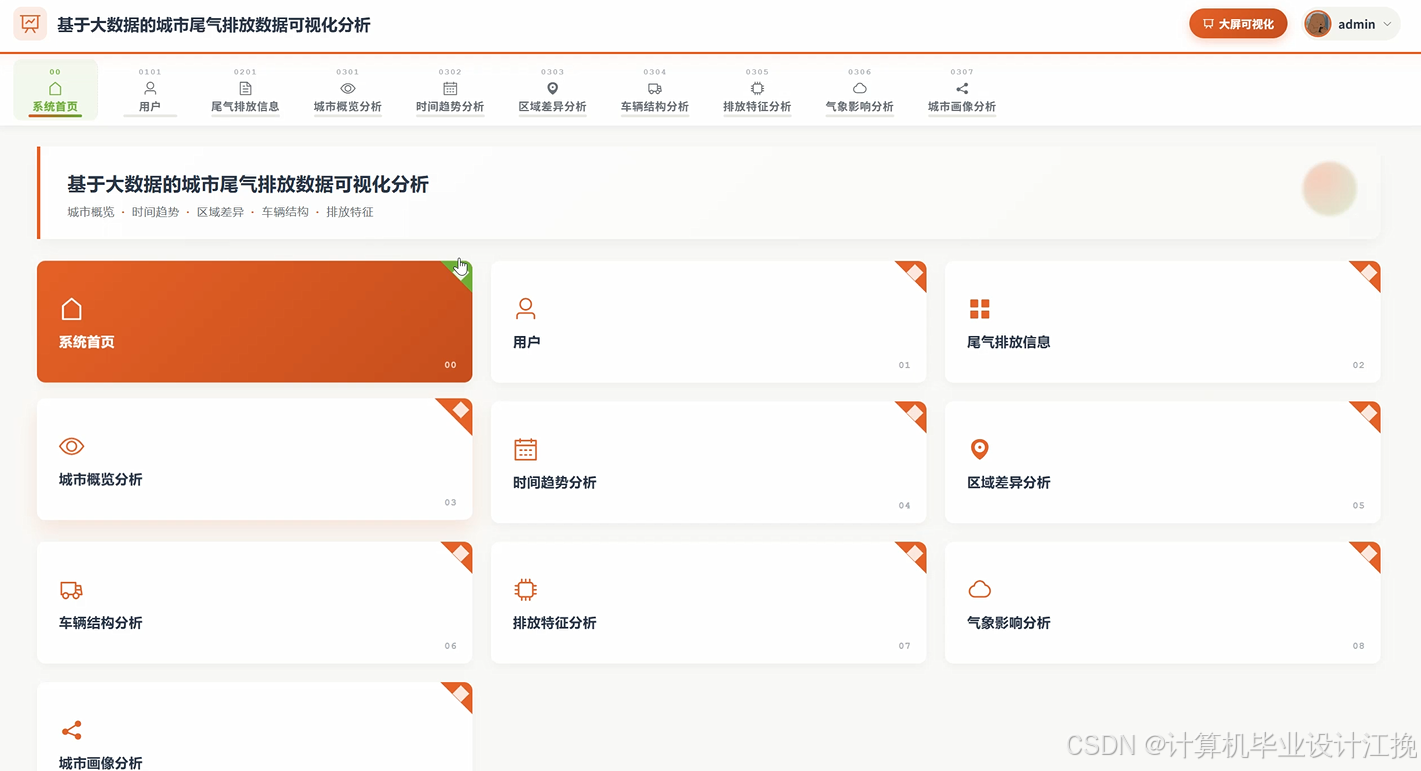
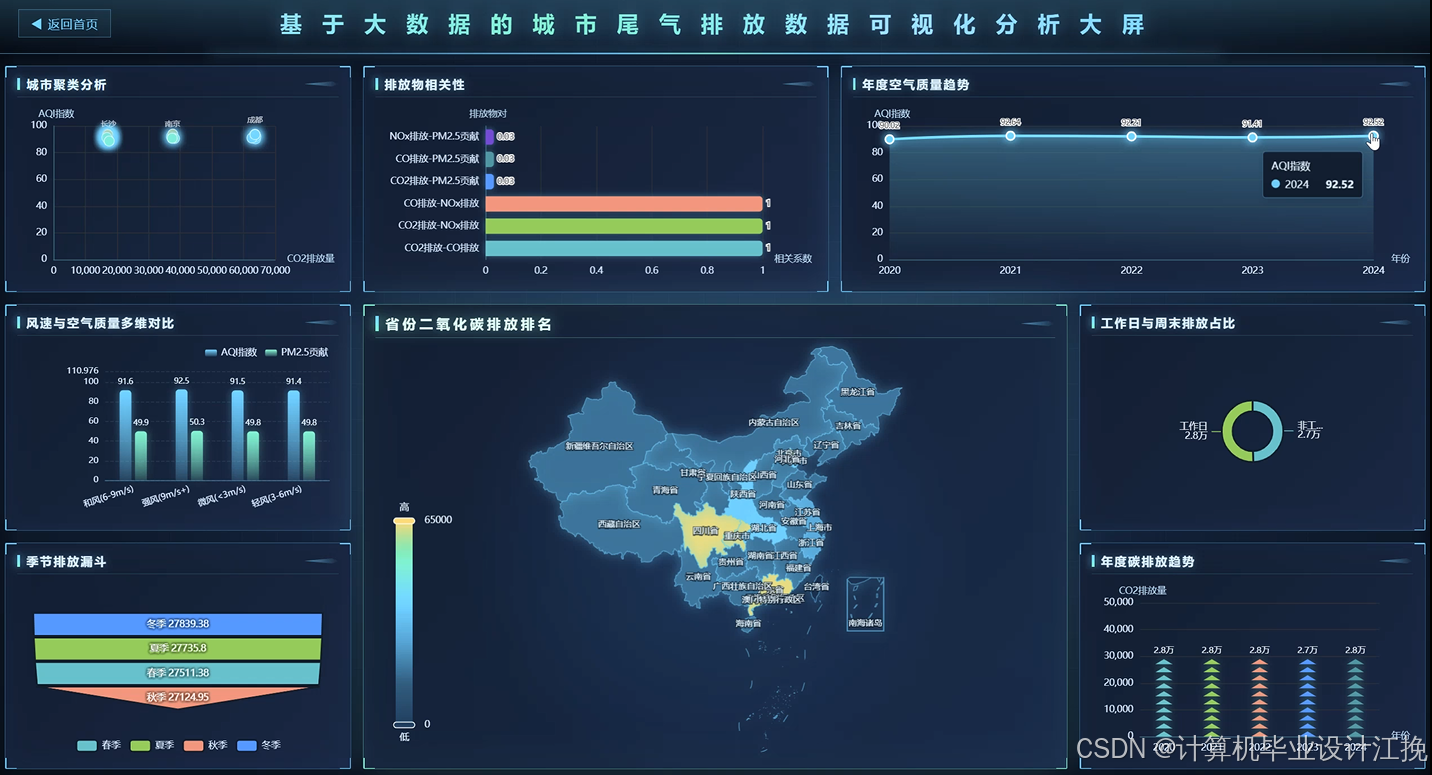
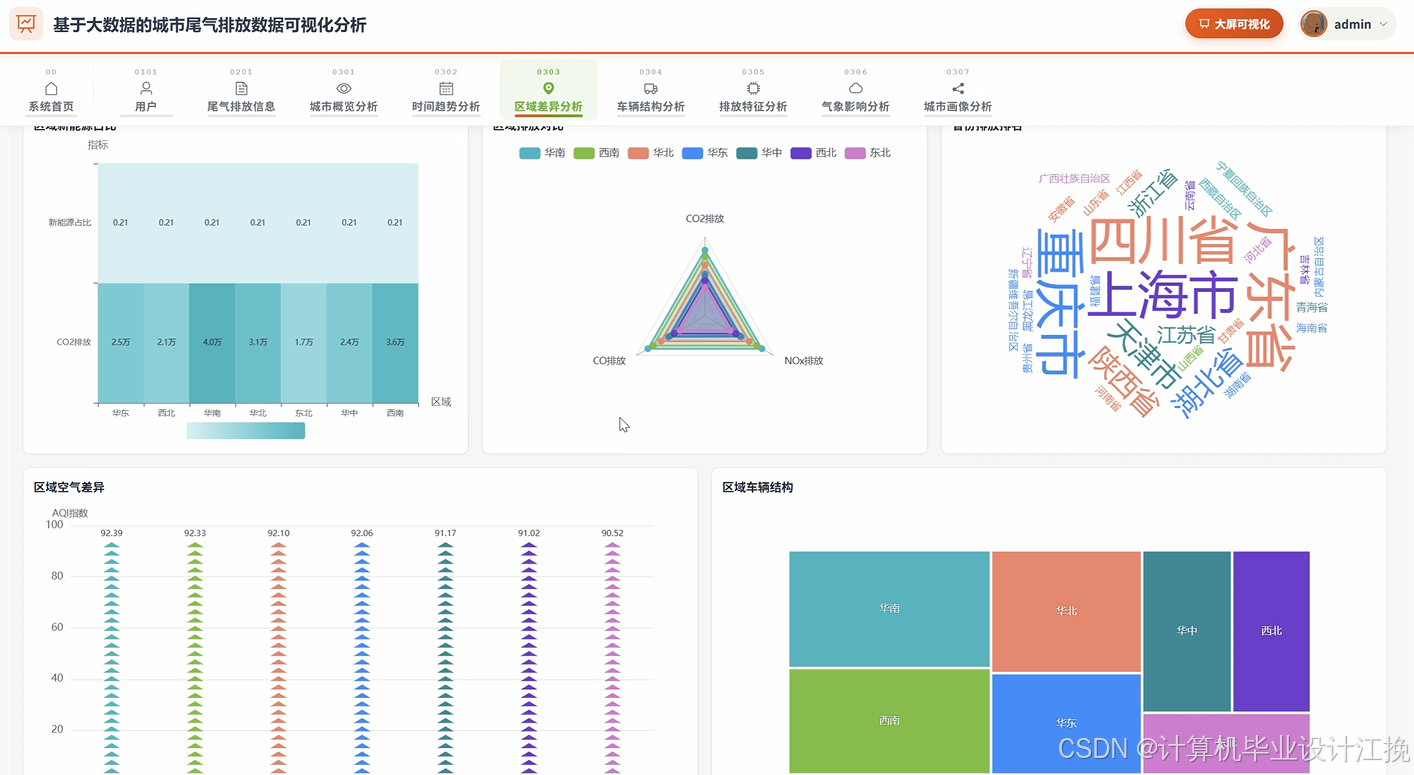
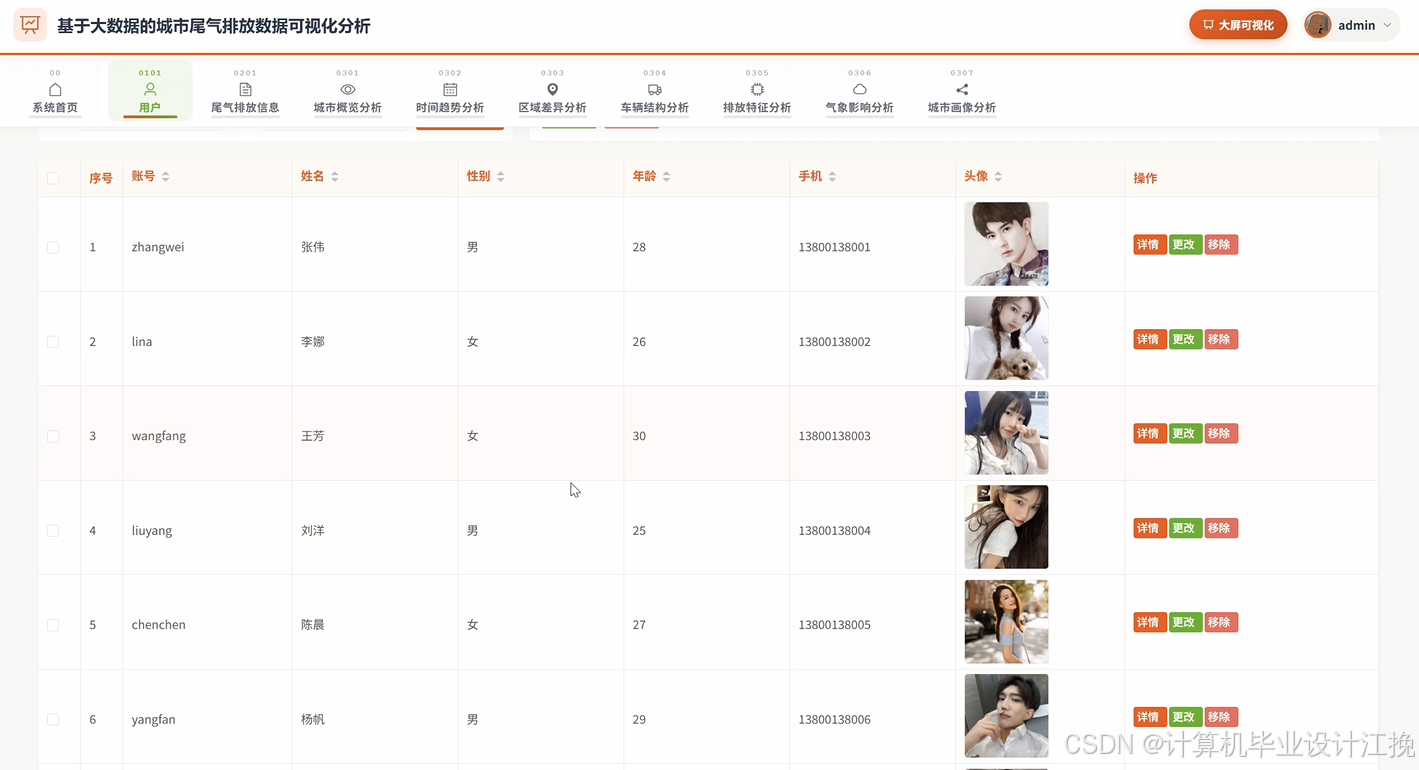
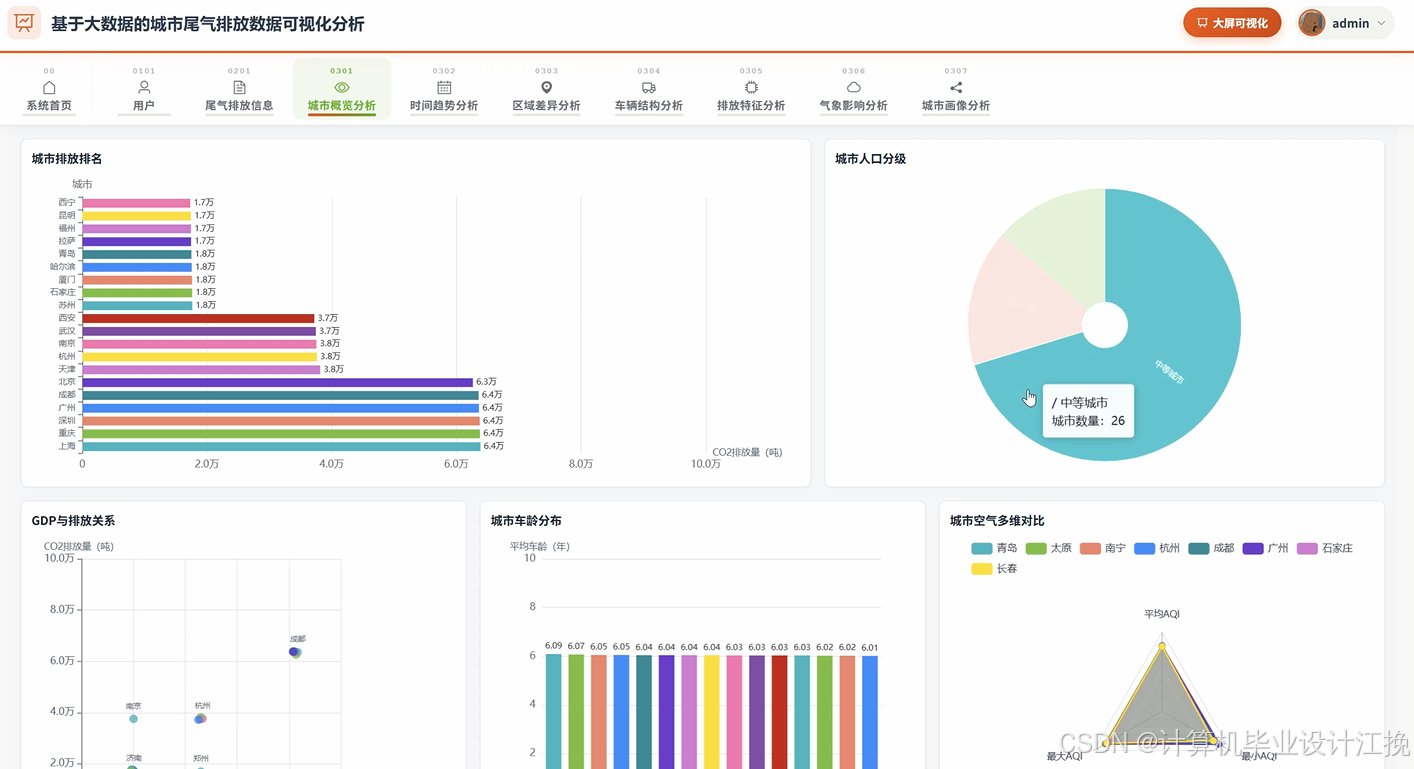
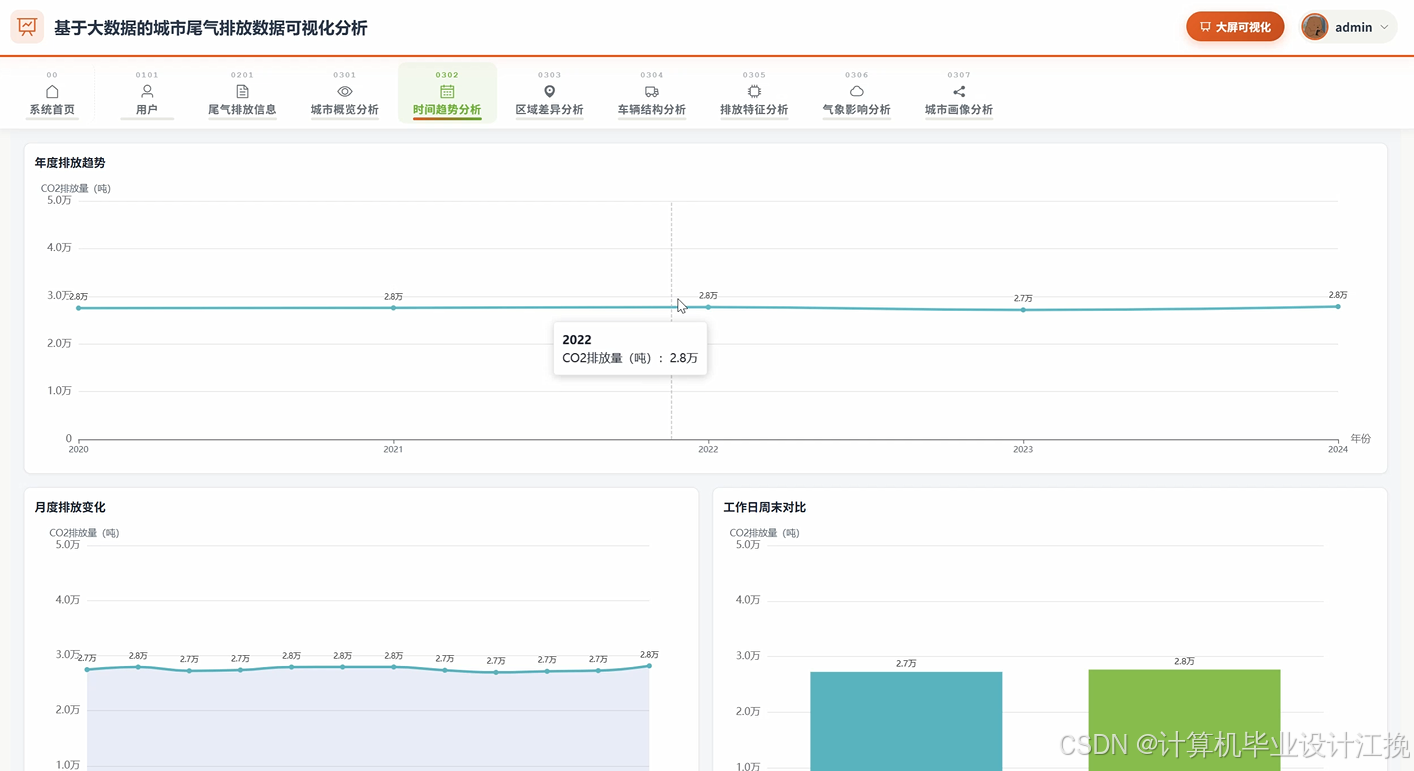
本系统《基于大数据的城市尾气排放数据可视化分析》面向城市环境管理部门与交通规划决策支持场景,旨在解决传统尾气监测数据量大、来源异构、分析手段滞后等问题。系统采用Hadoop分布式文件系统(HDFS)存储海量历史尾气监测记录,借助Spark计算引擎进行高效数据清洗、聚合与多维度统计,并利用Spark SQL实现复杂查询分析。后端同时提供Python(Django)与Java(Spring Boot)双版本支持,前端采用Vue框架结合ECharts可视化库,实现数据看板的动态交互展示。系统核心功能涵盖尾气排放信息的增删改查、城市概览综合指标分析、时间序列趋势挖掘、区域差异化对比、车辆类型结构解析、排放特征分布统计、气象因子关联影响分析以及城市综合画像生成,全方位支撑城市尾气排放的精细化治理与科学决策。
基于大数据的城市尾气排放数据可视化分析演示视频
演示视频
基于大数据的城市尾气排放数据可视化分析演示图片
基于大数据的城市尾气排放数据可视化分析代码展示
// 功能1:城市概览分析 – 计算各城市平均排放浓度与总排放量 @Override public Map<String, Object> getCityOverview(String dateRange) { SparkSession spark = SparkSession.builder().appName(“EmissionOverview”).getOrCreate(); Dataset df = spark.read().option(“header”, true).csv(“hdfs:///emission_data/*.csv”); Dataset filtered = df.filter(df.col(“date”).between(dateRange.split(“,”)[0], dateRange.split(“,”)[1])); Dataset grouped = filtered.groupBy(“city”).agg(functions.avg(“co_concentration”).alias(“avg_co”), functions.avg(“nox_concentration”).alias(“avg_nox”), functions.avg(“pm_concentration”).alias(“avg_pm”), functions.sum(“emission_volume”).alias(“total_emission”)); List rows = grouped.collectAsList(); Map<String, Object> result = new HashMap<>(); for (Row row : rows) { Map<String, Double> cityData = new HashMap<>(); cityData.put(“avgCo”, row.getDouble(1)); cityData.put(“avgNox”, row.getDouble(2)); cityData.put(“avgPm”, row.getDouble(3)); cityData.put(“totalEmission”, row.getDouble(4)); result.put(row.getString(0), cityData); } return result; }
// 功能2:时间趋势分析 – 按月份统计某城市尾气排放量变化趋势 @Override public List<Map<String, Object>> getTimeTrend(String city, String year) { SparkSession spark = SparkSession.builder().appName(“TimeTrendAnalysis”).getOrCreate(); Dataset df = spark.read().option(“header”, true).csv(“hdfs:///emission_data/*.csv”); Dataset cityData = df.filter(df.col(“city”).equalTo(city).and(df.col(“year”).equalTo(year))); Dataset monthly = cityData.withColumn(“month”, functions.date_format(functions.col(“date”), “yyyy-MM”)).groupBy(“month”).agg(functions.sum(“emission_volume”).alias(“total_monthly_emission”), functions.avg(“co_concentration”).alias(“avg_co_month”)); List rows = monthly.orderBy(“month”).collectAsList(); List<Map<String, Object>> trendList = new ArrayList<>(); for (Row row : rows) { Map<String, Object> point = new HashMap<>(); point.put(“month”, row.getString(0)); point.put(“totalEmission”, row.getDouble(1)); point.put(“avgCo”, row.getDouble(2)); trendList.add(point); } return trendList; }
// 功能3:区域差异分析 – 对比多个城市在指定时间段内的排放指标差异 @Override public Map<String, Map<String, Double>> getRegionDiff(List cities, String startDate, String endDate) { SparkSession spark = SparkSession.builder().appName(“RegionDiffAnalysis”).getOrCreate(); Dataset df = spark.read().option(“header”, true).csv(“hdfs:///emission_data/*.csv”); Dataset filtered = df.filter(df.col(“date”).geq(startDate).and(df.col(“date”).leq(endDate)).and(df.col(“city”).isin(cities.toArray(new String[0])))); Dataset grouped = filtered.groupBy(“city”).agg(functions.avg(“co_concentration”).alias(“avg_co”), functions.avg(“nox_concentration”).alias(“avg_nox”), functions.avg(“pm_concentration”).alias(“avg_pm”), functions.avg(“temperature”).alias(“avg_temp”), functions.avg(“humidity”).alias(“avg_humi”)); List rows = grouped.collectAsList(); Map<String, Map<String, Double>> regionMap = new HashMap<>(); for (Row row : rows) { Map<String, Double> metrics = new HashMap<>(); metrics.put(“avgCo”, row.getDouble(1)); metrics.put(“avgNox”, row.getDouble(2)); metrics.put(“avgPm”, row.getDouble(3)); metrics.put(“avgTemp”, row.getDouble(4)); metrics.put(“avgHumi”, row.getDouble(5)); regionMap.put(row.getString(0), metrics); } return regionMap; }
基于大数据的城市尾气排放数据可视化分析文档展示
xxx 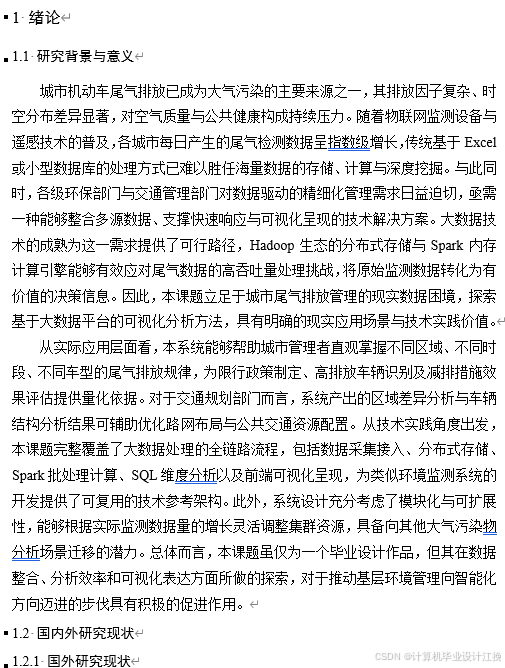
💖💖作者:计算机毕业设计江挽 💙💙个人简介:曾长期从事计算机专业培训教学,本人也热爱上课教学,语言擅长Java、微信小程序、Python、Golang、安卓Android等,开发项目包括大数据、深度学习、网站、小程序、安卓、算法。平常会做一些项目定制化开发、代码讲解、答辩教学、文档编写、也懂一些降重方面的技巧。平常喜欢分享一些自己开发中遇到的问题的解决办法,也喜欢交流技术,大家有技术代码这一块的问题可以问我! 💛💛想说的话:感谢大家的关注与支持! 💜💜 网站实战项目 安卓/小程序实战项目 大数据实战项目 深度学习实战项目