作者:代码简单说
大家好,我是代码简单说。小米开源了一个只有 0.8B 参数的 OCR 视觉模型 Xiaomi-OCR-0,别看它个头小,文档解析、表格还原、数学公式、手写字、看图问答全都在行。但它默认以 Ollama / HuggingFace 权重发布,普通 Windows 用户想跑起来,要装 Python、装 Ollama、拉模型、配环境变量,门槛不低。
我把整套环境打包成了一个开箱即用的 Windows 整合包:免安装、免配置、完全离线,解压后双击一个 bat 就能用,小白也能三步上手。本文给出下载地址、启动教程、功能清单和 API 调用示例,全文无套路,建议先收藏再看。
下载地址
整合包下载地址:https://share.wangpanso.cn/s/vsyhct
| 包名 | Xiaomi-OCR-0-win64-整合包.zip |
| 压缩包大小 | 约 3.1 GB(解压后约 4.2 GB) |
| 适用系统 | Windows 10 / 11 64 位 |
| 是否需要联网 | 下载后完全离线运行,数据不出电脑 |
一、Xiaomi-OCR-0 是什么
Xiaomi-OCR-0 是小米开源的轻量级全能文档理解模型,参数量仅 0.8B,底座为 Qwen3.5,单张 8GB 显存的消费级显卡就能跑,甚至纯 CPU 也能出结果(慢一些)。
它的能力覆盖一张图里几乎所有的"文字场景":
- 文档解析:整页内容转 Markdown,按阅读顺序输出;
- 表格还原:把图片里的表格还原成可编辑表格(OTSL 结构);
- 公式识别:数学公式直接转 LaTeX,论文截图秒变可复现公式;
- 手写识别:古籍、行书这类难啃的手写体也能认;
- 图像问答(VQA):直接问"这张单据的总金额是多少",它给答案;
- 字段提取(KIE):按"日期、商户、总额"这样的字段抓信息,直接出 JSON。
二、整合包里有什么
整合包 = 便携版 Python 3.12 + 便携版 Ollama + bf16 模型权重 + WebUI 服务,全部组件都在包内,不依赖系统里装没装 Python 或 Ollama,也不会污染系统环境。
Xiaomi-OCR-0/
├─ 启动小米OCR.bat ← 双击这一个就够了
├─ 使用说明.txt
├─ launcher.py ← 一键启动器
├─ watchdog.py ← 退出自动清理服务
├─ app\\demo\\ ← WebUI 与 HTTP API 服务
├─ runtime\\ ← 便携版 Python 3.12
├─ ollama\\ ← 便携版 Ollama
└─ models\\ ← 模型权重(已打好补丁,免下载)
几个贴心细节:
三、三步跑起来
第 1 步:解压。把 zip 解压到任意目录,路径建议不要太深、尽量不要带特殊字符。
第 2 步:双击「启动小米OCR.bat」。黑窗口会依次启动 Ollama 和 WebUI 服务,首次启动加载模型约需十几秒。
第 3 步:浏览器自动打开工作台,点击左侧画面选一张图或 PDF,选完自动开始识别,结果实时流式输出到右侧,可以直接复制或下载 Markdown。
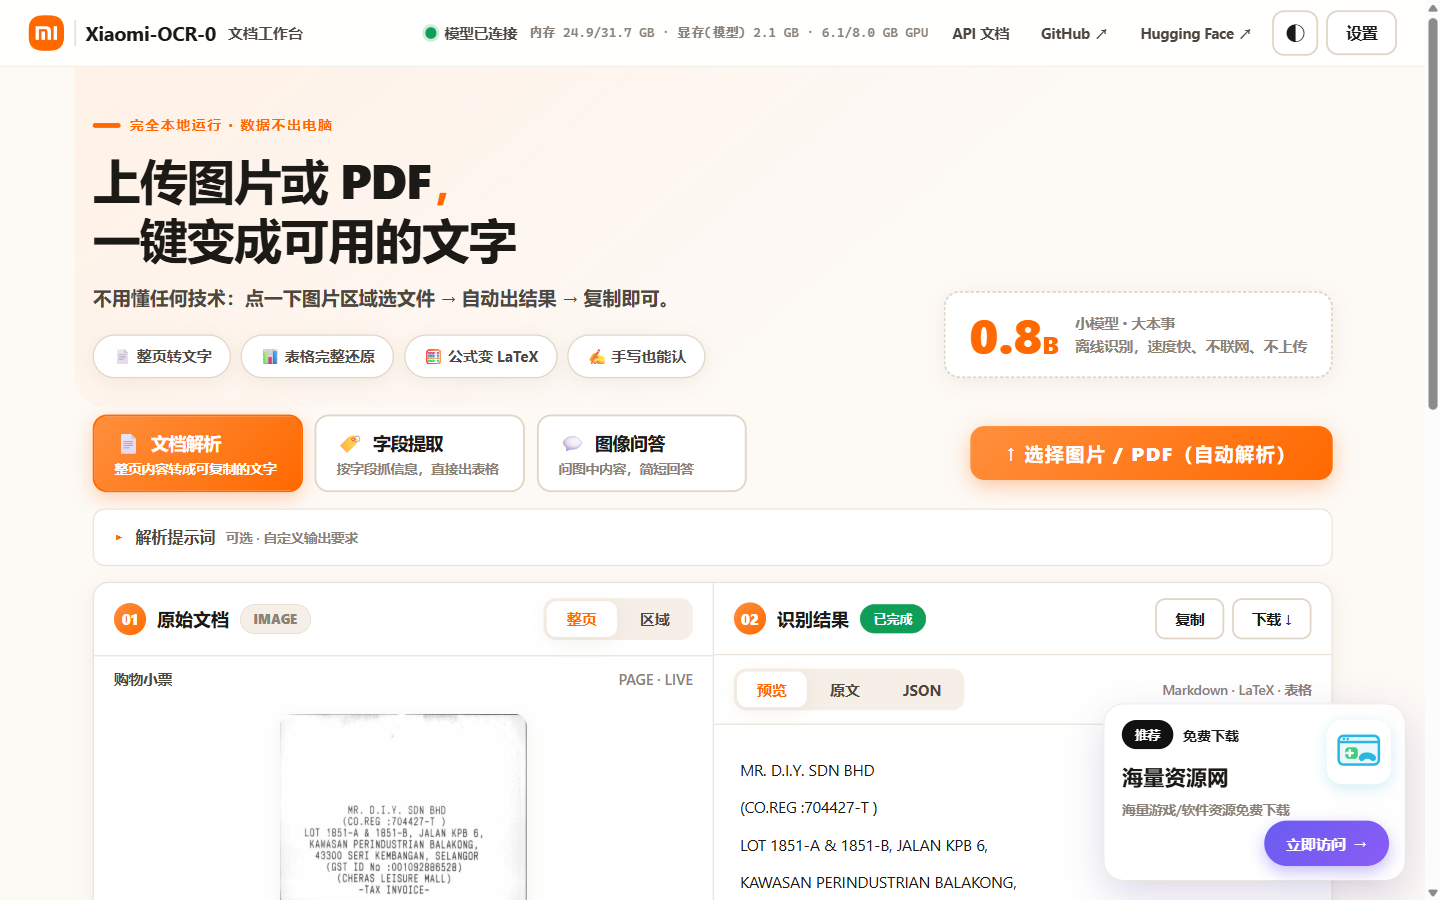
界面完全为小白设计:底部三个内置样例(购物小票、论文公式、行书千字文)点一下就换图重新解析;解析中右上方会出现红色「停止解析」按钮(按 Esc 也行),停止后已识别的部分内容会保留;顶栏实时显示内存与显存占用(低频刷新,不抢性能);解析提示词支持自定义,满足高级玩法。
四、识别效果实测
论文公式:截图里密密麻麻的多行推导,识别后直接是渲染好的 LaTeX,复制进 Typora / Word 公式编辑器就能用:

手写古籍:行书《千字文》竖排手写,也认得出来:
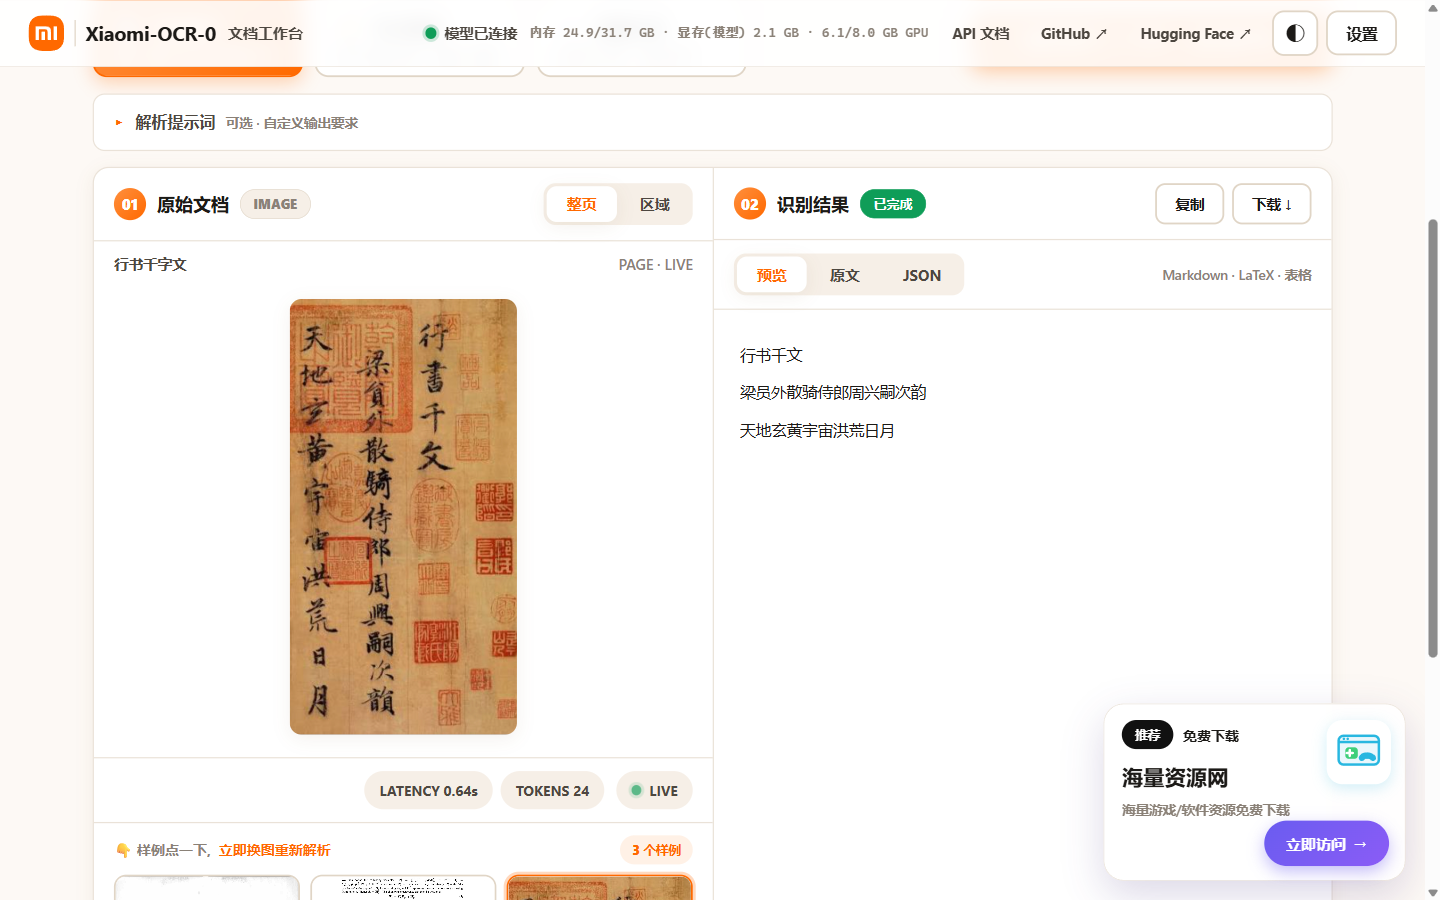
实测耗时参考(8GB 显卡):小票类图片 1-3 秒,密集公式页 15-20 秒,PDF 整本解析支持多页并发。除了图像,整合包还支持整本 PDF 解析:选一个 PDF 文件,它会逐页渲染并识别,自动拼成一份完整 Markdown,带进度条,中途可停止。
五、API 调用:把 OCR 接进你自己的程序
WebUI 不只是个页面,它同时是一个本地 HTTP API 服务(已开 CORS),浏览器访问 http://127.0.0.1:8787/docs 有完整中文文档页:

常用接口一眼看懂:POST /api/ocr(图像识别)、POST /api/ocr/stream(流式)、POST /api/book(PDF 整本)、GET /api/health(状态)。三个可直接复制的调用示例:
Windows PowerShell:
$b64 = [Convert]::ToBase64String([IO.File]::ReadAllBytes("demo.png"))
$r = Invoke-RestMethod http://127.0.0.1:8787/api/ocr –Method Post `
–ContentType "application/json" –Body ('{"image_base64":"' + $b64 + '","task":"document"}')
$r.content
Python(requests):
import base64, requests
img = base64.b64encode(open("demo.png", "rb").read()).decode()
r = requests.post("http://127.0.0.1:8787/api/ocr", json={
"image_base64": img,
"task": "document", # document / kie / vqa
})
print(r.json()["content"])
OpenAI SDK 兼容:整合包的 Ollama 暴露了 OpenAI 兼容接口,用 openai 库直接连 11434 端口就能当多模态模型用:
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:11434/v1", api_key="ollama")
resp = client.chat.completions.create(
model="longwayxu/xiaomi-ocr-0:bf16",
messages=[{"role": "user", "content": [
{"type": "text", "text": "提取这张图里的全部文字"},
{"type": "image_url", "image_url": {"url": "data:image/png;base64,<你的base64>"}},
]}],
)
print(resp.choices[0].message.content)
做 RAG 知识库、批量票据归档、自动化脚本,都可以直接拿这套接口当本地 OCR 引擎。
六、常见问题(FAQ)
1. 没有独立显卡能跑吗? 能。模型会自动回退到 CPU + 内存推理,速度慢一些(单张图十几秒到几十秒),功能完全一样。内存建议 16GB 起。
2. 双击 bat 后窗口一闪就没了? 多半是 11434-11438、8787-8792 端口全被占用,或杀毒软件拦截了。先关掉冲突程序、把包目录加入杀软白名单再试;窗口里会有中文提示。
3. 怎么彻底停止服务? 直接关闭 bat 窗口即可。即使窗口被强杀,看门狗也会在几秒内清掉全部子进程,不会留后台占显存。
4. 数据会上传吗? 不会。识别全部在本机完成,服务只绑定 127.0.0.1,不暴露到局域网,离线状态也能正常用。
5. 端口显示的不是 8787? 默认从 8787 起自动找空闲端口,实际地址以 bat 窗口里「已就绪」那行提示为准。
七、总结
- 小米开源的 Xiaomi-OCR-0(0.8B)以小博大:文档、表格、公式、手写、看图问答一体搞定;
- 本文的 Windows 整合包免配置、完全离线:解压 → 双击 bat → 自动开浏览器,三步用起来;
- WebUI 面向小白:样例点击换图、自动解析、可停止、显存内存可视;
- 同时内置本地 HTTP API(/docs 有中文文档),PowerShell / Python / OpenAI SDK 都能直接调;
- 下载地址: https://share.wangpanso.cn/s/vsyhct(失效可在评论区留言,我会补新链接)。
模型版权归小米开源项目所有,整合包只是帮你省去配环境的功夫。觉得有用的话,点个赞、收藏一下再走。用的过程中遇到任何问题,评论区见。