/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
一座适合高中生生活的城市,究竟应该具备什么条件?
学校资源丰富、治安良好、交通便利,还是家庭能够负担住房?这些条件并不总能同时满足。城市排名的难点,就在于如何把不同方面的信息放在一起比较,并解释:为什么这样排名,以及换一种偏好后,结论是否仍然成立。
本次围绕 HiMCM A 题,我们从指标构建、综合评价、模型修订和稳健决策四个层面展开,形成了一套可以逐步理解和复现的建模方案。
第一步:建立面向高中生成长的指标体系
评价城市之前,首先需要明确“适合高中生”的含义。
我们将城市成长环境划分为七个维度:教育、安全、健康、公园、气候、交通,以及成本与机会,共使用35项指标。
不同指标不能直接相加。例如,犯罪率越低越好,教育资源通常越多越好,而气温与降水并不是越高越好。因此,需要分别进行方向统一、量纲转换和气候目标区间处理。
学校、图书馆等资源还要换算为人口密度,避免大城市仅凭资源总量获得优势。对于缺失数据,则先检查覆盖情况,再决定是否允许有限插补。
公园资料覆盖不足的问题,也影响了比较范围。为此,我们分别建立了包含公园的81城七维主榜,以及不含公园的744城六维扩展榜。
第二步:先建立基准,再进行重大修订
综合评价没有必要一开始就使用复杂模型。我们保留了三个递进方案,方便比较每次修改带来的影响。
M0采用维度等权的线性评分,计算透明,便于作为基准。
M1采用熵权TOPSIS,根据数据的区分信息确定维度权重,再比较城市与正、负理想点的距离。
这次修订主要回应两个问题:数据差异大的维度,是否就应该更重要?一座城市的明显短板,能否被其他优势轻易抵消?
几何聚合提高了模型对薄弱维度的敏感程度,但仍然允许不同条件之间进行权衡。
在原始81城主榜中,Fremont排名第一,Irvine和Frisco分列第二、第三。这一推荐对应明确的样本和评价口径,不能直接扩展为对所有城市、所有家庭的统一判断。
第三步:把排名的不确定性算出来
得到一个总分,还不足以说明推荐可靠。
我们先通过权重扰动和留一维度分析,观察偏好变化或删除某个维度后,城市名次怎样改变。
随后,进一步增加四个决策模块:
缺失值与权重联合传播:同时改变缺失信息的补齐结果和维度权重,观察名次分布。
约束偏好接受度:在公开设定的合理权重范围内,统计城市获得第一名、前三名的频率。
最小最大遗憾:当无法确定家庭偏好时,寻找能够控制最坏选择损失的城市。
家庭条件约束选择:先筛选满足预算、健康或出行要求的城市,再在其中比较得分。
在新增的1500次联合情景中,Fremont进入前三的频率为97.13%。这一数值反映设定情景下的稳定程度,不是“它真实最适合所有学生”的概率。
家庭约束模型则给出了更直观的差异:安全与健康优先的示例情景选择Fremont,独立出行优先选择Arlington,租金上限情景选择Boise City。
这也说明,城市榜单更适合作为筛选工具,具体家庭仍需明确自己的需求。
第四步:让公式、结果和论文相互对应
论文写作不能停留在介绍算法。
指标为什么保留、缺失值怎样处理、模型为什么修改、修订后哪些城市升降,都需要与实际结果对应。我们还使用PCA、聚类和不同评价口径的比较,解释城市画像及结论分歧。
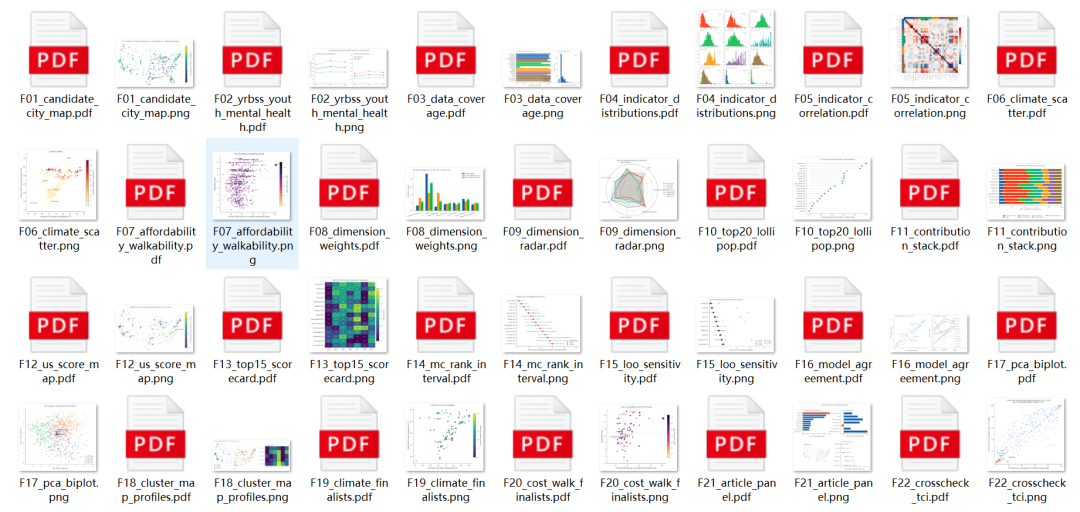
中英文论文均按章节组织,包含模型建立、求解结果、敏感性分析、模型评价与非技术新闻稿。英文版共24页,中文版共20页,便于结合公式、代码和结果图逐步学习。
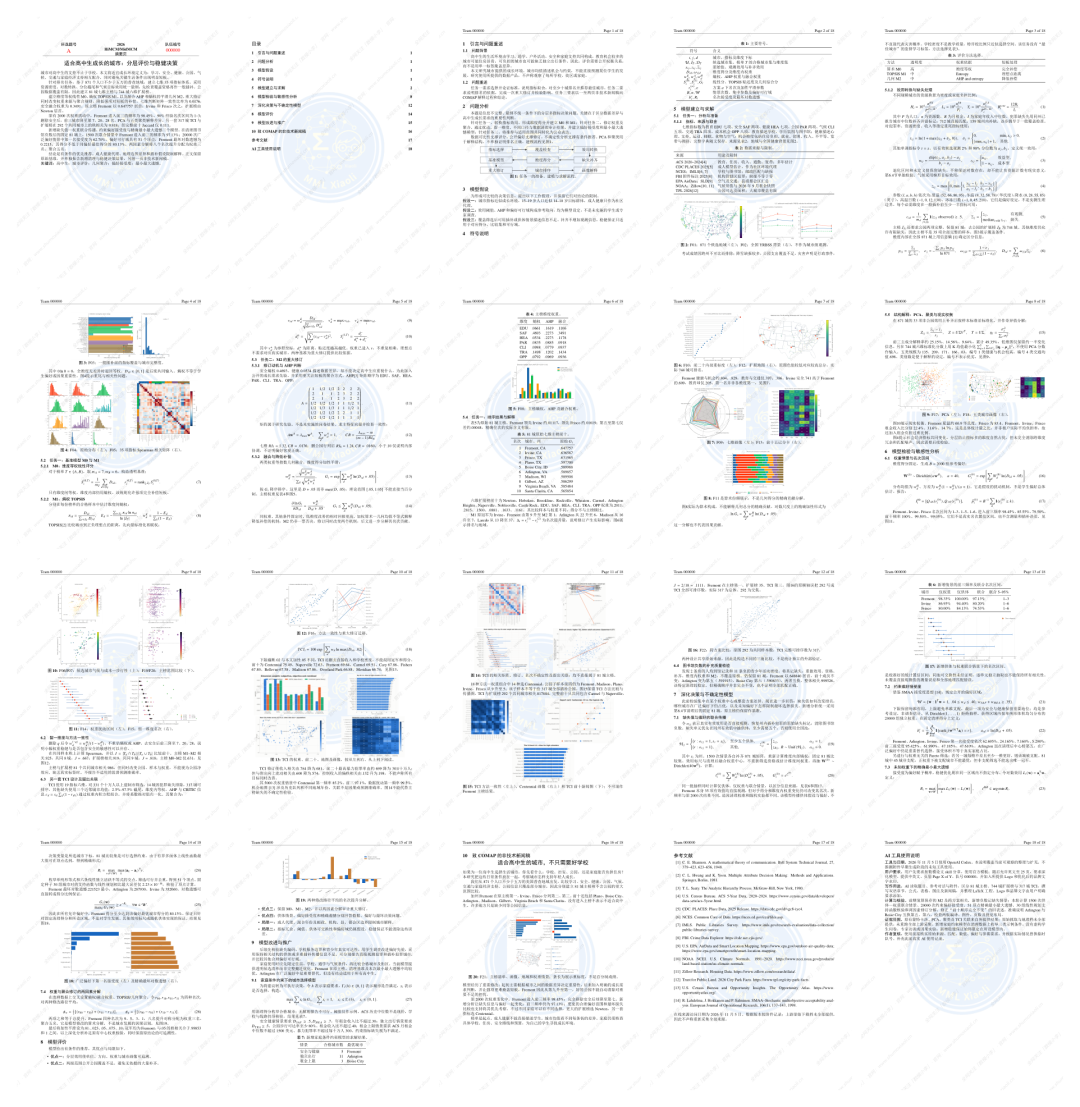
参考资料如何获取?
获取参考论文及配套资料,可访问数模小李官网。
中文版资料:仅提供中文版论文。
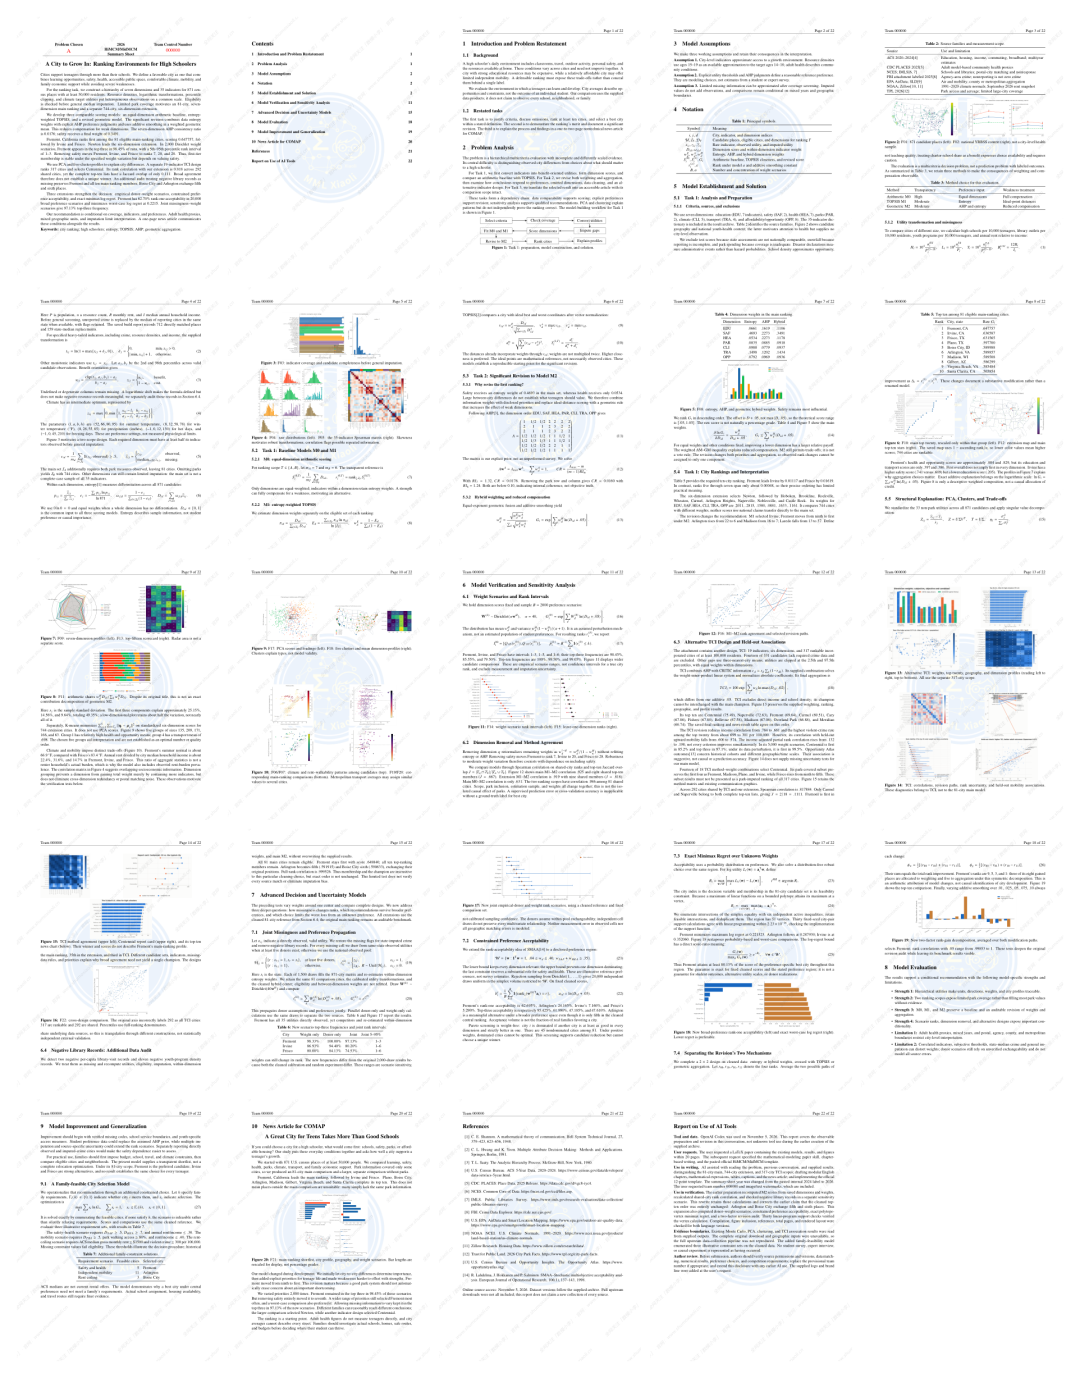
英文版资料:提供中英文双语论文、配套代码及高清结果图片。

全网关注「数模小李」,更多数学建模内容见官网:www.shumoxiaoli.cn。