/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
前述我们曾讨论过,现实生活中很多情况下的数据会出现像"钟形"一样的曲线,如,某地区男性的身高、体重,测量的误差等。假定我们在很多次测量绳子的长度,由于测量工具、测量技法的不同,总会有少量的误差。结合普遍性情况,从感受上我们认为测量结果应符合以下3个特征:
**(1)数据在均值附近比较集中。**用例子的情况来说,测量结果在绳子的真实长度附近会比较多。
**(2)在均值两边正负值相同时,对应的概率密度值也相同。**用例子的情况来说,测量结果发生正偏差、负偏差时,概率密度值相同,即
f
(
μ
+
ε
)
=
f
(
μ
−
ε
)
f(\\mu + \\varepsilon) = f(\\mu – \\varepsilon)
f(μ+ε)=f(μ−ε),其中,
μ
\\mu
μ为绳子的真实长度,
+
ε
+ \\varepsilon
+ε为正偏差,
−
ε
– \\varepsilon
−ε为负偏差。
**(3)离均值越远则概率密度越小。**用例子的情况来说,测量误差越大,概率密度就越小,也就是说出现这样的数据的可能性越小(概率越小)。要想打好概率统计基础,大家可以参见清华大学出版社的《人人可懂的概率统计》。
1 正态分布的表达
经过前人专家们的研究,提出了正态分布。早期贡献最大的专家为高斯,故正态分布又称为高斯分布。符合上述三种感受的正态分布公式如下:
f
(
x
)
=
1
2
π
σ
e
−
(
x
−
μ
)
2
2
σ
2
f(x) = \\frac{1}{\\sqrt{2\\pi}\\sigma}e^{- \\frac{(x – \\mu)^{2}}{2\\sigma^{2}}}
f(x)=2π
σ1e−2σ2(x−μ)2
为看起来舒服一点(不至于字体太小而看不清),通常把指数函数用
e
x
p
(
)
exp()
exp()来表达,则该公式如下:
f
(
x
)
=
1
2
π
σ
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
f(x) = \\frac{1}{\\sqrt{2\\pi}\\sigma}exp\\left( – \\frac{(x – \\mu)^{2}}{2\\sigma^{2}} \\right)
f(x)=2π
σ1exp(−2σ2(x−μ)2)
初学者看到这个公式估计脑袋是懵的。如果不是特别纠结,学会用就可以了。后续我会详细讲解这个公式的由来。由于推导公式需要有较好的微积分知识基础,建议您选读。下面就来学习正态分布的性质、对应的概率分布函数,以及怎么应用。
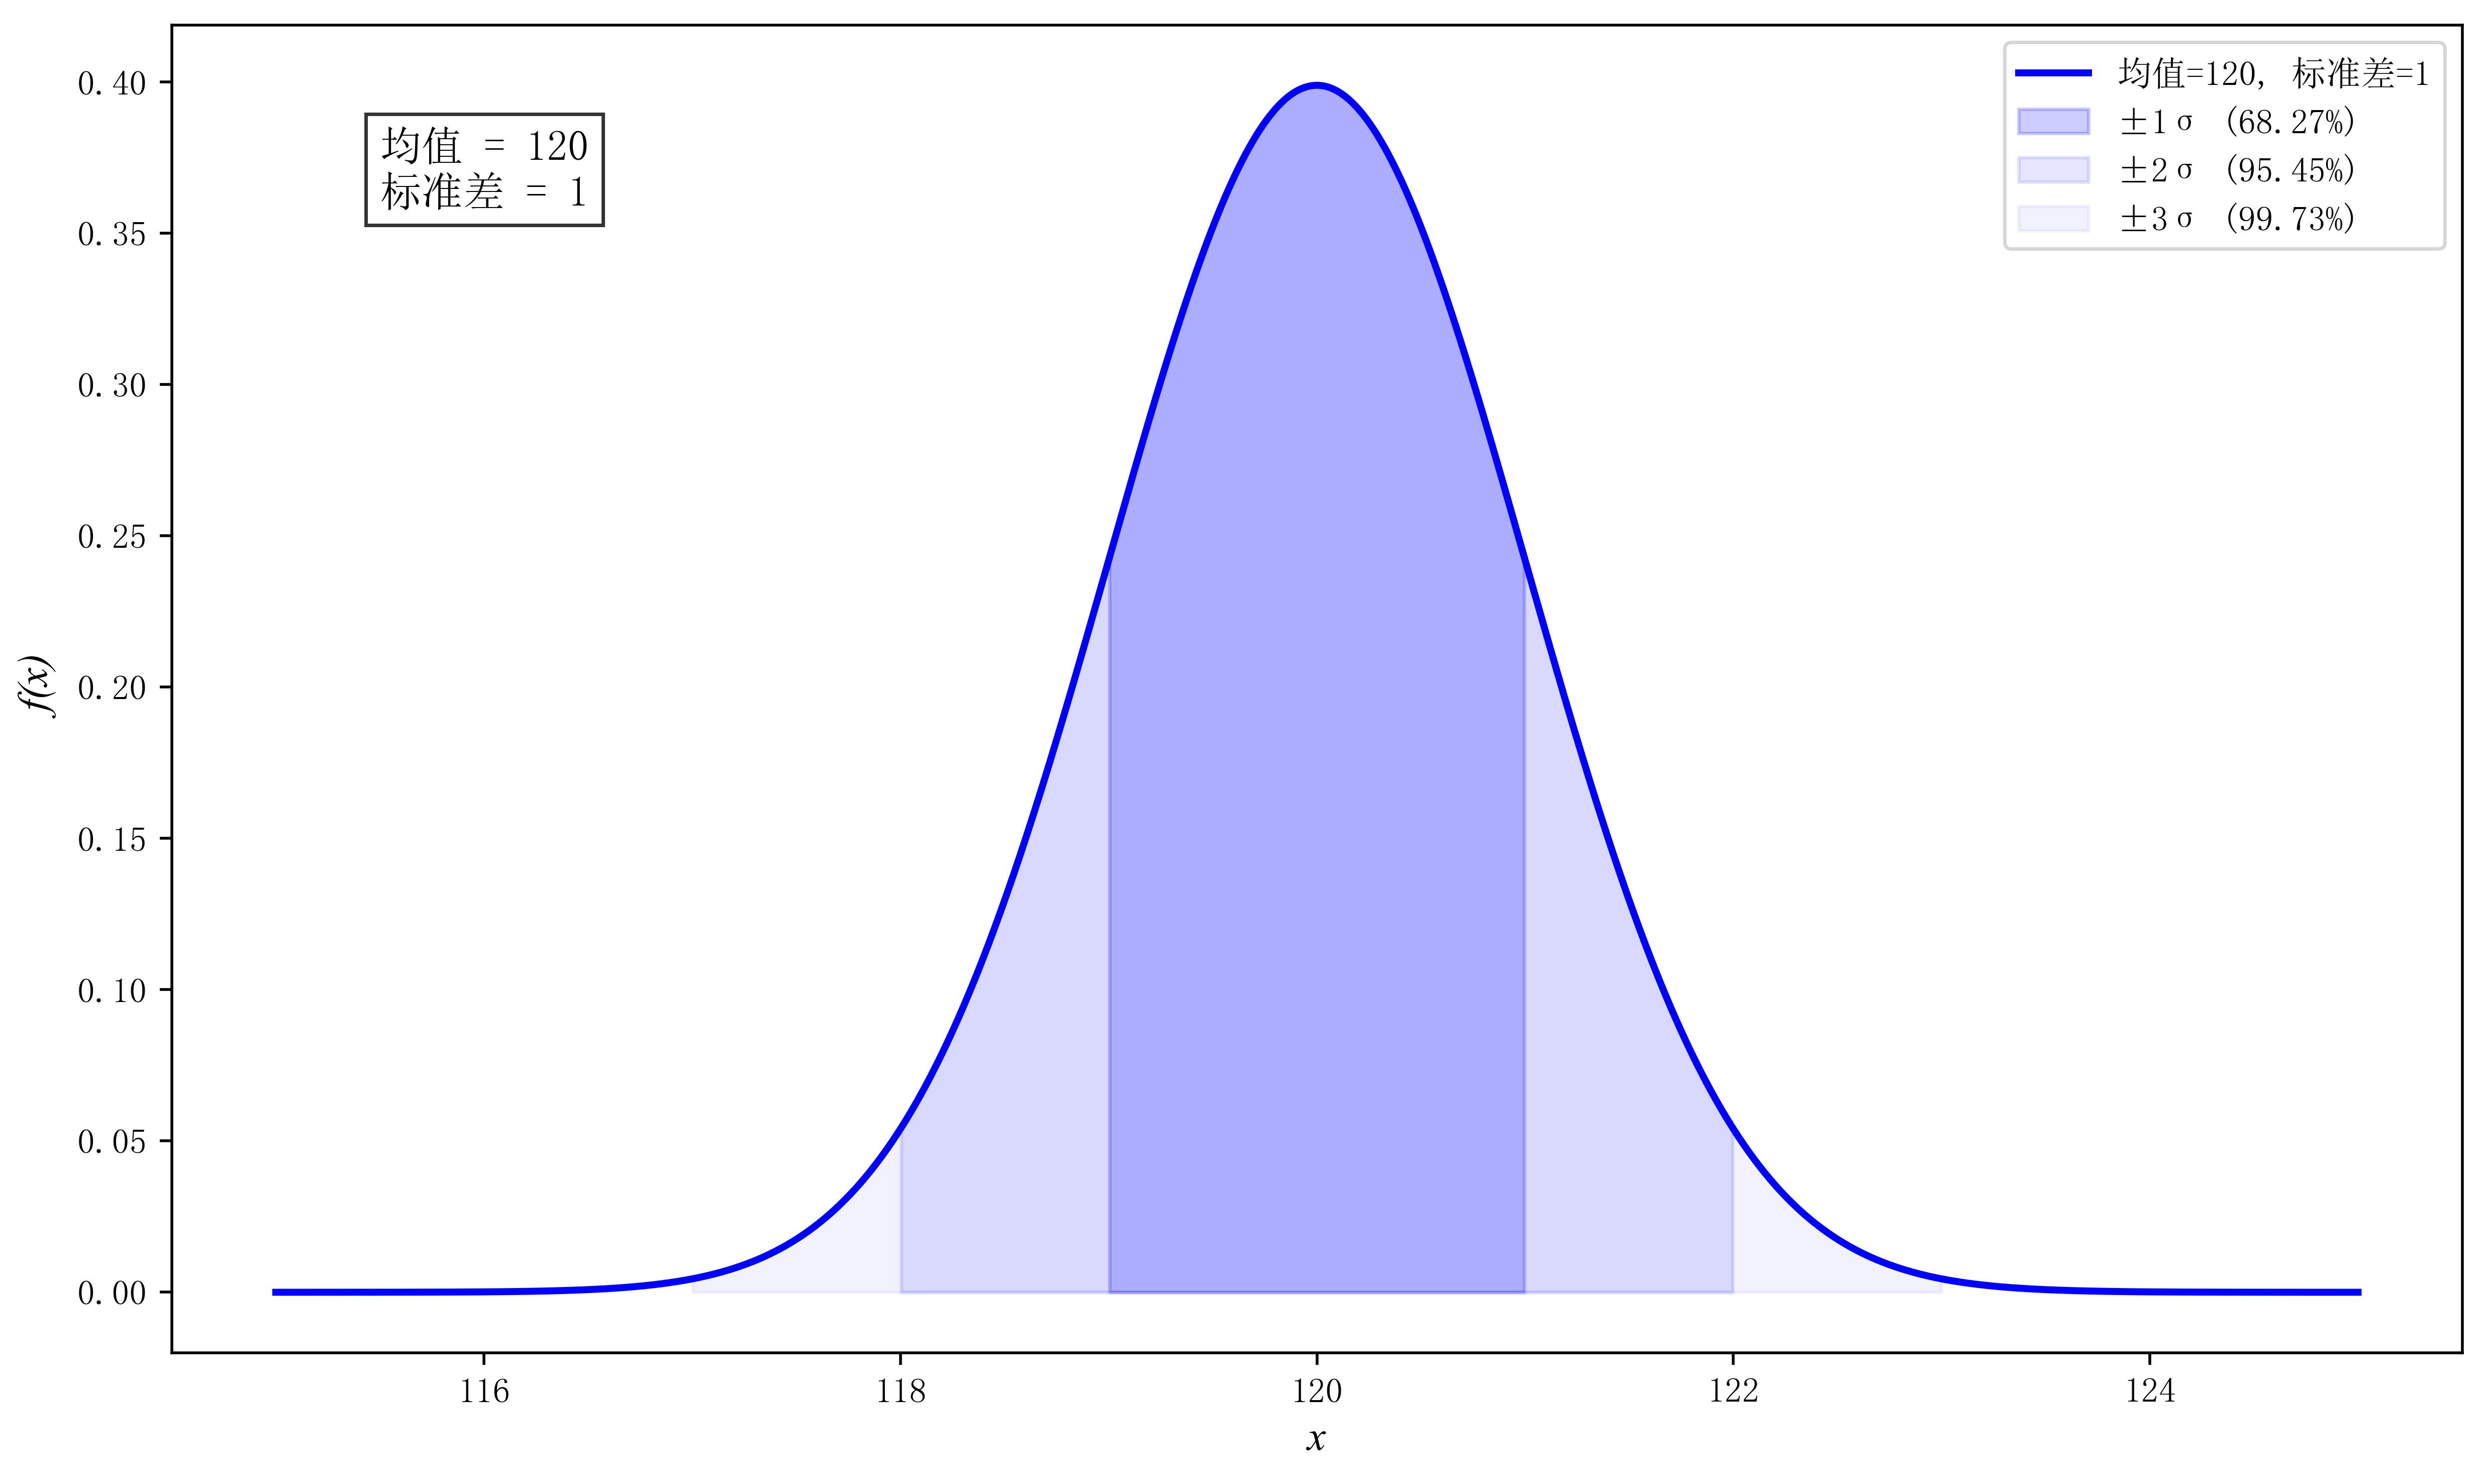
图1 正态分布的概率密度函数图形
如图1所示,这是对一条长为120cm的绳子做了很多次测量后的测量数据。可以明显的发现测量结果符合前述讲的3个特征。
在正态分布的概率密度函数中,
μ
\\mu
μ是指的数据均值,在测量的例子中,
μ
\\mu
μ是指的绳子的实际长度。
σ
\\sigma
σ是指的标准差,
σ
2
\\sigma^{2}
σ2是指的方差,两者的计算公式及联系如下:
σ
=
1
n
∑
i
=
1
n
(
x
i
−
μ
)
2
,
σ
2
=
1
n
∑
i
=
1
n
(
x
i
−
μ
)
2
,
σ
=
σ
2
\\sigma = \\sqrt{\\frac{1}{n}\\sum_{i = 1}^{n}\\left( x_{i} – \\mu \\right)^{2}},\\ \\sigma^{2} = \\frac{1}{n}\\sum_{i = 1}^{n}\\left( x_{i} – \\mu \\right)^{2},\\ \\sigma = \\sqrt{\\sigma^{2}}
σ=n1i=1∑n(xi−μ)2
, σ2=n1i=1∑n(xi−μ)2, σ=σ2
可见,两者都可以用于衡量数据集偏离平均值的程度,值越大,表明偏离越大,也就是说离散程度越大,数据波动越明显。
正态分布(高斯分布)的英文为Normal Distribution(Gaussian Distribution),习惯上结合英文首字母和重要的参数,将正态分布记为
N
(
μ
,
σ
2
)
N\\left( \\mu,\\sigma^{2} \\right)
N(μ,σ2)。要想打好概率统计基础,大家可以参见清华大学出版社的《人人可懂的概率统计》。
2 正态分布的特征和性质
正态分布的概率密度函数形状如"钟形",并具有以下重要的图形特征和性质:
(1)函数关于直线
x
=
μ
x = \\mu
x=μ对称。
(2)当
x
<
μ
x < \\mu
x<μ时,函数单调递增;当
x
>
μ
x > \\mu
x>μ时,函数单调递减;当
x
=
μ
x = \\mu
x=μ时,函数得到最大值。
(3)函数当
x
=
μ
+
σ
或
x
=
μ
−
σ
x = \\mu + \\sigma 或x = \\mu – \\sigma
x=μ+σ或x=μ−σ时为拐点。
(4)函数以
f
(
x
)
=
0
f(x) = 0
f(x)=0为水平渐近线。
(5)
σ
\\sigma
σ越大,表明数据离散程度越大,图形更为平缓(矮胖);
σ
\\sigma
σ越小,表明数据离散程度越小,图形更为陡峭(高瘦)。要想打好概率统计基础,大家可以参见清华大学出版社的《人人可懂的概率统计》。
3 最大值和拐点
◎以下内容选读
接下来我们来求概率密度函数的一阶和二阶导数,一并说明:为什么当
x
=
μ
x = \\mu
x=μ时,函数得到最大值;为什么当
x
=
μ
+
σ
或
x
=
μ
−
σ
x = \\mu + \\sigma 或x = \\mu – \\sigma
x=μ+σ或x=μ−σ时为拐点。
f
′
(
x
)
=
[
1
2
π
σ
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
]
′
=
1
2
π
σ
[
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
]
(
−
(
x
−
μ
)
2
2
σ
2
)
′
=
−
1
2
π
σ
2
σ
2
[
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
]
[
2
(
x
−
μ
)
]
=
−
x
−
μ
2
π
σ
3
e
x
p
(
−
(
x
−
μ
)
2
2
σ
2
)
=
−
x
−
μ
σ
2
f
(
x
)
f'(x) = \\left\\lbrack \\frac{1}{\\sqrt{2\\pi}\\sigma}exp\\left( – \\frac{(x – \\mu)^{2}}{2\\sigma^{2}} \\right) \\right\\rbrack' = \\frac{1}{\\sqrt{2\\pi}\\sigma}\\left\\lbrack exp\\left( – \\frac{(x – \\mu)^{2}}{2\\sigma^{2}} \\right) \\right\\rbrack\\left( – \\frac{(x – \\mu)^{2}}{2\\sigma^{2}} \\right)' = – \\frac{1}{\\sqrt{2\\pi}\\sigma 2\\sigma^{2}}\\left\\lbrack exp\\left( – \\frac{(x – \\mu)^{2}}{2\\sigma^{2}} \\right) \\right\\rbrack\\left\\lbrack 2(x – \\mu) \\right\\rbrack = – \\frac{x – \\mu}{\\sqrt{2\\pi}\\sigma^{3}}exp\\left( – \\frac{(x – \\mu)^{2}}{2\\sigma^{2}} \\right) = – \\frac{x – \\mu}{\\sigma^{2}}f(x)
f′(x)=[2π
σ1exp(−2σ2(x−μ)2)]′=2π
σ1[exp(−2σ2(x−μ)2)](−2σ2(x−μ)2)′=−2π
σ2σ21[exp(−2σ2(x−μ)2)][2(x−μ)]=−2π
σ3x−μexp(−2σ2(x−μ)2)=−σ2x−μf(x)
如果
f
′
(
x
)
=
0
f'(x) = 0
f′(x)=0,求得此时的点,才能找到极值点。显然,当
x
=
μ
x = \\mu
x=μ时为极值点,从图4-11也可明显看出来。
f
′
′
(
x
)
=
[
−
x
−
μ
σ
2
f
(
x
)
]
′
=
(
−
x
−
μ
σ
2
)
′
f
(
x
)
+
(
−
x
−
μ
σ
2
)
f
′
(
x
)
=
−
1
σ
2
f
(
x
)
+
(
x
−
μ
)
2
σ
4
f
(
x
)
=
(
x
−
μ
)
2
−
σ
2
σ
4
f
(
x
)
f^{''}(x) = \\left\\lbrack – \\frac{x – \\mu}{\\sigma^{2}}f(x) \\right\\rbrack' = \\left( – \\frac{x – \\mu}{\\sigma^{2}} \\right)'f(x) + \\left( – \\frac{x – \\mu}{\\sigma^{2}} \\right)f'(x) = – \\frac{1}{\\sigma^{2}}f(x) + \\frac{(x – \\mu)^{2}}{\\sigma^{4}}f(x) = \\frac{(x – \\mu)^{2} – \\sigma^{2}}{\\sigma^{4}}f(x)
f′′(x)=[−σ2x−μf(x)]′=(−σ2x−μ)′f(x)+(−σ2x−μ)f′(x)=−σ21f(x)+σ4(x−μ)2f(x)=σ4(x−μ)2−σ2f(x)
f
′
′
(
x
)
=
0
⟹
(
x
−
μ
)
2
−
σ
2
σ
4
f
(
x
)
=
0
⟹
(
x
−
μ
)
2
−
σ
2
σ
4
=
0
⟹
(
x
−
μ
)
2
=
σ
2
⟹
±
(
x
−
μ
)
=
σ
⟹
x
=
μ
+
σ
或
x
=
μ
−
σ
f^{''}(x) = 0 \\Longrightarrow \\frac{(x – \\mu)^{2} – \\sigma^{2}}{\\sigma^{4}}f(x) = 0 \\Longrightarrow \\frac{(x – \\mu)^{2} – \\sigma^{2}}{\\sigma^{4}} = 0 \\Longrightarrow (x – \\mu)^{2} = \\sigma^{2} \\Longrightarrow \\pm (x – \\mu) = \\sigma \\Longrightarrow x = \\mu + \\sigma 或x = \\mu – \\sigma
f′′(x)=0⟹σ4(x−μ)2−σ2f(x)=0⟹σ4(x−μ)2−σ2=0⟹(x−μ)2=σ2⟹±(x−μ)=σ⟹x=μ+σ或x=μ−σ
可见,
x
=
μ
+
σ
或
x
=
μ
−
σ
x = \\mu + \\sigma 或x = \\mu – \\sigma
x=μ+σ或x=μ−σ时为拐点。
◎选读内容结束
既然正态分布的概率密度函数关于直线
x
=
μ
x = \\mu
x=μ对称,那我们可以得出以下性质:
f
(
μ
+
a
)
=
f
(
μ
−
a
)
f(\\mu + a) = f(\\mu – a)
f(μ+a)=f(μ−a)
4 概率分布函数
我们再来看看正态分布的概率分布函数是什么样子。根据
F
(
x
)
=
P
{
X
≤
x
}
F(x) = P\\left\\{ X \\leq x \\right\\}
F(x)=P{X≤x}来推导:
F
(
x
)
=
P
{
X
≤
x
}
=
∫
−
∞
x
1
2
π
σ
e
x
p
(
−
(
t
−
μ
)
2
2
σ
2
)
d
t
F(x) = P\\left\\{ X \\leq x \\right\\} = \\int_{- \\infty}^{x}{\\frac{1}{\\sqrt{2\\pi}\\sigma}exp\\left( – \\frac{(t – \\mu)^{2}}{2\\sigma^{2}} \\right)dt}
F(x)=P{X≤x}=∫−∞x2π
σ1exp(−2σ2(t−μ)2)dt
这个定积分计算起来由于过于复杂,且计算结果不能用初等函数来表达,故不再展开描述。通过观察图1,因概率分布函数计算的是累加概率,故可得知:
(1)
F
(
x
)
\\mathbf{F}\\left( \\mathbf{x} \\right)
F(x)**的图形大致呈s形。**即:根据
x
x
x的值以
−
∞
– \\infty
−∞开始,从左到右来看,
F
(
x
)
F(x)
F(x)的增长速度越来越快;当增长到
x
=
μ
x = \\mu
x=μ时,
F
(
x
)
=
0.5
F(x) = 0.5
F(x)=0.5(因为
f
(
x
)
f(x)
f(x)左右对称);当
x
x
x的值继续增长时,
F
(
x
)
F(x)
F(x)的增长速度越来越慢。
(2)
F
(
x
)
\\mathbf{F}\\left( \\mathbf{x} \\right)
F(x)**在3倍标准差时的情况。**结合图1来观察。概率分布函数的值是对密度函数做积分运算得来的。如图中的灰色部分面积所示,在
(
μ
−
σ
,
μ
+
σ
)
(\\mu – \\sigma,\\mu + \\sigma)
(μ−σ,μ+σ)范围内,面积为0.6827,用应用场景示例的语境来说,就是测量结果有68.27%的可能性落在
(
μ
−
σ
,
μ
+
σ
)
(\\mu – \\sigma,\\mu + \\sigma)
(μ−σ,μ+σ)范围;同理,在
(
μ
−
2
σ
,
μ
+
2
σ
)
(\\mu – 2\\sigma,\\mu + 2\\sigma)
(μ−2σ,μ+2σ)范围内,面积为0.9545;在
(
μ
−
3
σ
,
μ
+
3
σ
)
(\\mu – 3\\sigma,\\mu + 3\\sigma)
(μ−3σ,μ+3σ)范围内,面积为0.9973。可见,测量结果落到
(
−
∞
,
μ
−
3
σ
)
( – \\infty,\\mu – 3\\sigma)
(−∞,μ−3σ)、
(
μ
+
3
σ
,
+
∞
)
(\\mu + 3\\sigma, + \\infty)
(μ+3σ,+∞)的可能性非常小。
(3)存在函数值关系:
F
(
μ
−
a
)
=
1
−
F
(
μ
+
a
)
F(\\mu – a) = 1 – F(\\mu + a)
F(μ−a)=1−F(μ+a)。结合图1可以看出这种关系。 要想打好概率统计基础,大家可以参见清华大学出版社的《人人可懂的概率统计》。学习有困难吗?欢迎给我留言讨论,提出问题。