/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
文章目录
- 1. 写在前面
- 2. LeetCode 560. 和为 K 的子数组
- 3. LeetCode 525. 连续数组
- 4. LeetCode 724. 寻找数组的中心下标
- 5. LeetCode 304. 二维区域和检索 – 矩阵不可变
1. 写在前面
这次我们将会先从一道看上去是滑动窗口能解决的题入手,发现哪些问题滑动窗口不能解决的同时介绍今天我们要讲解的前缀和方法。
2. LeetCode 560. 和为 K 的子数组
题目描述:给定一个整数数组和一个整数 k ,请找到该数组中和为 k 的连续子数组的个数。
注意:
-
1
1
1 <= nums.length <=2
∗
10
4
2*10^4
2∗104。 -
−
1000
-1000
−1000 <= nums[i] <=1000
1000
1000。 -
−
10
7
-10^7
−107 <= k <=10
7
10^7
107
示例 1: 输入:nums = [1,1,1], k = 2 输出: 2 解释: 此题 [1,1] 与 [1,1] 为两种不同的情况
示例 2: 输入:nums = [1,2,3], k = 3 输出: 2
这道题似乎和我们上次说的滑动窗口的题很像,但是这里不能使用滑动窗口。 为什么呢?因为以前我们数组里的数都是正整数。 所以扩大窗口,sum 一定增加;缩小窗口,sum 一定减少。因此我们可以通过 sum 判断应该移动哪个指针。但这道题不一样。 例如:nums = [1, -1, 2],k = 2。 那么我们会发现扩大窗口反而可能让 sum 变小,因为数组允许负数。 因此,我们无法像之前那样根据 sum 大小,可靠地决定移动哪个指针。 因此我们需要一种新的方法——前缀和。
前缀和理解起来也很简单。 例如:nums = [1, 2, 3, 4]。 我们从左往右累加就可以得到[1, 3, 6, 10],这就是前缀和数组。 现在假设我们想知道 [2, 3, 4] 的和是多少?我们可以利用前缀和前四个数的前缀和减去第一个数的前缀和那就是 2, 3, 4 三个数的和,所以是
10
−
1
=
9
10-1=9
10−1=9。 也就是说,一段连续区间的和可以通过两个前缀和相减得到。 所以前缀和的核心公式如下: 假设 prefix[j] 表示从数组开头到 j 的前缀和。 prefix[i] 表示从数组开头到 i 的前缀和。 那么: 区间和 = prefix[j] – prefix[i]。 因此我们现在就是要求区间和等于 k,因此就是: k = prefix[j] – prefix[i]。 我们现在再进行移项:prefix[i] = prefix[j] – k。 因为我们的数组里可能有负数,所以对于每一项前项和 prefix[j],我们要尝试找到所有对应满足的 prefix[i],而不是只找到一个就行。
因此这里引入了第二个点,我们如果每次遍历的时候都将之前的前缀和都遍历一遍,就又会产生 O(n²) 的复杂度(因为暴力算法也是 O(n²) 的复杂度)。 因此我们可以使用 HashMap 这样的字典来解决这个问题。HashMap 帮我们记录之前出现过哪些前缀和,以及它们出现了多少次。
例如我们现在的示例 1:nums = [1,1,1], k = 2。 这里我们在初始化 HashMap 的时候记得放入 (0,1),换句话说那就是前缀和 0 天生就是 1 次,因为空的时候就是前缀和 0,否则当数组里的前缀和等于 k 的时候,无法成功计算这一次。 所以我们现在开始: 第一次:遍历数字 1,当前 sum = 1,需要寻找 sum – k = -1。之前没有出现过 -1。所以结果不增加。记录当前前缀和 map = {0:1, 1:1}。 第二次:遍历数字 1,当前 sum = 2,需要寻找 sum – k = 0。发现之前前缀和 0 出现过一次。说明找到了一个符合条件的子数组 [1, 1]。所以现在结果增加 1。记录当前前缀和 2,因此 map = {0:1, 1:1, 2:1}。 第三次:遍历数字 1,当前 sum = 3,需要寻找 sum – k = 1。发现之前前缀和 1 出现过一次。又找到一个符合条件的子数组 [1, 1]。所以现在结果增加 1,因此最后的结果就是 2。
把我们刚才的逻辑写成代码就如下所示。
class Solution {
public int subarraySum(int[] nums, int k) {
// 1. 创建 HashMap
// Key:前缀和
// Value:前缀和出现的次数
HashMap<Integer, Integer> map = new HashMap<>();
// 2. 初始化前缀和为0,出现1次
map.put(0, 1);
int sum = 0;
int result = 0;
// 3. 遍历数组
for (int num : nums) {
// 计算当前前缀和
sum += num;
// 查找之前是否存在 sum – k
result += map.getOrDefault(sum – k, 0);
// 记录当前前缀和出现的次数
map.put(sum, map.getOrDefault(sum, 0) + 1);
}
return result;
}
}
这里用到的依然是我们上次说到的 getOrDefault() 方法。如果 HashMap 中存在我们要找的前缀和,则返回对应的 value,否则返回 0,也就是不修改 result。后面更新也是 HashMap 也是用的这个方法,比较方便,希望大家学会。
那么我们现在看一下这个算法的时间复杂度。 我们只需遍历一遍数组就好,因此时间复杂度是 O(n),这是我们用空间复杂度 O(n) 换来的,所以也是我们前面所说的空间换时间的又一体现。我们使用 HashMap 保存历史前缀和,避免重复遍历之前的数据。
而暴力枚举算法的时间复杂度还是 O(n²) 。
public int subarraySum(int[] nums, int k) {
int result = 0;
for (int i = 0; i < nums.length; i++) {
int sum = 0;
for (int j = i; j < nums.length; j++) {
sum += nums[j];
if (sum == k) {
result++;
}
}
}
return result;
}
3. LeetCode 525. 连续数组
题目描述:给定一个二进制数组 nums , 找到含有相同数量的 0 和 1 的最长连续子数组,并返回该子数组的长度。
注意:
-
1
1
1 <= nums.length <=10
5
10^5
105。 - nums[i] 不是
0
0
0 就是1
1
1。
示例 1: 输入: nums = [0,1] 输出: 2 解释: [0, 1] 是具有相同数量 0 和 1 的最长连续子数组。
示例 2: 输入: nums = [0,1,0] 输出: 2 解释: [0, 1] (或 [1, 0]) 是具有相同数量 0 和 1 的最长连续子数组。
这道题如果使用前缀和就会非常简单。 题目希望我们找到 0 和 1 数量相等的连续子数组。我们这一步可以先做一个预处理,把 0 全部替换为 -1。那么我们现在就是寻找 -1 和 1 数量相等的连续子数组,也就是我们寻找连续子数组,让其的和等于 0。 如果和等于 0,就说明 0 和 1 的数量相等。 这便是这道题的主要思路。
当然我们也没必要真的将 0 改为 -1.我们可以在遇到 0 的时候直接 sum – 1 就好,而不是 + 0。 因此我们还是使用前缀和与 HashMap。这道题和上一题还有个区别在于我们不需要统计有多少个符合条件的子数组,而是需要找到最长的子数组。 所以这次 HashMap 不需要记录次数,而是记录该前缀和第一次出现的下标。 那为什么是第一次呢? 假设我们的某个前缀和第一次出现在下标 1,第一次出现在下标 3。那么中间这段连续子数组的和一定为 0。我们需要获得最长的连续子数组,所以我们记录第一次获得的子数组更长。
完整的代码如下所示。
class Solution {
public int findMaxLength(int[] nums) {
// 1. 创建 HashMap
// Key:前缀和
// Value:前缀和第一次出现的下标
HashMap<Integer, Integer> map = new HashMap<>();
// 2. 初始化
map.put(0, –1);
int sum = 0;
int result = 0;
// 3. 遍历数组
for (int i = 0; i < nums.length; i++) {
// 4. 将0转换成-1,1保持不变
if (nums[i] == 0) {
sum -= 1;
} else {
sum += 1;
}
// 5. 如果之前出现过相同的前缀和
if (map.containsKey(sum)) {
// 计算当前连续子数组长度
int length = i – map.get(sum);
result = Math.max(result, length);
} else {
// 只记录第一次出现的位置
map.put(sum, i);
}
}
return result;
}
}
这里我们初始化的时候将数组初始的前缀和 0 的位置定义为下标 -1 处。 这样就能方便我们处理从数组第一个元素开始的子数组。 例如示例 2:nums = [0, 1, 0]。 第一步:index = 0,第一个数是 0,所以前缀和现在是 -1,HashMap 里没有 -1,因此 result 还是 0。 第二步:index = 1,第二个数是 1,所以前缀和现在是 0,HashMap 里的 0 就是我们之前存进去的那个,我们直接用这里的 index 减去找到的 index 直接得到长度 2。这样操作就很方便。 第三步:index = 2,第三个数是 0,所以前缀和现在是 -1,HashMap 里的 -1 的 index 是 0,这里得到的长度也是 2。所以最终的结果就是 2。
这道题这么做很方便,时间复杂度是 O(n) 。
4. LeetCode 724. 寻找数组的中心下标
题目描述:给你一个整数数组 nums ,请计算数组的中心下标 。 数组中心下标是数组的一个下标,其左侧所有元素相加的和等于右侧所有元素相加的和。 如果中心下标位于数组最左端,那么左侧数之和视为 0 ,因为在下标的左侧不存在元素。这一点对于中心下标位于数组最右端同样适用。 如果数组有多个中心下标,应该返回最靠近左边 的那一个。如果数组不存在中心下标,返回 -1 。
注意:
-
1
1
1 <= nums.length <=10
4
10^4
104。 -
−
1000
-1000
−1000 <= nums[i] <=1000
1000
1000。
示例 1: 输入: nums = [1,7,3,6,5,6] 输出:3 解释: 中心下标是 3 。 左侧数之和 sum = nums[0] + nums[1] + nums[2] = 1 + 7 + 3 = 11 , 右侧数之和 sum = nums[4] + nums[5] = 5 + 6 = 11 ,二者相等。
示例 2: 输入: nums = [1, 2, 3] 输出:-1 解释: 数组中不存在满足此条件的中心下标。
示例 3: nums = [2, 1, -1] 输出:0 解释: 中心下标是 0 。 左侧数之和 sum = 0 ,(下标 0 左侧不存在元素), 右侧数之和 sum = nums[1] + nums[2] = 1 + -1 = 0 。
这道题用暴力枚举也很方便,但是时间复杂度是 O(n²),我们希望用前缀和优化到 O(n)。 我们可以发现:如果知道数组总和,以及当前下标左边的和,就可以直接算出右边的和。 即:
r
i
g
h
t
S
u
m
=
t
o
t
a
l
S
u
m
−
l
e
f
t
S
u
m
−
n
u
m
s
[
i
]
rightSum=totalSum-leftSum-nums[i]
rightSum=totalSum−leftSum−nums[i] 这里
t
o
t
a
l
S
u
m
totalSum
totalSum:整个数组的总和。
l
e
f
t
S
u
m
leftSum
leftSum:当前下标左边的总和。
n
u
m
s
[
i
]
nums[i]
nums[i]:当前元素。 这里要减去
n
u
m
s
[
i
]
nums[i]
nums[i]是因为当前元素既不属于左边,也不属于右边。 所以我们可以先计算整个数组的总和,然后只需要遍历一次数组。
class Solution {
public int pivotIndex(int[] nums) {
// 1. 计算整个数组的总和
int totalSum = 0;
for (int num : nums) {
totalSum += num;
}
// 2. 初始化左边总和
int leftSum = 0;
// 3. 遍历数组
for (int i = 0; i < nums.length; i++) {
// 计算右边的和
int rightSum = totalSum – leftSum – nums[i];
// 判断左右两边是否相等
if (leftSum == rightSum) {
return i;
}
// 将当前数字加入左边总和
leftSum += nums[i];
}
return –1;
}
}
因此这道题完全是前缀和的应用,不需要使用 HashMap 了,因为我们不需要查找历史上出现过的前缀和,只需要维护一个 leftSum 就够了。
这道题比较简单,算是对我们今天学习的前缀和一个优秀的练习。下面的题就是前缀和进阶了,有些难度,挑战一下。
5. LeetCode 304. 二维区域和检索 – 矩阵不可变
题目描述:给定一个二维矩阵 matrix,以下类型的多个请求:
- 计算其子矩形范围内元素的总和,该子矩阵的左上角为 (row1, col1) ,右下角为 (row2, col2) 。 实现 NumMatrix 类:
- NumMatrix(int[][] matrix) 给定整数矩阵 matrix 进行初始化
- int sumRegion(int row1, int col1, int row2, int col2) 返回左上角 (row1, col1) 、右下角 (row2, col2) 的子矩阵的元素总和。。
注意:
- m == matrix.length
- n == matrix[i].length
- 1 <= m, n <= 200
-
−
10
5
-10^5
−105 <= nums.length <=10
5
10^5
105 - 0 <= row1 <= row2 < m
- 0 <= col1 <= col2 < n
- 最多调用
10
4
10^4
104 次 sumRegion 方法
示例 1: 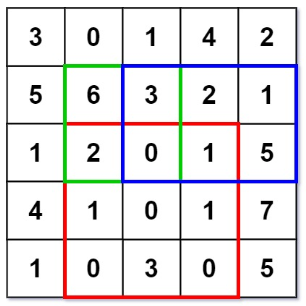
[“NumMatrix”,“sumRegion”,“sumRegion”,“sumRegion”] [[[[3,0,1,4,2],[5,6,3,2,1],[1,2,0,1,5],[4,1,0,1,7],[1,0,3,0,5]]],[2,1,4,3],[1,1,2,2],[1,2,2,4]] 输出: [null, 8, 11, 12]
解释: NumMatrix numMatrix = new NumMatrix([[3,0,1,4,2],[5,6,3,2,1],[1,2,0,1,5],[4,1,0,1,7],[1,0,3,0,5]]]); numMatrix.sumRegion(2, 1, 4, 3); // return 8 (红色矩形框的元素总和) numMatrix.sumRegion(1, 1, 2, 2); // return 11 (绿色矩形框的元素总和) numMatrix.sumRegion(1, 2, 2, 4); // return 12 (蓝色矩形框的元素总和)
从例子可以看出来我们的这里的 index 依旧是从 0 开始。 这里的难点主要是将我们之前学习的一维前缀和变为了二维前缀和。 我们现在的二维前缀和 prefix[i][j] 表示从矩阵左上角 (0,0) 到 (i-1,j-1) 这个区域内所有元素的总和。 为什么 i 和 j 要 -1,正是我刚刚说的 index 从 0 开始。 我们可以看一个例子,我们现在要计算左上角四个数的和,也就是从矩阵左上角 (0,0) 到 (1,1) 这个区域内所有元素的总和。 所以是 prefix[2][2]。 这就是二维前缀和的概念,那么怎么利用前面的前缀和计算后面的前缀和,可以看下图的第三部分。 我们将其的上一行的前缀和,以及左边一列的前缀和相加再加这一戈的元素再减去这里重复计算的左上前缀和即可。 也就是:prefix[i][j]=matrix[i-1][j-1]+prefix[i-1][j]+prefix[i][j-1]-prefix[i-1][j-1] 因此现在我们会计算二维前缀和了,二维前缀和可以让我们快速获得任意左上角矩形区域的总和。 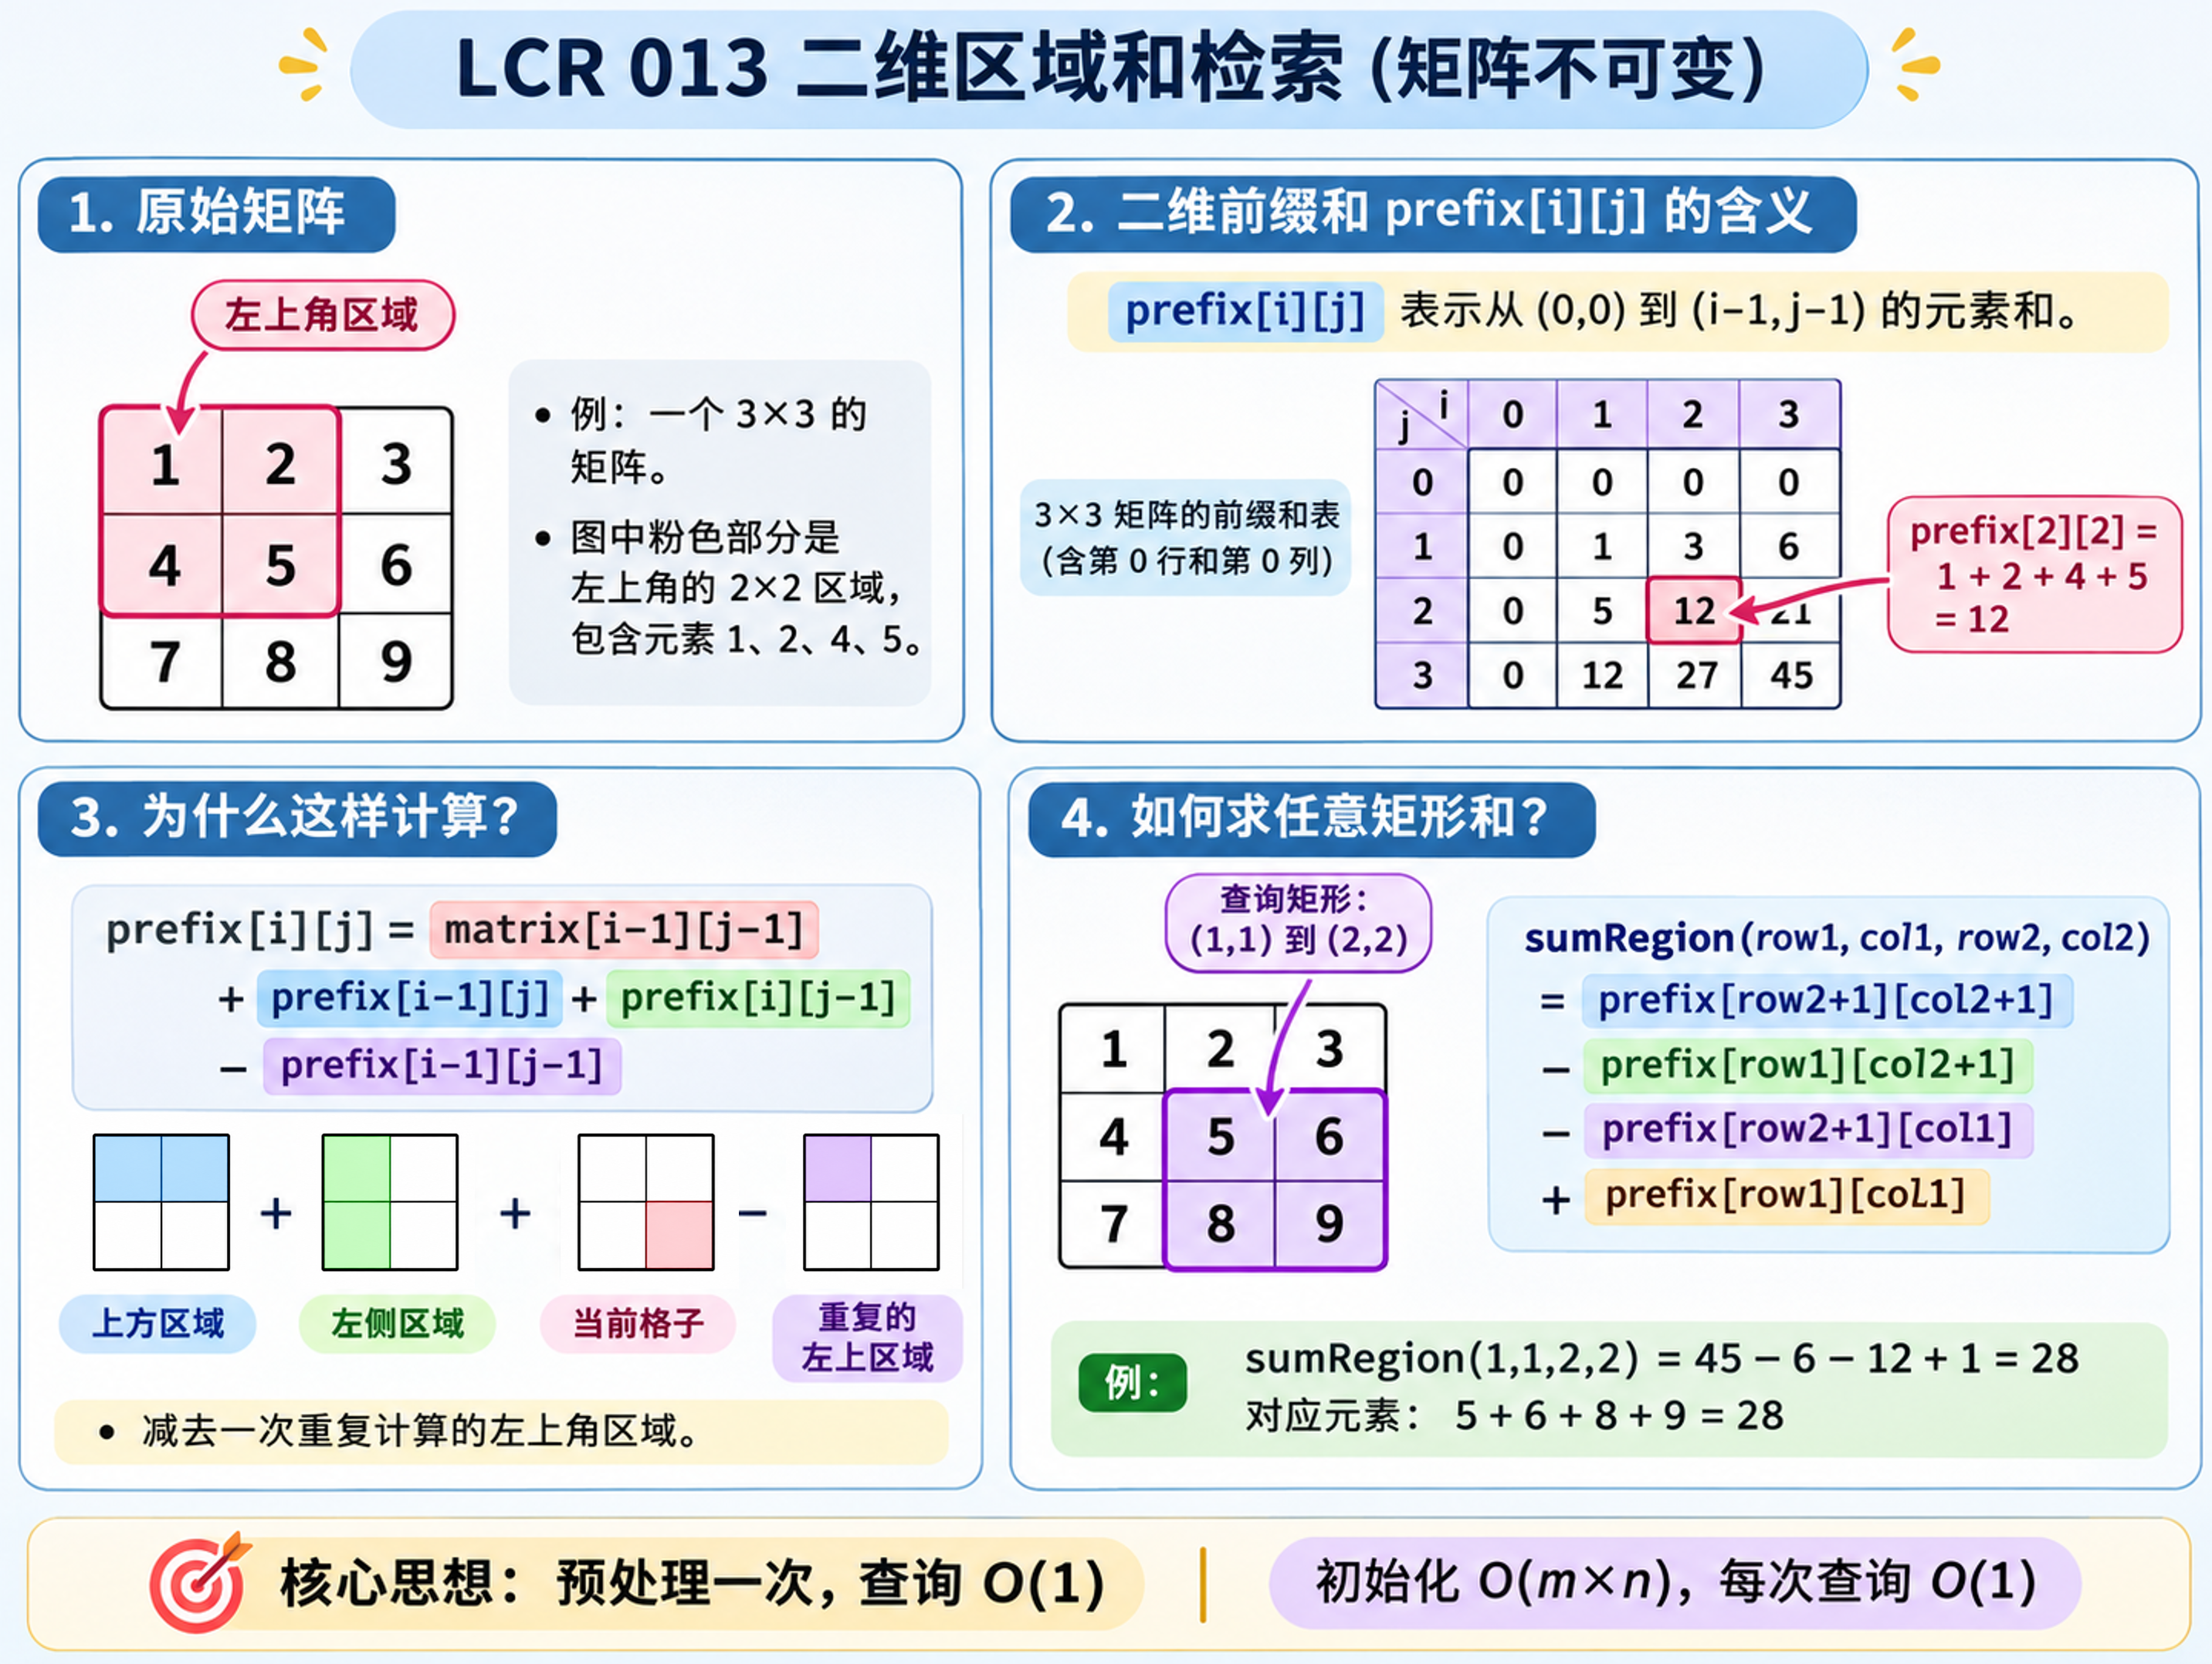
假设我们现在想计算矩阵(1,1) 到 (2,2) 这个区域内所有元素的总和。 那么我们该怎么办呢,我们可以多个前缀和去计算。这里和前面的思路类似。 如上图第四部分所示,我们只需要先计算大的前缀和,然后减去不需要的上方横着的部分以及左侧竖着的部分,然后这里会重复减去了一格,这部分要加一个就可以计算出来了。 所以现在的公式是: sum = prefix[row2+1][col2+1]-prefix[row1][col2+1]-prefix[row2+1][col1]+prefix[row1][col1]
因此我们现在可以计算任何区域了但是我们要是计算边界呢?难道要特殊情况吗? 为了方便我们可以这里多创建一行一列,方便处理边界,这里只需要在这个矩阵的外面再加一层 0 就好了。
因此完整的代码如下所示。
class NumMatrix {
int[][] pre;
public NumMatrix(int[][] matrix) {
int m = matrix.length;
int n = matrix[0].length;
// 多创建一行一列,方便处理边界
pre = new int[m + 1][n + 1];
// 计算二维前缀和
for (int i = 1; i <= m; i++) {
for (int j = 1; j <= n; j++) {
pre[i][j] =
pre[i–1][j]
+ pre[i][j–1]
– pre[i–1][j–1]
+ matrix[i–1][j–1];
}
}
}
public int sumRegion(int row1, int col1, int row2, int col2) {
return pre[row2+1][col2+1]
– pre[row1][col2+1]
– pre[row2+1][col1]
+ pre[row1][col1];
}
}
用前缀和跟暴力算法比的好处在哪里呢? 前缀和需要我们提前计算一遍前缀和,这需要我们额外创建一个 O(mn) 的数组。 从而以空间换时间,让我们的后续每次查询只需要 O(1)。 否则我们后续每次调用 sumRegion(),都需要直接遍历指定矩形区域。而且如果指定矩形区域较大的时候,也是二维前缀和更快。