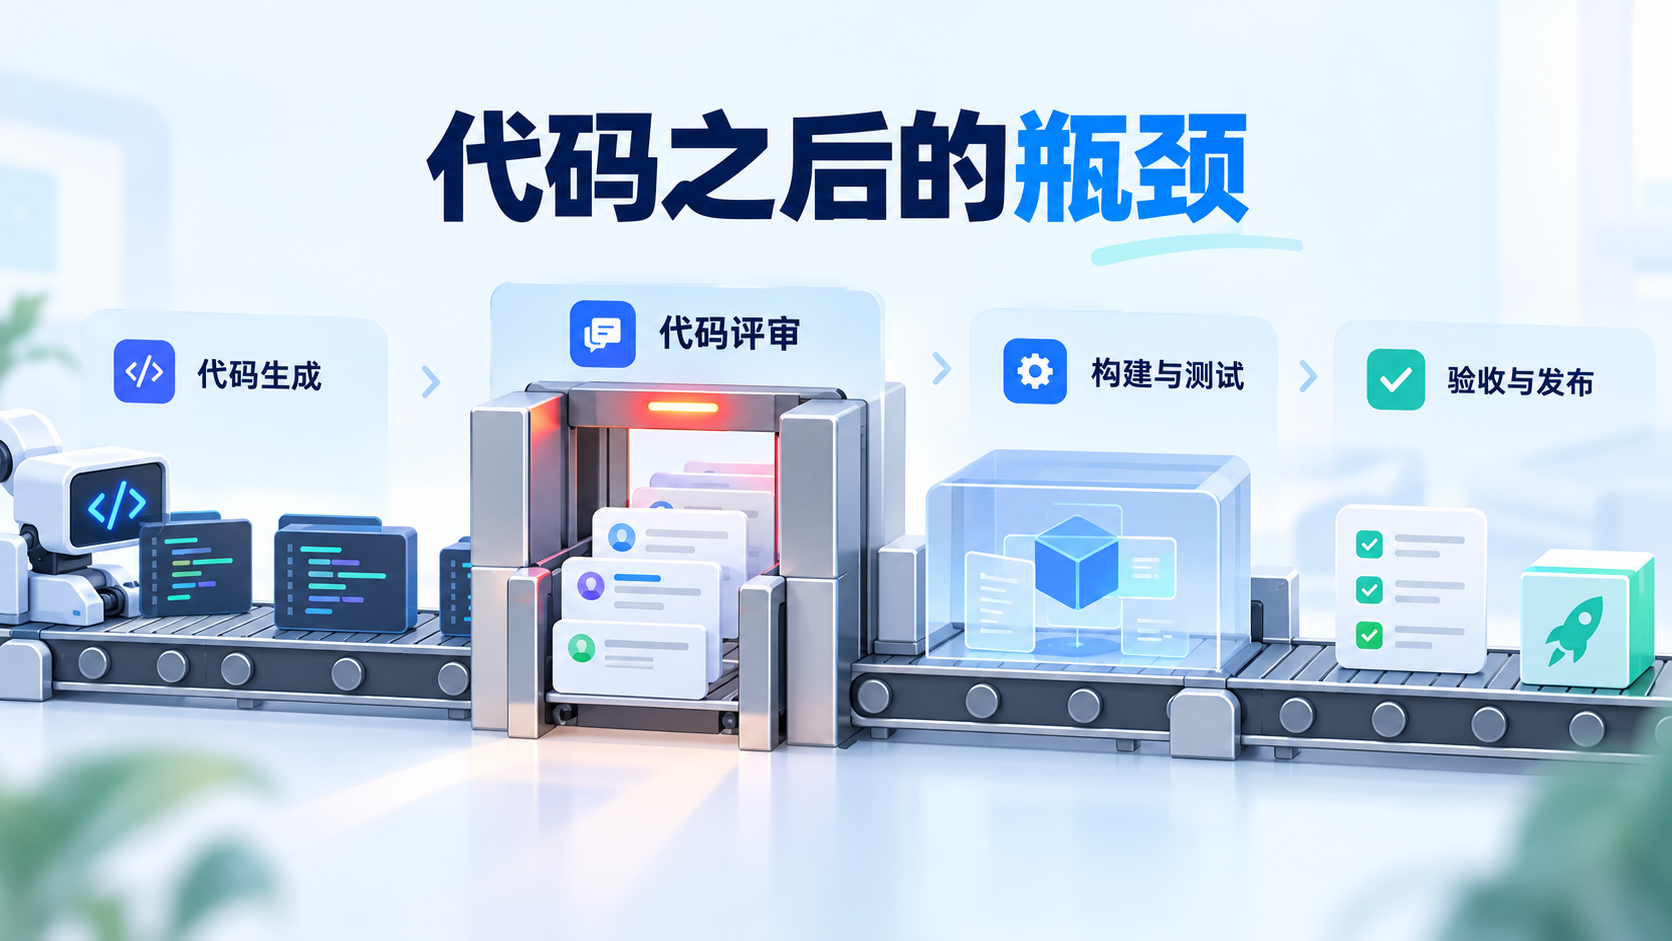
Agent 两分钟写完一个组件,PR 三天后才合入。拿前一个数字当研发效能,漏掉的恰好可能是团队真正的瓶颈。
代码生成只是交付链路的一段。评审排队、构建等待、测试环境不可用、产品验收和返工,都可能吃掉省下来的时间。该优化哪里,先看任务怎样流动,再看模型还可以快多少。
十月的源码管理案例,能借鉴什么
Anthropic 在10月13日发布、10月15日补充的文章中,介绍了 Scion 以及 Agent 规模下的源码管理问题。作者同时说明自己的工作负载很特殊;这不是一份建议所有团队抛弃 Git 的通用迁移指南。官方工程文章
对普通前端团队更有用的问题是:当代码产出增加,评审、构建和验收的处理能力有没有一起变化?
如果评审队列原本已经排满,再加快生成可能只是让队列更长。反过来,如果多数时间耗在重复搭脚手架,而下游很空,生成工具当然可能有用。不能离开实际链路直接下结论。
先给一项任务记完整账
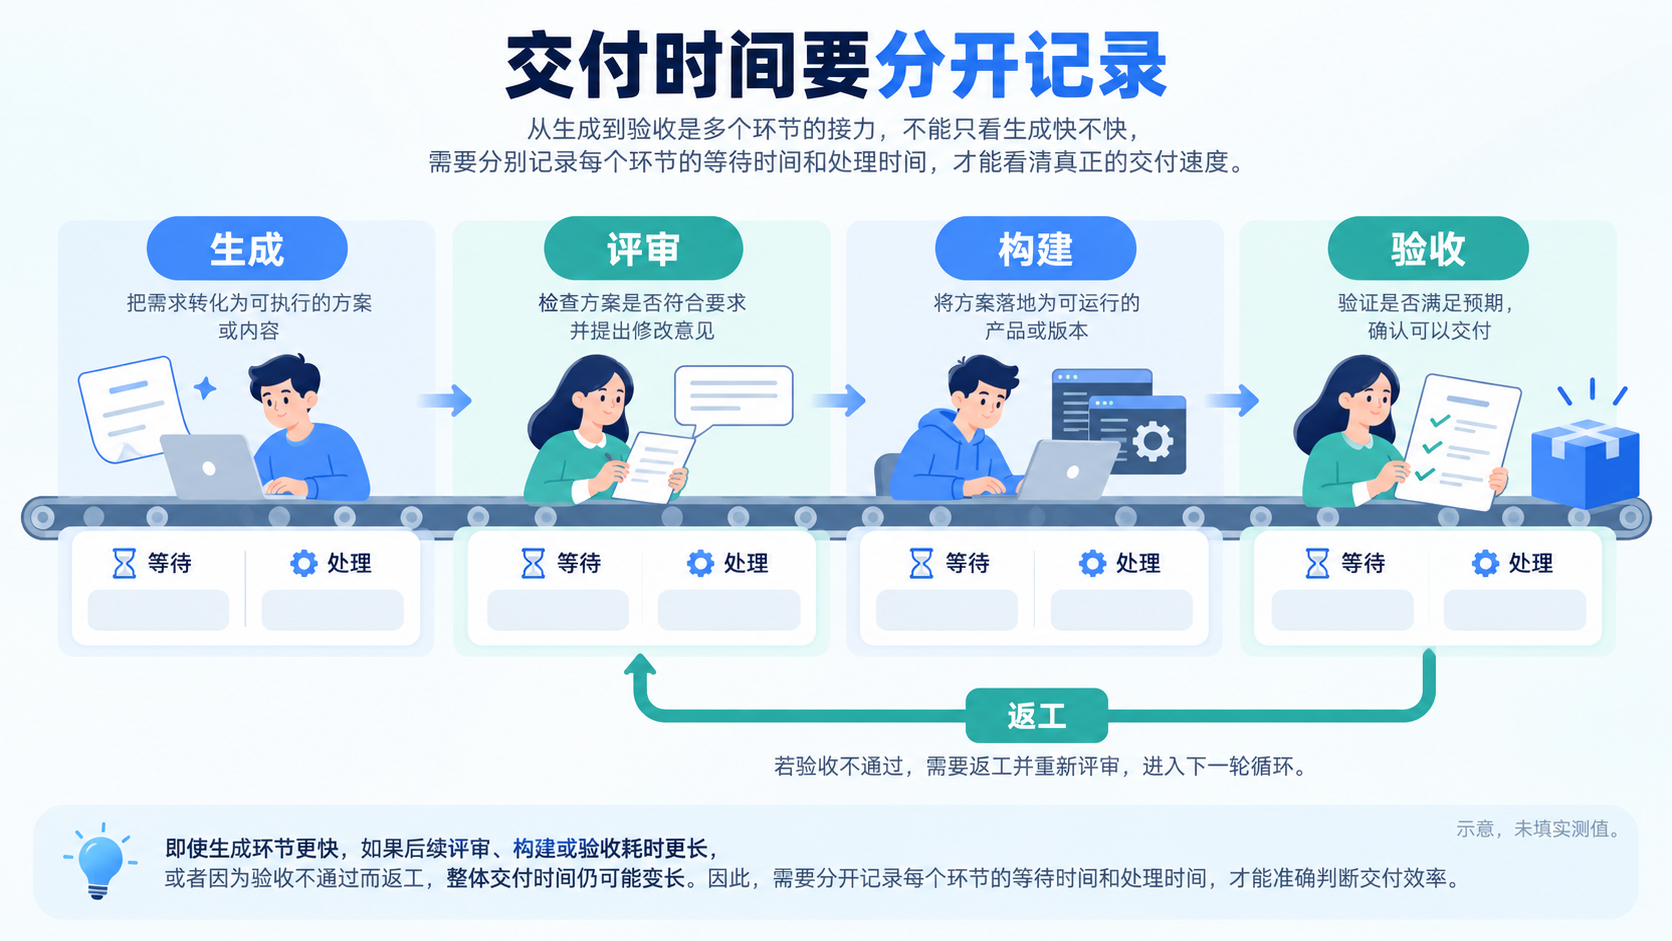
我会从一项边界清楚的前端任务开始,例如“增加一个有空态与键盘操作的筛选组件”。完成标准先写好,再记录四段:
- 生成:什么时候开始,什么时候有可供评审的差异;
- 评审:排队多久,实际审阅多久,是否退回;
- 构建:等待 runner 与实际构建分别多久;
- 验收:什么时候具备验收条件,什么时候被接受。
不要把“开始跑测试”记成任务完成,也不要把模型自述“已实现”当作验收结果。任务是否完成,要看约定的环境结果和人工接受状态。Anthropic 的 Agent 评估文章也明确区分 trace 与最终 outcome。评估方法,2026年1月9日
一个不掩盖空白时间的计算器
下面只处理同一时钟上的顺序阶段记录。数据是为单元测试构造的时间点,不是任何团队的效率测量。
import assert from 'node:assert/strict';
function summarise(stages) {
if (!Array.isArray(stages) || stages.length === 0) {
throw new TypeError('stages required');
}
let previousEnd = stages[0].entered;
let waiting = 0, working = 0;
for (const s of stages) {
const times = [s.entered, s.started, s.ended];
if (!times.every(Number.isFinite) ||
s.entered < previousEnd ||
s.started < s.entered || s.ended < s.started) {
throw new RangeError('invalid or overlapping stage');
}
waiting += s.started – s.entered;
working += s.ended – s.started;
previousEnd = s.ended;
}
const cycle = stages.at(-1).ended – stages[0].entered;
return { cycle, waiting, working,
unaccounted: cycle – waiting – working };
}
// 纯演算fixture,单位由采集方统一;不是实测耗时。
const task = [
{ name: 'generate', entered: 0, started: 0, ended: 2 },
{ name: 'review', entered: 2, started: 5, ended: 6 },
{ name: 'build', entered: 6, started: 6, ended: 8 },
{ name: 'accept', entered: 8, started: 10, ended: 11 }
];
assert.deepEqual(summarise(task),
{ cycle: 11, waiting: 5, working: 6, unaccounted: 0 });
assert.equal(summarise([
{ entered: 0, started: 0, ended: 1 },
{ entered: 3, started: 3, ended: 4 }
]).unaccounted, 2);
assert.throws(() => summarise([
{ entered: 0, started: 2, ended: 1 }
]));
console.log('delivery ledger checks passed');
unaccounted 不该被悄悄摊到某个环节。出现空白,先查漏记了等待、交接还是返工。真实系统跨客户端、CI 和评审平台采集时,还要处理时钟来源;不同机器的时间点不能不经校验就相减。
这个函数假设阶段顺序执行。若任务并发,要保留有向依赖关系与重叠区间,不能把重叠耗时直接求和成端到端时间。一个小计算器的边界写清楚,比一张混合多种口径的“提速表”可靠。
生成次数增加,质量的分母也要跟上
记录一批类似任务时,至少一起看:接受了多少、返工多少、放弃多少,以及人工复核投入。把失败任务从分母剔除,只统计最顺利的几个,会让任何工具都显得高效。
代码行数和单次补全速度可以保留作过程信息,但它们不能代替交付质量。Agent 可以快速产出一段代码,也可能把审核负担转交给人。新增代码有没有满足可访问性、性能与接口约束,要通过真实验收判断。
Google10月13日的 Argon 发布文包含复杂工程案例。这些是官方关于其模型与团队工作的陈述,适合用来提出问题,不适合复制成自己团队的效率倍数。官方发布
用记录决定下一步,不用趋势图替团队做决定
如果等待集中在评审,先缩小差异、补齐复现材料和职责边界;如果构建占主导,再看缓存与任务拆分;如果验收不断打回,优先修完成标准。只有记录表明生成是主要耗时,再重点投入生成优化。
这不需要先做一套大型 Agent 平台。用少量定义清楚的任务,保留失败和返工,再扩大范围。需要新基础设施时,账本会告诉你为什么需要,而不只是“同行都在用”。
本文没有采集真实团队任务,也没有对任何模型做效率测评。代码验证的是记录计算和非法时间检查;组织收益仍需真实任务样本。10月24日以后的交付成果没有预写。
本地核验:Node.js v26.3.0,独立保存本文 JavaScript 后运行 node,断言通过。这里只验证纯函数和构造的测试输入,不是网络或真实团队收益实测。


