/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
🔥 本文专栏:Lua 🌸作者主页:努力努力再努力wz
💪 今日博客励志语录:不必因为今天尚未抵达理想的远方,就否定一路走来的自己。
思维导图
Lua 函数调用与运行上下文
↓
Lua 虚拟机维护调用栈与执行状态
↓
debug.getinfo() / debug.traceback()
↓
需要在合适位置主动调用
↓
通用调试逻辑分散到业务函数中,产生耦合与重复
↓
希望在不修改大量业务代码的情况下观察执行行为
↓
Hook:提前注册,由虚拟机在指定执行事件发生时调用回调
│
├── 和 Reactor 一样,具有事件 → 回调的思想
└── 但监听的是 Lua 执行事件,不是 FD 的 I/O 就绪事件
↓
弄清注册对象:Lua thread(主 Lua 线程 / 协程)
↓
弄清监听内容:call / return / line / count
↓
通过 debug.sethook() 注册事件与回调
↓
虚拟机触发 hook(event, line)
↓
根据 event 分派,必要时结合 debug.getinfo() 获取函数信息
↓
实现调用追踪、代码行监控、调试与执行预算控制
引入:为什么认识了 getinfo 和 traceback,还需要 Hook?
在此前学习 Lua 调试库时,我们已经认识了两个比较重要的接口:debug.getinfo() 和 debug.traceback()。
前者能够查询函数及调用栈中指定层级的调试信息,后者则主要用于生成格式化的调用链信息。看起来有了这两个接口,我们已经能够知道函数定义在哪里、程序执行到什么位置,以及当前函数是被谁调用的。
但是这里有一个问题:如果我们希望持续监控程序中的大量函数,难道要在每个业务函数内部都手动调用一次这些接口吗?
在简单的 Demo 中,这样做当然没有问题;但是进入真实工程以后,我们通常希望业务代码只关心业务处理,把通用的执行追踪、调用监控等调试逻辑尽量独立出来。
而 Lua 提供的 Hook(钩子)机制,恰好为这类需求提供了一个入口。
本文不打算一上来就记忆 debug.sethook() 的参数,而是从此前已经建立的调用栈、Lua 虚拟机和 Reactor 回调模型出发,逐步理解 Hook 为什么存在、它究竟监听什么、监听范围如何确定,以及回调函数是怎样工作的。
一、从主动查询调用栈说起
1. 函数调用过程中,虚拟机会维护哪些信息?
我们之前已经知道,Lua 会把源代码编译成字节码,再由 Lua 虚拟机执行。执行过程中一旦发生函数调用,就需要维护对应的调用状态。
例如:
local function foo()
local a = 10
local b = 20
return a + b
end
local function bar()
local result = foo()
return result
end
print(bar())
当 foo() 正在执行时,可以把调用关系简单理解为:
调用栈(概念示意)
foo() ← 当前正在执行
bar() ← 调用 foo() 的函数
主 Chunk ← 程序入口代码
这里需要注意,调用栈代表的是活动函数调用及其执行状态,而不是每个 Lua 文件都对应一份独立的调用栈。一个函数的运行状态中涉及当前执行位置、参数、活动局部变量以及返回调用者所需的信息等;源码文件、函数定义起止行等信息,则属于函数对应的调试信息。
这里我们先建立一个基础认识:Lua 虚拟机掌握程序当前的执行状态,而调试接口允许我们查询这些信息。
2. debug.getinfo():按照指定目标查询调试信息
debug.getinfo([thread,] f [, what])
f 可以是一个函数对象,也可以是调用栈的层级;what 则用于选择需要返回哪些信息。
例如:
local info = debug.getinfo(1, "Sl")
print(info.short_src)
print(info.currentline)
print(info.linedefined)
print(info.lastlinedefined)
这里的 1 表示直接调用 getinfo() 的函数;"S" 用来获取源码相关信息,"l" 用来获取当前执行行号。返回结果是一个 Table,我们可以按字段读取所需数据。
因此,getinfo() 的特点就是:查询目标相对精确,而且可以通过 what 选择结果内容。
另外,getinfo() 不会把局部变量的名称和值直接全部放进返回的 Table;如果要读取活动局部变量,还需要使用 debug.getlocal() 等接口。直接传入函数对象时,也不能凭空知道该函数某一次调用的当前执行行号。
3. debug.traceback():侧重整个调用链
debug.traceback([thread,] [message [, level]])
相比之下,traceback() 的目标更加明确:根据调用栈生成格式化的回溯字符串,帮助我们查看函数之间的调用关系。
例如:
local function foo()
print(debug.traceback("查看调用链"))
end
local function bar()
foo()
end
bar()
它支持通过 level 指定从哪一层开始显示调用栈,也可以通过 message 在回溯信息前添加说明:
debug.traceback("发生错误", 2)
debug.traceback(nil, 2) — 不添加说明,从第 2 层开始
此外还有一个容易忽略的细节:当 message 既不是字符串,也不是 nil 时,traceback() 会直接原样返回这个值,不再生成调用栈字符串:
local t = { code = 500 }
print(debug.traceback(t) == t) — true
我们可以这样比较:
| 主要目标 | 查询指定函数或栈帧的信息 | 展示调用链 |
| 返回结果 | Table | 通常是格式化字符串 |
| 可配置程度 | 通过 what 选择信息字段 | 可指定消息和起始层级,不能自由选择字段 |
| 典型用途 | 查询函数、文件和执行位置 | 错误回溯、调用链定位 |
两个接口的共同点在于:都是程序在某个位置主动调用的调试接口。
4. 主动调用为什么会引出解耦问题?
假设我们正在开发游戏服务端的背包模块:
local function addItem(player, item)
print(debug.traceback("添加物品"))
player.items[item.id] = item
end
local function removeItem(player, itemId)
print(debug.traceback("删除物品"))
player.items[itemId] = nil
end
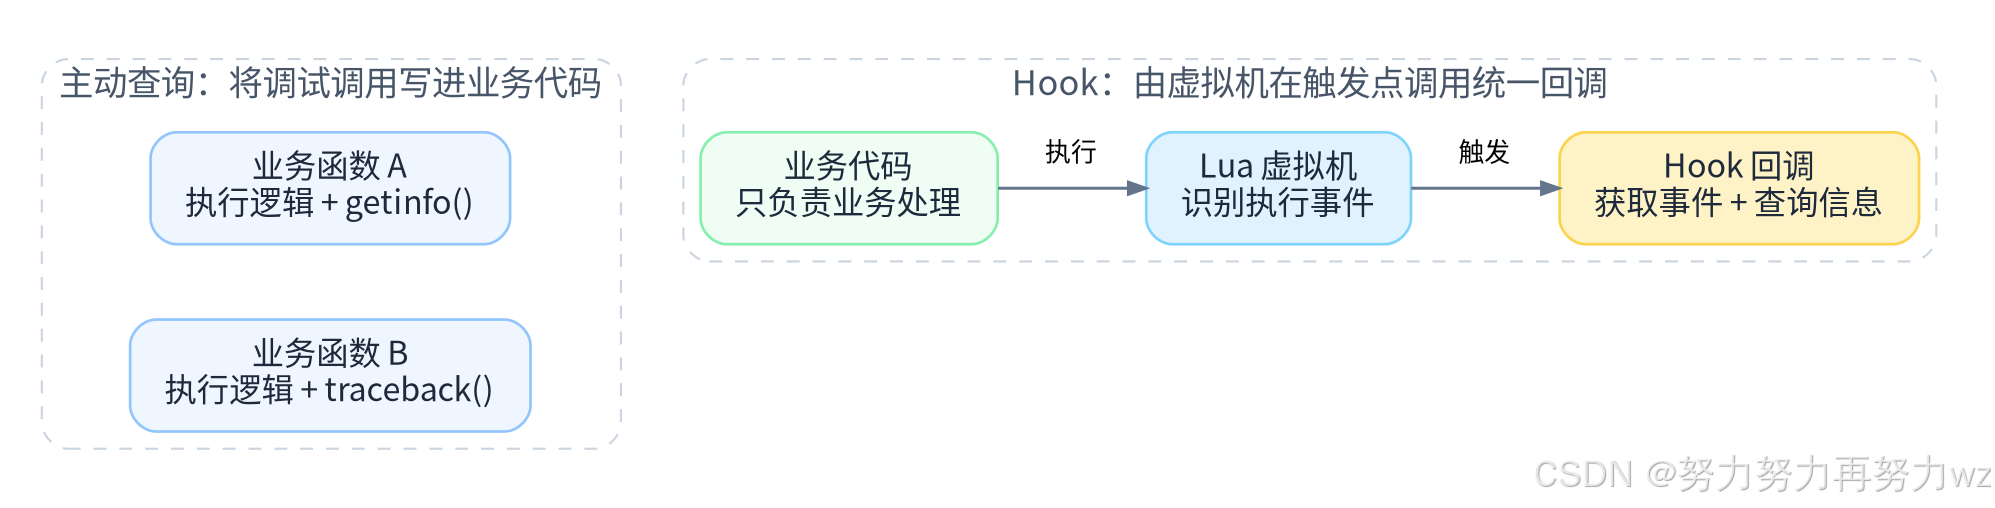
这里存在两类职责:一类负责添加和删除物品,另一类负责打印调用信息。如果只是临时定位问题,这样写很直观;但如果希望监控大量业务函数,就会面临调试代码重复、插入位置分散、统一开关不方便等问题。
所以我们真正希望的是:不需要在每一个业务函数中主动插入通用的追踪代码,也能在函数调用、返回、执行代码行等时机观察程序行为。
需要说明,工程中并不是不能主动调用 getinfo() 或 traceback()。例如,在统一异常处理器或日志模块中集中调用 traceback() 完全合理。这里想解决的,是“大量通用调试逻辑散落在业务代码中”的问题,而不是要禁止主动查询。
二、Hook 为什么能自动执行?从 Lua 虚拟机与 Reactor 说起
1. 先回到 Lua 的代码执行流程
我们之前认识过 Lua 的加载与执行机制,可以先把整个过程简化为:
Lua 源代码 / Chunk
↓
加载、编译
↓
生成字节码
↓
Lua 虚拟机执行字节码
↓
产生函数调用、返回、代码行执行等行为
对于 Lua 函数来说,虚拟机负责执行它的字节码,因此自然知道什么时候进入一个函数、什么时候准备返回、当前执行位置对应哪一行源代码,以及已经执行了多少条虚拟机指令。
那么能否让虚拟机在这些特定位置主动通知我们,而不必让业务函数亲自调用调试接口?
答案就是 Hook。
Hook 的本质,是 Lua 运行时提供的一套执行事件回调机制。我们提前注册关注的事件和回调函数,虚拟机在执行到相应触发点时,自动调用这个回调。
要注意,这里并不意味着每个函数的字节码都被修改或插入了一条调试语句。我们目前只需要理解为:虚拟机本身支持在相应执行位置触发调试回调即可。
2. 为什么说它和 Reactor 的思路很像?
此前我们学习主从 Reactor 模型时,已经认识过这样一条处理链路:
主 Reactor 接受连接并得到 FD
↓
将连接分配给从 Reactor
↓
从 Reactor 注册 FD 及关注的 I/O 事件
↓
epoll_wait() 返回就绪事件
↓
根据 FD 与事件类型分发处理逻辑
Hook 与 Reactor 都涉及“提前关注事件 → 事件发生 → 调用处理逻辑”这个共同思想,但它们并不是同一个执行模型。
| 关注对象 | FD 的 I/O 就绪状态 | Lua 执行过程中的调试事件 |
| 事件来源 | 操作系统 I/O 多路复用机制 | Lua 虚拟机执行机制 |
| 典型事件 | 可读、可写等 | call、return、line、count |
| 谁来组织回调 | Reactor 事件分发逻辑 | Lua Hook 触发机制 |
| 是否需要等待 I/O 就绪 | 可以通过 epoll_wait() 阻塞等待 | 不需要额外的 I/O 等待循环 |
更直观地说,Reactor 关心的是“连接什么时候可读、可写”,Hook 关心的是“Lua 程序什么时候进入函数、离开函数、执行到某个位置”。
因此,Reactor 是事件驱动的服务器架构,而 Hook 是 Lua 虚拟机支持的调试回调机制。 不能因为它们都使用回调,就认为 Lua 虚拟机内部还运行着一套类似 epoll 的 Reactor。
3. Hook 回调在什么时候执行?
这里我们还需要纠正一个容易出现的理解:不是所有 Hook 都是“先执行回调,再执行被监听的事件”。所谓的事件本身并不一定是一段尚未执行的代码,而可能是虚拟机执行过程中已经到达的某个状态。
对于普通 Lua 函数调用,可以这样理解:
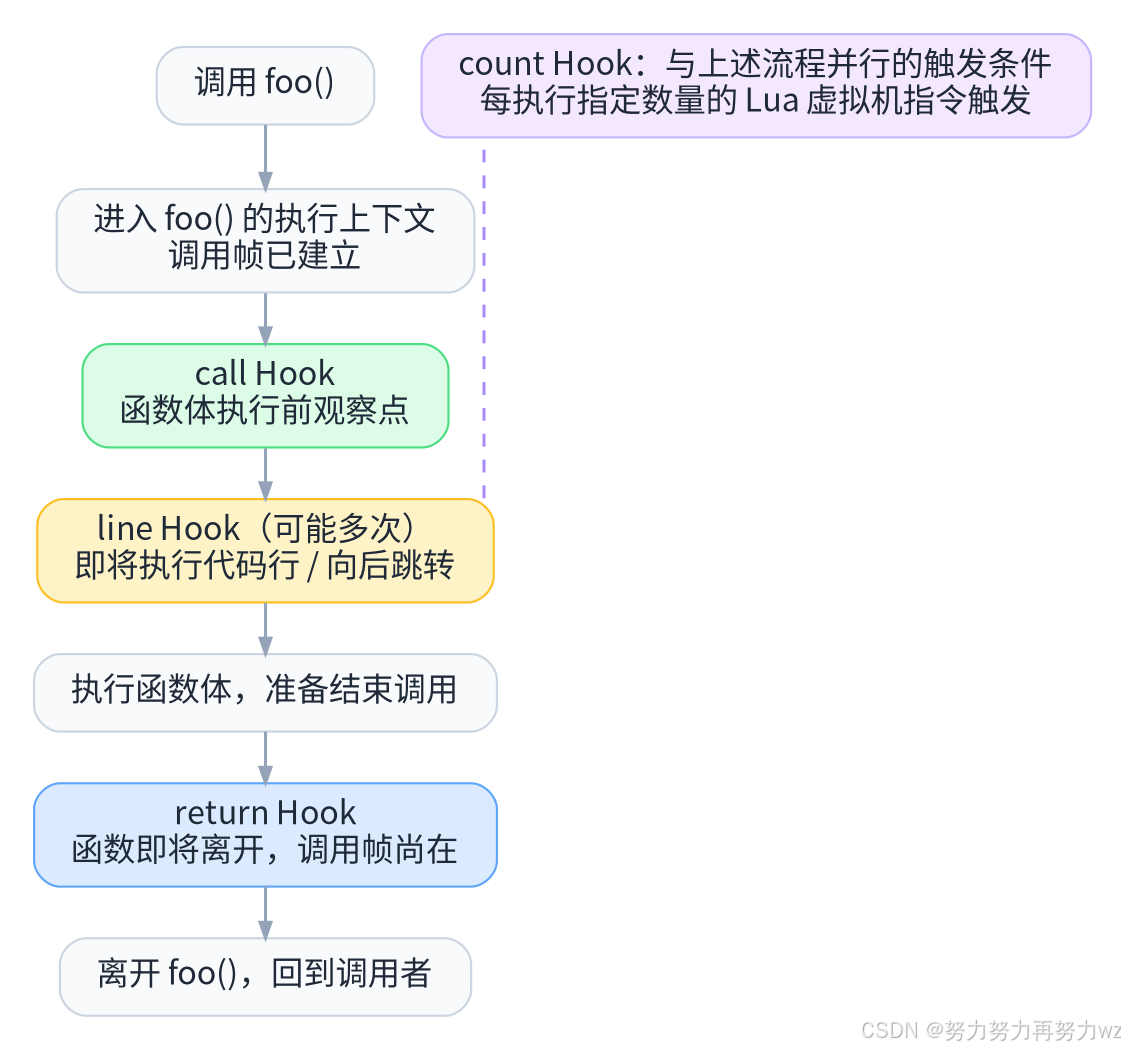
- 函数调用事件 call:虚拟机已经进入被调用函数的执行上下文,但尚未正常执行函数体。
- 函数返回事件 return:函数已经来到返回阶段,虚拟机即将离开当前函数的调用帧。
- 代码行事件 line:即将执行某行对应的代码,或者执行过程中发生向后跳转。
- 指令计数事件 count:执行了指定数量的 Lua 虚拟机指令后触发。
通常情况下,Hook 回调是在当前 Lua 执行流程中同步运行的:触发回调、回调执行完成、虚拟机继续原来的执行流程。它不是自动开启一个新的 OS 线程异步处理这些事件。
三、Hook 究竟注册到哪里?先区分宿主线程、Lua thread 与 Chunk
这个问题十分重要,因为刚开始接触 debug.sethook() 时,我们可能会自然地认为:既然是代码行事件,那是不是应该指定某个文件或者具体行号?
但实际上,Hook 的注册粒度不是某个函数、某个文件或者某一行代码,而是 Lua thread。
1. Lua thread 不是操作系统线程
Lua 可以嵌入 C/C++ 等宿主程序中运行。宿主程序的 OS 线程负责实际执行 Lua 虚拟机代码,这是执行的载体。
而 Lua 自己也有 thread 这个数据类型,它表示 Lua 内部的执行流。即使没有显式创建协程,一个 Lua 运行时也有主 Lua 线程:
local running, isMain = coroutine.running()
print(type(running)) — thread
print(isMain) — 在主 Lua 线程中为 true
当我们调用 coroutine.create() 时,创建的是另一个 Lua thread(协程):
local co = coroutine.create(function()
print("协程执行")
end)
print(type(co)) — thread
这里必须区分:宿主 OS 线程是实际执行载体,Lua thread 是 Lua 维护的执行上下文。 两者不是同一个概念,也不要求一一对应。
2. Chunk 也不等于 Lua thread
这里还需要回忆此前学习的 dofile() 和 loadfile():
— main.lua
local f = loadfile("a.lua") — 加载并编译,不立即执行
f() — 在当前 Lua thread 中执行
dofile("b.lua") — 加载并执行
a.lua、b.lua 对应的是可以加载、编译并执行的代码单元(Chunk),并不会因为加载了多个文件,就自动创建多个协程。
因此:Chunk 是被执行的代码,Lua thread 才是执行这些代码的执行流。 同一个 Lua thread 可以执行多个函数和多个 Chunk。
3. 每个 Lua thread 都有自己的 Hook 配置
下面这张图就是我们现阶段需要掌握的模型,不必进一步展开底层结构体字段:
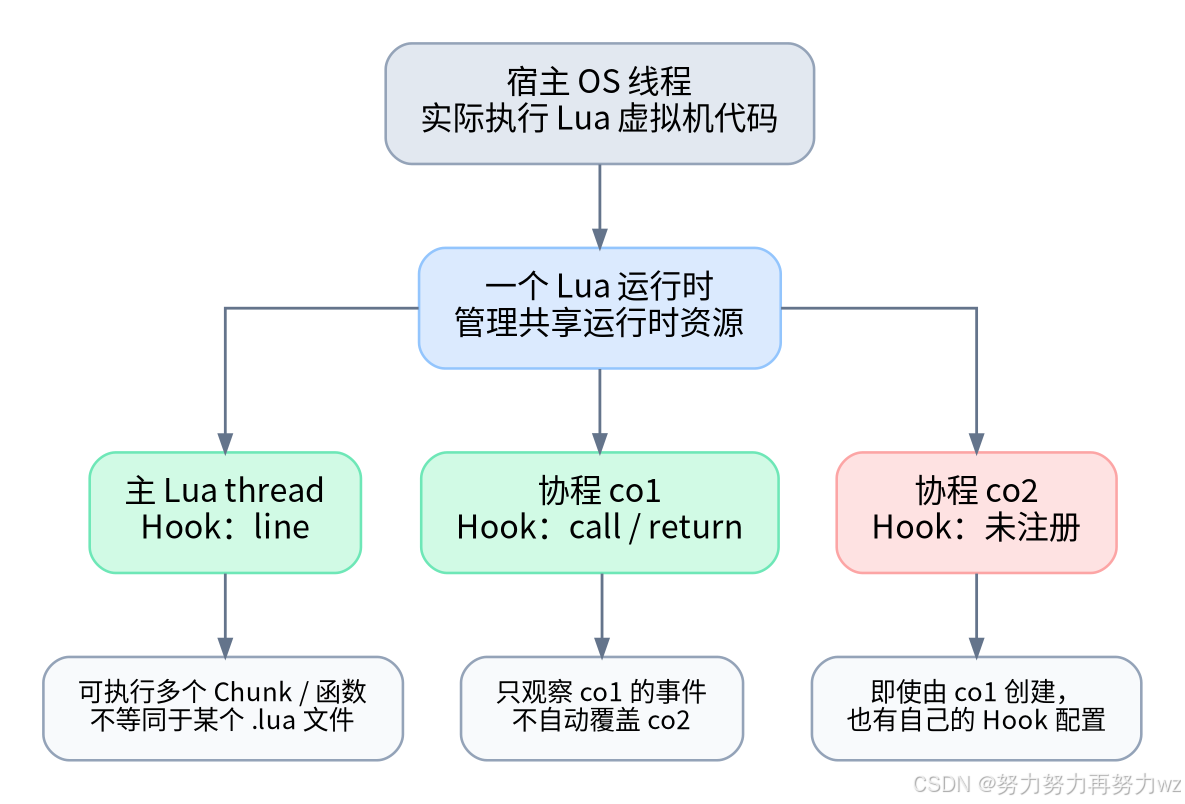
可以把每个 Lua thread 理解为都维护自己的执行栈、函数调用状态和 Hook 配置。注册 Hook,就是针对其中某个 Lua thread 设置要关注的事件以及回调。
例如:
— 给当前 Lua thread 注册
debug.sethook(hook, "l")
— 显式给某个协程注册
debug.sethook(co, hook, "l")
第一种在主 Lua 线程中执行时,监听的是主 Lua 线程;第二种显式指定 co,监听的是 co 的执行过程。
这里的“独立”是我们理解 注册与生效范围 的心智模型,不意味着多个协程之间的全部运行时资源都相互隔离。它们仍然可以共享所属 Lua 运行时中的全局环境、对象等资源。
4. 在一个协程里再创建协程,会自动受到监控吗?
假设:
local co1 = coroutine.create(function()
local a = 10
local co2 = coroutine.create(function()
local b = 20
print(b)
end)
coroutine.resume(co2)
print(a)
end)
— 只显式为 co1 设置 Hook
debug.sethook(co1, hook, "l")
coroutine.resume(co1)
我们可以沿着执行过程理解:
主 Lua thread
↓
resume(co1)
↓
执行 co1 的代码 → 按 co1 的 Hook 配置处理
↓
co1 创建并 resume(co2)
↓
执行 co2 的代码 → 按 co2 自己的 Hook 配置处理
↓
co2 结束或 yield
↓
恢复 co1 的代码 → 再按 co1 的 Hook 配置处理
这也说明,创建协程的代码发生在 co1 的上下文中,不等于新协程的函数体也在 co1 的上下文中运行。
对于通过 Lua 层 debug.sethook() 注册的回调,需要监控哪个 Lua thread,就明确给哪个 Lua thread 配置 Hook。
四、debug.sethook():指定回调与关注的执行事件
认识了注册对象以后,接口就比较容易理解了:
debug.sethook([thread,] hook, mask [, count])
| thread | 可选,指定 Lua thread;省略时是当前 Lua thread |
| hook | 事件发生后要调用的回调函数 |
| mask | 使用字符组合指定函数调用、返回、代码行事件 |
| count | 可选,设置执行多少条虚拟机指令触发一次计数事件 |
例如:
debug.sethook(hook, "c") — 关注函数调用
debug.sethook(hook, "cr") — 关注函数调用和返回
debug.sethook(hook, "crl") — 同时关注调用、返回、代码行
这里有两个重点。
第一,注册粒度是 Lua thread,不是单个业务函数。 比如我们在主 Lua thread 中注册 "cr",那么它在执行 foo()、bar() 甚至其他文件中的 Lua 函数时,只要发生符合条件的事件,就可能触发 Hook。
第二,一个 Hook 可以关注多种事件,统一使用同一个回调函数。 不是说 call 一定绑定一个函数、return 必须再绑定另一个函数;通常是在回调内部通过事件类型进行分发。
而且,同一个 Lua thread 后续再次执行 debug.sethook() 会更新当前配置,并不是不断叠加一组新的 Hook 回调。
五、四种 Hook 事件到底关注什么?
1. call:函数调用事件
当 Lua 调用一个函数时,会进入被调用函数的执行上下文。对于普通 Lua 函数,call Hook 的触发点可以理解为:
调用 foo()
↓
建立 foo() 对应的调用状态
↓
进入 foo() 的执行上下文
↓
触发 call Hook
↓
Hook 回调结束
↓
开始正常执行 foo() 的函数体
注意,这里的 call 关注的是函数调用行为,不是提前为某个指定函数注册 Hook。 print() 这类 C 函数的调用也可能产生调用事件;而对于尾调用,还可能收到 "tail call" 事件。
2. return:函数返回事件
例如:
local function foo()
local a = 10
return a
end
当函数来到返回阶段时,可以这样理解:
foo() 执行函数体
↓
来到返回阶段,准备退出
↓
触发 return Hook
↓
Hook 回调结束
↓
离开 foo() 的调用帧
↓
恢复调用者的执行
这里不能机械地理解成“整个 return 语句已经彻底执行完成后,才开始 Hook”。更准确的说法是:虚拟机已经进入函数返回流程,但在真正离开函数之前触发 Hook。
现在我们就能够解释一个重要现象:call 和 return 的 Hook 触发时,相关函数的调用帧仍然可供调试接口查询,因此可以在回调中使用 debug.getinfo() 获取函数信息。
不过,尾调用会影响普通的调用/返回对应关系,不能假定每次 "tail call" 后都会再收到与之严格配对的 "return" 事件。
3. line:代码行事件
前两种事件关注的是函数的调用与退出,而 line 更关注函数内部执行到了哪里。
例如:
local function foo()
local a = 10
local b = 20
print(a + b)
end
当虚拟机即将开始执行新的源代码行时,会产生相应的行事件。这里的行号是由 Lua 字节码携带的源码位置信息确定的,并不是去重新扫描 .lua 文件。
另外,对于循环等控制流结构,向后跳转时也会触发行事件,即使返回的还是同一行。因此:
Line Hook 不能简单理解为“只有源代码行号变化才触发一次”,更不能理解为“一行代码最多触发一次”。
这里还有我们此前讨论过的一个关键问题:
一个 Lua 文件有这么多行,sethook() 并没有让我指定第几行,那它到底关注哪一行?
答案是:默认监听该 Lua thread 执行过程中产生的全部相关行事件,并没有事先指定某一行。
例如:
debug.sethook(hook, "l")
无论当前 Lua thread 执行 a.lua、b.lua,还是调用哪个函数,只要满足行事件触发条件,就会进入同一个回调。
如果只希望监控 game.lua 的第 20 行,需要在 Hook 内部根据行号和源码文件进一步过滤,而不是通过 sethook() 直接注册第 20 行:
local function onLine(event, line)
if event ~= "line" or line ~= 20 then
return
end
local info = debug.getinfo(2, "S")
if info and info.source == "@game.lua" then
print("执行到 game.lua 第 20 行")
end
end
— 注意:实际 source 可能包含完整路径,需要按真实路径匹配
debug.sethook(onLine, "l")
即使在回调内部做了过滤,其他行事件仍然可能触发 Hook,因而仍有额外开销。
4. count:指令计数事件
前三种事件通过 mask 里的字符启用,而 count 比较特殊:它关注的是当前 Lua thread 执行了多少条 Lua 虚拟机指令。
debug.sethook(hook, "", 100)
这里的 "" 表示不关注 call、return、line;100 表示每执行 100 条 Lua 虚拟机指令,触发一次 count 事件。
为什么要强调“虚拟机指令”?因为:
sum = sum + i
源代码虽然只有一行,但编译后可能对应多条虚拟机指令,循环也会反复执行它们。所以 100 条虚拟机指令并不是 100 行 Lua 代码,更不是 100 条 CPU 机器指令。
count 在普通单步调试中可能不如前三种直观,但并不是没有用途。比如要给某段脚本设置执行指令预算,可以定期检查累计执行量,并在达到限制时主动报错或采取其他控制措施。
不过它无法精确衡量真实执行时间,也不能靠它逐条统计 C 函数内部的机器指令;对于长时间运行的 C 函数,单靠这个机制也无法保证及时中断。
5. 四种事件放在一起看
| 函数调用 | mask 包含 "c" | 函数进入调用状态 | "call",尾调用时可能为 "tail call" |
| 函数返回 | mask 包含 "r" | 函数即将退出 | "return" |
| 代码行 | mask 包含 "l" | Lua 源码执行位置与向后跳转 | "line" |
| 指令计数 | count 非零 | Lua 虚拟机执行指令数量 | "count" |
四种事件也可以同时关注:
debug.sethook(hook, "crl", 100)
六、Hook 回调函数:事件参数与 getinfo 如何配合?
1. 回调函数本质上还是普通 Lua 函数
例如:
local function hook(event, line)
— 在这里处理事件
end
它和我们此前定义的普通 Lua 函数没有本质区别,只是调用时机和传参协议由 Lua Hook 机制决定,而不是由业务代码直接调用 hook(…)。
这里的两个形参具有固定含义:
- event:触发 Hook 的事件名称,可能是 "call"、"tail call"、"return"、"line"、"count"。
- line:只有 "line" 事件提供对应的源码行号;其他事件下为 nil。
因此,一个典型的 Hook 函数就会按照事件类型进行分派:
local function hook(event, line)
if event == "call" then
— 处理普通函数调用事件
elseif event == "tail call" then
— 处理尾调用事件
elseif event == "return" then
— 处理函数返回事件
elseif event == "line" then
— 处理代码行事件(可使用 line)
elseif event == "count" then
— 处理指令计数事件
end
end
2. 为什么 call 事件还要配合 debug.getinfo()?
现在思考一个问题:如果 Hook 收到了 "call",它只知道“发生了函数调用”,却并不知道究竟是 foo()、bar() 还是其他函数被调用。
所以,我们需要重新用到最开始学习的 debug.getinfo():
local function hook(event, line)
if event == "call" then
local info = debug.getinfo(2, "nS")
if info then
print("函数名:", info.name or "未知")
print("来源:", info.short_src)
end
end
end
这里最值得理解的是 debug.getinfo(2, "nS") 中的 2。
当我们在 Hook 内部调用 getinfo() 时,可以把查询层级理解为:
Level 0:debug.getinfo() 自身
Level 1:hook() 回调函数
Level 2:触发当前 Hook 事件的函数
所以,在 Hook 内部查询第 2 层,就能拿到对应被观察函数的调试信息。"n" 用于尝试获取函数名,"S" 用于获取源码信息。
注意 info.name 可能是 nil,因为 Lua 不一定能够推断出函数名称。若希望精确筛选某个函数,可以使用 "f" 选项取回 info.func,再与目标函数对象比较。
因此我们就把两个知识点串起来了:
Hook 负责在指定执行时机通知我们,getinfo() 则负责进一步获取这个执行位置对应的函数信息。
3. 通过一个完整示例串起回调与事件过滤
下面我们只关注 add() 函数产生的调用、返回与行事件:
local function add(a, b)
local result = a + b
return result
end
local function traceHook(event, line)
— 取回当前 Hook 对应的函数对象及其源码信息
local info = debug.getinfo(2, "fS")
— 整个 Lua thread 的事件都会进来;这里只处理 add
if not info or info.func ~= add then
return
end
if event == "call" then
print("进入 add()")
elseif event == "return" then
print("即将离开 add()")
elseif event == "line" then
print("add() 执行行:", line)
end
end
— 为当前 Lua thread 注册一个回调,关注三种事件
debug.sethook(traceHook, "crl")
local result = add(10, 20)
— 关闭当前 Lua thread 的 Hook
debug.sethook()
print("计算结果:", result)
分析这段代码时,可以按照以下顺序理解:
这里还要补充一个机制:Lua 执行 Hook 回调期间,会暂时禁止其他 Hook 再次触发。 因此回调里调用 print(),不会因为 print() 本身也是函数调用而无限递归进入当前 Hook。
七、debug.gethook():查询已注册的 Hook
既然可以使用 debug.sethook() 注册 Hook,自然也可以查询当前配置:
debug.gethook([thread])
当对应 Lua thread 存在有效 Hook 时,会返回三个值:
local registeredHook, mask, count = debug.gethook()
例如:
local function hook(event, line)
— 处理调试事件
end
debug.sethook(hook, "cr", 100)
local currentHook, mask, count = debug.gethook()
print(currentHook == hook) — true
print(mask) — cr
print(count) — 100
debug.sethook() — 关闭当前 Hook
所以两个接口可以放在一起记忆:
- debug.sethook():设置指定 Lua thread 的 Hook。
- debug.gethook():查询指定 Lua thread 当前的 Hook 配置;没有有效 Hook 时返回 nil。
对于某个特定协程,也可以显式传入该协程对象进行设置或查询。
八、实际工程中使用 Hook,还需要注意什么?
第一,Hook 是执行监控机制,不等于业务事件系统。它主要用于调试器、调用追踪、执行行为观察、分析工具,以及部分脚本执行预算控制;不能把它直接理解成网络服务器的事件循环。
第二,Hook 的范围是 Lua thread,而不是代码文件。切换到另一个协程后,需要考虑那个协程自己的 Hook 配置;同一个 Lua thread 执行其他 Chunk 时,原先配置的 Hook 仍然可能生效。
第三,高频 Hook 会带来性能开销。尤其是 "l" 和很小的 count 间隔,可能频繁进入回调;即使只想监控某个特定文件或函数,也可能需要先接收更宽范围的事件再过滤。因此,线上游戏服务端一般不宜长期开启高频全量追踪。
第四,并不是所有调试需求都应该使用 Hook。统一异常处理时主动调用 debug.traceback() 仍然是合理且常见的做法。是否使用 Hook,应当根据实际需要观察的事件、性能成本和调试目标来判断。
第五,Hook 的触发与调试信息并不是无条件完整的。比如 C 函数没有 Lua 源代码行事件,尾调用可能影响调用帧关系,编译时缺失调试信息也会限制可查询内容。
九、总结:把 Hook 放回整个 Lua 调试体系
到这里,我们已经可以重新审视整个 Lua 调试机制:
Lua 虚拟机执行代码
↓
维护函数调用与运行状态
│
├── 主动查询
│ ├── debug.getinfo():指定函数 / 栈帧信息
│ └── debug.traceback():格式化调用链
│
└── 自动观察
└── debug.sethook():注册 Hook
↓
关注 call / return / line / count
↓
触发 hook(event, line)
↓
根据 event 分派
↓
必要时再调用 getinfo()
↓
调用追踪、代码行监控、执行分析
此前学习的 getinfo() 与 traceback() 解决的是:我们怎样主动获取 Lua 程序的运行信息?
而 Hook 解决的是:能否让 Lua 虚拟机在某些执行事件发生时,自动通知我们去处理调试逻辑?
这两者并不冲突,反而可以配合使用。
从设计思想上说,Hook 与此前认识的 Reactor 都涉及事件触发与回调,但它们关注的是不同层次的事件;从注册范围上说,Hook 面向的是 Lua thread;从回调协议上说,虚拟机传递 event 和 line,我们再按事件分派,需要详细函数信息时使用 getinfo()。
所以,理解 Hook 最重要的并不是背下四个事件,而是建立这样一条完整的逻辑:主动查询调试信息存在重复与耦合问题 → 利用虚拟机掌握执行状态这一能力 → 为 Lua thread 注册 Hook → 在特定执行事件发生时自动调用回调 → 进一步查询和处理调试信息。
这样一来,Hook 就不再是一个孤立的 Lua API,而是可以自然地纳入我们之前建立的 Lua 运行时与调用栈心智模型之中。