/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
Python 网络爬虫实战:中国电动汽车市场分析与可视化系统,从数据采集到决策展示
Requests|BeautifulSoup|数据清洗|统计分析|市场可视化|源码资料可领
|
项目摘要 项目以中国电动汽车市场为研究对象,通过网络爬虫采集市场相关数据,完成去重、缺失值处理、格式转换和数据集成,再从品牌、销量、市场份额、用户偏好等维度进行描述性分析和可视化展示,为市场观察和决策提供数据支持。 |
|
关键词:Python、网络爬虫、数据清洗、电动汽车、数据分析、可视化 |
一、项目不是“爬网页”,而是构建数据闭环
一个完整的市场分析项目至少包含数据源确认、采集策略、清洗规则、指标设计、统计分析、可视化表达和系统展示七个环节。爬虫只是入口,真正决定项目质量的是后续的数据治理与分析逻辑。
二、数据源与采集边界
系统的数据来源可以覆盖汽车销售网站、行业资讯平台、公开报告和用户评论等公开页面。采集内容包括车型与品牌信息、价格区间、销量或热度、用户评论、市场资讯等。项目实施时应明确采集频率、字段范围和页面变化策略,避免盲目抓取。
- 结构化字段:品牌、车型、价格、级别、续航、发布时间等。
- 半结构化字段:用户评论、资讯正文、标签和来源链接。
- 分析字段:销量趋势、品牌占比、价格分布、用户关注点和市场热度。
三、网络爬虫采集流程
|
发送 HTTP 请求 |
解析页面 |
定位字段 |
异常重试 |
数据落库 |
记录采集日志 |
采集程序可使用 Python 配合 Requests 和 Beautiful Soup 完成。对列表页与详情页分别设计解析规则,使用唯一键避免重复写入,并对请求失败、页面结构变化和字段缺失进行日志记录。
|
response = requests.get(url, headers=headers, timeout=10) |
四、数据预处理决定分析可信度
五、分析指标体系
- 市场规模:车型数量、品牌数量、价格区间和销量变化。
- 竞争格局:品牌市场份额、热门车型和细分市场分布。
- 消费偏好:评论关键词、关注配置、价格敏感度和车型偏好。
- 趋势判断:时间序列变化、政策节点前后差异和品牌增速。
- 运营视角:资讯热度、轮播内容、用户行为与页面访问。
六、系统架构与功能模块
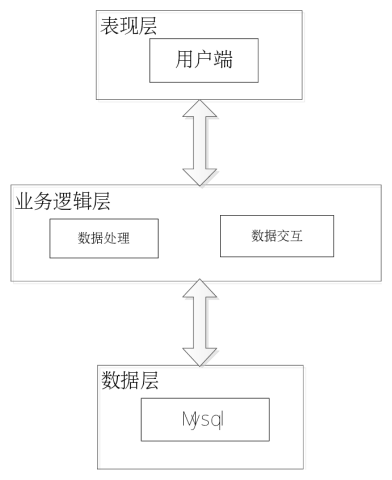
图1 系统架构设计图
系统采用用户端、业务服务层和 MySQL 数据库的分层结构。业务服务层负责数据处理与系统交互,数据库保存用户、汽车数据、资讯、公告和展示内容。
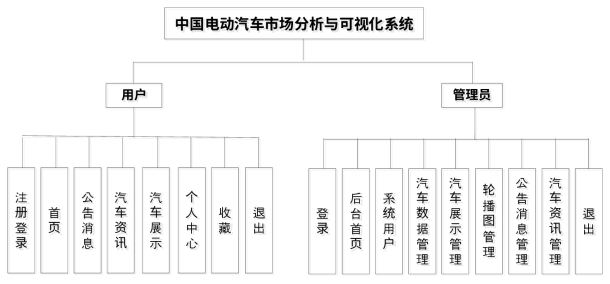
图2 系统功能结构图
七、系统端功能拆解
- 用户端:浏览汽车信息、汽车资讯、公告和可视化结果,维护个人信息。
- 管理员端:管理系统用户、汽车数据、汽车展示、轮播图、公告消息和汽车资讯。
- 数据端:保存原始采集数据、清洗结果、分析指标和展示数据。
八、可视化表达应服务于结论
可视化页面不宜简单堆叠图表。品牌份额适合使用柱状图或环形图,价格分布适合直方图,销量变化适合折线图,车型与品牌对比适合排序条形图,评论关键词则可使用词频排行。每张图都应回答一个明确问题,例如“哪个品牌占比最高”或“哪个价格区间车型最密集”。
九、推断分析与业务建议
在描述性统计之外,项目还可以通过相关分析、回归分析或方差分析研究变量关系,例如价格与热度、续航与用户评价、政策节点与市场变化之间的联系。分析结果可进一步转化为产品定位、渠道拓展、品牌传播和技术改进建议。
十、工程风险与合规边界
- 遵守目标网站的 robots 规则、服务条款和访问频率限制。
- 不采集个人敏感信息,不绕过登录、验证码或访问控制。
- 对数据来源、采集时间和清洗规则进行记录,保证分析可追溯。
- 页面结构变化时启用解析失败告警,避免错误数据进入分析结果。
- 将采集、清洗、分析和展示拆分为独立任务,方便调度和维护。
十一、可继续扩展的方向
后续可以引入定时调度、增量采集、情感分析、品牌趋势预测和交互式仪表盘。对于规模较大的数据集,还可以将清洗与聚合任务迁移到分布式计算平台,并增加数据质量监控和版本管理。
项目总结与资料领取
中国电动汽车市场分析与可视化系统把需求分析、角色权限、业务流程、数据库建模和系统界面串成了一套完整的项目闭环。从毕业设计角度看,它既能够体现框架与数据库的综合应用,也能够展示业务状态、权限隔离和数据管理等工程思维。
需要完整源码、数据库 SQL、部署说明、论文文档及答辩 PPT,可在评论区留言“源码”,按项目名称领取对应资料。
资料内容:爬虫源码、数据清洗脚本、数据库、分析代码、论文与答辩资料




