Linux 进程管理:ps、top、kill、nohup 与信号
运维学习路线系列 · 阶段一 Linux 地基 · 第 6 篇
适用环境:Ubuntu 24.04 LTS,普通用户(有 sudo)
阅读前提:《S1-05》(会看 systemctl status)
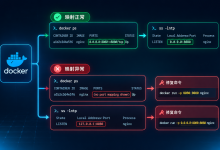
前言:三个经典翻车
这三个问题背后是同三块知识:进程怎么看(ps/top)、进程怎么控(信号)、进程怎么和终端共存亡(nohup/后台)。本篇一次讲透,也是阶段二《性能排查》的前置。
一、进程状态:先认识五个字母
ps / top 里的状态列(S 列)是理解一切的基础:
| R | Running | 正在 CPU 上跑 / 排队等 CPU | CPU 打满时一堆 R |
| S | Sleeping | 等事件(IO、网络、定时),随时可唤醒 | 服务进程的常态,99% 时间在睡觉 |
| D | Uninterruptible Sleep | 不可中断的磁盘 IO 等待 | 🚨 大量 D = 存储有严重问题(阶段二细讲) |
| Z | Zombie | 僵尸:已退出但父进程没"收尸" | 少量无害;大量=父进程程序缺陷 |
| T | Stopped | 被挂起(Ctrl-z 就是它) | 记得 fg 恢复或 kill 掉 |
二、看进程:ps 与 top
2.1 ps:快照
ps -ef # 全格式:UID、PID、PPID、启动时间、命令
ps aux | head -1 # 另一套风格:CPU%、MEM%
ps -ef | grep mysql # 服务排查固定句式
# 三个进阶句式(更精准)
pgrep -a nginx # 直接按名字找 PID(-a 显示完整命令行)
ps -eo pid,ppid,user,%cpu,%mem,stat,cmd –sort=-%cpu | head -10 # CPU 前十
ps -eo pid,ppid,user,%cpu,%mem,stat,cmd –sort=-%mem | head -10 # 内存前十
ps –ppid 1234 # 某进程的所有子进程
PID / PPID 是"父子链":ps -ef 里顺着 PPID 往上捋,能看到进程族谱(比如 nginx master → workers)。孤儿进程会被收养给 PID 1(systemd),所以 systemd 是所有服务的最终"爹"。
2.2 top:实时
top # 默认按 CPU 排
# 进入后的常用交互按键:
# M 按内存排序 P 按CPU排序
# 1 展开每个CPU核心 c 显示完整命令行
# k 交互式 kill q 退出
# -u 用户 只看某用户
头部信息逐行解读(这是性能排查的地基,先混个脸熟):
load average: 2.10, 1.80, 1.50 ← 1/5/15 分钟平均负载(含义阶段二专讲)
%Cpu(s): 3.0 us, 1.2 sy, 0.0 ni, 95.5 id, 0.3 wa …
↑用户态 ↑内核态 ↑空闲 ↑IO等待(高=磁盘瓶颈)
MiB Mem / MiB Swap ← 内存与交换
💡 wa(iowait)高 = CPU 在等磁盘,问题在磁盘不在 CPU——这种"指标会说话"的读法是阶段二的正菜。
2.3 免费仪表盘:htop 与 glances
sudo apt install htop -y && htop
# htop 默认按 CPU 分列、可鼠标点杀、F9 发信号、F6 换排序——服务器常备
三、控进程:信号是唯一的遥控器
kill 不是"杀",是给进程发信号。进程收到信号后自己决定怎么办( TERM 可以被优雅处理,KILL 不能):
| 15 | SIGTERM(kill 默认) | ✅ | “请你退出”(进程可做清理、存盘) | 首选 |
| 9 | SIGKILL | ❌ | 内核直接回收(进程无机会清理) | 最后手段 🚨 |
| 1 | SIGHUP | ✅ | 挂断/重读配置(很多守护进程用它 reload) | nginx -s reload 本质 |
| 2 | SIGINT | ✅ | Ctrl-C | 交互用 |
| 18/19 | CONT/STOP | 19 不可捕获 | 暂停/继续 | 调试用 |
kill 1234 # = kill -15 1234,优雅退出
kill -9 1234 # 强杀,不给清理机会
pkill -f "app.py" # 按完整命令行匹配杀(-f 很重要)
pkill nginx # 按进程名杀掉全部 nginx
killall nginx # 同名全杀(效果类似 pkill)
🚨 kill -9 的三宗罪:① 数据库/编辑类进程没落盘,文件损坏;② 信号不进队列,可能"该收到 TERM 时"你直接掀桌;③ 对 D 状态进程无效(连内核都叫不动它,等 IO 返回吧)。生产动作顺序永远是:TERM → 等几秒确认 → 还不死再 KILL。
四、终端与进程:为什么关了 SSH 它就死
默认情况下,前台进程是终端的"孩子":终端断开(SSH 关闭)会向它发 SIGHUP → 进程退出。三种活下来的姿势:
# ① nohup:免疫挂断信号,输出进 nohup.out
nohup python app.py &
nohup ./job.sh > /data/logs/job.log 2>&1 & # 生产写法:明确日志去向
# ② 后台 + 表格:Ctrl-z 暂停 → bg 转后台 → jobs 查看 → fg 拉回前台
./long_task # Ctrl-z
bg # 后台继续跑
jobs # 看后台任务表 [1]
fg %1 # 拉回前台
# ③ screen/tmux:断线重连不丢现场(服务器长任务首选)
sudo apt install tmux -y
tmux new -s deploy # 开会话
# 里面跑长任务,Ctrl-b d 脱离
tmux attach -t deploy # 重连回来,现场还在
| nohup & | 一次性脚本 | 无交互、看不到实时输出 |
| tmux | 需要中途看/交互的长任务(升级、编译) | 多一层要学 |
| systemd 服务(S1-05) | 常驻业务的正解 | 写 unit 文件 |
💡 判断标准:临时任务用 nohup/tmux,常驻服务必须 systemd——"用 nohup 跑生产服务"是面试官最爱抓的反模式。
五、综合实战:一次"服务假死"处置
现象:网站 502,nginx 在跑但后端 Python 进程疑似卡死。
# ① 找到进程看状态
ps -eo pid,user,stat,%cpu,%mem,cmd | grep app.py
# STAT 是 D? → IO 卡死(查磁盘/网络存储)
# STAT 是 S 但 curl localhost:8080 不响应? → 应用层死锁
# ② 先优雅:发 TERM,给 10 秒
kill <PID> ; sleep 10
ps -p <PID> || echo "已退出"
# ③ 还在才强杀
kill -9 <PID>
# ④ systemd 自动拉起(Restart=always),验证恢复
systemctl status myapp
curl -sI localhost:8080 | head -1
# ⑤ 保留现场复盘:强杀前先把线程栈 dump 下来
cat /proc/<PID>/stack > /data/logs/stack-$(date +%F-%H%M).txt 2>/dev/null
验收标准:能独立完成上述五步;能解释为什么第 ② 步不直接 kill -9;能说出 nohup 和 systemd 各自的适用场景。
六、🚨 避坑清单
| 1 | 上来 kill -9 | 数据损坏、清理未执行 | TERM → 等待 → 再 KILL |
| 2 | pkill python 手滑 | 杀光机器上所有 Python 进程 | 用 pkill -f "完整路径/参数" 精准匹配 |
| 3 | 生产服务用 nohup 跑 | 挂了没人拉、重启不自启 | systemd + Restart=always |
| 4 | nohup 不重定向输出 | nohup.out 膨胀到 GB | > 日志 2>&1 显式重定向 |
| 5 | 对 Z 进程 kill -9 | 杀僵尸本身(它已死) | 处理它的父进程或忽略 |
| 6 | 看到 D 状态进程强杀 | 杀不掉还可能把 IO 憋更死 | 先查底层 IO/存储问题 |
| 7 | Ctrl-z 挂起就关终端 | 任务收到 SIGHUP 死亡 | bg/nohup/tmux 转正再走 |
七、一句话总结
看进程 ps/top 看状态字母,控进程默认 TERM 别急 KILL,长任务 tmux、常驻服务 systemd——进程管理的所有"玄学",都是信号与状态没搞懂。
💬 互动
你有没有 pkill 手滑误杀的经历?或者 nohup 跑生产服务被面试官/主管当场教育?评论区聊聊。
下一篇预告:《S1-07 磁盘与文件系统管理:分区、挂载、LVM 与 inode》——“磁盘还有空间却写不进文件”(inode 耗尽)这种诡异故障,就是它的主场。