/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
文章目录
-
- 1. 四个源,四种频率
- 2. 第一个错配:这份「每日数据」里含着香港居民
- 3. 第二个验证:两个源数的是不是同一批人
- 4. 三张表互相反推:反推出官方没给的那一列
- 5. 第三个错配:一个定义改动,把比值从 3 倍推到 4.8 倍
- 6. 第四个坑:2020—2022 这三年的基数不能用
- 7. 把数拼起来:给出区间,不给一个假精确的数
- 8. 踩坑清单与结论
- 9. 参考链接
1. 四个源,四种频率
| 入境处 | 各口岸每日通关人次(分到达/离开、居民/旅客) | 日 | 2021-01-01 ~ 2026-09-16 |
| 统计处 650-80001 | 按国籍/地区划分的访港旅客人次 | 月 + 年 | 2004-01 ~ 2026-07 |
| 统计处 650-80003 / 80004 | 境内消费开支 / 人均消费 | 年 | 1998 ~ 2025 |
| 天文台 | 公历与农历对照表 | 年 | 逐年一份文本 |
第一件事不是拼,而是先把「中秋是哪一天」从官方表里读出来——查百科容易记错,官方有现成的对照表:
import datetime as dt, re
def parse_midautumn(text):
"""从公历/农历对照表里取出「农历八月十五」对应的公历日期。
表里月初标成 `8th Lunar Month`,之后每天只写农历日号,
所以要先定位八月初一,再往后推 14 天。
"""
first = None
for line in text.splitlines():
m = re.match(r"^\\s*(\\d{4})/(\\d{1,2})/(\\d{1,2})\\s+(\\S.*?)\\s{2,}", line)
if not m:
continue
y, mo, d, lunar = m.group(1), int(m.group(2)), int(m.group(3)), m.group(4).strip()
# 🔴 2004–2011 写小写 `8th Lunar month`,2012 起才改成大写 `Month`
if lunar.lower().startswith("8th lunar month"):
first = f"{y}–{mo:02d}–{d:02d}"
return (dt.date.fromisoformat(first) + dt.timedelta(days=14)).isoformat() if first else None
那行注释不是随手写的。第一版只判断了大写 Month,23 个年份里只有 16 个解析成功——2004 到 2011 那份文本用的是小写。这类「同一份官方数据在不同年份换了大小写」的差异不会报错,只会让一部分年份悄悄消失。
读出来之后,2026 年的中秋是 9 月 25 日,与 1823 公众假期表里的「中秋節翌日 9 月 26 日」对得上。
2. 第一个错配:这份「每日数据」里含着香港居民
入境处的 CSV 里,每一天每个口岸有 4 列人数:香港居民、内地访客、其他访客、合计。做「旅客消费」只能要后两类。
def visitor_arrivals(rows):
"""只取「到达」且只取旅客 —— 这一步决定了后面差几倍。"""
out = defaultdict(int)
for r in rows:
if r["Arrival / Departure"] != "Arrival":
continue
d = dt.datetime.strptime(r["Date"], "%d-%m-%Y").date().isoformat()
out[d] += int(r["Mainland Visitors"] or 0) + int(r["Other Visitors"] or 0)
return out
两个过滤条件都要有。漏掉第一个,到达和离开会被算成两倍;漏掉第二个,香港居民的通勤人次会混进来。
量化一下后者:如果把「合计」这一列直接当旅客数用,与统计处的访港旅客人次相比,比值中位数是 3.325 倍——也就是高估 232%。这不是小数点级别的问题,是量级级别的问题。
这段取数逻辑可以收藏备用 —— 凡是「合计列」与「分类列」并存的官方表,先确认合计里含谁。
3. 第二个验证:两个源数的是不是同一批人
入境处的「到达旅客」和统计处的「访港旅客」,定义上应该是一回事。既然两边都有,就拿来对一次:
2023 年 7 月起的 37 个月,两边最大偏离 0.0122%——基本可以认为数的是同一批人,口径能对齐。
但2023 年 1 月前的 24 个月,比值中位数只有 0.824。同一个指标、同样两个源,在疫情期差了 18%。
这条结论的价值在于:别拿 2021—2022 的数据去外推 2026 年。不是因为「疫情特殊」这种笼统的理由,而是这两个源在那段时间的差值是可测量的 18%。
4. 三张表互相反推:反推出官方没给的那一列
人均消费是按「过夜旅客 / 入境不过夜旅客」分开给的,但人数表里没有这个分类——只有按地区分。
好在三张表之间存在一个恒等式:
消费开支(百万港元)÷ 人均消费(港元)× 1,000,000 = 旅客人数
把 650-80003 的总开支除以 650-80004 的人均消费,就能反推出两类旅客各有多少人,再拿它和 650-80001 的总人数比一比:
def rebuild_counts(exp, cap, arrivals):
"""用两张表反推第三张表,并检查三者是否自洽。"""
out = []
for y in sorted(arrivals):
e1, e2 = exp[y].get(1), exp[y].get(2) # 1=过夜, 2=不过夜
c1, c2 = cap[y].get(1), cap[y].get(2)
if not all(isinstance(x, (int, float)) for x in (e1, e2, c1, c2)):
out.append((y, None, None, None))
continue
n1 = e1 * 1_000_000 / c1
n2 = e2 * 1_000_000 / c2
out.append((y, n1, n2, (n1 + n2) / arrivals[y]))
return out
19 个有完整数据的年份里,偏差全部在 0.21 个百分点以内,其中 11 年不到 0.1 个百分点,2023—2025 三年只有 0.003%—0.011%。
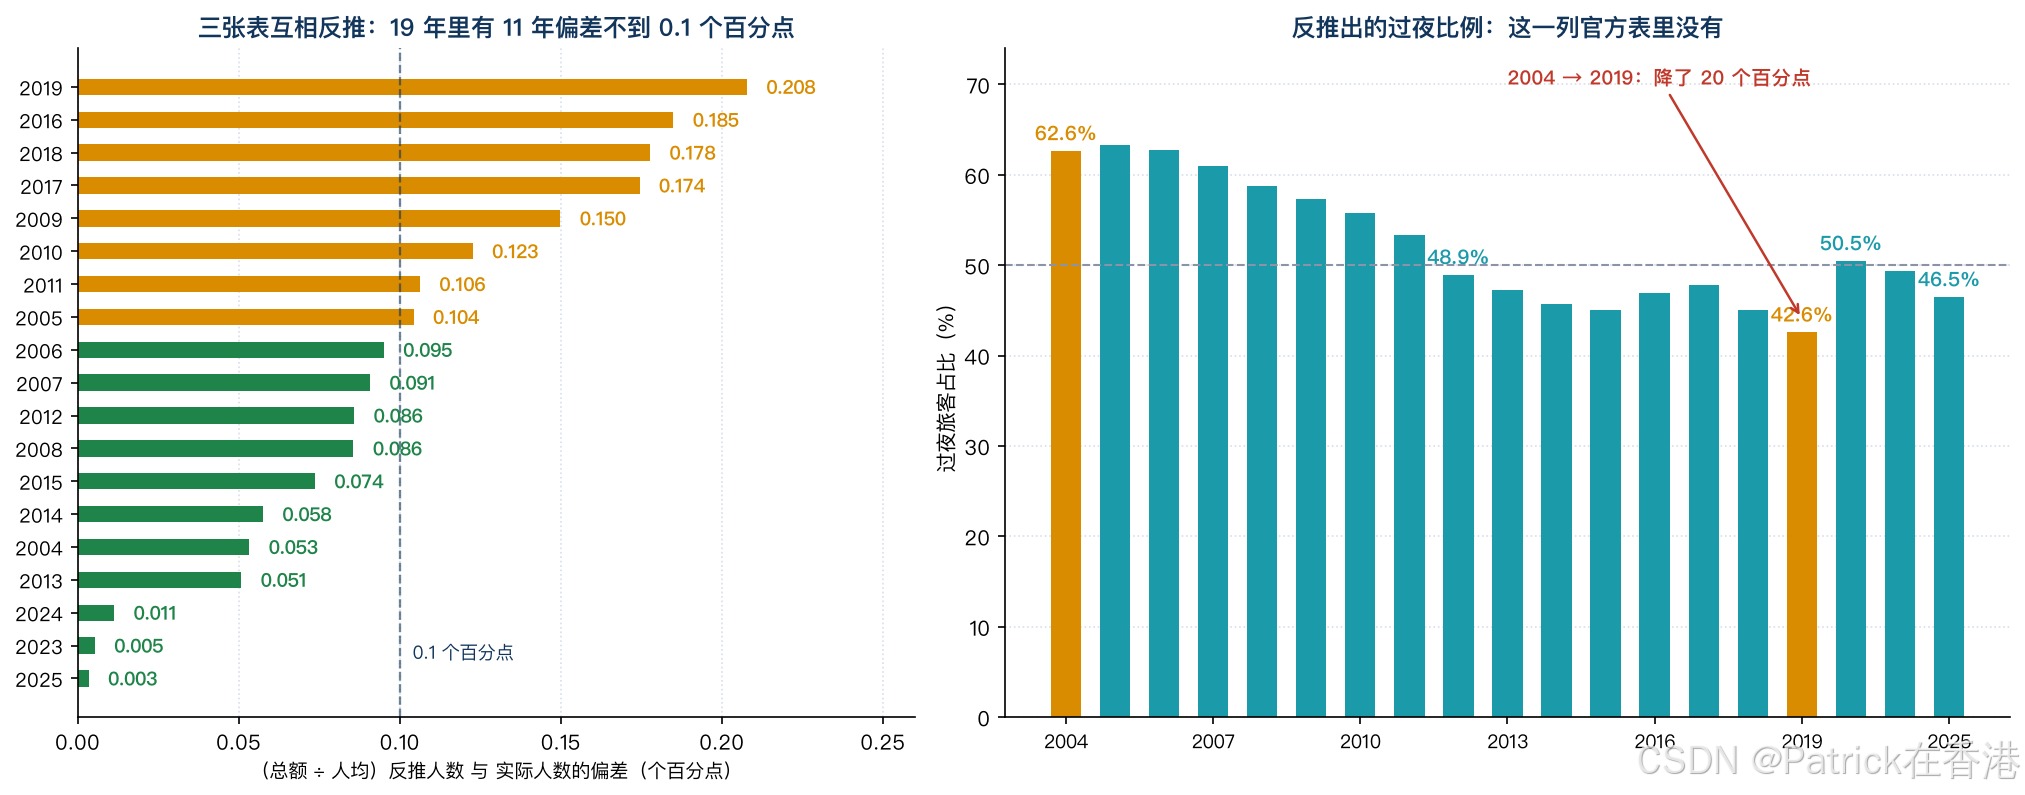
三张独立发布的表能互相对上到这个程度,说明这套调查数据本身是自洽的。
这个「用两张表反推第三张」的写法可以收藏 —— 凡是「总额 = 数量 × 单价」结构的表都能自查一遍。
顺手就得到了一列官方没直接给的数:过夜旅客占比。2004 年是 62.6%,2019 年掉到 42.6%——15 年降了 20 个百分点;2023 年回到 50.5%,2025 年 46.5%。
这十几年里「当天来回、不住一晚」的旅客越来越多。这条趋势对算消费极其关键,因为两类人的花费差着好几倍。
5. 第三个错配:一个定义改动,把比值从 3 倍推到 4.8 倍
现在来看人均消费本身。过夜和不过夜的花费差距,本来是稳定的:
| 2017 | 6,443 | 2,059 | 3.13× |
| 2018 | 6,614 | 2,202 | 3.00× |
| 2019 | 5,818 | 2,004 | 2.90× |
| 2023 | 6,939 | 1,316 | 5.27× |
| 2024 | 5,490 | 1,235 | 4.45× |
| 2025 | 5,503 | 1,139 | 4.83× |
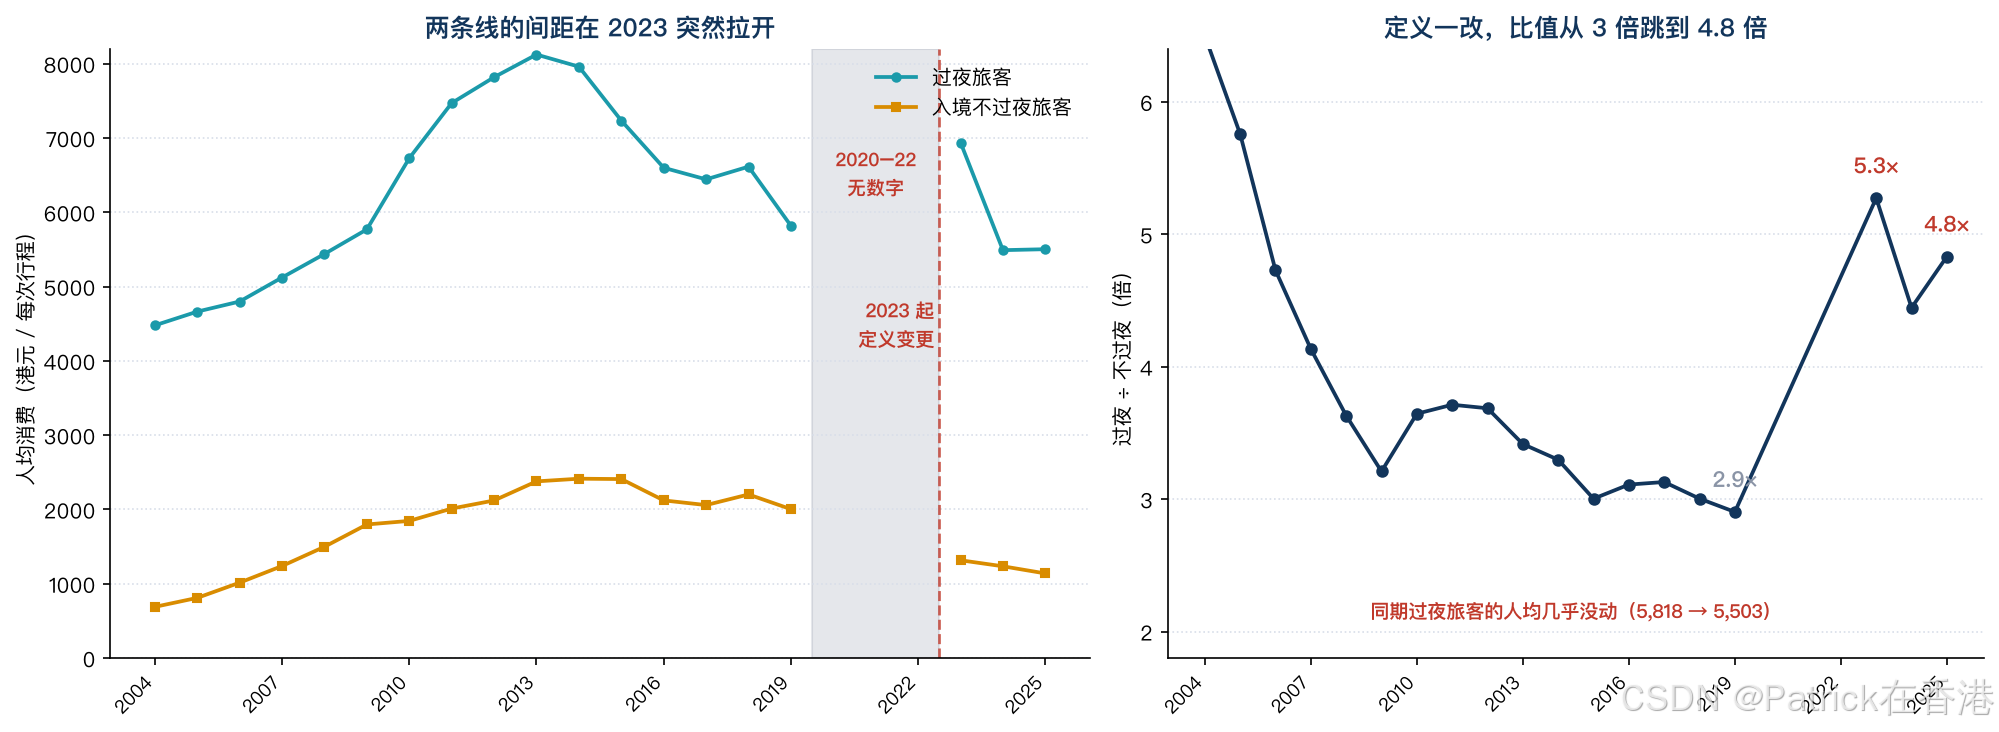
2019 年之前是 2.9—3.1 倍,2023 年之后是 4.5—5.3 倍。中间那三年没有数字,一跳就是 5.27 倍。
原因写在表的脚注里:
「入境不過夜旅客」的定義在 2019 年或以前是指通過香港入境處,但沒有在本港公眾或私人住宿設施過夜的旅客;該定義於 2023 年起修訂為通過香港入境處,但沒有在本港過夜的旅客。
差别在于「住宿设施」四个字被去掉了。旧定义只算「住在公众或私人住宿设施」的才算过夜,露宿、住亲友家、住船上这些都不算;新定义只看「有没有在本港过夜」。
一个定义改动,让不过夜旅客的人均消费从 2,004 港元掉到 1,139 港元,降了 43%。 同期过夜旅客的人均几乎没动(5,818 → 5,503)。
所以:这个序列在 2023 年有一个断点,断点两侧的数字不能直接比。 谁要是拿 2019 年的不过夜人均去估 2026 年,会高估 76%。
6. 第四个坑:2020—2022 这三年的基数不能用
中秋落在 9 月还是 10 月,会让这两个月的人流完全不一样。用「该月旅客数 ÷ 当年 1—7 月均值」来看:
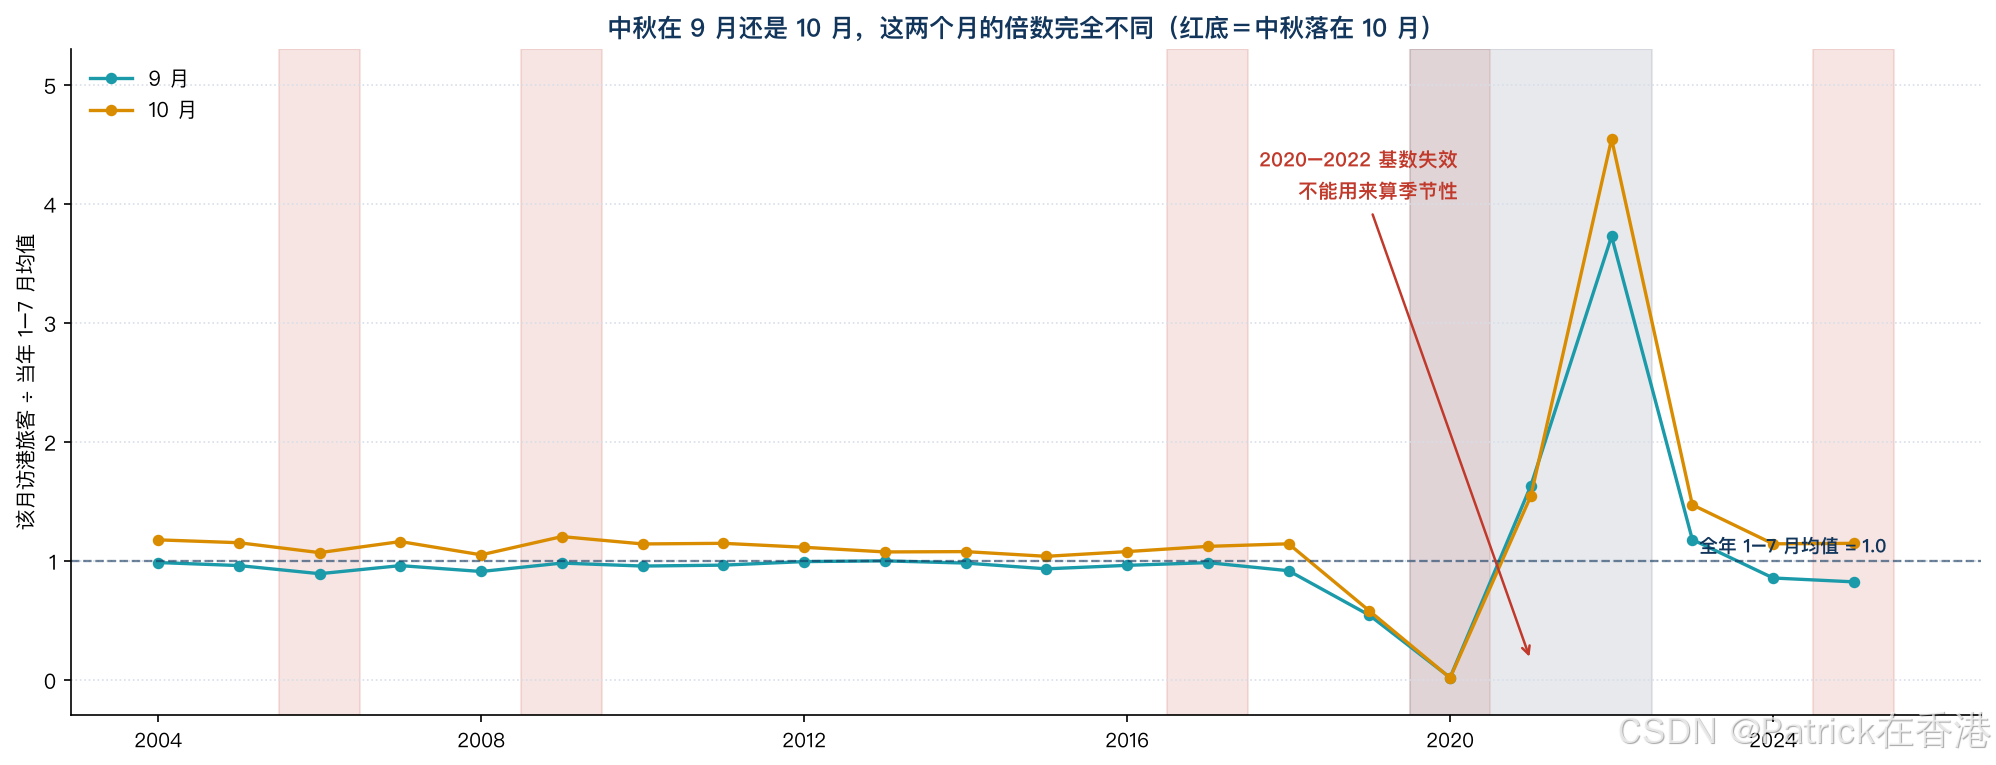
正常年份(2004—2018)这条线非常稳:9 月 0.89—1.00,10 月 1.04—1.20。10 月总是比 9 月高一点,因为国庆假期也在 10 月。
然后:
| 2019 | 0.54 | 0.58 |
| 2020 | 0.02 | 0.02 |
| 2021 | 1.63 | 1.54 |
| 2022 | 3.73 | 4.54 |
| 2023 | 1.18 | 1.47 |
| 2024 | 0.85 | 1.14 |
| 2025 | 0.82 | 1.15 |
2020 年 9 月只有全年月均的 2%,2022 年是 3.73 倍。这两个数字都真实,但都不能进季节性模型——一个是封关,一个是基数太低导致的虚高。
判断「能不能用」的方法很简单:把该月的值除以当年 1—7 月的均值。 落在 0.8—1.2 之外就说明当年的基数不干净,直接排除。这样看,可用的年份是 2004—2018 加 2023—2025。
这个基期筛选判据可以收藏 —— 换成「当月 ÷ 当年已公布月份的均值」,任何月度季节性场景都能套用。
7. 把数拼起来:给出区间,不给一个假精确的数
现在可以算了。2026 年中秋窗口按 9 月 25—27 日三天算,人均消费用最新的 2025 年数据,过夜占比用同一年的 46.5% 加权:
def blend(overnight_share, cap_overnight, cap_same_day):
"""按人数占比把两类人均消费加权成一个数 —— 但它不是「答案」。"""
return overnight_share * cap_overnight + (1 – overnight_share) * cap_same_day
blended = blend(0.4648, 5503, 1139) # 46.5% 的精确值 → 3,167 港元
加权人均 3,167 港元。但请把这三个数一起看:
| 假设全部不过夜(下界) | 1,139 |
| 按 46.5% 加权 | 3,167 |
| 假设全部过夜(上界) | 5,503 |
上下界相差 4.8 倍。 差距这么大,是因为「过夜比例」这一列官方没有给,是我从另外两张表反推出来的,而反推用的是全年比例——中秋三天的比例未必一样(假期短途客通常更多,过夜比例可能更低)。
所以正确的表述是:给出区间而不是点值。这篇文章能负责的部分到此为止——把数据拼对、把口径标清楚、把不确定度算出来;至于「该按哪个口径估」,取决于你想回答什么问题。
8. 踩坑清单与结论
| 拿「合计」当旅客数 | 含香港居民,比值中位数 3.325 → 高估 232% | 只取内地 + 其他访客 |
| 漏掉「到达/离开」过滤 | 同一批人被算两遍 | 先按方向过滤 |
| 用疫情期数据外推 | 两源比值中位数 0.824,差 18% | 只用 2023-07 之后的月份 |
| 跨年比对人均消费 | 2023 定义变更,不过夜人均降 43% | 断点两侧不并列 |
| 直接用该月比值做季节性 | 2020 是 0.02、2022 是 3.73 | 落在 0.8—1.2 之外即排除 |
| 假定农历表格式不变 | 2004—2011 是小写 month | 判断改成不区分大小写 |
| 把加权人均当结论 | 上下界差 4.8 倍 | 输出区间 + 标注不确定度 |
三条:
本文只做公开数据的接入与结构校验,不涉及旅游、消费或投资判断,也不构成投资建议。 全部数字可按文中代码复现。
9. 参考链接
原创声明:本文为原创内容,数据来自香港入境处、政府统计处及香港天文台的公开接口,代码均可直接运行验证,转载请注明出处。
关注不迷路:后续会继续用 Python 拆解香港的公开数据源,把「接口看着规整、拼起来到处是坑」的部分一个个写清楚。