端侧工具启动时先申请一块工作区,界面很快显示“准备完成”;第一次处理日志时却出现额外开销。只测分配函数返回,可能没有覆盖后续首次访问的工作。
这篇用一个小型 C 程序观察两轮逐页写入前后的计数。实际运行环境是 macOS,本机页大小与输出都如实记录;Linux 机制依据官方手册核对,没有把当前结果冒充 Linux 实测。
把分配与访问拆开记录
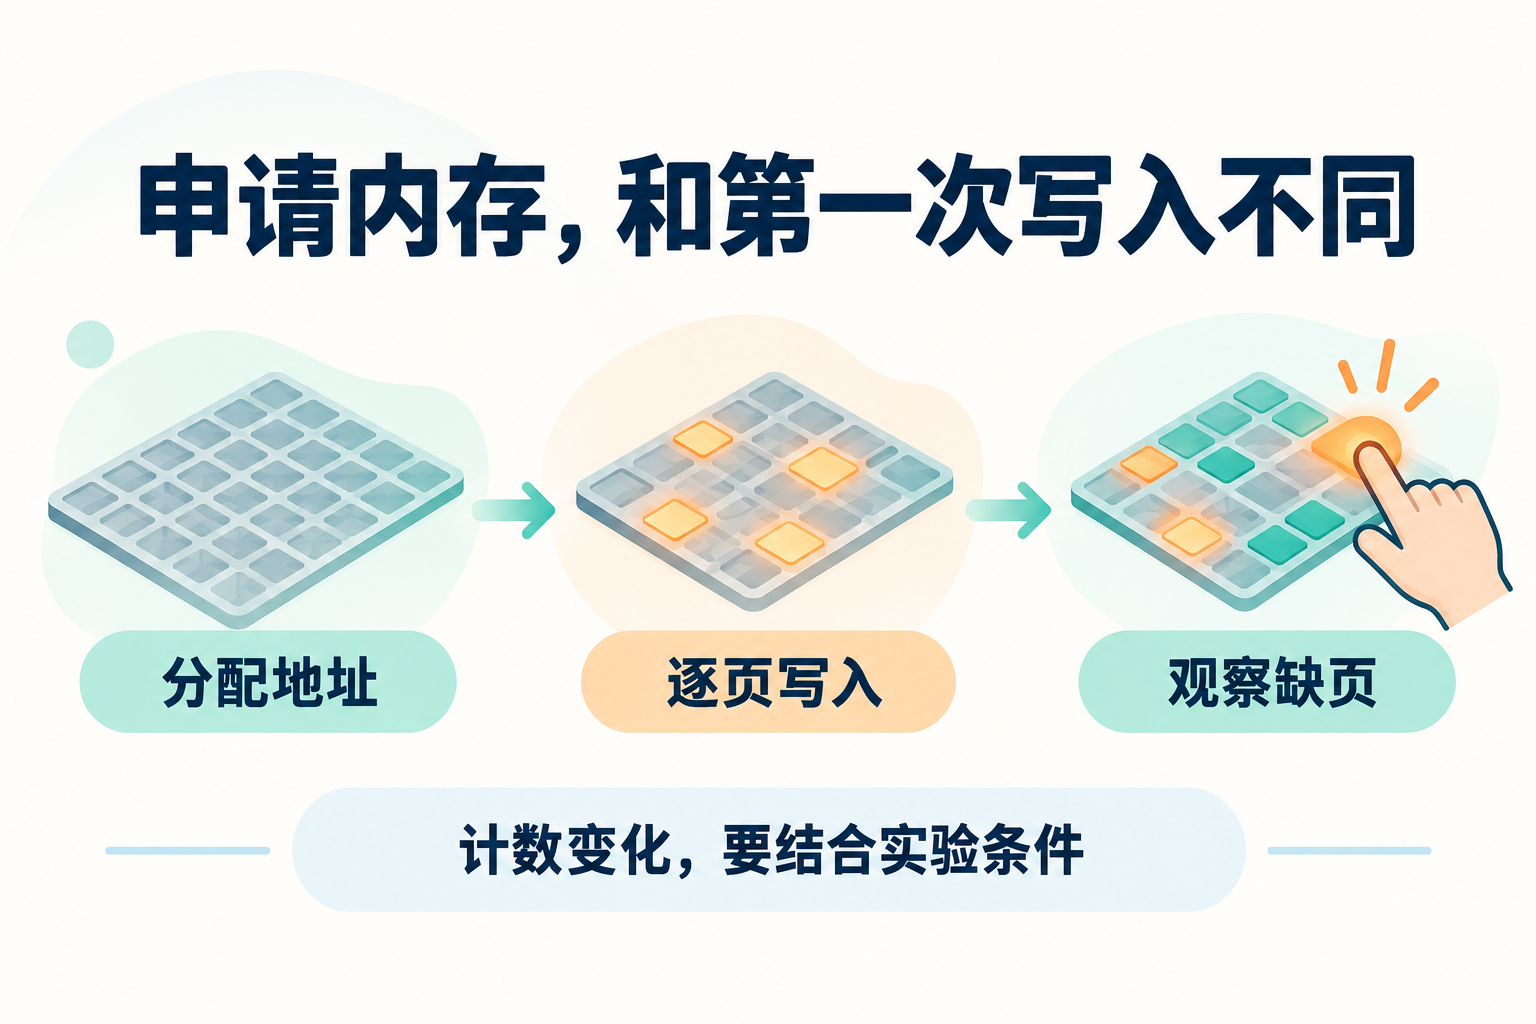
程序申请 4 MiB、清零语义的动态内存,先记录进程 minor fault 计数,再每隔一个本机页写一个字节,记录增量;接着写同一区域第二次,再比较。
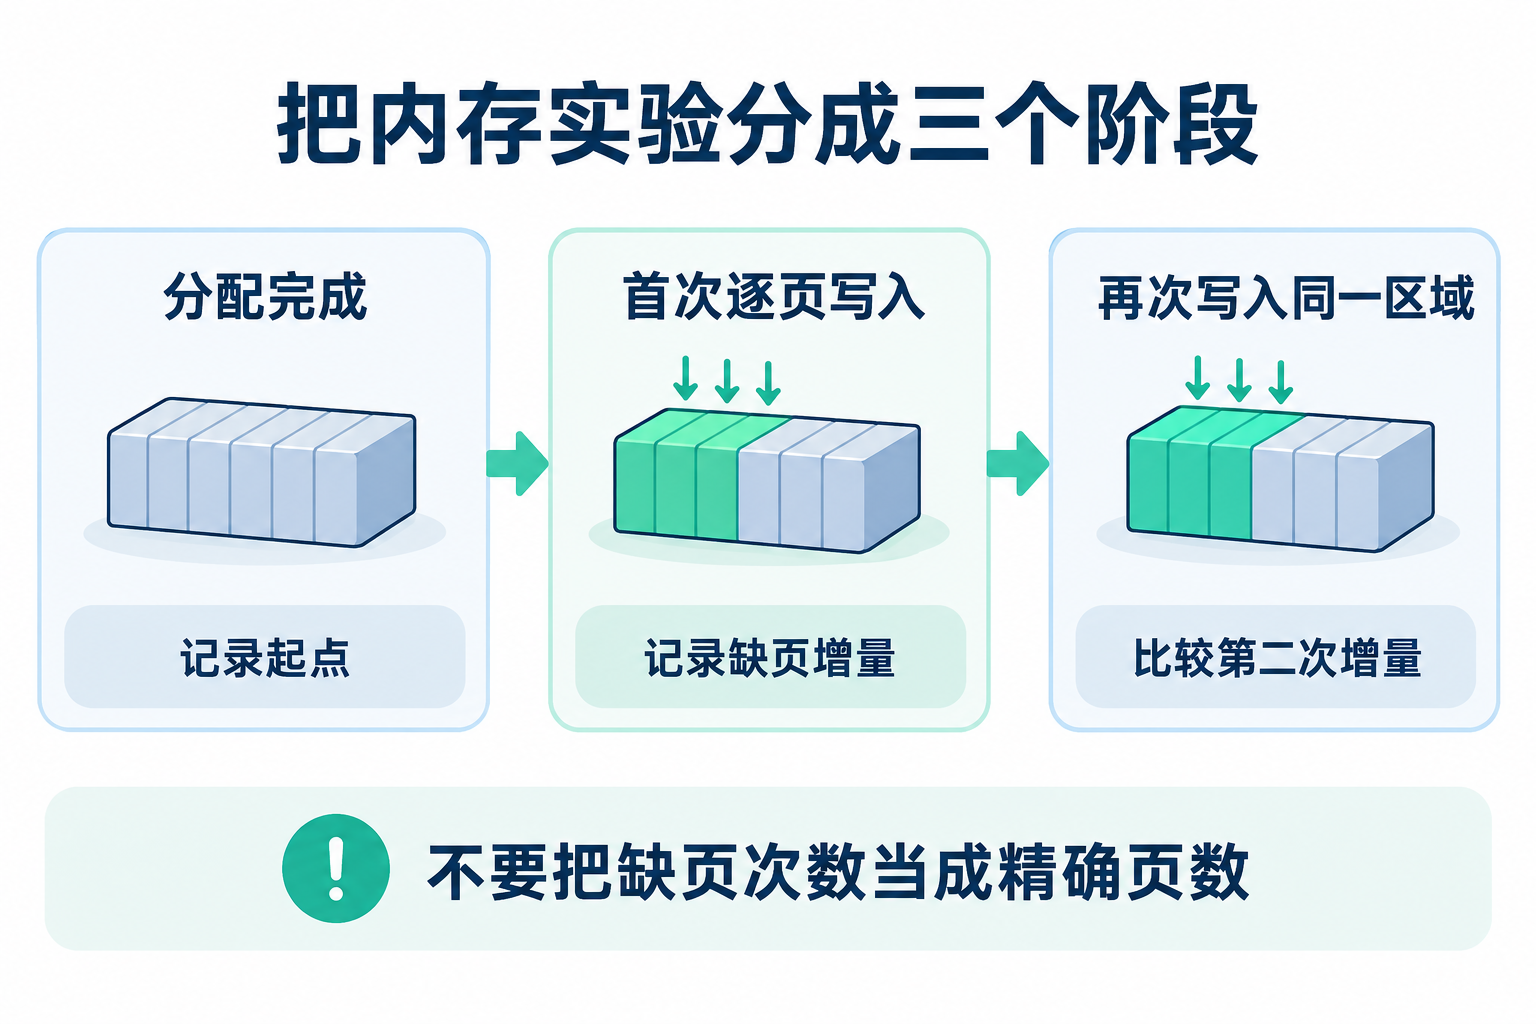
calloc 的接口保证分配区域的零初始化语义,不意味着所有底层准备工作一定在返回前按同一种方式完成。分配器、操作系统与内存状态会影响观察。Linux malloc(3) 可用于核对接口及实现边界。
最小程序保留两个阶段
把以下内容保存为 fault.c,不依赖附件:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>
#include <sys/resource.h>
static long faults(void) {
struct rusage r;
if (getrusage(RUSAGE_SELF, &r)) exit(1);
return r.ru_minflt;
}
int main(void) {
long page = sysconf(_SC_PAGESIZE);
if (page <= 0) return 1;
size_t bytes = 4u * 1024u * 1024u;
volatile unsigned char *p = calloc(bytes, 1);
if (!p) return 2;
long a = faults();
for (size_t i = 0; i < bytes; i += (size_t)page) p[i] = 1;
long b = faults();
for (size_t i = 0; i < bytes; i += (size_t)page) p[i] = 2;
long c = faults();
printf("bytes=%zu page=%ld first_write_minflt=%ld "
"second_write_minflt=%ld\\n", bytes, page, b-a, c-b);
free((void *)p);
return 0;
}
使用已有编译器:
cc -O0 -Wall -Wextra -Werror fault.c -o fault
./fault
本次实际输出为:
bytes=4194304 page=16384 first_write_minflt=256 second_write_minflt=0
这是一次本地观察,没有重复挑选有利结果。程序使用 volatile 保留写入访问,-O0 让这个演示更容易检查;它不是优化后的性能基准,也没有测量写入耗时。
计数说明了什么,没有说明什么
当前这一次,第一次逐页写入伴随 minor fault 增量,第二次没有新增。它与“首次访问和再次访问不同”的实验目标一致,但不能推出所有设备都有相同计数。
Linux getrusage(2) 区分无需 I/O 的缺页与需要 I/O 的缺页,并说明 RUSAGE_SELF 是进程范围统计。本文本地结果来自 macOS,跨平台字段语义和实现仍需单独核对。
统计窗口里不仅有目标区域,调用本身及进程其他活动也可能贡献计数。分配地址未必页对齐,分配器还可能复用已经驻留的区域;大页、预处理与系统压力也会改变结果。所以不要把缺页次数直接当作精确物理页数,更不能据第二轮为零就说“没有内存开销”。
程序只每页写一个字节,没有遍历所有字节,也没有测带宽、缓存命中率或模型推理。图中方格只是阶段示意,不对应这次实测的页数。
为什么不用一行总耗时下结论
如果把分配、第一次访问、第二次访问和释放统统计成一个总时间,很难判断差异来自哪一段。更合适的观察是先按阶段记录,再决定是否需要增加计时、驻留量或系统观测。
在受控 Linux 上重跑时,保存内核、页大小、分配器、编译参数和内存压力条件。若有现成观测工具,可以补充进程级信息;没有就先记录缺失条件,不为了这个例子安装软件。
本次没有 Linux 环境,也没有使用清缓存、改内核设置或制造内存压力的方式。小实验保持资源消耗有限,不能替代目标设备验证。
对端侧工具准备阶段的影响
产品显示“模型就绪”或“缓冲区已分配”,应说明实际完成了什么。分配工作区、加载模型、第一次执行探针,可能是不同阶段。若只完成地址分配,就别把首次任务的成本全部归给模型计算。
是否预先触碰内存,要结合启动时间、资源预算和真实工作负载决定。提前做工作可能把开销移到启动阶段,也可能多占用暂时用不到的资源;本文没有比较这些方案,不提供统一建议。
可以先把准备状态拆清楚,再用目标任务记录阶段耗时与资源变化。这样使用者看到首次任务较慢时,团队有证据解释,而不是用一张没有来源的性能曲线代替测量。
资料与验证范围
- 官方依据:malloc(3)、getrusage(2)。
- 已执行:macOS 现有编译器编译与一次 4 MiB 两轮写入实验;输出如正文记录。
- 未执行:Linux 复现、内存压力、大页控制、性能计时、真实模型、浏览器、真实 API 和生产构建。没有吞吐或启动收益结论。