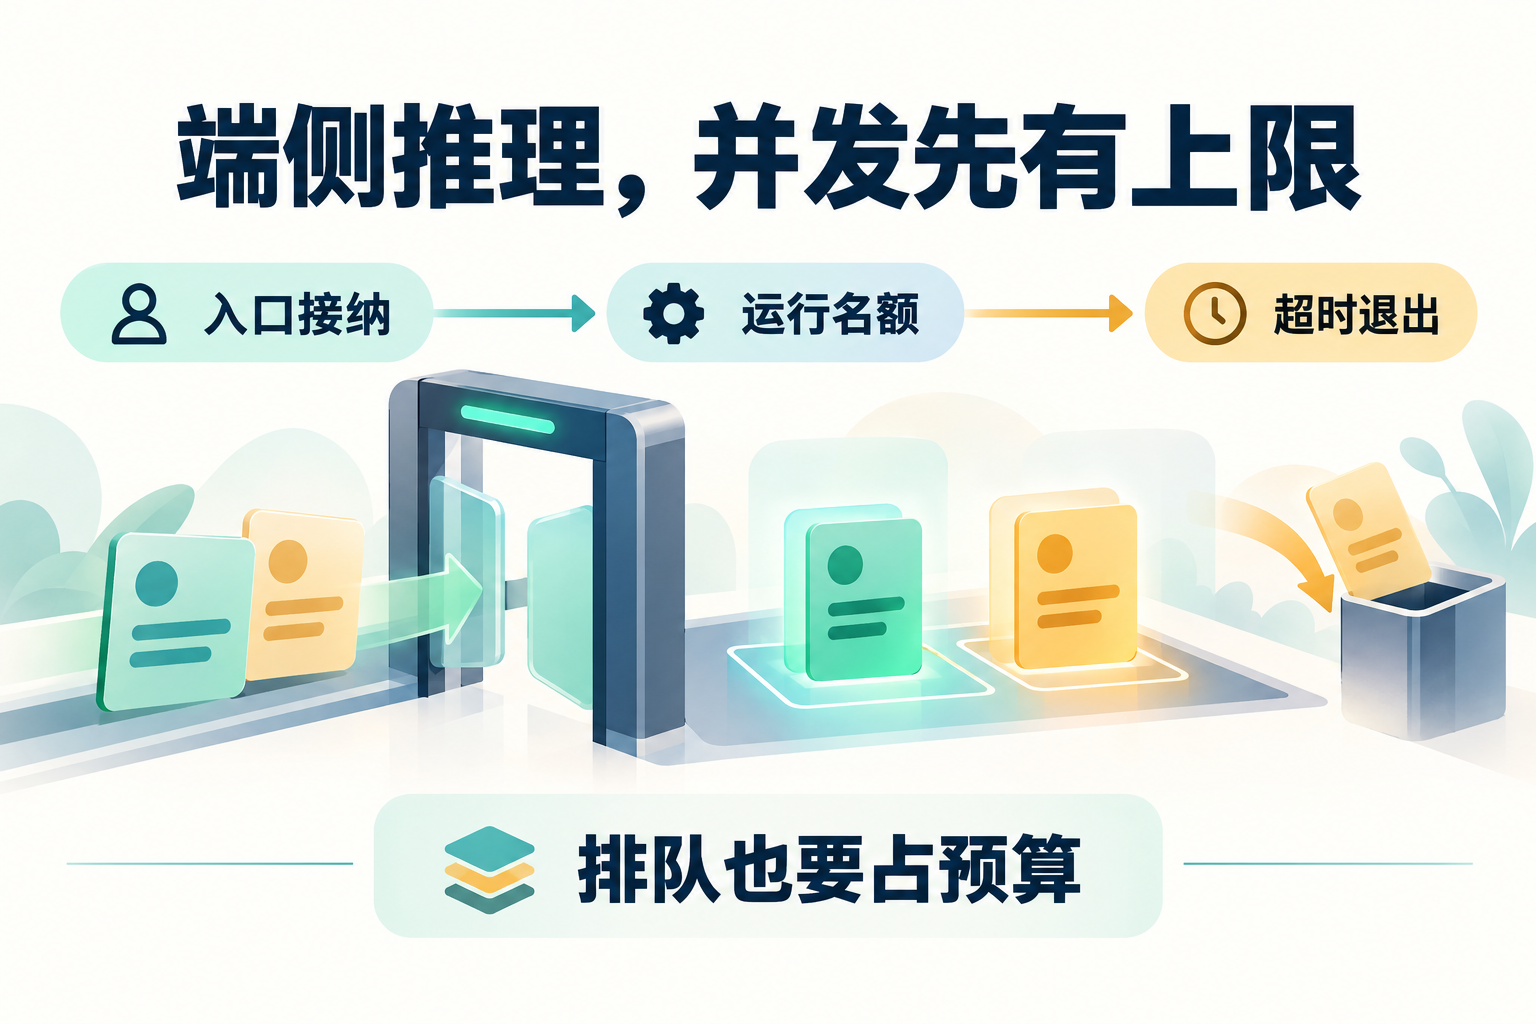
服务只允许一个请求执行推理,外部却可以无限提交。每个等待请求已经带着日志、上下文和回调进入内存,即使模型只有一个在跑,进程也可能撑不住。
并发上限解决运行名额,入口接纳和等待队列还需要各自的边界。下面用单进程 Python 逻辑演示名额管理,没有调用真实模型,也没有测量设备内存。
给每个阶段单独列预算
端侧日志助手可以拆成接收请求、准备材料、等待推理、执行推理和返回结果。限制要放在对应资源分配之前。
| 接收 | 输入字节数与请求数量 | 大日志先全部读进内存 |
| 准备 | 解析与检索任务数 | 多个解析器同时占资源 |
| 等待 | 排队数量、材料大小与有效期 | 队列无限增长 |
| 推理 | 实际运行任务与上下文预算 | 引擎内部仍有另一个队列 |
| 返回 | 缓冲输出及慢客户端 | 生成已结束,结果仍占内存 |
这些限制不是要求第一版同时实现复杂调度。可以先选择“忙碌即拒绝”的简单行为,减少隐含队列,再根据真实需求加入有限等待。
最小名额门要在失败后释放
下面保留一个名额,无等待时直接返回忙碌。run_model 是待接入的运行时接口,代码展示控制层位置,不是可直接运行的推理工程。
from threading import BoundedSemaphore
slots = BoundedSemaphore(1)
def handle(request):
if not slots.acquire(blocking=False):
return {"status": "busy"}
try:
return run_model(request)
finally:
slots.release()
Python 官方 threading 文档说明了有限信号量的语义。选择 BoundedSemaphore 可以发现释放超过初始值的错误,但它不知道推理资源是否实际回收。
本地有限验证没有运行模型:先占住名额,确认第二次获取失败;释放后模拟异常,通过 finally 归还;再确认下一次可获取;最后检查重复释放会抛出 ValueError。断言全部通过。
这个门只约束共享该对象的单进程线程。启动多个服务进程,每个都有独立信号量,总并发就可能成倍增加。若模型由单独进程托管,应把全局接纳策略放在统一入口或可协调的工作池中。
客户端超时,不代表后台推理已经停了
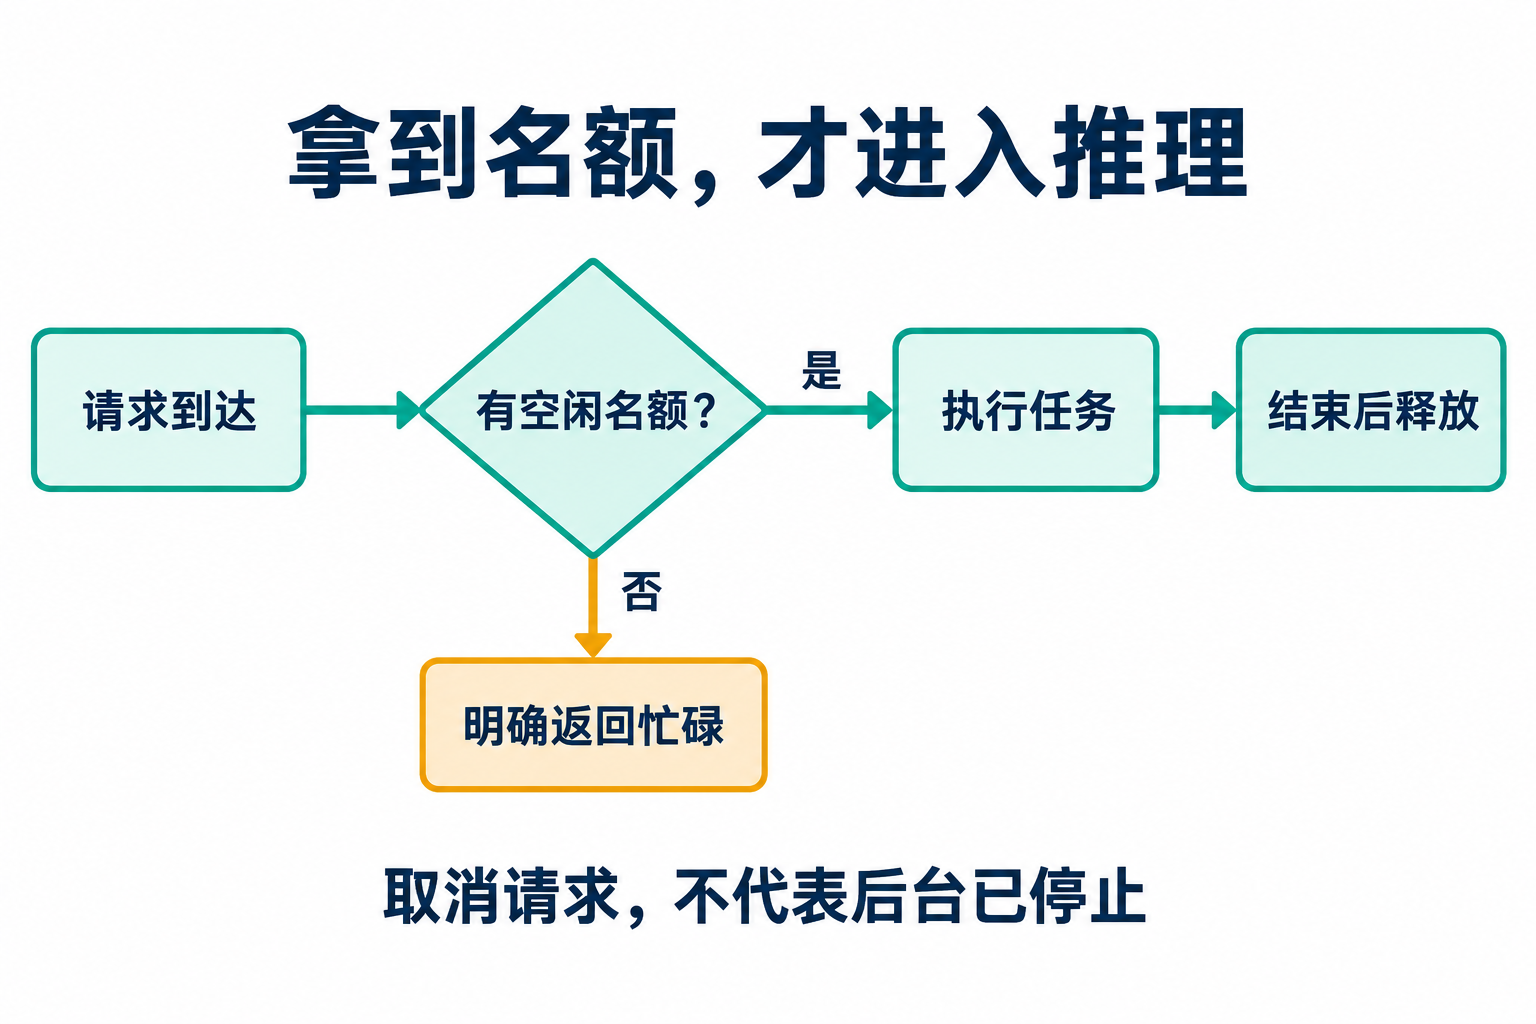
如果 HTTP 请求超时后立即释放名额,模型在后台仍运行,下一个请求就可能与它重叠。应区分“调用者停止等待”和“运行时停止执行”。只有确认任务结束或资源已按协议交还,才释放对应运行名额。
有些运行时支持协作取消,有些只能让工作进程结束。具体行为要查所用引擎并做故障演练。本文没有指定模型运行时,因此不承诺某个取消接口有效,也没有强杀进程的代码。
异常路径还包括输入解析失败、模型加载失败、输出流断开。把每条路径对应的资源写清楚,比简单在最外层加 finally 更可靠。资源释放发生了,不代表用户收到完整结果;结果状态要独立记录。
想要排队,就把排队变成明确功能
有限队列至少需要最大等待数、单项材料上限和过期策略。最好只排一个小型任务引用,材料保存在受控存储中,避免每项都复制完整日志和展开上下文;存储本身也要有配额与清理规则。
请求开始执行前再次检查是否已经取消或过期。过期请求不应再消耗一次模型计算。使用者重试时还要避免同一任务排入多次,否则界面显示一次等待,后台实际有多份工作。
“当前忙碌,稍后重试”应有明确状态,客户端重试采用受控间隔。本文没有实现传输协议,不预设具体 HTTP 状态码或重试秒数。
设备上的上限需要测出来
真实验收先固定设备、模型、上下文与输出长度,分别记录正在运行数、等待数、输入准备耗时、推理耗时和资源峰值。并发数不是越大越好;单任务变慢、内存增加和取消恢复都要一起看。
可以先用假工作任务验证接纳逻辑,再用真实引擎验证生命周期。前者便于稳定制造异常,后者才能发现引擎内部排队和异步释放问题。本文只完成了最小名额逻辑的断言,没有真实吞吐或峰值数据。
对第一版产品,“容量满时说清楚”本身就是可验收行为。无限接收后让所有人一直等,既难维护,也无法判断失败发生在哪个阶段。
资料与验证范围
- 官方依据:threading.BoundedSemaphore。
- 已执行:单进程名额耗尽、异常释放、后续接纳及重复释放拒绝的本地断言。
- 未执行:真实推理、跨进程接纳、有限队列、客户端取消、设备资源测量、浏览器、真实 API 和生产构建。没有安全并发数结论。