/* MD / 富文本中的 .toc(含博客园搬家等嵌套结构);.toc-box 在侧栏,不受影响 */
#content_views .toc,
/* 编辑器常在目录前后插入空 p(:empty 仍占 20px),一并去掉避免顶空隙 */
#content_views.markdown_views > p:empty:has(+ .toc),
#content_views.markdown_views > .toc + p:empty,
/* 富文本旧版目录标记 */
#content_views.htmledit_views #main-toc,
#content_views.htmledit_views #hr-toc,
#content_views.htmledit_views p[id*=\”-toc\”] {
display: none !important;
}
/* 目录去掉后,紧跟的首个标题不再多出一块上边距 */
#content_views.markdown_views > .toc + h1,
#content_views.markdown_views > .toc + h2,
#content_views.markdown_views > .toc + h3,
#content_views.markdown_views > .toc + h4,
#content_views.markdown_views > .toc + p:empty + h1,
#content_views.markdown_views > .toc + p:empty + h2,
#content_views.markdown_views > .toc + p:empty + h3,
#content_views.markdown_views > .toc + p:empty + h4 {
margin-top: 0 !important;
}
1. 一句总纲:上篇讲报文长什么样,这篇讲怎么保证一个字不差地读下来。
2. 请求行三段:只有方法带语义
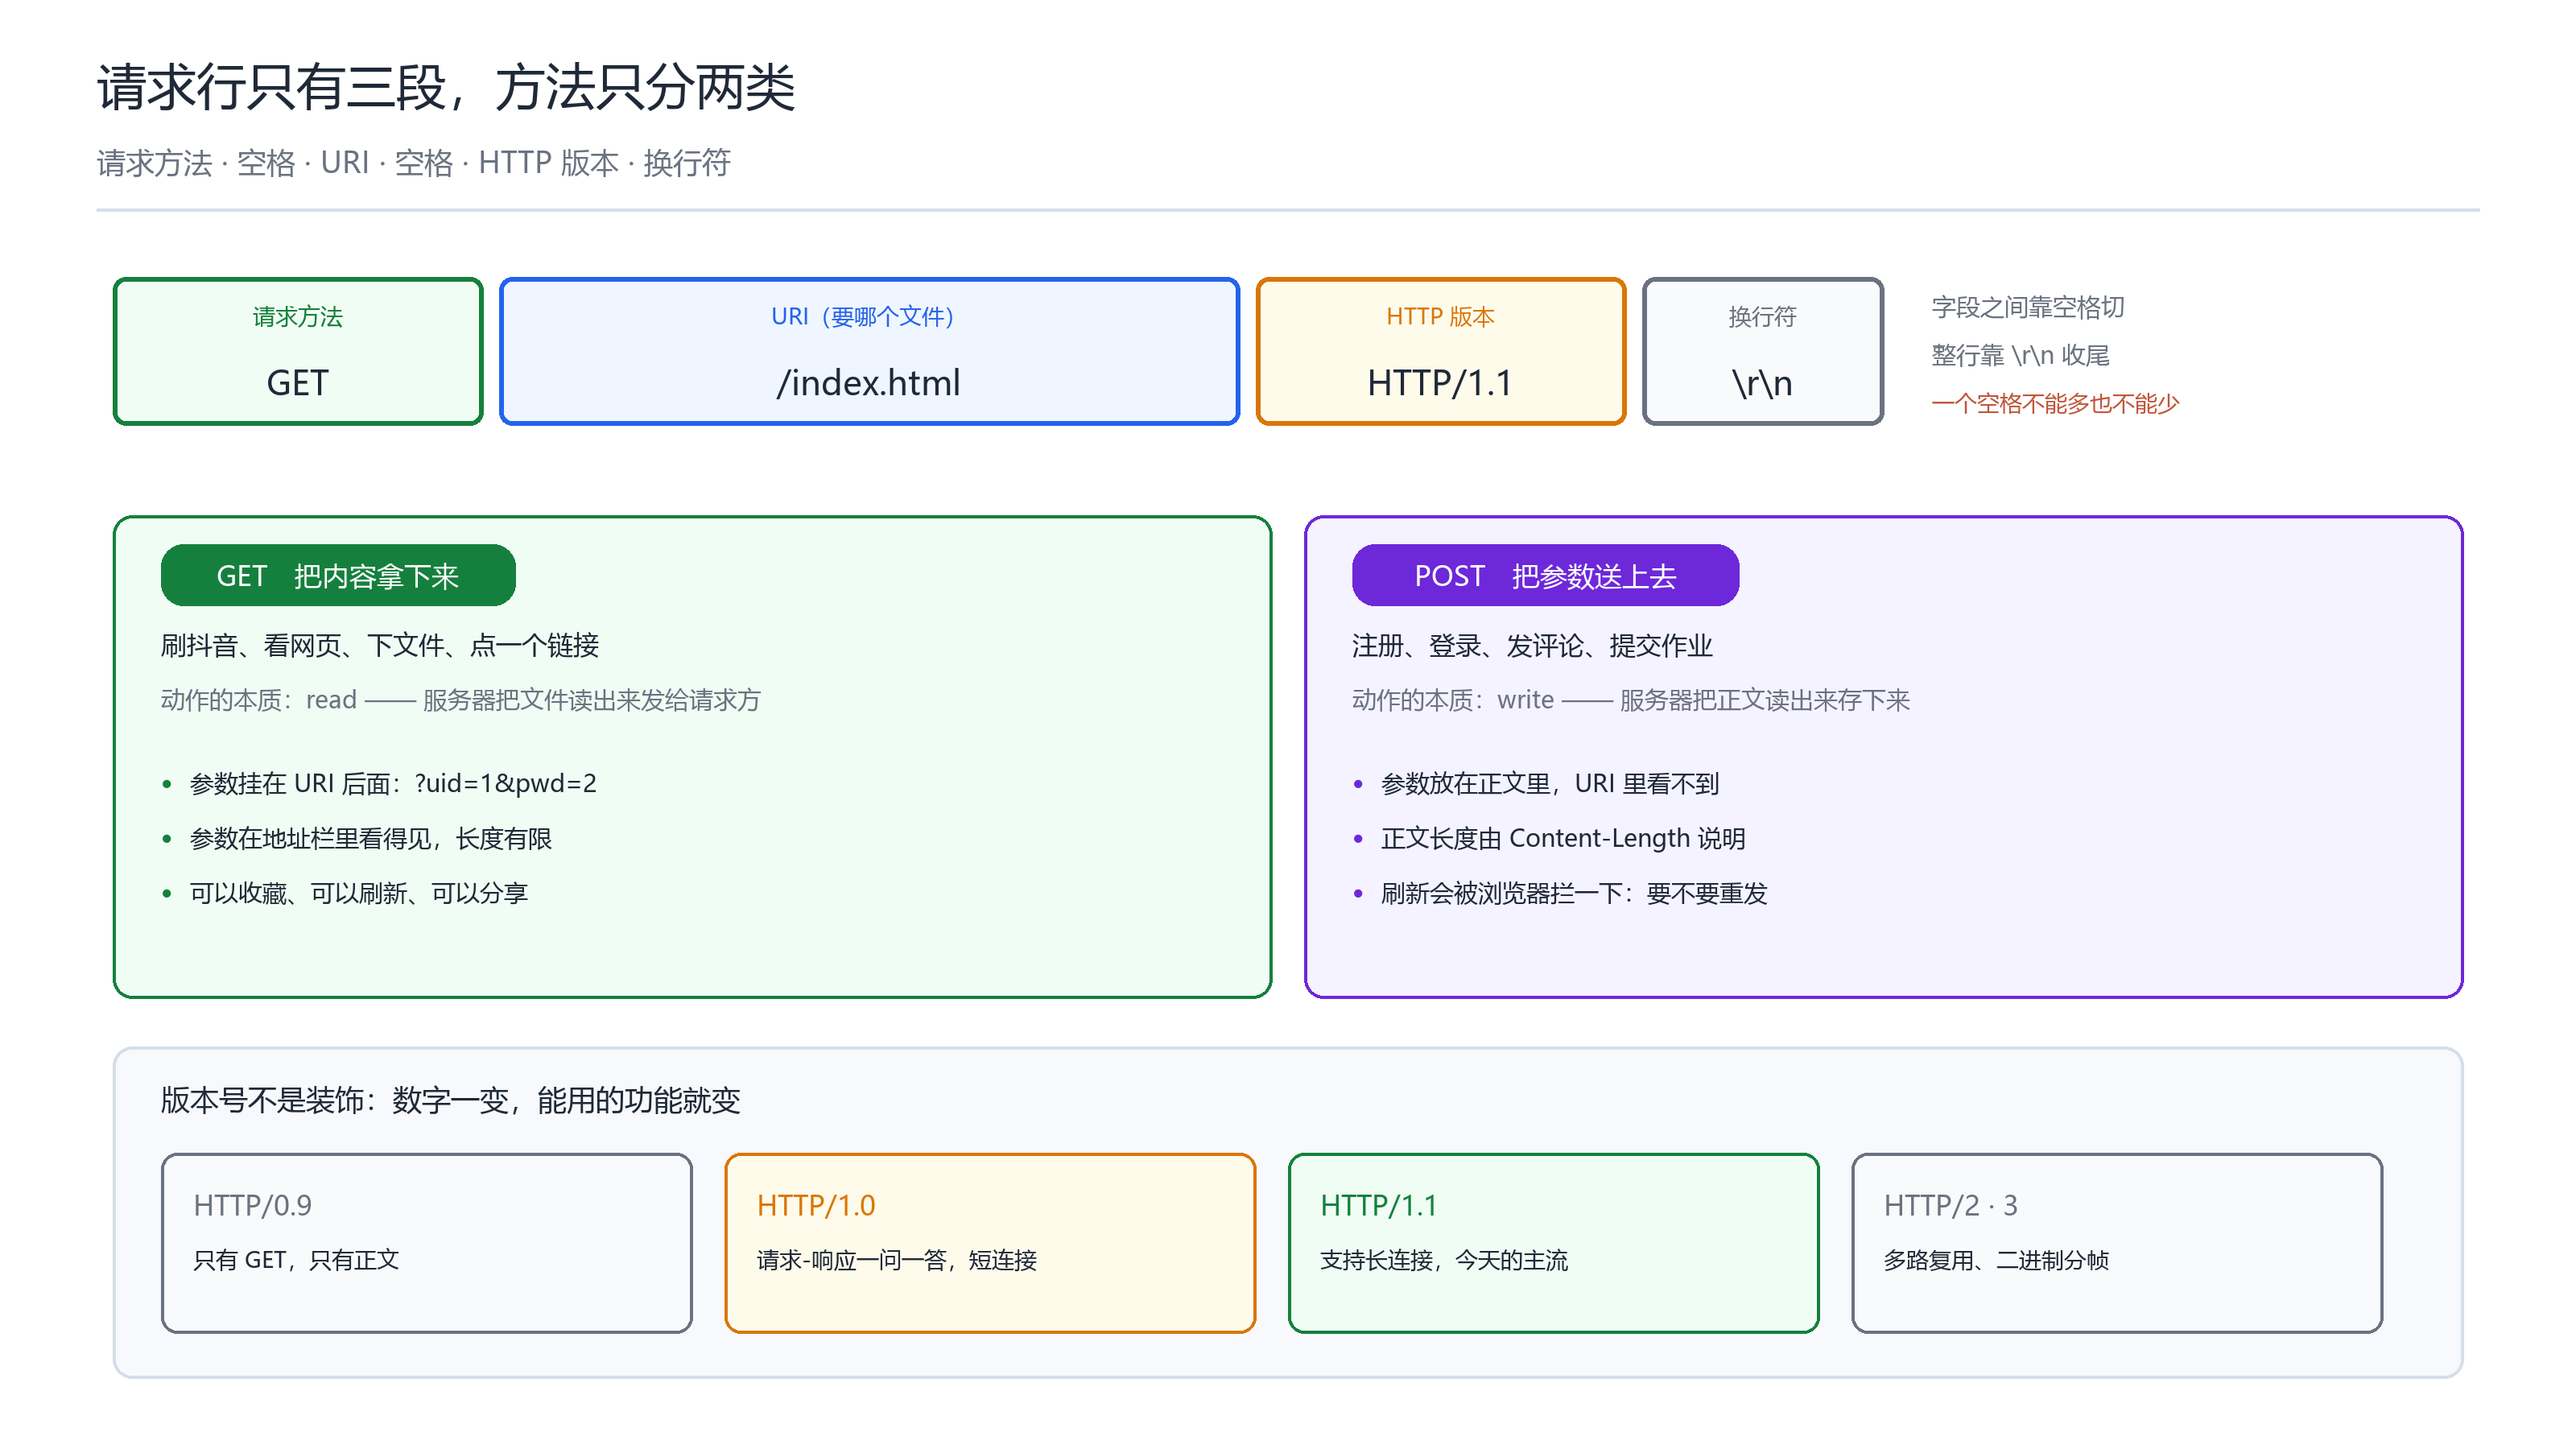
请求行只有一行:
GET /index.html HTTP/1.1\\r\\n
3. GET 与 POST:一个拿下来,一个送上去
上篇有一个结论:人上网只干两件事 —— 把远端的东西拿下来,把本地的东西送上去。方法就是这两件事的名字。
| GET | 从远端获取内容 | read | 刷短视频、看网页、下文件、点链接 |
| POST | 向远端提交参数 | write | 注册、登录、发评论、提交作业 |
判断标准只有一条:这次来,是想让服务器「给出」东西,还是想让它「收下」东西。
- 浏览器访问自己写的服务器,服务器把磁盘上的文件读出来发回去 —— 这是 GET;
- 表单里填了账号口令点提交,服务器把正文读出来存下来 —— 这是 POST。
方法不止两个。规范里还有 PUT、DELETE、HEAD、OPTIONS、TRACE、CONNECT,但真实流量里 99% 就是 GET 和 POST。剩下那些,用一句话概括:一部分极少用,一部分一看名字就懂。
3.1 一个容易记混的点:GET 也能带参数
「GET 不能传参」是错的。GET 的参数挂在 URI 的 ? 后面:
GET /s?wd=%E5%BE%AE%E4%BF%A1 HTTP/1.1
区别不在「能不能传」,而在参数放在哪、谁看得见:
| GET | URI 里,?k=v&k=v | 可见,可收藏可分享 | 受 URI 长度限制 | 直接重发 |
| POST | 正文里 | 不可见 | 由 Content-Length 说明 | 浏览器会问「要不要重新提交」 |
百度搜索用的是 GET(关键词挂在 ?wd= 后面),注册登录用的是 POST(口令放在正文里)。前者要能被分享和收藏,后者不能被看见。
3.2 版本演进:数字一变,能用的功能就变
| HTTP/0.9 | 只有 GET,没有报头 | 历史包袱 |
| HTTP/1.0 | 请求-响应一问一答,短连接 | 讲原理就用这一版 |
| HTTP/1.1 | 支持长连接 keep-alive | 今天的主流 |
| HTTP/2 · 3 | 多路复用、二进制分帧 | 暂时不管 |
上篇讲的「短连接」就是 1.0 的模型:一问一答,答完 close。1.1 的长连接是优化,不是本质。
4. 版本号为什么两边都要写
请求行末尾写 HTTP/1.1,状态行开头也写 HTTP/1.1。同一个版本号写两遍,看起来是冗余,其实是一次协商。
4.1 先承认一个事实:这是两款软件
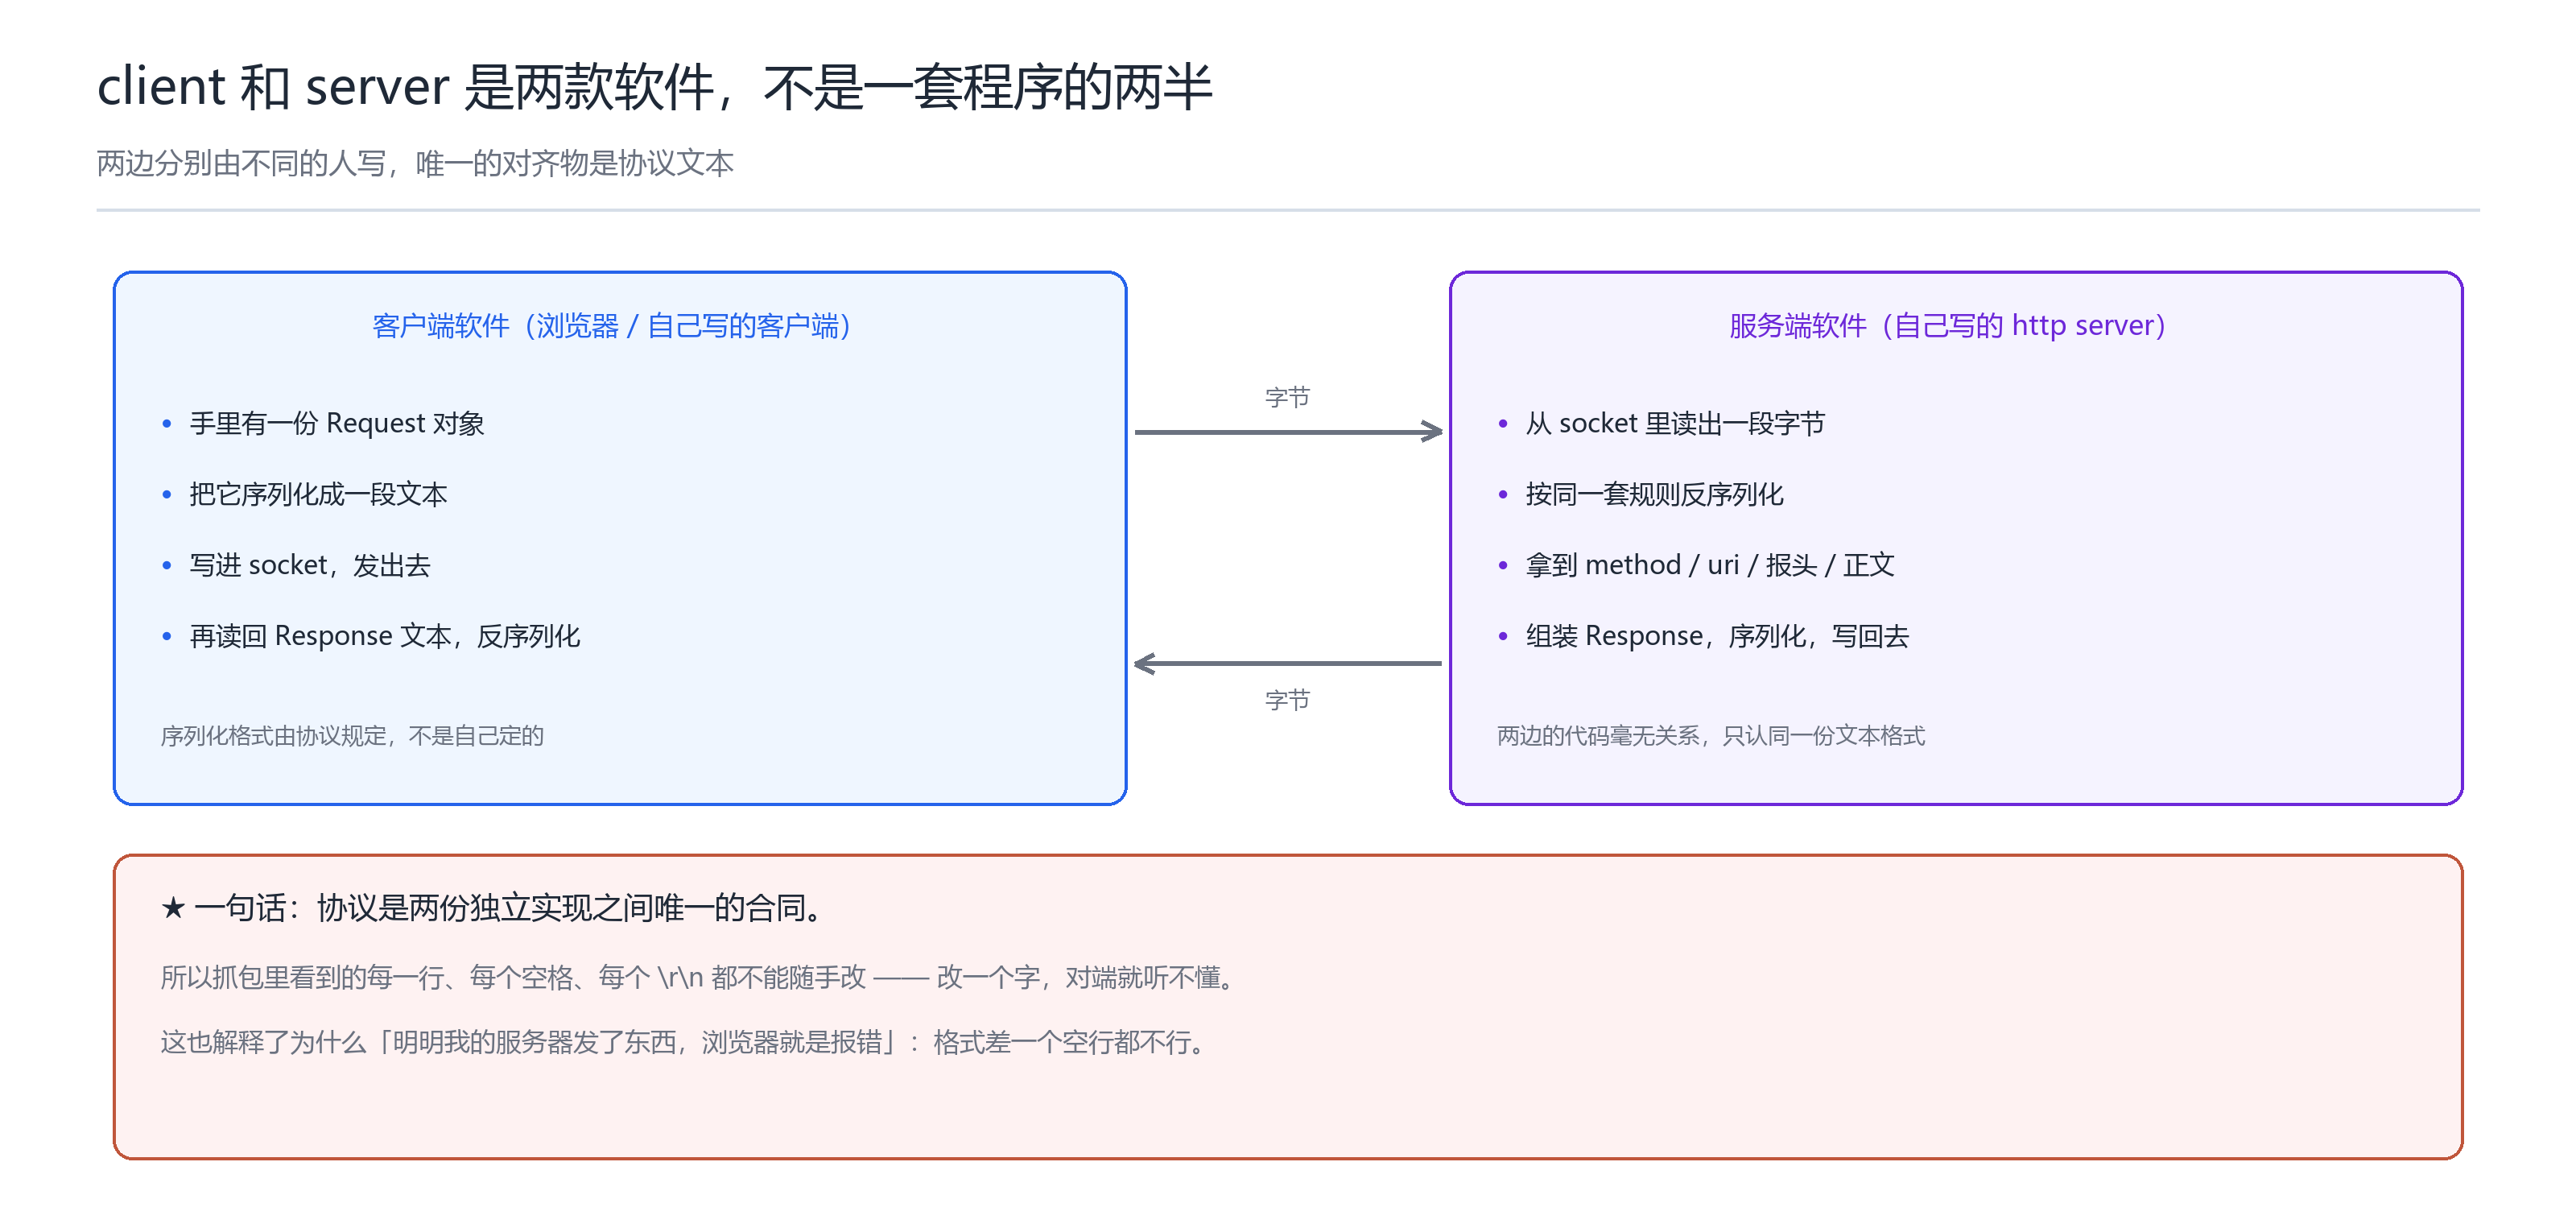
浏览器由浏览器厂商写,服务器由自己写(或者由另一家公司写)。两边代码毫无关系,唯一认的东西是那段纯文本的格式。所以:
- 客户端手里有一个 Request 对象,序列化成文本发出去;
- 服务端从 socket 里读出一段字节,按同一套规则反序列化回来。
协议是两份独立实现之间唯一的合同。 这一句能解释很多现象:改一个空格、少一个 \\r\\n,对端就听不懂;「明明发了东西,浏览器就是报错」,十有八九是格式差了一点。
4.2 再说版本号为什么不能省
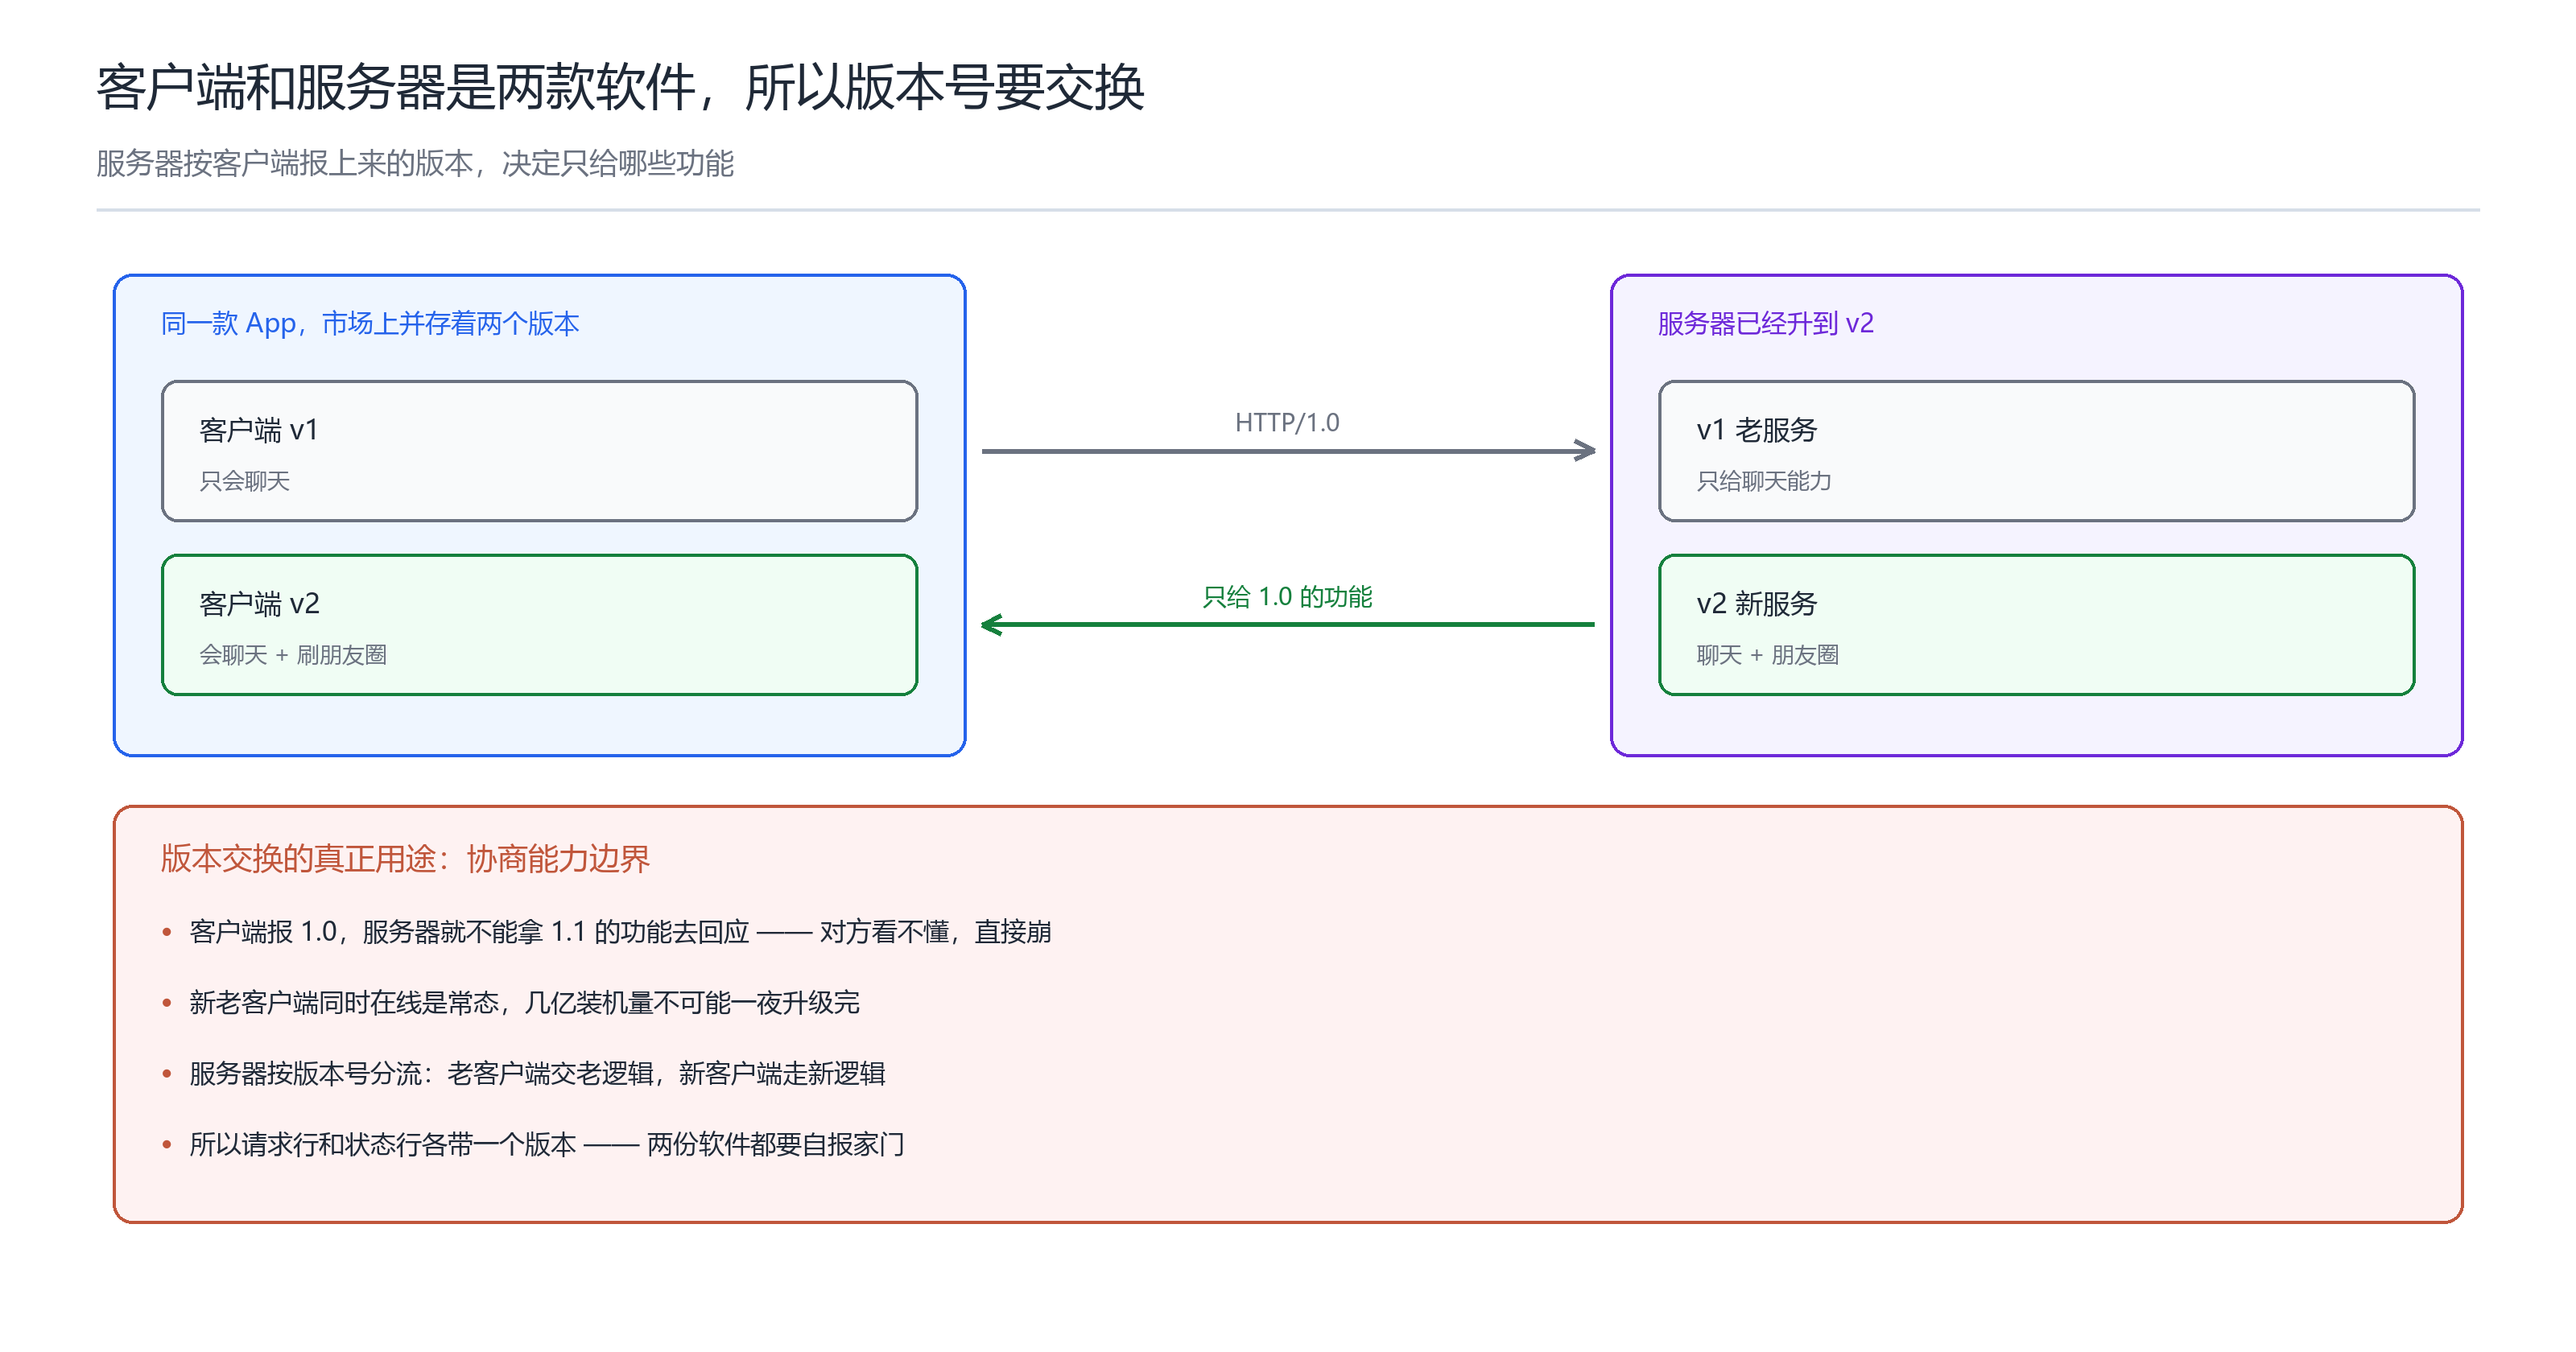
关键前提:客户端的新老版本会同时在线。
所以两边都要报版本:
- 客户端自报 → 服务器知道对面是谁;
- 服务器按版本回流 → v1 客户端只拿到 v1 的功能;
- 状态行里的版本号 → 服务器告诉客户端「按哪一版回的」。
💡 换一个说法:版本号不是装饰,是降级开关。它让新服务端能同时伺候新老客户端,而不需要客户端一夜之间全部升级。
5. 字节流不认报文边界
到这里还没碰到真正的麻烦。麻烦在于:recv 返回的那一段字节,跟报文没有任何对齐关系。
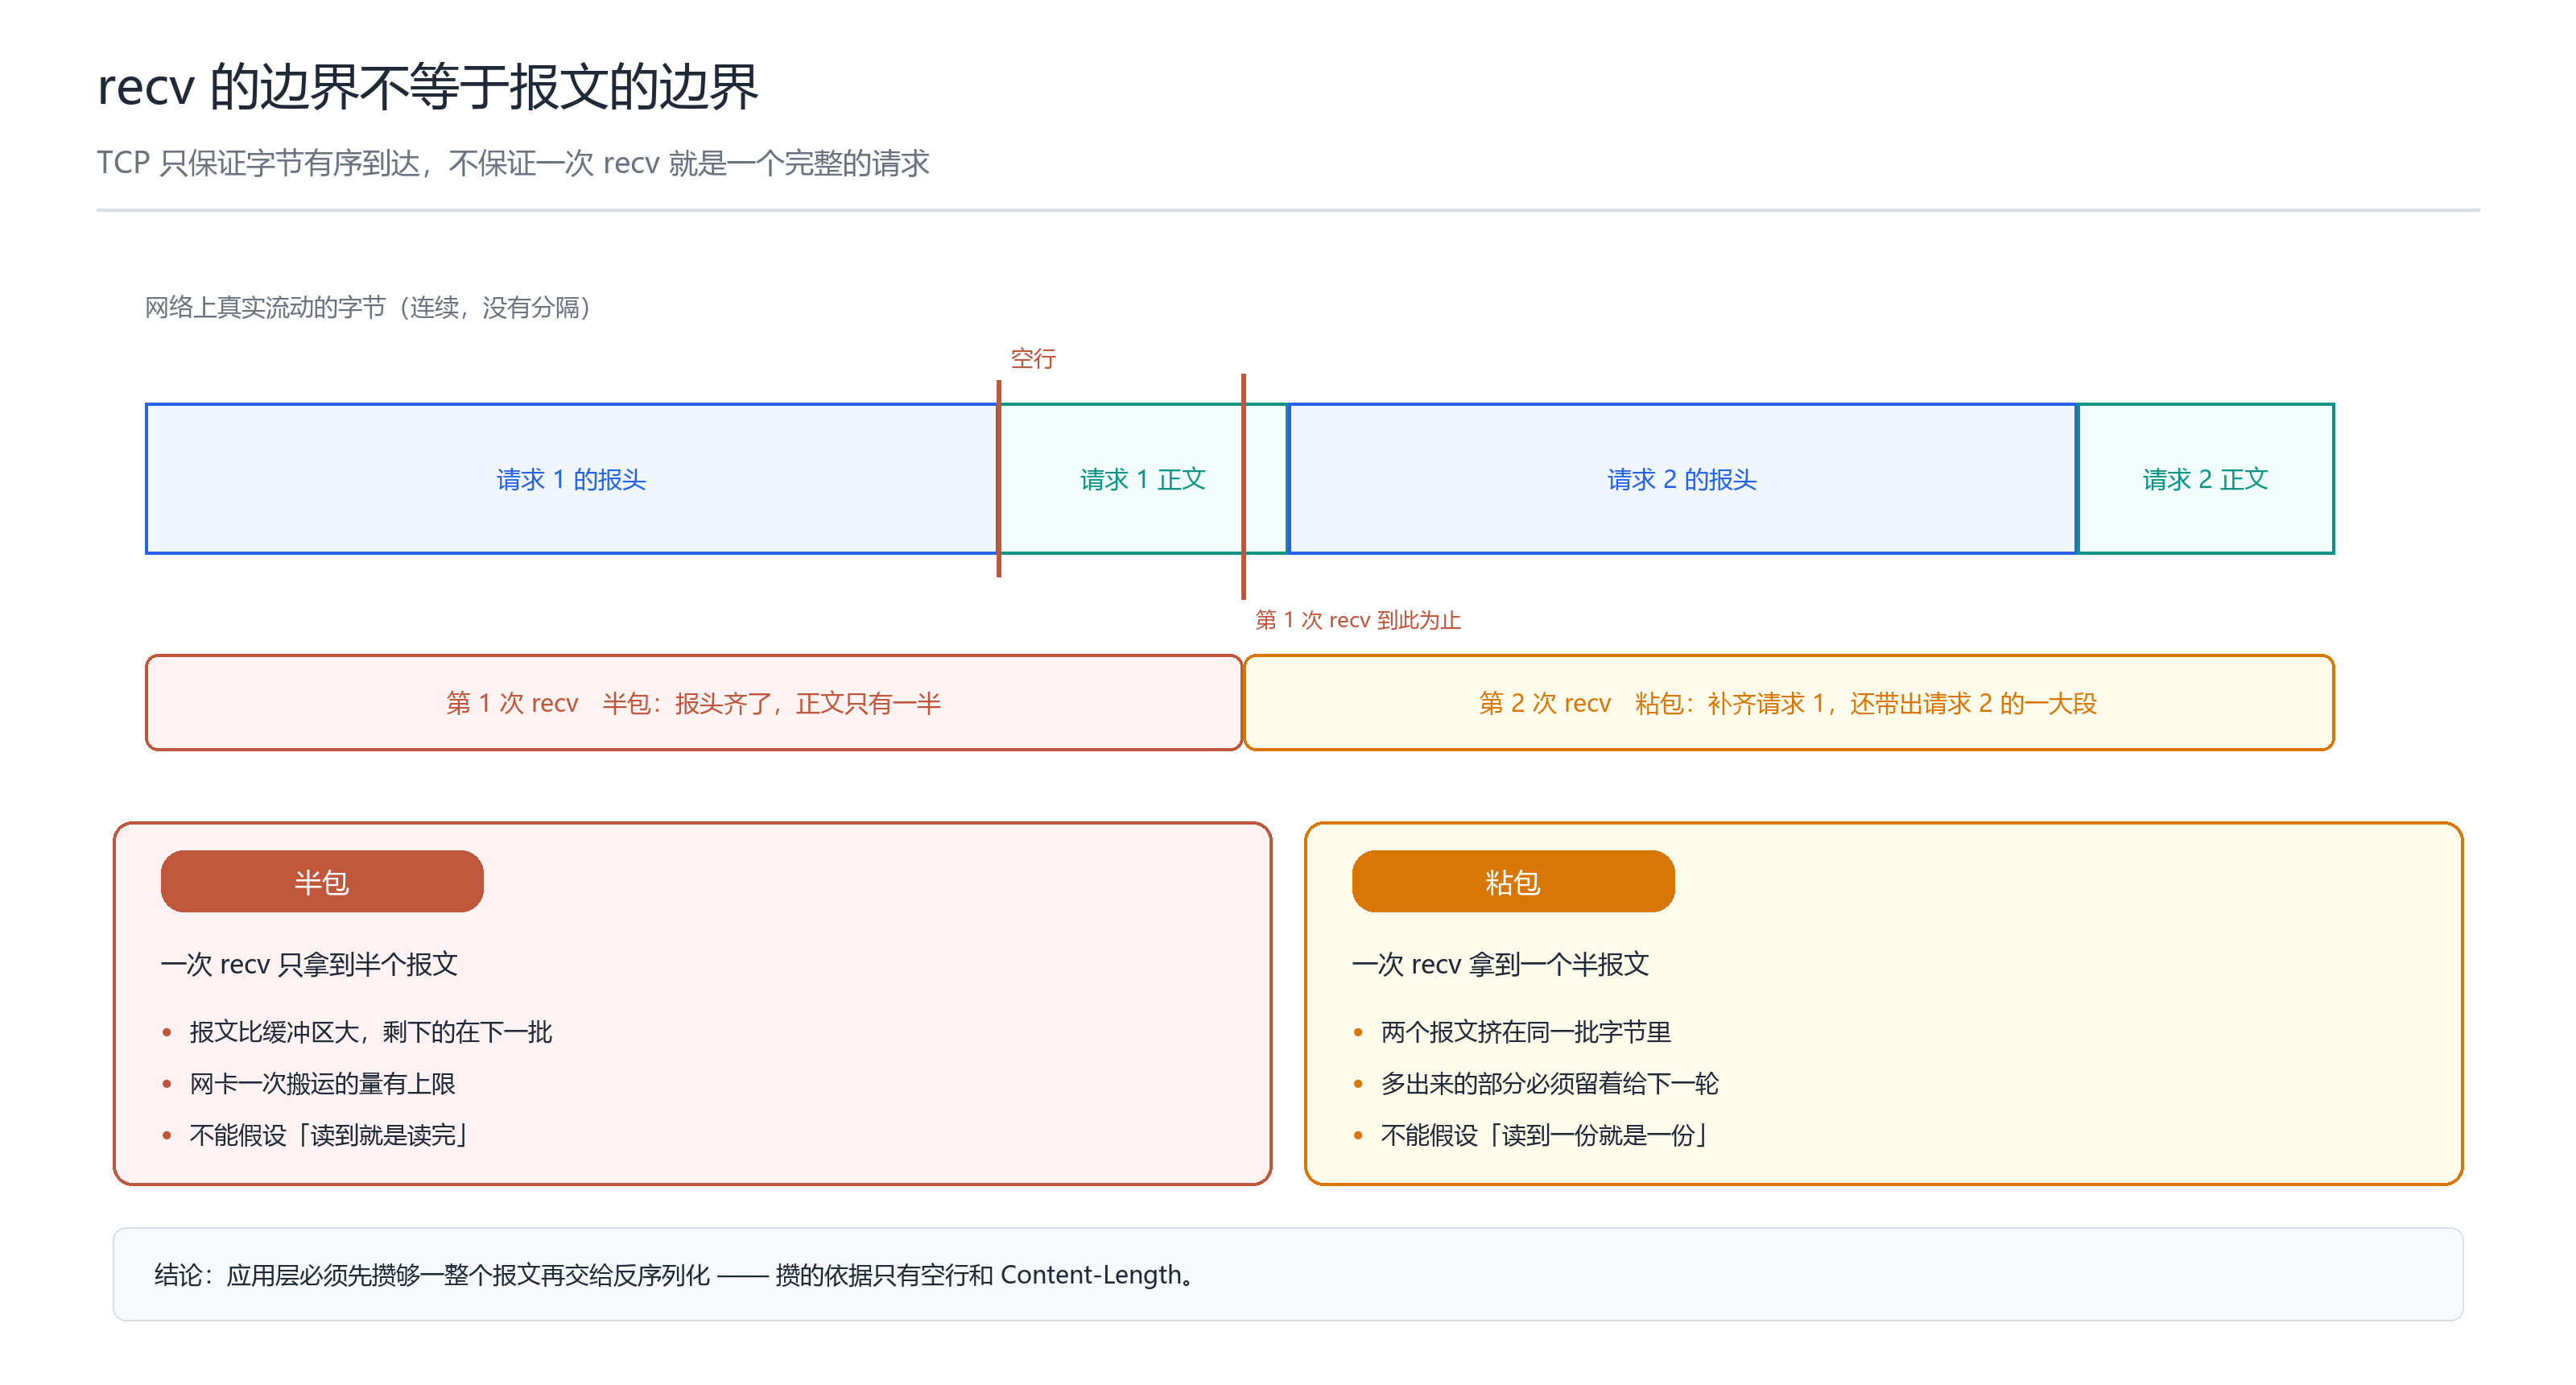
6. 想要读全一个请求,则需要三步:
恢复的依据只有两个:空行和 Content-Length。
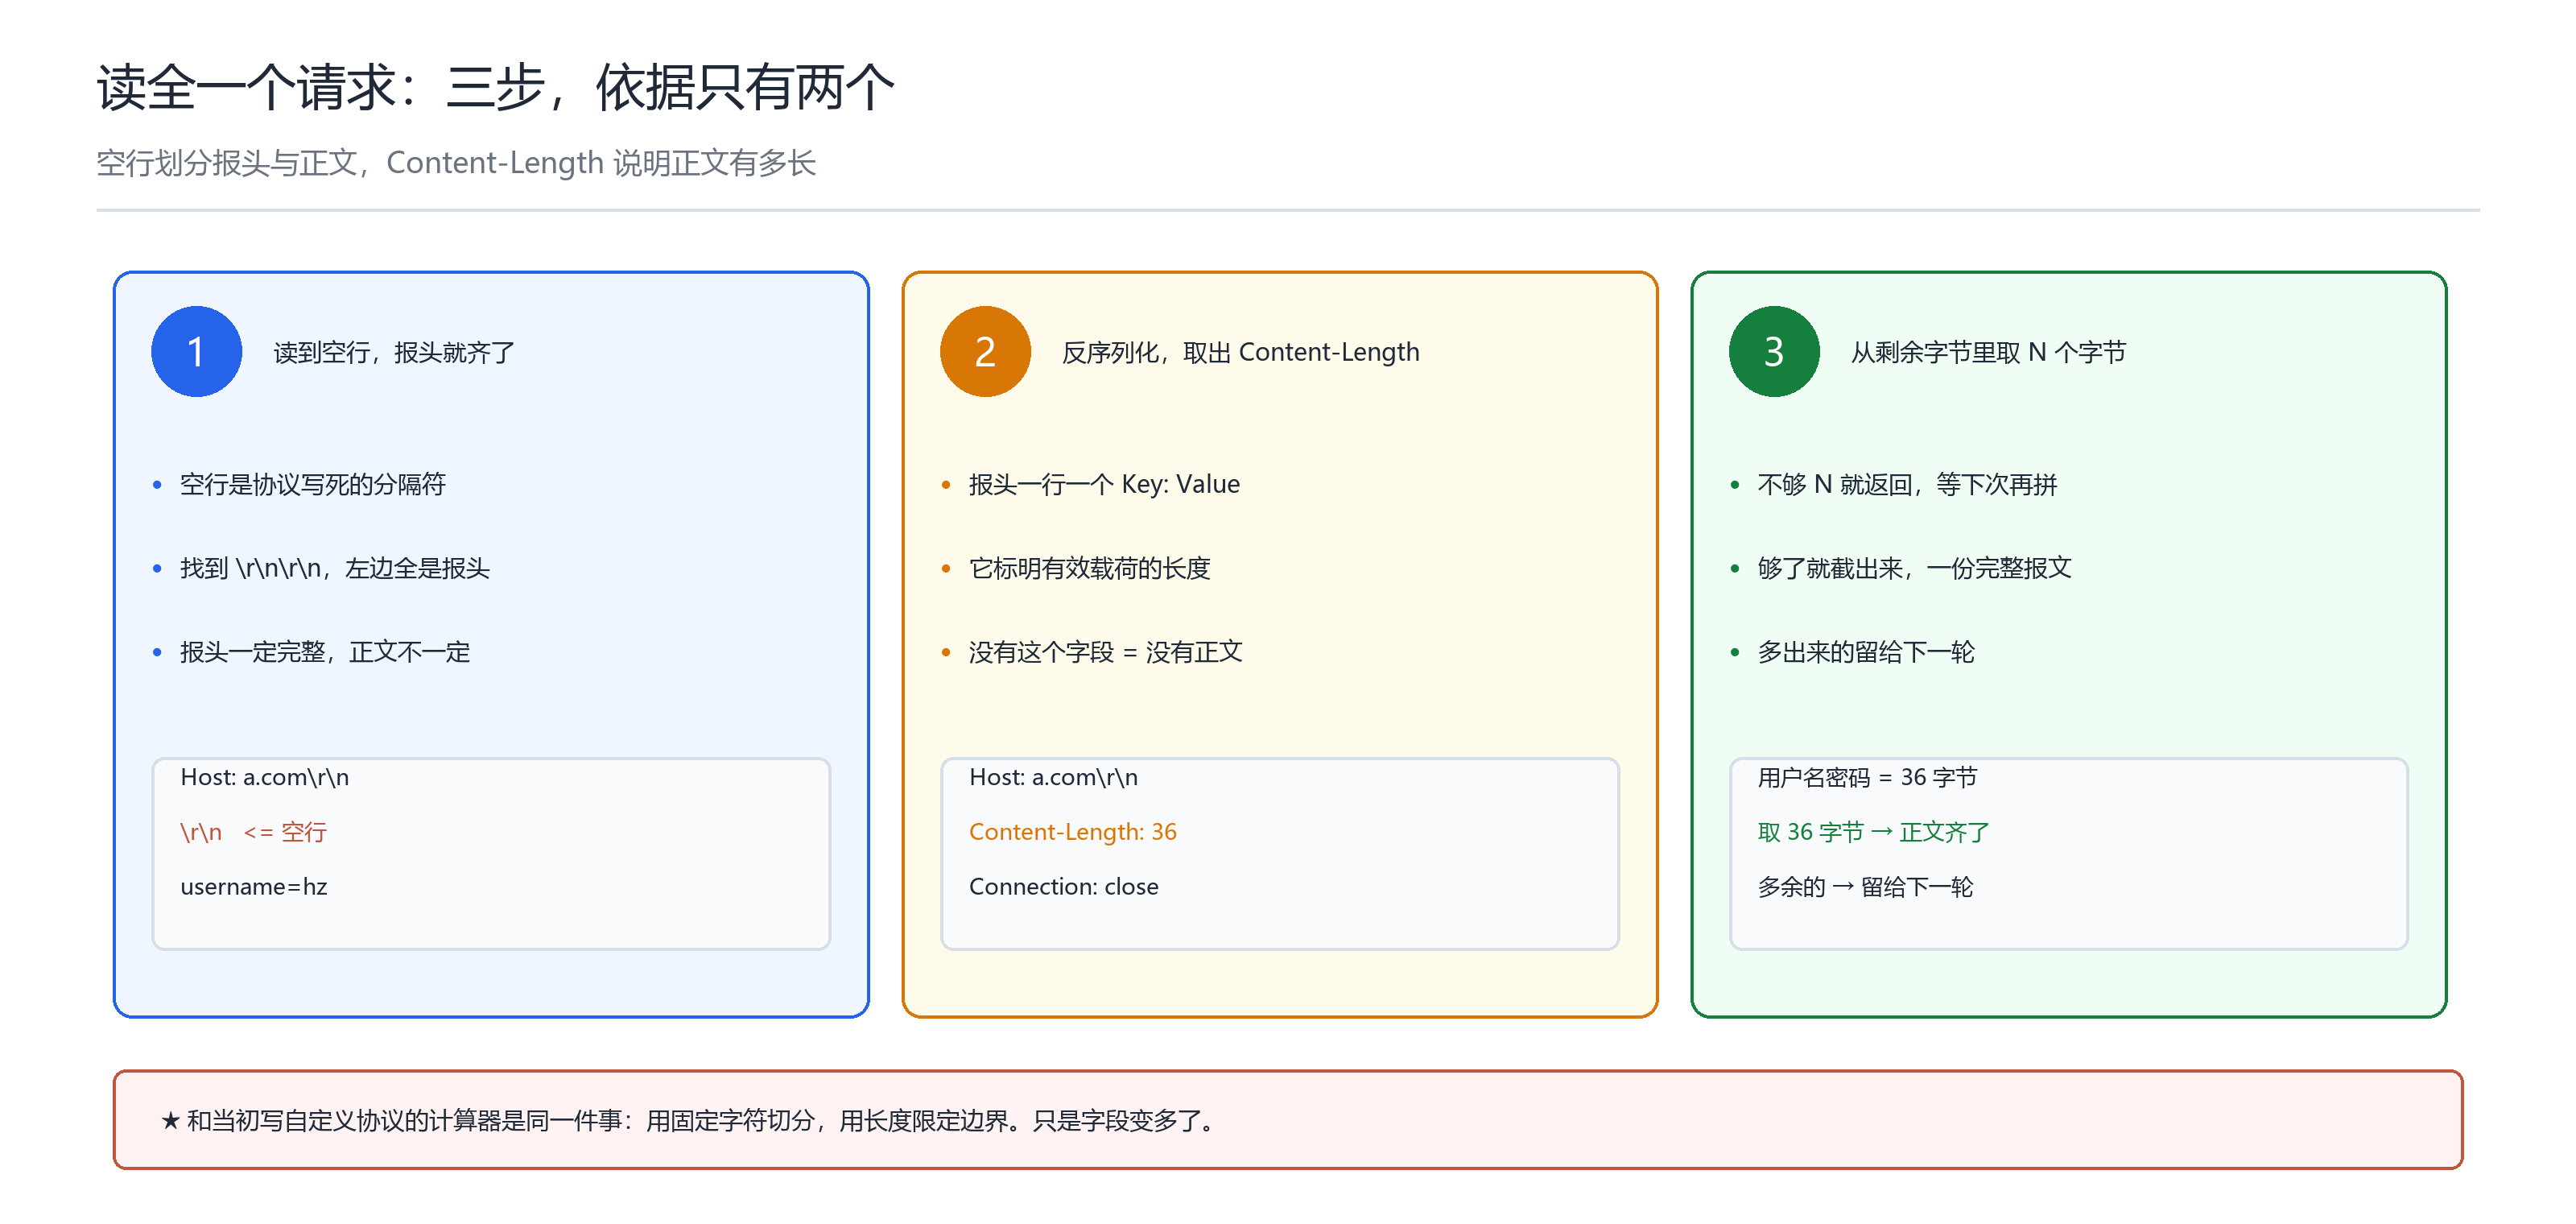
6.1 第一步:读到空行,报头就齐了
空行是协议写死的分隔符。报头是一行一行的(Key: Value\\r\\n),每一行都以 \\r\\n 结尾;当出现一个「什么都没有的行」,也就是连续两个 \\r\\n,报头结束。
所以第一步的判据非常干脆:在收到的字节里找 \\r\\n\\r\\n,找到就说明报头完整了。
为什么这一步一定可靠?因为报头里不可能出现空行 —— 空行是保留的边界标记。其他行都有内容,唯独分隔符这一行什么都没有。
这一步的产出:一份完整的报头(请求行 + 所有 Key: Value)。正文完整不完整,还不知道。
6.2 第二步:反序列化报头,取出 Content-Length
报头是一堆 Key: Value,其中最要紧的一个是:
Content-Length: 36
它声明的是有效载荷(正文)的字节数。三种情况:
| 有这个字段,值 > 0 | 后面要跟这么多字节的正文 |
| 有这个字段,值 = 0 | 有正文段,但是空的 |
| 没有这个字段 | 没有正文 |
6.3 第三步:从剩余字节里取 N 个字节
拿到 N 之后,剩下的事情就是数数:
- 剩余字节 不足 N 个 → 返回,等下一次 recv 把余下的拼上来;
- 剩余字节 够 N 个 → 截出前 N 个字节当正文,多出来的留给下一轮。
三步走完,一份完整报文到手。多出来的部分不能丢 —— 它已经是下一个请求的开头了。
6.4 这套做法并不新
自定义协议的计算器里就是这么干的:先找 \\r\\n,切出报头,取出长度,再读正文。
不同的只有一点:计算器的报头只有一行(一个数字),所以「找 \\r\\n」和「找空行」是一回事;HTTP 的报头有十几行,于是多了一步「先找到连续两个 \\r\\n」。
✔ 一个足够强的表述:任何「报头 + 变长正文」的协议,靠的都是「固定分隔符切头 + 长度字段定尾」这两件事。 HTTP、自定义协议、Redis 协议、MQTT,全是这个套路。
7. 一份真实的 POST 报文
理论讲完,看一份抓下来的真货。
POST /companyLogin.do HTTP/1.1
Host: job.xjtu.edu.cn
Connection: keep-alive
Content-Length: 36
Cache-Control: max-age=0
Origin: http://job.xjtu.edu.cn
Content-Type: application/x-www-form-urlencoded
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) …
Accept: text/html,application/xhtml+xml,application/xml;q=0.9
Referer: http://job.xjtu.edu.cn/companyLogin.do
Accept-Encoding: gzip, deflate
Accept-Language: zh-CN,zh;q=0.9
Cookie: JSESSIONID=D6287A58…; Hm_lvt_783e83ce…
username=hgtz2222&password=2222222222
整份报文 15 行:1 行请求行 + 13 行报头 + 1 个空行 + 1 行正文。
值得留意的几件事:
- 报头占了九成篇幅。 真正要传的数据(用户名口令)只有最后一行,前面全是元信息。应用层协议的典型形态就是这样:元信息的量远超有效载荷。
- Content-Length: 36 是发送方数出来填进去的,不是接收方估算的。所以接收方只要照着 36 去数,一定不多不少 —— 这是整个「读全报文」方案能成立的根本原因。
- 正文是 username=…&password=…,Content-Type 声明它是 application/x-www-form-urlencoded,也就是「用 & 连接的键值对」。
- 口令是明文。HTTP 本身不加密,加密要靠 TLS(那是 https 的事)。
8. 响应方向同理:Content-Length 是双向的
请求要读全,响应也要读全。所以对称地:
应答一旦携带数据,就应该在响应报头里带上 Content-Length: XXX。
现状是:今天的浏览器非常宽容,不带也能把网页渲染出来。但规范上要求带,原因和请求方向一样 —— 接收方没有别的办法知道正文到哪结束。
反过来看就更清楚:浏览器解析响应时,靠的就是
如果正文后面还有内容(比如长连接上的下一个响应),不带长度就彻底分不清边界。
✖ 一个常见的错觉:以为「TCP 关闭连接」就代表正文结束。短连接下勉强成立,长连接下完全不成立。
9. 报头的四把钥匙
报头字段有几十个,真正需要理解的只有四个:Host、User-Agent、Accept-Encoding、Referer。剩下的(Cookie、Connection、Location)留到下一篇。
9.1 Host:资源在哪台机器的哪个端口
Host: 8.137.19.140:8081
它记的是「被请求资源所在的主机和端口」。对一台普通的、自己就是那台服务器的程序来说,这个字段看看就好 —— 反正请求就是发给自己的。
但对代理服务器,这个字段是命门:
- 收到请求,看 Host;
- Host 指向的不是自己 → 不处理,转发给那台机器;
- 拿到应答复,再转回给客户端。
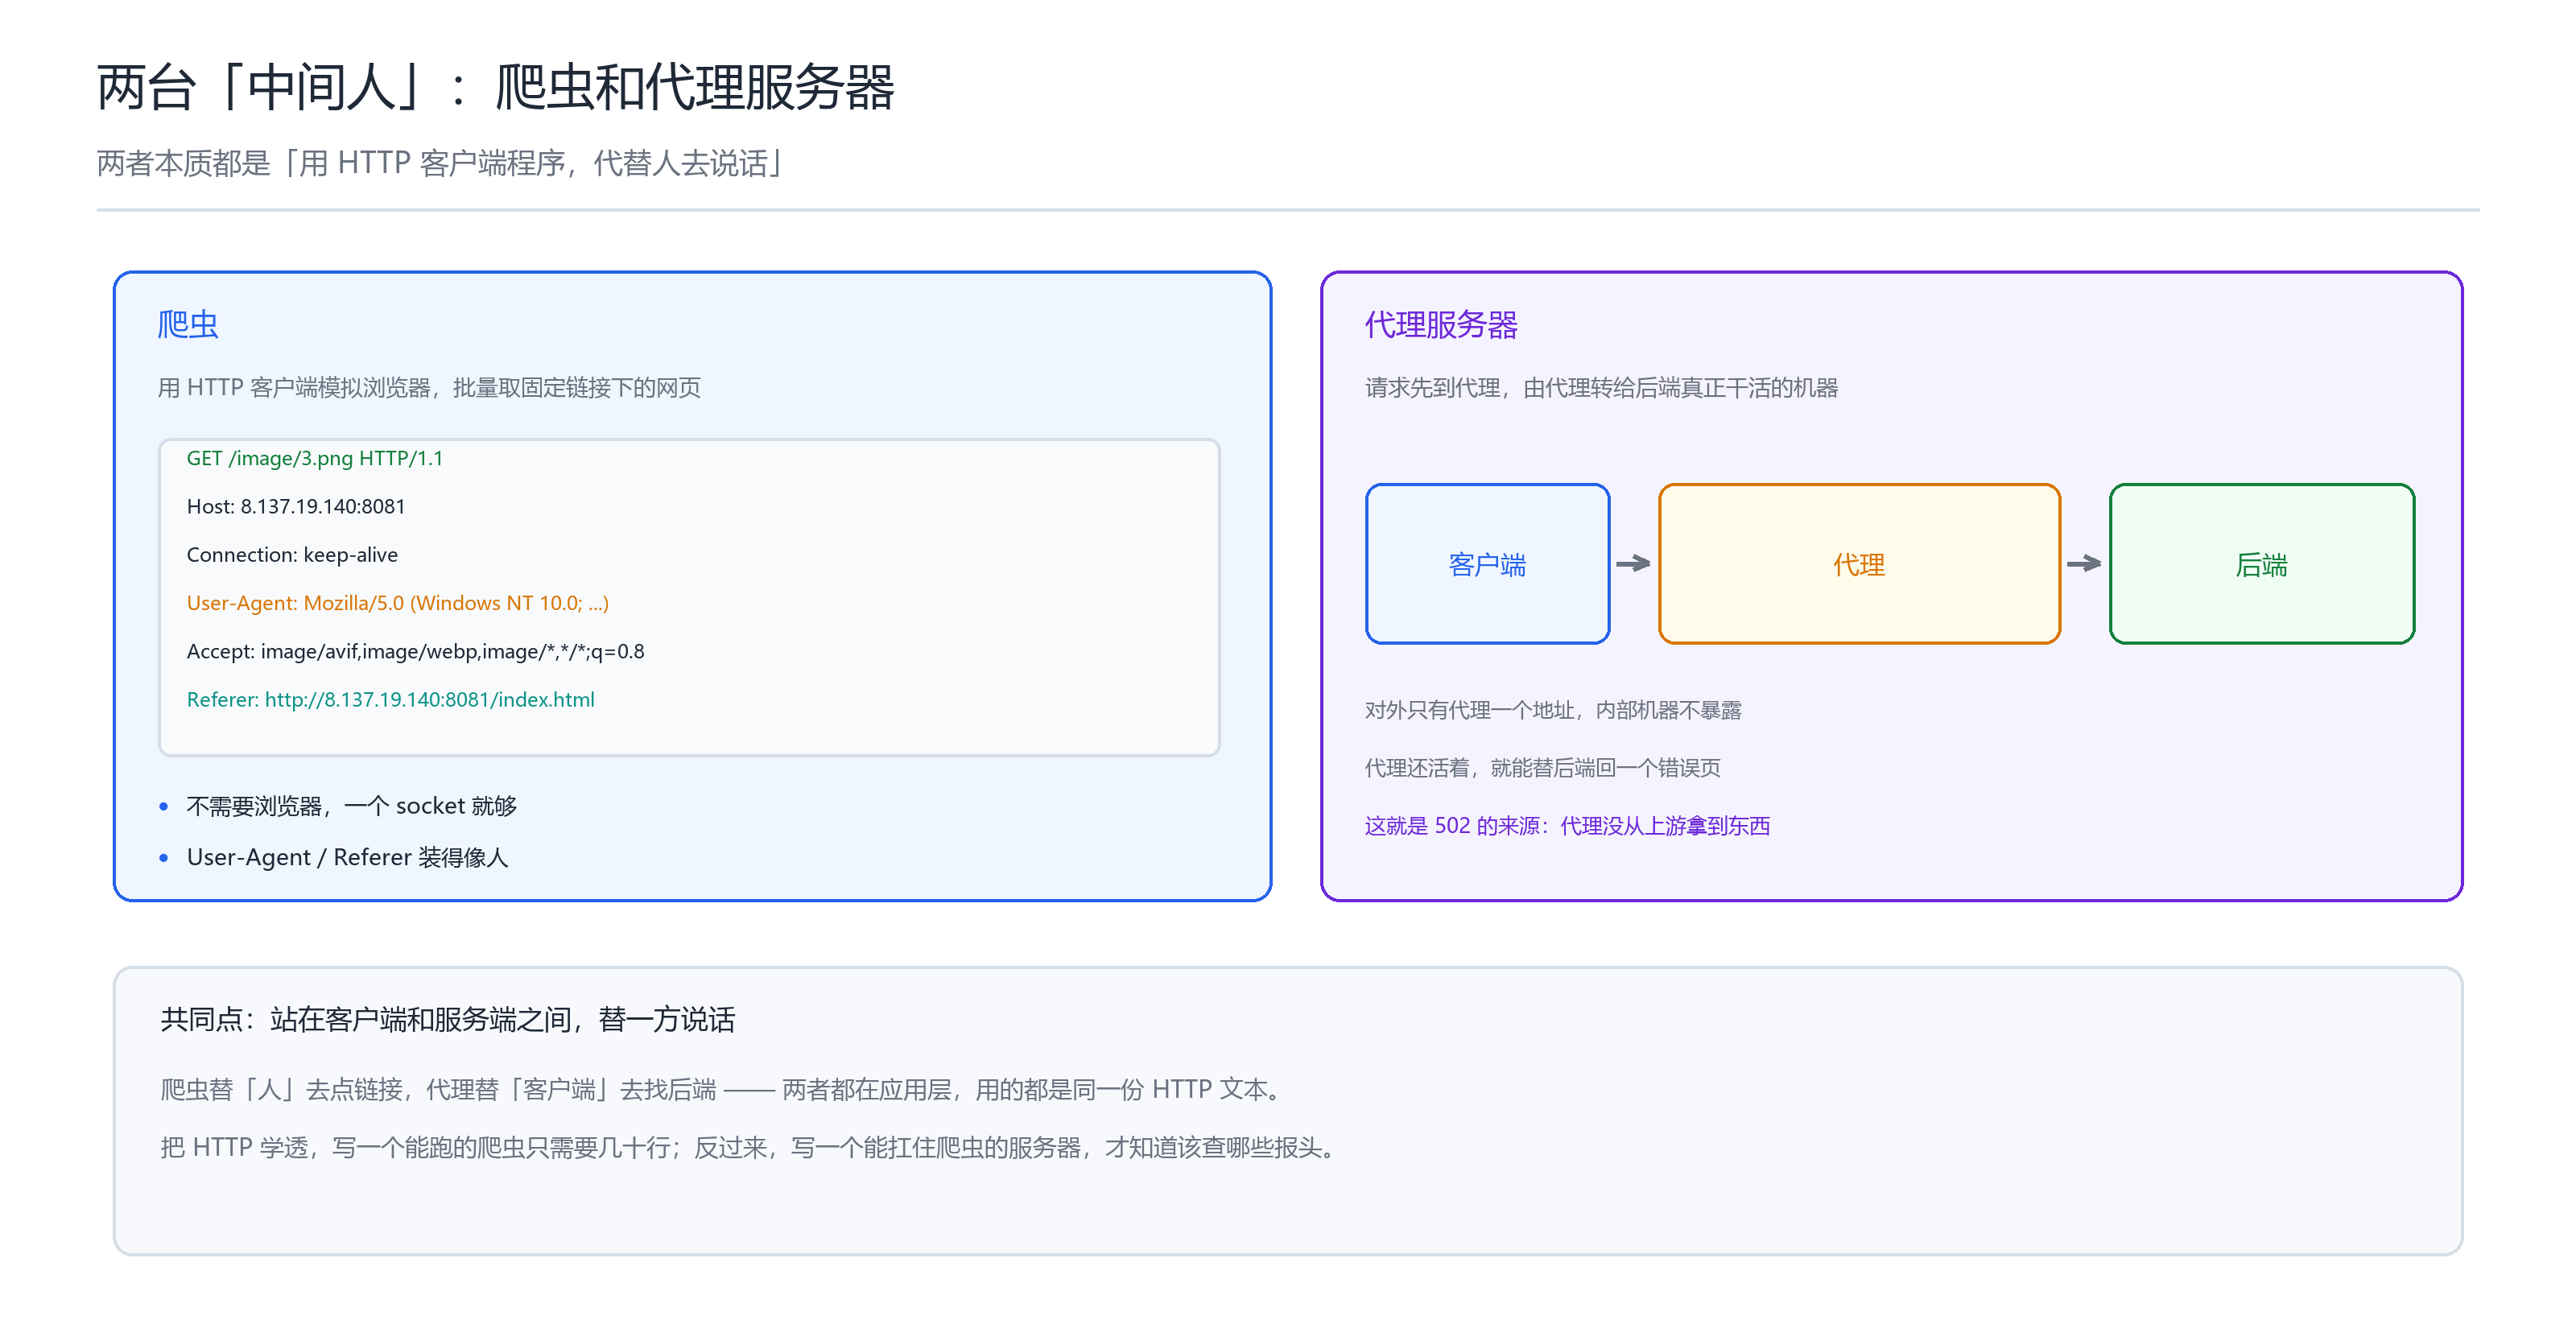
代理服务器自己不当老板,只当中间人。 这一条在 §16 还会展开。
9.2 User-Agent:客户端是谁
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) …
它装的是客户端信息:操作系统、浏览器内核、版本号。手机访问时,这里就会变成 Android 或 iOS 的标识。
它的用途能用一个场景说明白:在百度搜「微信」,页面会推一个「安全下载」按钮。Windows 上点下去是 .exe,手机上点下去是安卓包或 iOS 跳转。
服务器凭什么判断客户端是什么设备? 因为搜索本身也是一次 HTTP 请求,请求里带着 User-Agent。服务器读这个字段,就知道该推哪个平台的包。
它还有第二个用途:判断请求是不是真人发的。后端可以检查 User-Agent 是否像一个正常浏览器,不像就拒绝。这一条直接关系到爬虫能不能活着(§16)。
9.3 Accept-Encoding:能不能压缩
Accept-Encoding: gzip, deflate
意思是「本端能解压这些格式,对端可以压完再发」。
为什么要压:网页经常几十上百 KB,先压缩再传,用双方的 CPU 算力去对冲网络 IO 的时间。省的是带宽,花的是算力 —— 在带宽贵的年代这是刚需,今天依然默认开着。
9.4 Referer:从哪个页面跳过来的
Referer: http://job.xjtu.edu.cn/companyLogin.do
它回答的是「上一次是从哪个页面点过来的」。这个字段能直接做实验验证:
结论:浏览器会自动带 Referer,值就是上一个页面的地址。 一次次跳转,就串成一条路径。
工程上的用途:
- 分析「用户从哪个页面跳到哪个页面」,画转化漏斗;
- 多个站点互相导流时,统计「哪个站点导过来的流量最大」;
- 防盗链:图片只允许本站页面引用,外站引用的 Referer 不对,直接拒绝。
💡 Referer 这个单词本身是拼错的(正确拼写是 Referrer),但错版已经写进规范,几十年没人改 —— 属于典型的「历史包袱变成标准」。
10. Content-Type:正文到底是什么
Content-Length 说的是「正文有多长」,Content-Type 说的是「正文是什么」。
text/html ← 网页
text/css ← 样式表
image/png / image/jpeg ← 图片
application/x-www-form-urlencoded ← 表单数据
为什么必须带?有一个很直观的对照:
之前不带 Content-Type,浏览器照样把 HTML 渲染出来了 —— 于是很容易得出结论「这个字段可有可无」。但只要换成返回图片,问题立刻暴露:不带类型,浏览器不知道这是图片,不会渲染,而是直接当成文件下载。
所以不是浏览器不需要,是浏览器在替服务器猜。返回的类型一旦多起来,猜不准就是常态。规范要求带,是为了让接收方不用猜。
✔ 这也解释了 HTTP 为什么能「什么都能传」:图片、音频、视频、字体、JSON —— 在协议眼里都只是一段字节 + 一个类型标签。协议本身不懂内容,它只负责把「字节」和「它是什么」一起搬过去。
网页里嵌视频就是同一件事:
<video src="/video/1.mp4" width="640" height="360" controls></video>
浏览器拿到网页后,看到 video 标签,再发一次请求去拿那个 .mp4;服务器返回时把 Content-Type 设成 video/mp4,浏览器才知道该调播放器。
11. 打开一个网页 = 一串请求
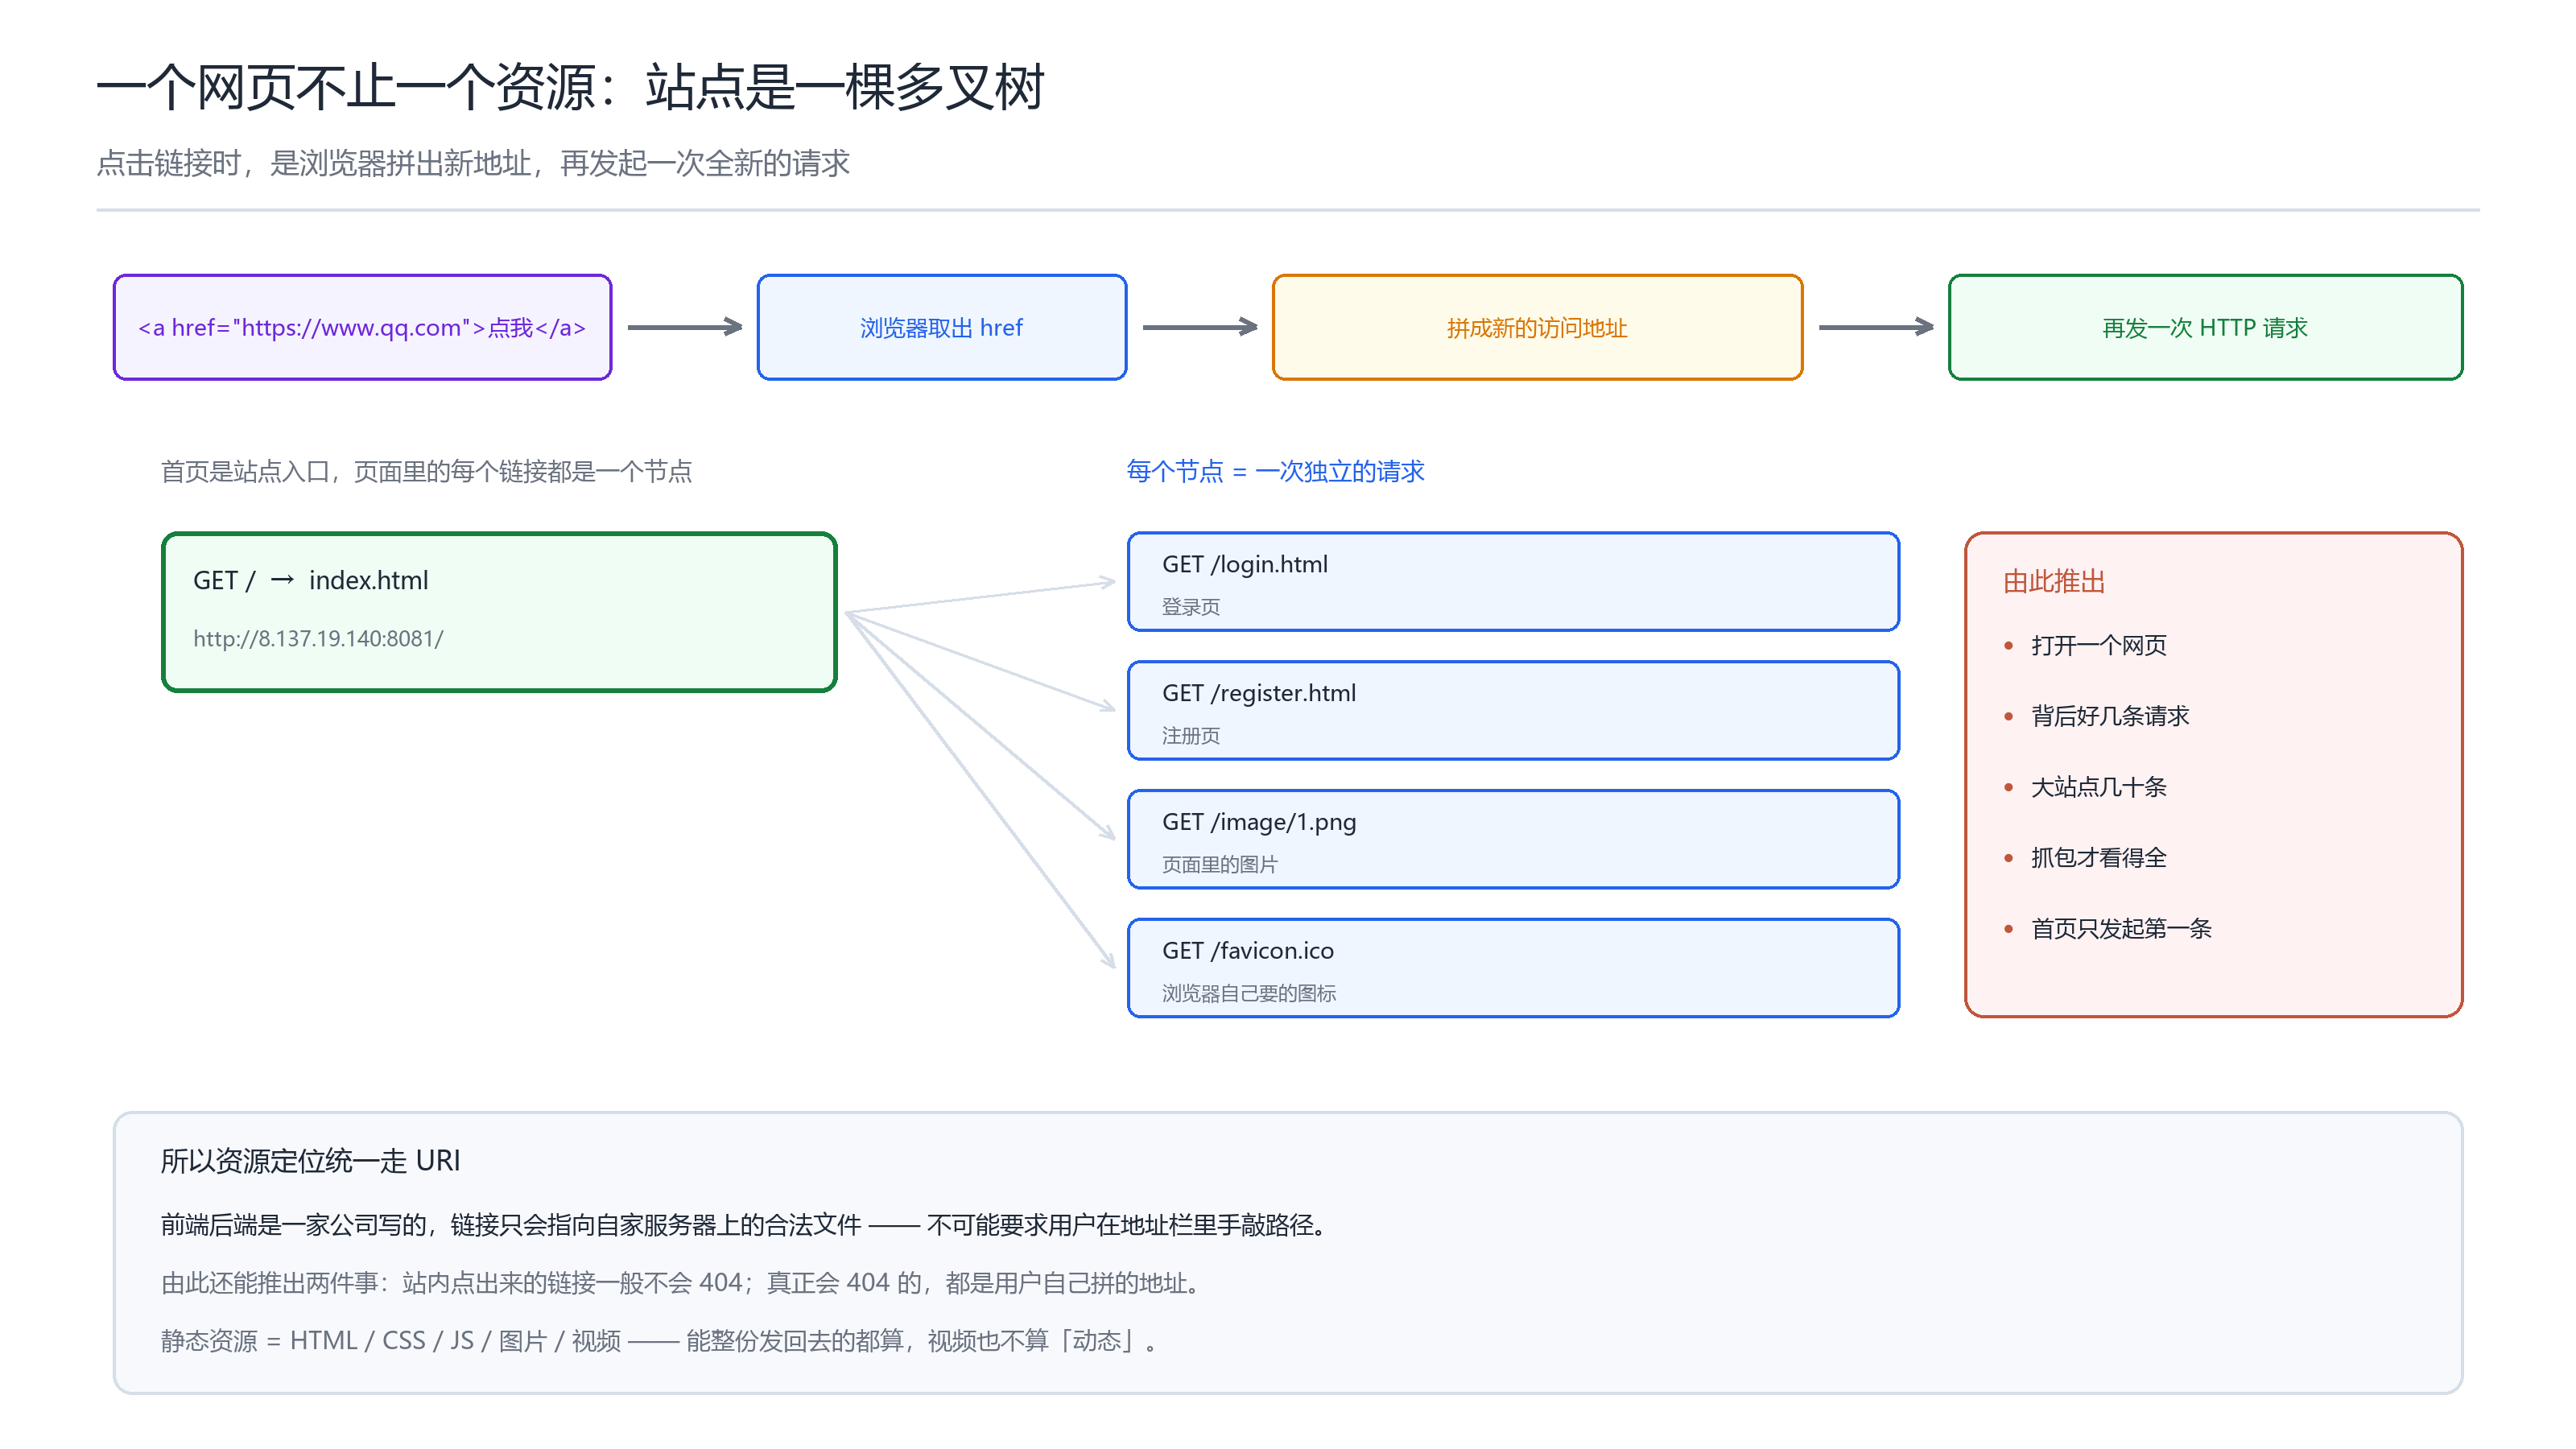
11.1 首页是入口,站点是一棵树
前端和后端通常是一家公司写的,所以站内的链接只会指向自家服务器上的合法文件。用户不会在地址栏里手敲路径 —— 他只会点。
于是站点的结构天然是一棵树:
- 根节点是首页(/);
- 首页里嵌着指向登录页、注册页、图片的链接;
- 每个链接点下去,就走到一个子节点。
每个节点对应一次独立的 HTTP 请求。 这一点由浏览器完成,跟后端没关系:
<a href="https://www.qq.com">…</a> 这种绝对地址,点下去就是跳到别的站点;<a href="/login.html"> 这种相对地址,浏览器自动补成「当前站点的根 + 这个路径」。
11.2 浏览器还会自己要东西
除了页面里写的链接,浏览器自己还会发请求:
| index.html | 地址栏或链接 |
| image/1.png | 页面里的 <img> |
| 1.css / 1.js | 页面里的 <link> / <script> |
| /favicon.ico | 浏览器自己,为了标签页上的小图标 |
favicon.ico 是一条容易被忽略的请求:它一定从站点根目录取,站点没放这个文件就是 404。
12. 文件在磁盘上就是一个 char 数组
12.1 看到的「一行一行」是编辑器给的
文本编辑器把文件显示成一行一行,看起来文件是「二维」的。但底层不是:
- 换行只是内容里的两个字节 \\r\\n(Windows)或一个字节 \\n(Linux);
- 磁盘上文件就是一串连续的字节。
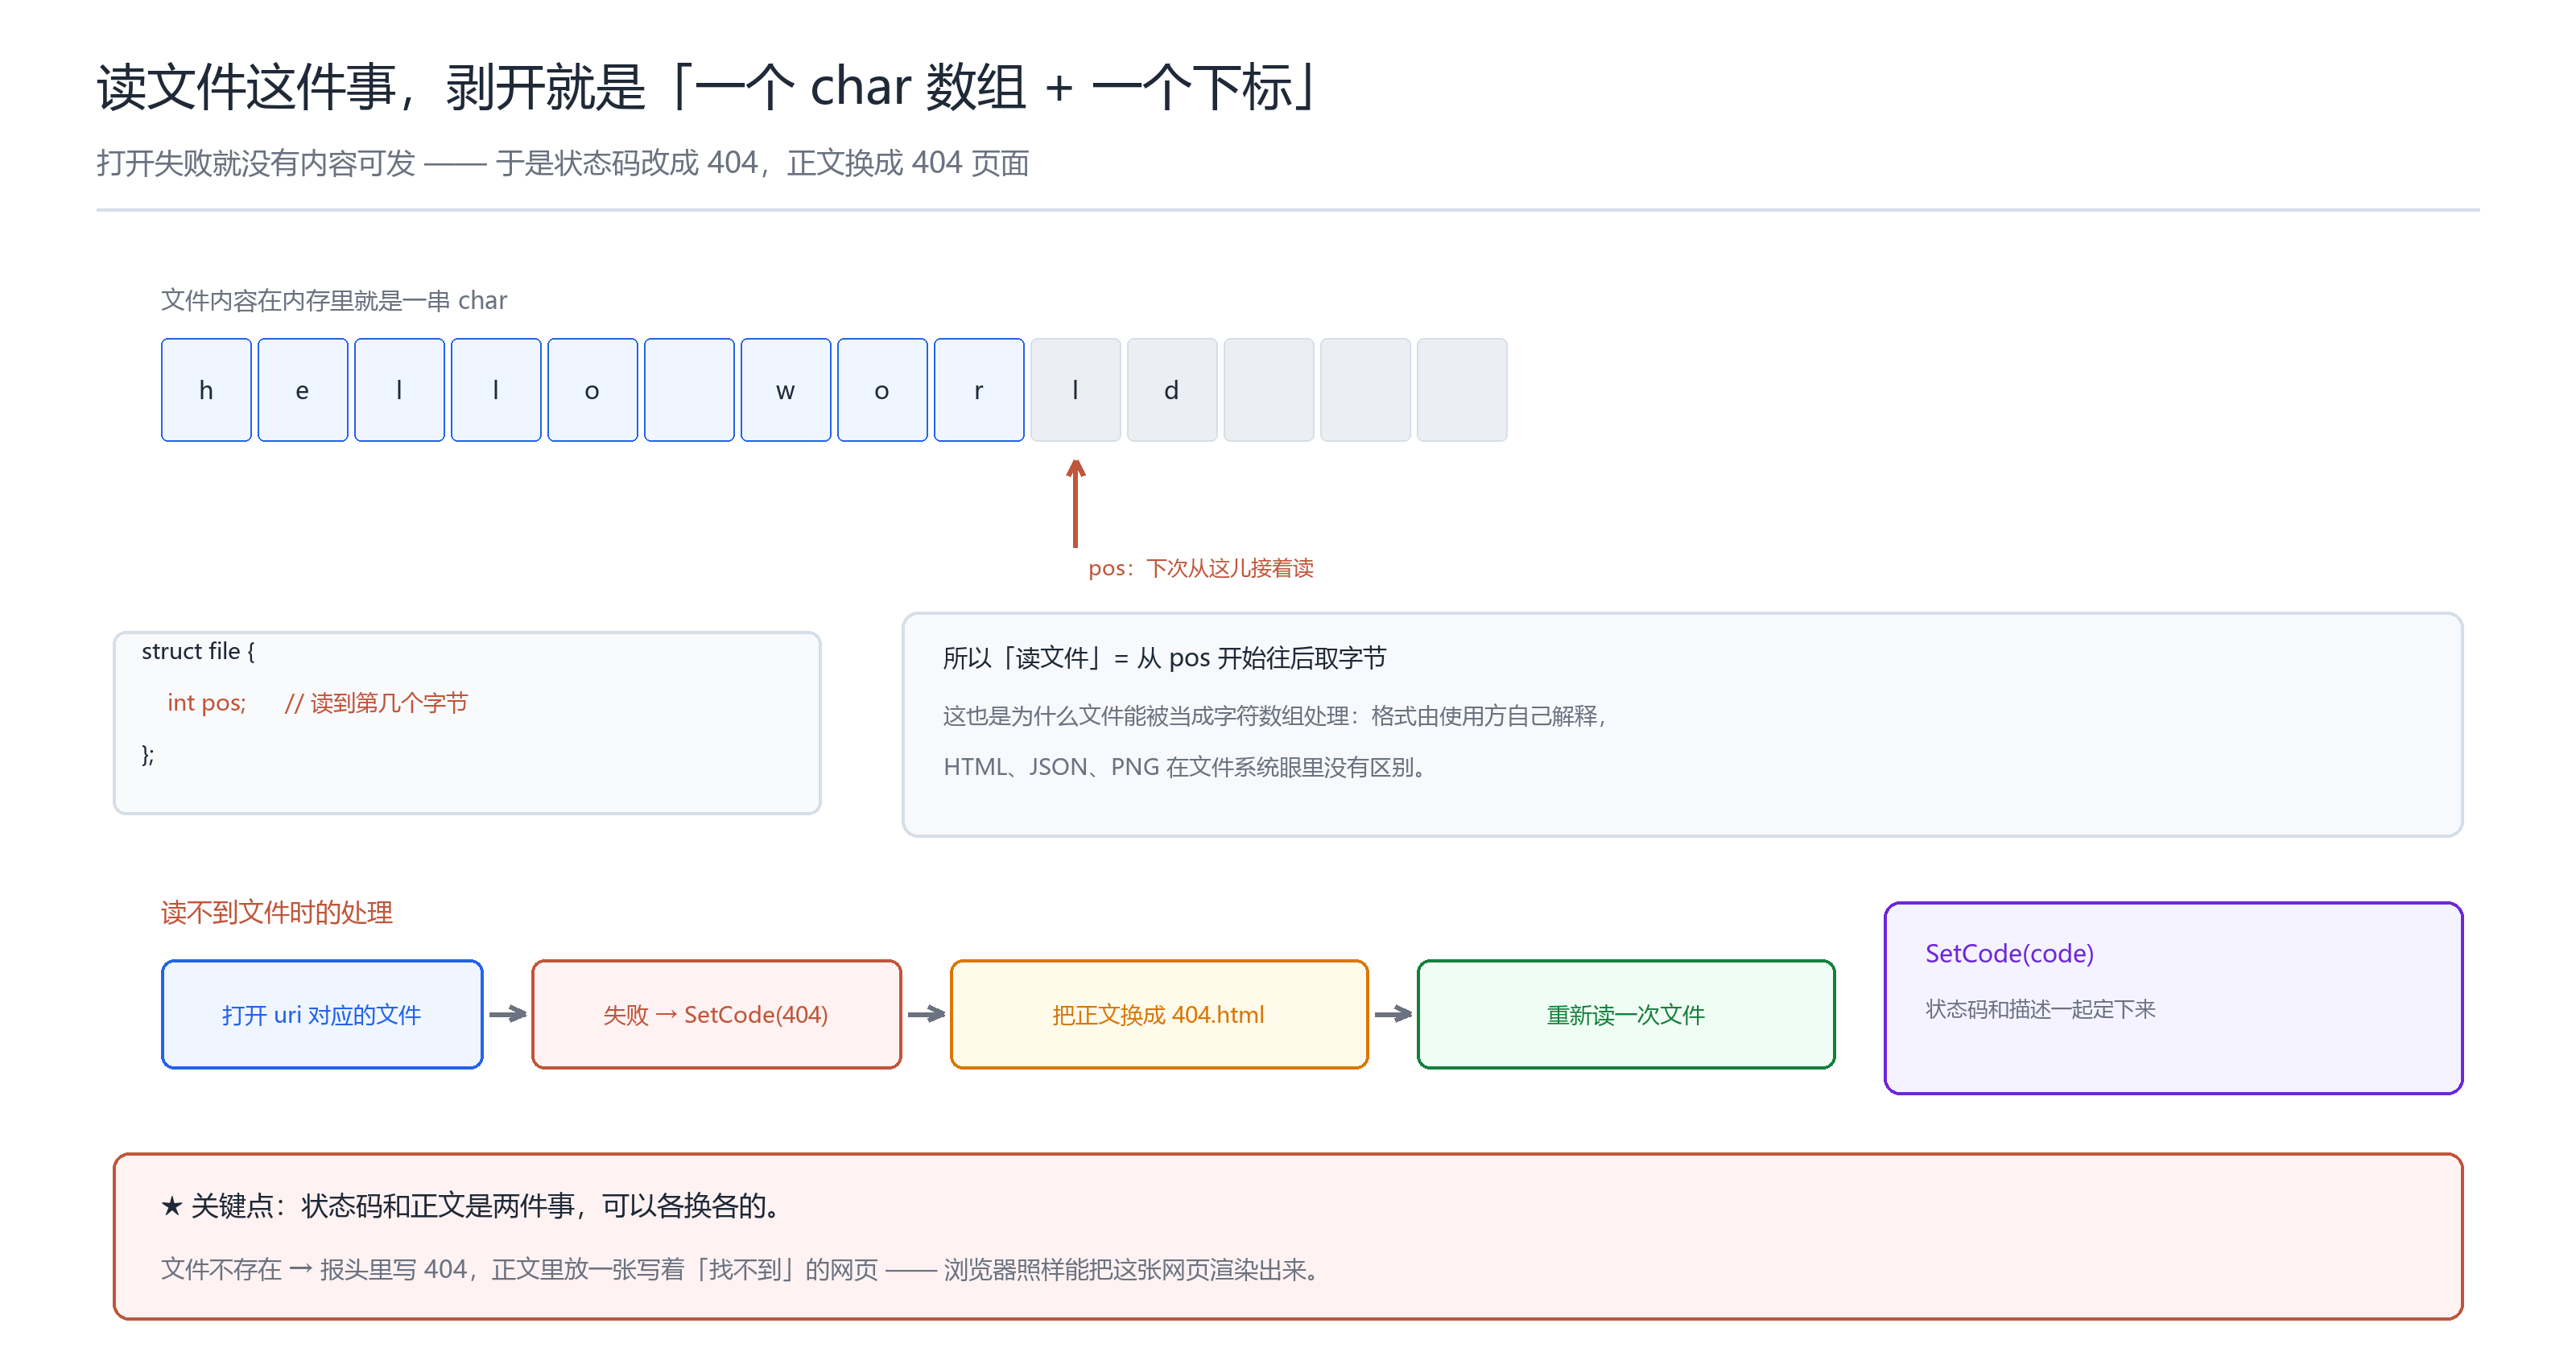
所以文件在内存里就是一个 char 数组。 所谓「第几行」,只是编辑器扫到 \\n 时做的排版。
这和从 socket 读数据是完全一样的视角:从网络读上来是一维字节数组,从文件读进来也是一维字节数组。只要是一维数组,就需要一个位置记录「读到哪了」,否则下次不知道从哪继续。
12.2 那个位置叫 pos
struct file {
int pos; // 读到第几个字节
};
Linux 内核管理一个打开的文件时,属性里就有这么一个「读写位置」。有了它:
- 读 10 个字节 → pos 变成 10;
- 再读 10 个 → 从 10 开始,读完 pos 变成 20;
- 要算文件大小 → 把 pos 移到末尾,此时 pos 的值就是大小。
12.3 怎么拿文件大小
两种做法,都要会:
做法一:fstream + seekg / tellg
std::ifstream in(file_name, std::ios::binary);
if (!in.is_open()) return –1;
in.seekg(0, std::ios::end); // 读写位置移到结尾
int size = in.tellg(); // 当前位置 = 文件大小
in.seekg(0, std::ios::beg); // 还原到开头,后面还要读内容
in.close();
return size;
seekg 就是 C 里 fseek 的 C++ 版本,tellg 对应 ftell。以二进制方式打开(std::ios::binary),文本文件和二进制文件都能用。
做法二:stat 系统调用
struct stat st;
if (stat(path.c_str(), &st) == 0) {
return st.st_size; // 文件大小
}
stat 直接把整个文件属性结构体带出来:inode、权限、硬链接数、UID/GID、大小、时间戳。拿大小只是顺手,这个接口的真正价值是「一次拿到全部属性」。
💡 为什么非要单独算大小?因为 Content-Length 要填一个准确的数字。前面读文件内容时拿到的是「内容」,不是「长度」—— 除非额外调一次 size(),否则只能再数一遍。
13. 状态码:五类,五种责任
状态行的格式是:
HTTP/1.1 200 OK
↑ ↑ ↑
版本 状态码 描述
描述是给人看的,程序判断只认数字。第一位数字定性,后两位细分。
13.1 五类总览
| 1XX | 信息性 | 请求已收到,处理还没完 | 100 Continue |
| 2XX | 成功 | 请求正常处理完毕 | 200 201 204 |
| 3XX | 重定向 | 需要附加操作才能完成 | 301 302 304 307 |
| 4XX | 客户端错误 | 服务器无法处理这个请求 | 400 401 403 404 |
| 5XX | 服务器错误 | 服务器自己处理时出错 | 500 502 503 |
13.2 1XX:先回一句「收到了,继续发」
最典型的场景是大文件上传。传一个几百 MB 的文件,客户端不可能一口气发完,通常先把报头(带 Content-Length)发过去。服务器一看:知道这次要传大东西,但正文还早。于是先回一个 100 Continue:
请求收到了,接着传,别停。
这一类的意义就是防止客户端白等。日常很少见,因为除了上传大文件,很少有「处理时间明显长于传输时间」的场景。
13.3 2XX:成功,但成功的样子不止一种
| 200 OK | 一切正常 | 请求的网页/图片拿到了 |
| 201 Created | 新建了资源 | 发布一篇新文章,服务器入库并生成了新页面 |
| 204 No Content | 成功,但没有正文 | 删除一篇文章,操作成功,没有东西要返回 |
204 最容易被误用成 200。区别在于语义:200 的意思是「要的东西在正文里」,204 的意思是「事情办成了,但正文是空的」。程序如果按 200 去读正文,读到空就会以为出错。
13.4 3XX:换个地方
重定向的意思是「要找的东西不在这儿(或者不只用这一份),去另一个地址」。
- 登录后跳回原页面:在 B 站看视频,提示登录 → 点登录 → 登录成功后自动跳回刚才那个视频页。这个「跳回」就是重定向。
- 换域名:老域名解析到新站,访问老域名自动跳过去。
- App 互跳:打开某个 App,开屏广告点一下直接跳到淘宝 —— 这是一次重定向。
- 域名层面的跳转:某些域名解析后指向的不是自己,而是另一台机器的 IP。
重定向本身还能细分(301 永久、302 临时、304 未修改、307 保持方法),这一篇先不展开。
13.5 4XX:客户端的责任
| 400 Bad Request | 坏请求 | 请求格式不对,服务器解析不了 |
| 401 Unauthorized | 需要认证 | 这个资源要登录才能看 |
| 403 Forbidden | 禁止访问 | 登录了,但权限不够 |
| 404 Not Found | 找不到 | 这个路径下确实没有这个文件 |
403 的典型场景是公司内网论坛:新入职的实习生看不了某些版块,即便登录了也一样 —— 权限不够。401 的典型场景是 VIP 视频:点开先弹登录框。
404 值得单独论证一下归属问题。「访问的页面不存在」,到底怪谁?
答案是怪客户端。理由:服务器上本来就没有这个文件,请求本身是非法的。类比一下 —— 去找人要一样东西,人家确实没有,不能因此说人家有问题,任何人都有能力边界。
换个角度看更清楚:只要是在站点内部点链接访问,一般不会 404。 因为站内的链接一定指向自家服务器上的合法文件。真正会 404 的,都是用户在地址栏里自己拼出来的路径 —— 比如在京东后面手敲 /a/b/c.html,那个资源本来就不存在。
✔ 由此可以推出一条工程判断:404 的日志条目,多半来自用户手输、旧链接、爬虫猜测,而不是站内正常点击。
13.6 5XX:服务端的责任
| 500 Internal Server Error | 内部错误 | 代码崩了、数据库挂了 |
| 502 Bad Gateway | 网关错误 | 代理没从上游拿到有效响应 |
| 503 Service Unavailable | 服务不可用 | 过载,暂时处理不过来 |
503 最好理解:大学选课系统在开放的那一刻,全校同时点,服务器扛不住 —— 页面直接报错,刷新几次偶尔能进去。这就是「过载」。
500 在今天的代码里对应一个具体场景:TCP 服务器收到新连接后要 fork 一个子进程去处理,如果 fork 失败(进程数到上限),服务器自己就出错了。
这里有一个漂亮的追问:服务器连子进程都创建失败了,它凭什么还能回一个 500 给客户端?
答案是:失败的只是「创建子进程」这一步,父进程还活着。父进程手里的监听套接字还在、新连接的套接字也拿到了,所以它完全可以:
也就是说,给客户端回错误这件事,不需要「处理请求」的能力,只需要「连接还在」这个条件。 只有当父进程本身也挂掉,才真的什么都回不了 —— 那时候客户端只能看到连接被重置。
13.7 关于状态码的两个现实
讲义里特意交代了两件事,都属于「规范之外的世界」:
第一,状态码在工程实践里写得相当随意。 前后端联调时,很多人不管什么情况都填 200,把真正的错误塞进正文的 JSON 里。原因是浏览器重内容、轻报头:它真正在乎的是正文能不能渲染,状态码对不对很少影响页面显示。
所以规范是规范,现实是现实。但自己写的时候还是应该认真填 —— 至少 4XX 和 5XX 要分清楚。
第二,大公司不愿意返回 5XX。 一旦返回 500,等于对外承认「服务器内部出问题了」。这两个信息很有价值:既暴露了自己系统的短板,也可能被人拿来做攻击。所以大多数公司的做法是:内部报错 → 对外返回一个 4XX,甚至返回 200 + 一个「稍后再试」的页面。
💡 这条能解释一个常见现象:明明网站挂了,抓包看到的却是 200 或 404。状态码首先是产品决策,其次才是技术要求。
14. 以 404 为载体的异常处理
理论落到代码,选 404 当样本,因为它最容易复现(随便请求一个不存在的文件就行)。
14.1 让状态码和描述绑在一起
状态码和描述永远成对出现(200 OK、404 Not Found),手写容易对不上。所以抽一个接口出来:
void SetCode(int code) {
code_ = code;
switch (code) {
case 200: desc_ = "OK"; break;
case 404: desc_ = "Not Found"; break;
default: desc_ = "Unknown"; break;
}
}
这样只要给一个数字,状态行需要的东西就齐了。以后要加 301、500,就在 switch 里多一个分支。
14.2 报头也走同一个接口
响应报头也是一堆 Key: Value,所以同样抽一个:
void SetHeader(const std::string& key, const std::string& value) {
headers_[key] = value;
}
序列化的时候遍历这个 map,每个键值对拼成 Key: Value\\r\\n,最后补一个 \\r\\n 收尾。这就是「自己写的序列化」 —— 没有第三方库,只有字符串拼接。
✖ 一个真实的坑:这个 map 不能写成全局的或者多个响应共用的,否则会出现 §12.3 那种「后写的覆盖前写的」的情况。每条响应各有一份。
14.3 读不到文件时怎么办
MakeResponse() 里的流程:
目标路径 = webroot + uri
读这个文件
成功 → SetCode(200),正文 = 文件内容,SetHeader("Content-Length", 文件大小)
失败 → SetCode(404),目标路径 = webroot + "/404.html",重新读一次
关键在第 3 步:失败之后不是什么都不返回,而是换一个文件读。 因为协议规定,响应必须有正文(至少得有个能显示的东西),不能让浏览器拿到一片空白。
所以站点根目录下必须有一个 404.html:
- 它是「错误页」,不是「错误码」;
- 报头里写 404 Not Found,正文里放这张网页;
- 浏览器照样能把这张网页渲染出来,用户看到的是「访问的资源不存在」。
✔ 状态码和正文是两件独立的事,可以各换各的。报头说「错了」,正文说「错成什么样」。
改完之后实测:GET /a/b/c.html HTTP/1.0 → 返回 404 + Content-Length: 1506 + 一张 404 页面。长度对得上,说明换文件之后重新算过大小 —— 这一步如果漏了,就会掉进前面那个「长度不匹配」的坑。
💡 更规范的做法是用重定向(302)把浏览器导向 /404.html,这样地址栏也会变。但重定向本身要讲一节,这里先用「换正文」的土办法。
15. 爬虫和代理服务器