插拔、装配、擦拭这一类活的失败点几乎从不在"看见孔在哪"这一步。真正的分水岭是贴着孔往里推的最后几毫米:给多了卡死,给少了打滑,力控参数差一个数量级就整段报废。更要命的是,这些经验只在当次的光照和桌布下成立,灯一换、背景一换,策略就当成换了个工位。
Semantics-to-Contact(S2C)这篇论文的立场可以压成一句:把"去哪里"和"怎么贴上去"拆成两段做,而且在真机上做。第一段请一个视觉语言模型在第三视角里点出接触区,配上深度和外参算出一个三维目标点,由运动规划把夹爪送到位;第二段交给人在回路的真机残差强化学习,在双腕视角加六维力里学最后的修正量。中间还插了一层对象中心增广,用提示式分割把腕部图像的前景抠住、把背景换成随机纹理,专门掐掉策略对背景的依赖。
先把三个数摆出来。主表里 6 个真机任务、每任务 20 次试验,平均成功率 94.17%,同期 HIL-ConRFT 91.76%、HIL-SERL 90.83%、ACT 2.50%、SERL 0%、Octo-small 5.83%。视觉加位置双重扰动下平均 78.75%,而两个人在回路基线在花纹桌布那一组的平均成功率都是 0.00%。学习器侧优化时间单任务 20 到 90 分钟,六个任务合计 320 分钟,比 HIL-SERL 的 480 分钟少三分之一(这两个和我按表 1 逐项相加)。
代价也得提前说清。这不是一个 VLA:VLM 只做点选,动作全部由行为克隆和强化学习产生,没有一条梯度从语义模块流向动作模块。没有触觉,观测里只有六维力/力矩。把白色充电器换成黑色,Charger 与 USB-Easy 都是 0/10——论文自己把这条边界写进了可扩展性表。语义层每个回合只调用一次,一旦点错,后面没有任何重定位或恢复机制。
一分钟速览
- 痛点:真机 RL 学接触任务,两个失效源分得比想象里清——"贴不准"是控制问题,"换个背景就崩"是观测问题,端到端策略被迫用一个网络同时应付两种分布漂移。
- 主张:语义聚焦(VLM 点出接触区 + 运动规划送到位)与接触精修(人在回路的真机残差 RL + 力反馈)两段串联,中间只交一个 SE(3) 点。
- 接口:语义层不传特征、不传轨迹、不传梯度,只传一个接触前目标点 p_target。好处是两段都能单独替换,表 4 换 VLM 就是拿这个接口做实验。
- 阶段二的三层:ACT 基座负责"走到位",残差 SAC 只学"补多少",动作是 a_base + Δa;人的干预动作不进策略缓冲区,单独进 D_offline。
- 不加仿真:不做仿真域随机化,改用 YOLOE 提示式分割抠住腕部图像前景,背景换随机纹理,前景再做颜色抖动。
- 结果:6 个真机任务平均 94.17%,比 HIL-SERL 高 3.34 点、比 HIL-ConRFT 高 2.41 点;学习器时间合计少 160 分钟。
- 抗扰动:花纹桌布 + 位置 69.17%、强阳光 + 位置 84.17%、彩光 + 位置 79.17%、闪光 + 红桌布 + 位置 82.50%,四组平均 78.75%。
- 边界:换黑色充电器 0/10,插座内出现分布外物体 Charger 0/10;作者的原话是"改变接触区外观与几何的扰动"打不过。
- 没给的:阶段切换判据、定位正确率、每段单独的成功率分解、重定位机制、代码与数据(checklist 写的是接收后再放)。
接触丰富任务为什么死在最后一次接触
这一节先把问题拆开:S2C 之所以要分阶段,是因为接触丰富任务里同时在漂移两样东西,而它们的解药完全不同。
失败不在"看见",在"贴合"
论文开头给的动机很具体:工业装配里的紧配合插入,间隙可能小于 0.1 毫米。这个尺度上,接触动力学对表面粗糙度、装配公差、夹爪柔性都敏感,仿真里很难建准,所以接触丰富任务历来有大的 sim-to-real 落差。
注意这句话的落点。它说的不是"看不见孔",而是"贴合那一下的物理过程建不准"。这就决定了强化学习只能上真机:仿真是可以用来练视觉的,但练不出一套能迁移的接触模型。于是论文的选择是"完全不要仿真",连视觉随机化也搬到真机图像上做。
单阶段端到端 RL 的三个死结
把六个任务交给一个策略从头学,会同时撞上三堵墙。
- 探索空间太大。工作空间是按整张工作台给的,位置随机化 5 到 10 厘米、姿态随机化 10 到 30 度,策略要在里面自己撞到孔。SERL 不用人干预,六个任务全 0/20,训练还都是 120 分钟,这就是纯探索的下场。
- 观测里有捷径。腕部相机看得到桌布、桌面、背景杂物,而背景在每个回合里是恒定的。对策略来说,记住"这块黑桌布加这个角度等于工位在这"比学接触动力学便宜得多。于是换个背景就整段失效。
- 信用分配被拉长。episode 上限 100 步,奖励是稀疏的完成奖励,接触成功那一刻的功劳要摊回前面几十步的接近动作。
这三个死结里,第一个是空间问题,第二个是观测问题,第三个是时间问题。它们能被同一个网络吸收,但不能被同一个网络解决——这正是分阶段的动机。
两阶段的直觉:先进入语义邻域,再闭环保边
论文的说法是"机器人是感知、规划、控制紧耦合的系统,视觉泛化不可能靠优化单个模块得到"。这句话翻译成工程语言是:把两类泛化问题按"谁有能力解决"切开。
- 语义泛化交给预训练的 VLM。开放词表里"USB 口"“插排上的三孔插座”"试管架最右列最上面那个空位"这些概念本来就存在,换桌布不影响它的判断。
- 接触泛化交给真机 RL。力反馈、阻抗、毫米级修正这些只能在真机上试出来,预训练模型给不了。
切完之后,两段的成功是串联关系:先到达接触区附近,再完成插入。图 1 把它标成了 80% 与 20%——“VLM 规划先完成 80% 的无接触任务,RL 智能体再完成 20% 的接触任务”。这个 80/20 是图上的定性标注,不是统计量,论文没有给测量方法,读的时候别当成实测比例。
阶段怎么切:一条边界、两种信号
这一节回答三个具体问题:两段的输入输出各是什么、切换由谁触发、语义层与接触层之间到底传了什么。
两个阶段的输入输出对照
| 传感器 | 固定第三视角 RGB-D | 双腕 RGB、tcp_pose、tcp_vel、tcp_f/t |
| 核心模块 | MolmoPoint-8B(冻结)+ 运动规划基元 | ACT 基座(冻结)+ 残差 SAC + 人工干预 |
| 输出 | 基座系下的接触前目标点 p_target | 末端位姿增量 6 维 + 夹爪 1 维 |
| 学习 | 不学习,少样本提示 + 手眼标定 | 行为克隆 + 真机在线强化学习 |
| 频率 | 每个回合一次(论文正文口径) | 每个控制步 |
| 主责指标 | 定位是否落在接触区 | 是否在限时内完成插合 |
| 主要失败形态 | 点错位置、深度跳变、外参漂移 | 卡死、打滑、插入偏斜、背景过拟合 |
谁触发切换,按什么信号
这是全文最该盯、也最容易读漏的一处:论文没有把切换判据写出来。
正文的定义是"一旦机器人到达接触前区域",剩下的交给残差策略。但"到达"没有判据:没有位置阈值、没有力阈值、没有超时、没有失败回退。实现上它被一个运动规划基元承担——规划到 p_target 就结束,控制权转交 RL。也就是说,切换信号是"规划执行完毕"这个事件,而不是任何来自接触状态的量。
更麻烦的是口径不一致。正文说 VLM 在"每个回合开始时"调用一次,而算法 1 的第 4 行把 Φ_VLM 写在 for t = 0 to T 的循环体里,读起来像每步都调用。两者对部署成本的影响差两个数量级:一次调用是 2 秒,每步调用在 100 步的 episode 里根本不可能。论文没有解释这个矛盾,我倾向于认为正文口径是对的(与"2 秒推理"的可用性论证一致),算法伪码写松了。
语义层与接触层之间只有一个 SE(3) 点
这是我认为这篇论文最值得抄的设计:接口被压到极窄,只有一个三维点加一次运动规划。
接口窄带来三个直接好处。
- 两段可以独立替换。表 4 就是把 VLM 换成 YOLOE、SAM 3、Qwen3-VL、GPT-5.5 API 做对比,下游 RL 一行不改。
- 失败可以定位。定位错了就是定位错了,不会以"隐变量漂移"的形式糊进动作分布里。
- 没有梯度耦合。不需要考虑两段的优化目标互相打架,也就不需要冻结、隔离、课程这些补丁。
代价同样明确:一个点不含姿态。VLM 只回答"孔在哪",不回答"夹爪该用什么角度进"。所以朝向误差全部压给第二阶段,这也解释了为什么残差策略的姿态边界要给到正负 10 度、部分任务正负 60 度。点也不含可达性、不含抓取可行性——如果点落在机械臂够不到的地方,第一阶段不会知道。
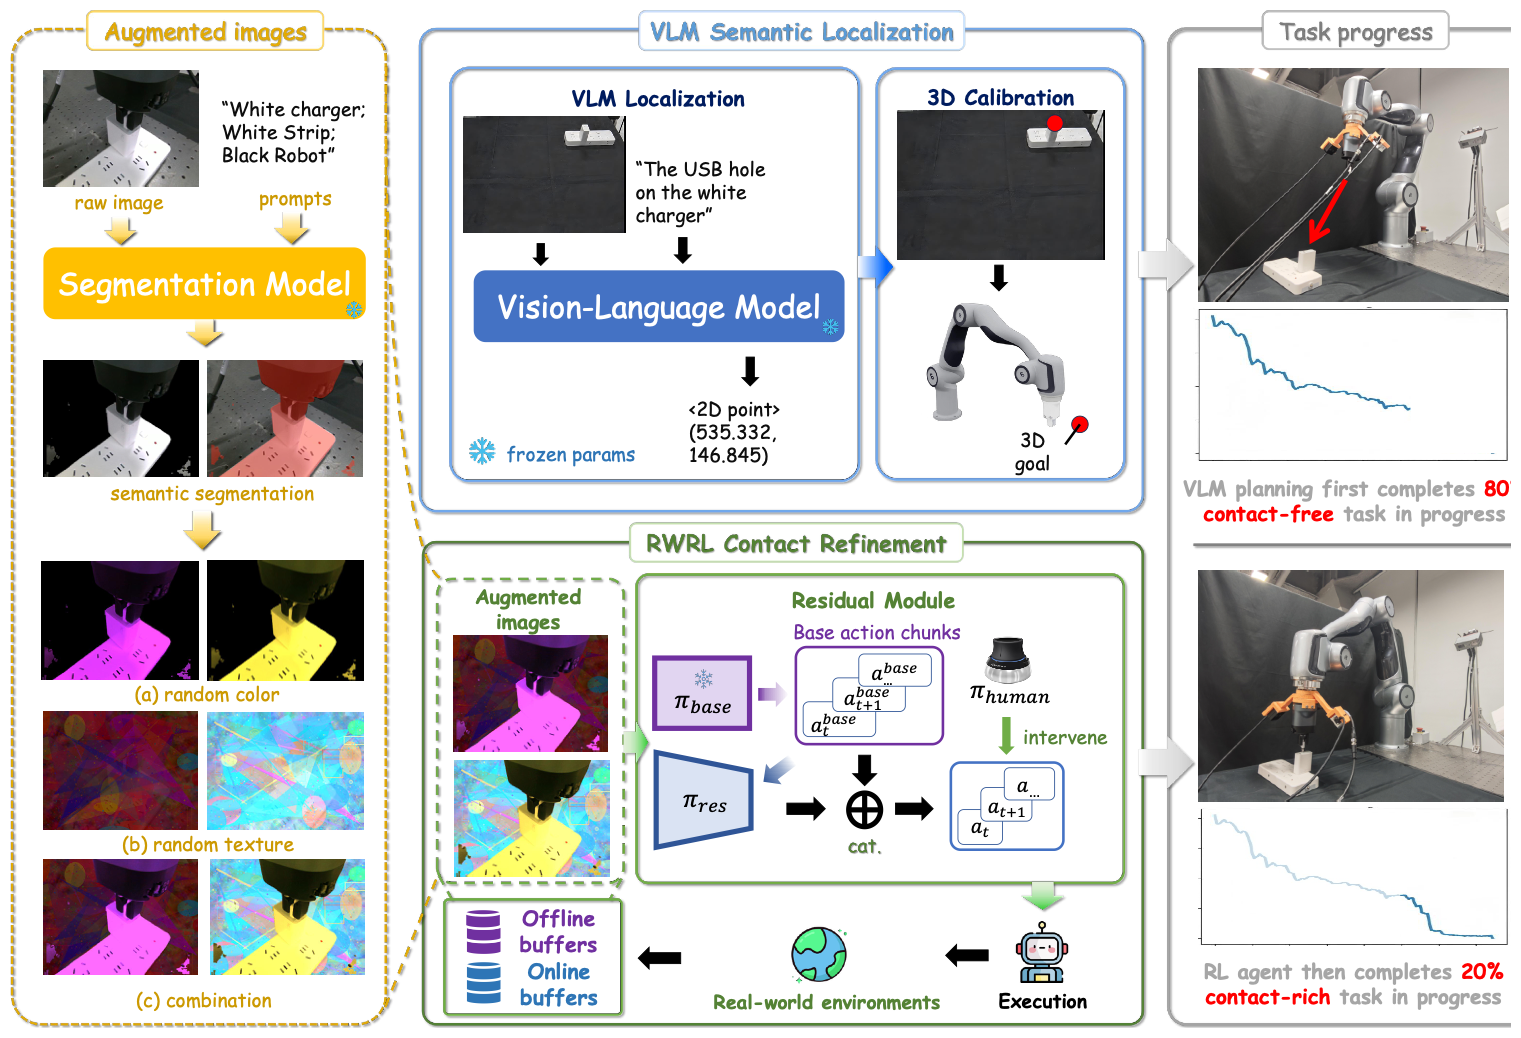
图 1|左侧是把腕部图像的前景抠住后做颜色、纹理与组合三种随机化;中间是语义聚焦(VLM 输出二维点,经三维标定变成目标)与接触精修(基座策略出动作块、残差策略出修正、人可介入、双缓冲回收)两条链路;右侧是任务进度曲线,标出 VLM 先做 80% 无接触段、RL 再做 20% 接触段。
第一阶段:把一个点变成 SE(3)
这一节讲清楚一个二维像素怎么变成机械臂能执行的三维目标,以及为什么模型选的是 MolmoPoint 而不是更强的通用 VLM。
MolmoPoint-8B 的 2 秒与 GPT-5.5 的 15 秒
论文在选型阶段横向比了五个模型,只在 Charger 插入这一个任务上、每个 10 次真机试验。
| YOLOE | 0.07 秒 | 0/10(0%) |
| SAM 3 | 0.12 秒 | 3/10(30%) |
| Qwen3-VL-8B | 2.00 秒 | 5/10(50%) |
| GPT-5.5 API | 15.00 秒 | 10/10(100%) |
| MolmoPoint-8B | 2.00 秒 | 10/10(100%) |
这张表最容易被误读成"越慢越准"。真实结论是"在同等精度下选最快的那一个":GPT-5.5 和 MolmoPoint 都是 10/10,但前者 15 秒、后者 2 秒,论文正文写 GPT-5 API 是"至少 10 秒",表 4 实测 15.00 秒,两处口径略有出入但方向一致。
更值得注意的是另外三行。YOLOE 0.07 秒却 0/10,SAM 3 0.12 秒 3/10——快不等于能用,检测式的定位在"同色邻近物体"面前会失效,而插座周围恰好全是白色塑料。Qwen3-VL 2 秒只有 5/10,论文说它在 affordance 预测和点式定位上下游表现不如 MolmoPoint,还会偶发大偏差。作者对这条大偏差的评语是"可能带来安全风险"——但全文没有给出任何针对大偏差的保护机制(比如置信度阈值、二次校验、越界拒动)。这是一个我读出来的缺口。
MolmoPoint 的机制值得一提:它不靠外接检测头,而是直接从视觉 token 里选出包含目标的那个,再生成额外 token 精修位置。所以它输出的是"指认",不是"框"。对"插孔中心"这种细粒度目标,"指"比"框"更贴近需求。
深度反投影与外参:点如何落到基座系
拿到二维点之后是标准三步:查深度、乘内参逆、乘手眼外参。论文写成两行。
clt=Dt(ult,vlt) K−1[u,v,1]⊤∈R3
c_l^{t}=D_t(u_l^{t},v_l^{t})\\,K^{-1}[u,v,1]^{\\top}\\in\\mathbb{R}^{3}
clt=Dt(ult,vlt)K−1[u,v,1]⊤∈R3
ptargetbase=Tcambase⋅cl∈SE(3)
p_{\\mathrm{target}}^{\\mathrm{base}}=T_{\\mathrm{cam}}^{\\mathrm{base}}\\cdot c_l\\in SE(3)
ptargetbase=Tcambase⋅cl∈SE(3)
K 是相机内参,D_t 是深度图,T_cam^base 由 eye-to-hand 方式标定,第三视角相机固定不动。论文提到标定经过一块六孔板,之后所有回合复用同一套外参。
这两行意味着误差是三项直接相加:点选误差进 (u,v),深度噪声进 D_t,标定残差进 T_cam^base,最后全部落到 p_target 上,成为第二阶段的初始条件。论文没有报告任何一项的分布——没有点选误差统计、没有标定重投影误差、没有深度在图上的噪声水平。复现时这三项是第一个要量的东西,因为它们直接决定残差策略要吃多大的初始偏差。
语义失败会长什么样
把表 4 和表 5 放在一起看,语义失败有两种形态,后果完全不同。
- 小偏差。点落在孔边缘外侧一点点。这种错第二阶段能吃下去,残差策略本来就是干这个的。
- 大偏差。点落在旁边的插座、或者干脆落在桌面上。这种错第二阶段吃不下——残差能吃的是随机化那一档,5 到 10 厘米、10 到 30 度,超出就无从下手。
论文对第二种形态只有一句"偶发大偏差可能带来安全风险",没有量化发生频率。这是全文我认为最该补的一个数:定位偏差的分布,比平均成功率更能说明这套框架什么时候能用。
第二阶段:残差 RL 与人回路的三层接口
第二阶段要解决的问题很小也很硬:初始位姿有偏、接触面有摩擦、力反馈有噪声,怎么在几十毫米里把插头送进去。论文用三层结构处理它。
第一层:ACT 基座只负责走到位
基座是行为克隆出来的 ACT,损失就是最朴素的均方误差。
θbase∗=argminθEDexp∥πθbase(o~t)−at∥22
\\theta^{*}_{\\mathrm{base}}=\\arg\\min_{\\theta}\\mathbb{E}_{\\mathcal{D}_{\\mathrm{exp}}}\\left\\|\\pi^{\\mathrm{base}}_{\\theta}(\\tilde{o}_t)-a_t\\right\\|^{2}_{2}
θbase∗=argθminEDexpπθbase(o~t)−at22
基座策略的训练数据是每个任务 30 到 40 条专家示教(分任务看:试管易 30、试管中 40、充电器 38、试管难 40、USB 易 35、USB 难 35),先预训练 5000 个 epoch。它提供的是"接近加大致对准"的行为,把随机探索的量压下去。
但论文对它的评价很克制:行为克隆受示教覆盖限制,在视觉漂移、位姿扰动和接触不确定性下仍会失败。这句话在表 1 里有对应——单独用 ACT,六个任务加起来 3/120,2.50%。
第二层:残差动作只学补多少
残差 RL 的做法是不替换基座,只学一个加性修正。
atRL=atbase+Δat
a_t^{\\mathrm{RL}}=a_t^{\\mathrm{base}}+\\Delta a_t
atRL=atbase+Δat
Δat∼πθres(⋅∣o~t,abase,g)
\\Delta a_t\\sim\\pi_\\theta^{\\mathrm{res}}(\\cdot\\mid\\tilde{o}_t,a^{\\mathrm{base}},g)
Δat∼πθres(⋅∣o~t,abase,g)
π_res 是一个 256×256 的 MLP,用 SAC 训练,双 Q 网络加目标网络,熵系数 α,折扣 0.98。探索空间从"完整动作"缩到"修正量",这是训练时间能压到 20 到 90 分钟的直接原因——同样的任务,HIL-SERL 要 30 到 120 分钟。
这里有个设计细节值得说:残差策略的输入里带 a_base。也就是说它知道自己要修正的是哪条动作,而不是只看观测猜。这让"补多少"变成一个条件化的回归问题,比无条件探索稳得多。
第三层:人的干预怎么进缓冲区
人在回路的接口是一个二值开关。
lt∈{0,1}
l_t\\in\\{0,1\\}
lt∈{0,1}
at=atRL (lt=0),at=atH (lt=1)
a_t=a_t^{\\mathrm{RL}}\\ \\ (l_t=0),\\qquad a_t=a_t^{H}\\ \\ (l_t=1)
at=atRL (lt=0),at=atH (lt=1)
论文没有在正文给出 l_t 的触发规则(这属于既有 HIL-SERL 的约定),但给了数据流向:自主执行和干预产生的转移分别进 D_online 与 D_offline,每轮更新从两个池各采一半。干预动作只进离线池,因为它是人的动作,不是策略的分布——混在一起会把策略往人的手感上拽。
消融里"去掉 HIL"是 0/20、0/20,两档全灭。这说明这一层不是加速项,是必要项:没有人在不安全或无进展状态下手动接管,真机上的随机探索根本走不完。
把三层拼成一个回合
# 仅示意,非原文伪码
每回合开始:
l ← 语言指令
p ← MolmoPoint(RGB-D, l) # 约 2 秒
p_base ← T·D(p)·K^-1·[u,v,1]
规划到 p_base # 第一段结束
循环 t = 0..T:
o~ ← Augment(wrist_1, wrist_2)
a_base ← π_base(o~) # ACT
Δa ← π_res(o~, a_base) # 残差
a ← a_base + Δa # 或取 a_H
执行 a,写 D_online / D_offline
每 c 步: 各采 N/2,更新 Q 与 π_res
腕部视角窄得只剩接触区
第二阶段的观测只有双腕图像加本体感受,第三视角的语义信息在这里完全缺席。这个选择是有意的——接触发生在夹爪正下方,第三视角根本看不清——但它同时决定了视觉扰动的伤害集中在哪。

图 2|试管插入(易)任务的两路腕部输入:左视图里试管架占据大半画面、夹爪与试管在右侧,右视图几乎只剩夹爪、试管和一小块架子,桌面与远处地面都进了背景。

图 3|充电器抓取插入任务的两路腕部输入:接触区(插排上的三孔)在画面里只占很小一块,两个视角都被白色塑料和金属台面填满,这正是对象中心增广要处理的那种背景。
看这两组图就能理解为什么 HIL-SERL 会崩:它的观测同样来自腕部相机、同样被背景填满,只是没有掩码这一步,于是背景纹理直接进了策略的输入分布。
让策略别看背景:对象中心增广
这一节是全文最工程的部分,也是消融里贡献最大的一块。它要解决的不是"看不见物体",而是"看得太清楚背景"。
YOLOE 掩码:把前景锁住
做法是先用提示式分割把该保留的像素圈出来。论文选 YOLOE 的理由是轻量到可以在线做预处理,并且支持文本提示与视觉提示两种方式。
Mt,k=fYOLOE(Pt,kwrist,L),k∈{1,2}
M_{t,k}=f_{\\mathrm{YOLOE}}\\left(P^{\\mathrm{wrist}}_{t,k},L\\right),\\quad k\\in\\{1,2\\}
Mt,k=fYOLOE(Pt,kwrist,L),k∈{1,2}
L 是一组描述机械臂、夹爪和被操作物体的提示词,图 1 里给的实际例子是"White charger; White Strip; Black Robot"。M 是二值掩码,1 表示保留(机械臂、夹爪、被操作物体、与接触相关的结构),0 表示背景。
论文明确解释了为什么用文本提示而不是视觉提示:腕部相机跟着机械臂动,给出的参考图提供不了有效引导。这是个很实的工程判断,很多实现会在这里踩坑。
背景替换与前景抖动
掩码拿到之后做两件事:背景换成随机纹理,前景做颜色抖动。
P~t,kwrist=Mt,k⊙Afg(Pt,kwrist)+(1−Mt,k)⊙Bt,k
\\tilde{P}^{\\mathrm{wrist}}_{t,k}=M_{t,k}\\odot A_{\\mathrm{fg}}\\left(P^{\\mathrm{wrist}}_{t,k}\\right)+(1-M_{t,k})\\odot B_{t,k}
P~t,kwrist=Mt,k⊙Afg(Pt,kwrist)+(1−Mt,k)⊙Bt,k
B 从增广分布 q(B) 里采样,分布里含随机颜色、纹理和视觉干扰物;A_fg 是随机颜色抖动加亮度变化。关键在于:几何与语义结构全部保留,只有外观被随机化。
这一点和仿真域随机化的差别值得强调。仿真里做随机化要先有 3D 资产、要建模材质、要保证物理仍然可信;这里物理一直是真实的,只有图像级的外观被替换。论文的说法是"不需要建模和 3D 资产,物理交互保持真实,任务无关的视觉因素在图像层面被随机化"。

图 4|YOLOE 在验证集上的分割样例:三帧腕部图像里 white strip 分别给出 0.9、0.9、0.8 的置信度,掩码覆盖插排本体,夹爪与线缆被正确留在掩码外。
线性探针:透明物体的补丁
提示式分割不是万能的。论文自己承认:物体透明、或者与背景颜色接近时,掩码会不干净。补丁是一个轻量线性探针——冻结 YOLOE 主干,只训一个线性分割头。
ψ∗=argminψEDmask[Lseg(M^,M∗)]
\\psi^{*}=\\arg\\min_{\\psi}\\mathbb{E}_{\\mathcal{D}_{\\mathrm{mask}}}\\left[\\mathcal{L}_{\\mathrm{seg}}\\left(\\hat{M},M^{*}\\right)\\right]
ψ∗=argψminEDmask[Lseg(M^,M∗)]
M^=hψ(fYOLOE(P))
\\hat{M}=h_{\\psi}\\left(f_{\\mathrm{YOLOE}}(P)\\right)
M^=hψ(fYOLOE(P))
标注用 Label Studio 的多边形工具,只标需要微调的类别。这个设计的取舍很清楚:不重训分割模型,只在一个已有特征上加一层线性读出,代价是一小批人工标注,收益是掩码质量。论文没有给这个标注集的规模,也没有给微调前后的掩码 IoU 对比,只给了图 9 的定性样例。
实验:6 个任务、5 个基线、全在真机
这一节先把平台和任务说清,再逐张表看数字。所有实验都在真机上,没有仿真环节。
任务集与平台
平台是一台 Agile Diana 力控机械臂,单臂 7 自由度,阻抗控制,但交互仍然通过发送末端位姿指令完成。遥操作用 3D SpaceMouse 发送增量位姿,人回路干预和数据采集都用它。相机是 RealSense D405 与 Kingfisher 深度相机。VLM 部署在 A800 上走客户端-服务器通信,真机 RL 用 5090 训练,模仿学习用 A800。
六个任务都是接触丰富的原子技能:一是充电器抓取插入,抓起插头插进插排;二是 USB 插入易档,插头已在夹爪里、充电器固定;三是 USB 插入难档,充电器位置在若干预设点里随机;四是试管插入易档,固定孔位;五是试管插入中档,连续插一排六根;六是试管插入难档,插进一排试管里随机空出的位。论文特意强调整个实验在自然工业环境里做,没有用黑布遮挡。
指标只有两个:成功率 SR(限时内完成的比例)和训练时间 TT(在线训练分钟数)。TT 只统计学习器侧的 actor-critic 优化时间,因为真机采样和优化是两个进程,这个口径要说清——它不等于墙钟时间。
主表:94.17% 与那 2.4 个点
| ACT | 2.50% | 未报 |
| SERL | 0.00% | 720 分钟 |
| Octo-small | 5.83% | 未报 |
| HIL-SERL | 90.83% | 480 分钟 |
| HIL-ConRFT | 91.76% | 350 分钟 |
| S2C | 94.17% | 320 分钟 |
再把三个人在回路方法按任务拆开,每格 20 次:
| 充电器抓取插入 | 19/20 | 18/20 | 20/20 |
| USB 插入(易) | 20/20 | 20/20 | 20/20 |
| USB 插入(难) | 18/20 | 19/20 | 20/20 |
| 试管插入(易) | 20/20 | 20/20 | 20/20 |
| 试管插入(中) | 16/20 | 16/20 | 17/20 |
| 试管插入(难) | 16/20 | 17/20 | 16/20 |
时间一列是我按表 1 逐任务相加,论文只给单任务数值;ACT 与 Octo-small 未报训练时间。ACT 与 Octo-small 的逐任务数字都在 0/20 到 5/20 之间,合计 3/120 与 7/120。
三个梯队分得很干净。纯模仿学习的 ACT 与预训练大策略 Octo-small 在 2.50% 与 5.83%,说明"会抓不会插"是行为克隆的通病。不用人干预的 SERL 是 0%,六个任务全灭且每个都要 120 分钟。两个人在回路基线到了 90.83% 与 91.76%,S2C 是 94.17%。
S2C 相对 HIL-SERL 的增益是 3.34 点,相对 HIL-ConRFT 是 2.41 点。这个幅度不算惊人,但要看两件事:一是它把 Charger、USB 易、USB 难三个任务做到了 20/20,二是它的学习器时间更短(合计 320 分钟对 480 分钟)。论文的解释是残差设计加 VLM 引导共同缩短了训练。
一处小账要提:HIL-ConRFT 的逐项相加是 110/120,也就是 91.67%,论文写 91.76%,差 0.09 点。这不影响排序,但说明表里的平均值是按逐任务百分比的均值算的,不是按总次数算的。
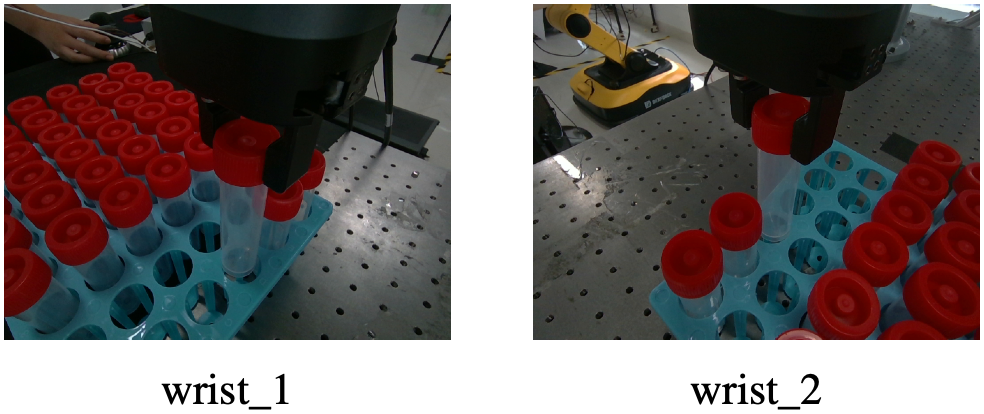
图 5|试管插入(中)任务的两路腕部输入:已经插好的试管在画面里形成密集遮挡,机器人要在不碰倒邻管的前提下把下一根对准空位,这是六个任务里唯一有多步顺序结构的。
视觉扰动:0% 与 78.75% 之间
四组设置都叠加了位置变化,每格 20 次:
| 花纹桌布 | 0.00% | 0.00% | 69.17% |
| 强阳光 | 0.00% | 0.00% | 84.17% |
| 彩光 | 0.00% | 0.00% | 79.17% |
| 闪光加红桌布 | 9.17% | 13.33% | 82.50% |
这四组是全文最有说服力的地方,也是最容易被过量解读的地方。
先看事实:两个人在回路基线在训练用的黑桌布上能到 90% 上下,一旦换背景就跌到 0% 到 13.33%;S2C 在同样条件下 69.17% 到 84.17%,四组平均 78.75%。论文的解读是"这些策略对任务无关的视觉线索高度敏感,倾向于过拟合训练场景的外观"。
再看该怎么读。第一,这四组都叠加了位置变化,所以它测的是"视觉加位置"的联合扰动,不是纯视觉。第二,S2C 自己也没到 90%——69.17% 这一组掉了 25 点左右,说明增广压得住背景但压不住全部。第三,0% 这个数字很刺眼,但它的成因是"腕部观测被背景污染加策略把背景当特征",而不是"基线方法本身不会插"——同一个基线在黑桌布上是 90.83%。
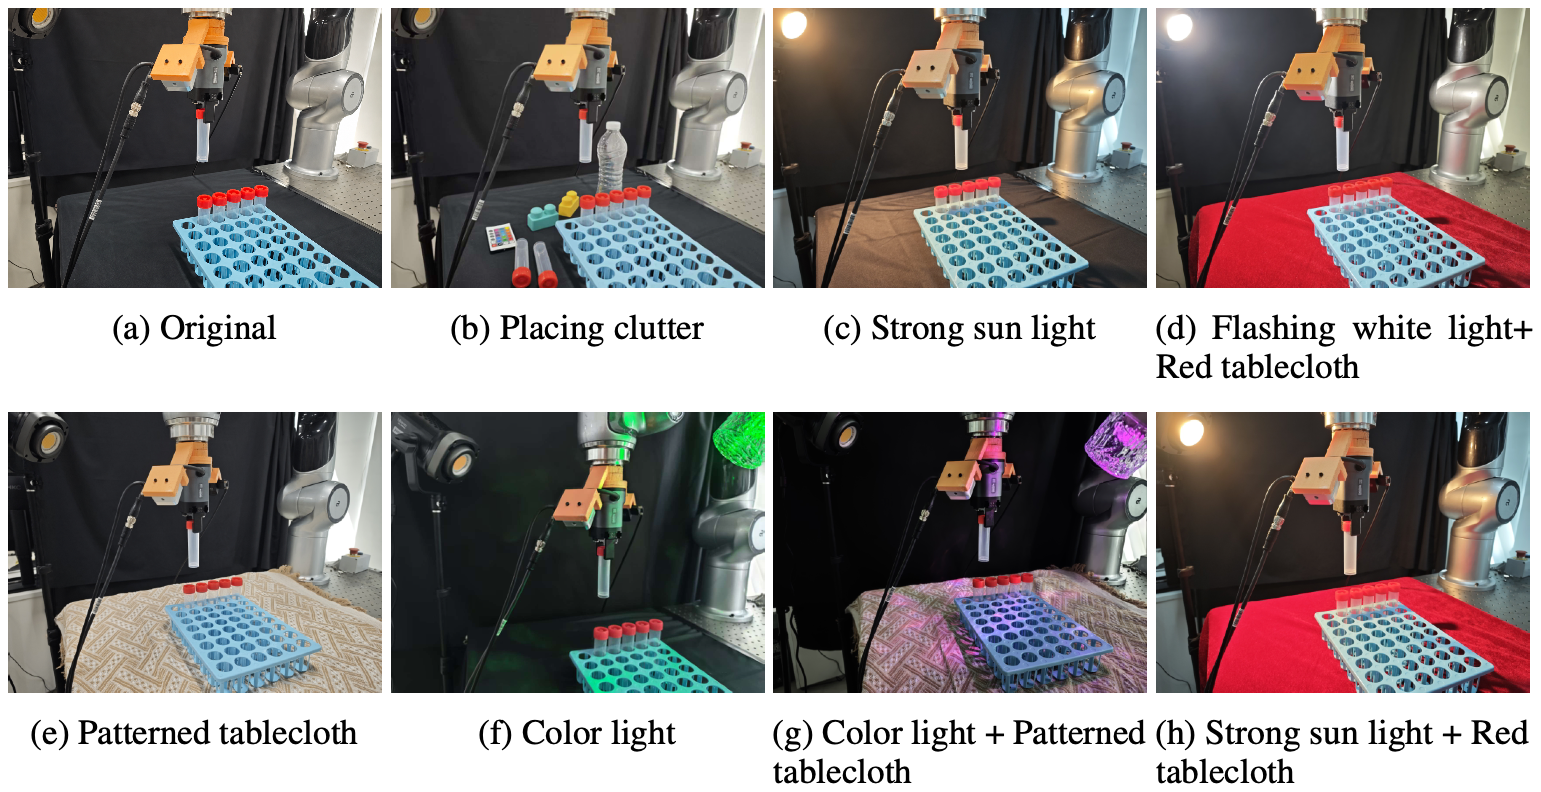
图 6|八种视觉设置:(a) 原始,(b) 周围放杂物,© 强阳光,(d) 闪光加红桌布,(e) 花纹桌布,(f) 彩光,(g) 彩光加花纹桌布,(h) 强阳光加红桌布;所有设置都保持机械臂、试管架与试管本身不变。
消融:谁在扛鲁棒性
消融只在两个任务上做(Charger 与 USB 难),每档 20 次,选的是两种最狠的复合扰动。
| 去掉 HIL | 0.00% | 0.00% |
| 去掉 VLM 引导 | 55.00% | 57.50% |
| 去掉对象中心增广 | 0.00% | 7.50% |
| 去掉接触精修 | 0.00% | 0.00% |
| 完整 S2C | 75.00% | 77.50% |
读法要按"去掉谁、剩什么"来看,不能只看数字大小。
- 去掉对象中心增广是最致命的:0% 与 7.50%,比去掉 VLM 更狠。这说明抗视觉的主承重是增广,不是语义定位。
- 去掉 VLM 是 55.00% 与 57.50%,掉了 20 点左右。注意这时增广还在,所以它测的是"语义引导减少探索难度"这一项的净贡献,而不是"没有语义会不会崩"。
- 去掉接触精修是 0%。语义能把你送到孔边,但送不进孔里。
- 去掉 HIL 也是 0%。这一项和上一项经常被混着说,其实测的是两件事:前者测接触这一段要不要专门学,后者测真机 RL 要不要人兜底。
论文对增广与 VLM 的关系有一句很准的总结:可靠的语义定位本身不足以阻止局部策略过拟合任务无关的视觉线索,VLM 起的是辅助作用。这句话和表里的数字是对得上的——增广去掉就归零,VLM 去掉只掉 20 点。
可扩展边界:A 到 I 的九个探针
为找泛化边界,论文设计了九个探针,每个 10 次。
| A | 工作台周围放杂物 | 10/10 | 10/10 |
| B | 换不同颜色的桌布 | 9/10 | 8/10 |
| C | 插排里出现分布外物体 | 0/10 | 3/10 |
| D | 强光,静止或闪烁 | 10/10 | 10/10 |
| E | 彩光照射 | 8/10 | 8/10 |
| F | 对机械臂施加轻微外力 | 10/10 | 10/10 |
| G | 室内灯开或关 | 10/10 | 10/10 |
| H | 执行中微调插入位置 | 10/10 | 10/10 |
| I | 换成黑色充电器 | 0/10 | 0/10 |
这张表把"泛化"拆成了两条轴,而两条轴的结论完全相反。
- 环境轴很稳:A、D、E、F、G、H 六项都在 8/10 以上,其中 F(施加外力)和 H(执行中改位置)是 10/10。这两个恰好是最像真实产线意外的扰动,能稳住说明残差策略的闭环确实在起作用。
- 物体轴很脆:C(插座里有别的东西)和 I(换黑色充电器)直接归零。论文的原话是"主要限制来自改变任务关键接触区外观与几何的扰动"。
这个不对称是这套框架的结构性特征,不是调参能解决的。语义层用的是"白充电器""白插排"这类文本提示,物体一换色,提示就指错;而增广只随机化背景,前景被刻意保留,所以前景一变就在分布外。两条路都往同一个方向失效。
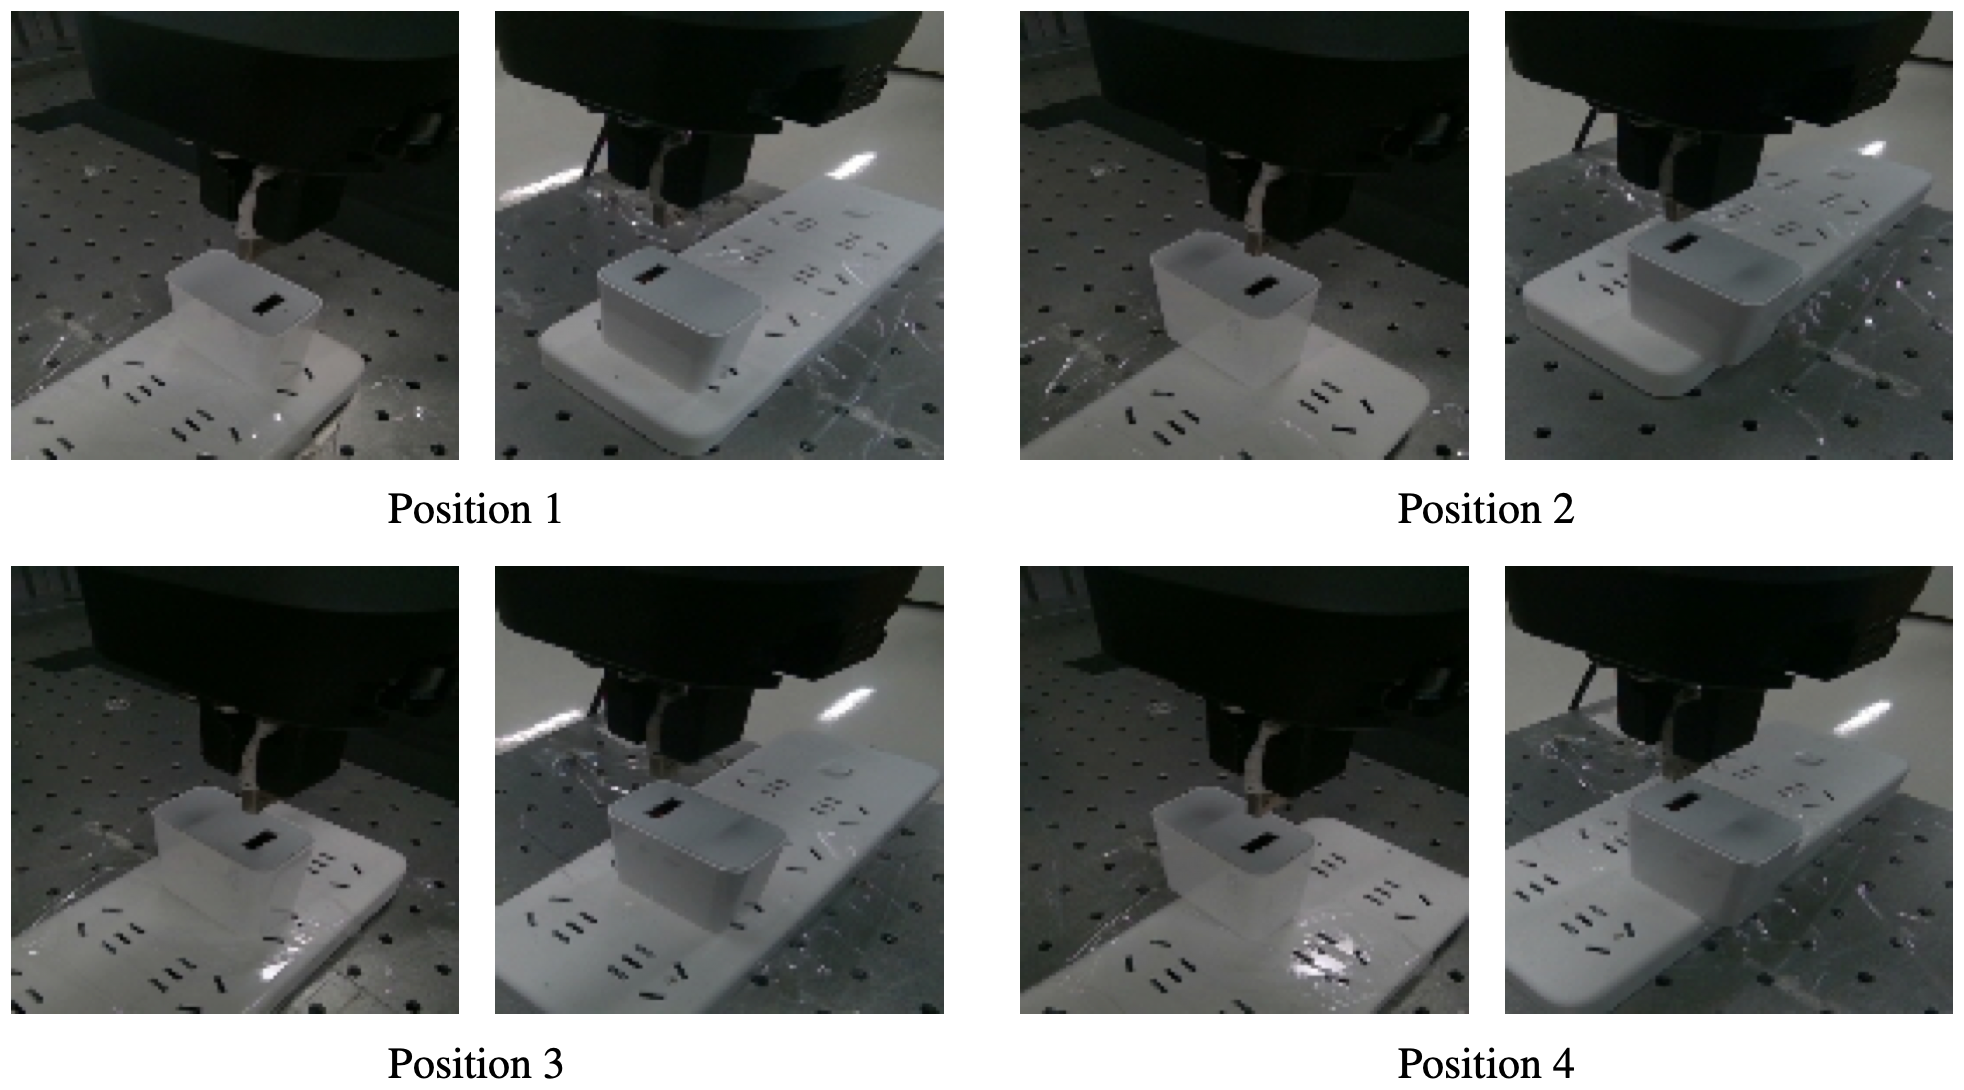
图 7|USB 插入(难)任务的四个目标位置:同一只夹爪、同一个插排,插排本体在画面里平移,目标孔相对夹爪的位置每回合都不同;这类位置不确定性正是残差策略要吃掉的那部分。
训练数据与算力账
这一节把一个常被含糊过去的问题说清:数据到底从哪来。
- 语义层不训练。MolmoPoint-8B 是现成模型,靠少样本提示工作,图 1 里明确标了 frozen params。唯一涉及训练的是 YOLOE 那层线性探针,用 Label Studio 标的多边形掩码,规模论文没给。
- 接触层的示教数据是每个任务 30 到 40 条专家轨迹,用 SpaceMouse 遥操作采集,进 D_offline。
- 接触层的在线数据是策略自己跑出来的转移,加上人干预时的动作,分别进 D_online 与 D_offline。
- 基线对照里,ACT 与 Octo-small 用 50 条样本训练,ACT 训 10000 个 epoch,Octo-small 训 20000 个 epoch;S2C 的基座策略用 40 条样本预训 5000 个 epoch。
- 算力:VLM 在 A800,真机 RL 在 5090,模仿学习在 A800。
所以这套方法的数据成本是 30 到 40 条示教加每任务 20 到 90 分钟学习器时间,没有仿真资产、没有大规模预训练、没有互联网数据。这是它和 VLA 路线最本质的差别:VLA 把成本前置到预训练,S2C 把成本放在每个任务的现场调试。
阶段化会不会把错误累积放大
这是分阶段方案绕不开的质疑:两段串联,前一段错了后一段还有没有救?论文没有专门的一节回答它,但散在四处的证据能拼出答案。
原文给出的失败证据
四条,按硬度排序。
- 表 4 是硬证据:同一个第二段(同一套 RL、同一批示教),只换定位模块,成功率从 0/10 到 10/10。YOLOE 定位失败时,第二段一次都没救回来。这说明串联的第一段是硬门,不是软先验。
- 去掉 VLM 是 55.00% 与 57.50%,比完整版低 20 点左右。这是"第一段变弱但不消失"的情形,此时第二段能吃下大部分偏差。
- 去掉接触精修是 0%。反过来证明第二段不可省。
- 探针 C 与 I 是 0/10。这两条不是定位算法变差,而是"接触区本身变了",属于第一段的输入分布外。
三条传播路径
把上面四条整理成机制,错误其实是三条不同的路进到最终失败里的。
三条路径的差别很重要:第一条是串联放大,第二条是串联与门,第三条是并联旁路。所以"阶段化会不会放大错误"这个问题没有单一答案,要分路径看。
为什么这里没有雪崩,但有归零
我的判断是:这套设计把误差截断在段边界上,代价是取消了所有补救。
截断的机制是接口窄。第一段只交一个三维点,不交轨迹、不交隐变量、不交置信度。好处是第一段的错误不会以"平滑污染"的形式渗进动作分布——它要么把点送对,要么把点送错,没有中间态。这也是为什么表 4 的对比那么干净:换定位器,成功率在 0% 和 100% 之间跳,没有中间地带。
代价是没有重试。真实系统里,人对这种情况的处理是"没插进去就退出来看一眼再插",也就是重定位。S2C 没有这个环:一个回合一次定位,失败就结束。而重定位在成本上是可行的——MolmoPoint 单次 2 秒,一个 episode 上限 100 步,加一次重试完全负担得起。论文没做,也没有讨论为什么不做。
还有一层是多步任务里的累积。六个任务中只有"试管插入(中)“有多步结构(连续插六根),而论文没有单独报告它的分步成功率,也没有报告"前一根插歪了会不会影响后一根”。探针 H(执行中微调位置)是 10/10,但它测的是单次插入内的扰动,不是跨步骤的误差传递。作者把长程操作明确写进了未来工作,等于承认这一块还没验证。

图 8|试管插入(难)任务的两路腕部输入:空位夹在已插好的试管之间,邻管就在夹爪两侧几厘米处;这类布局下第一段把点送偏的后果不是插不进去,而是撞倒邻管。
局限与失效场景
分两块写:作者自己写进论文的,和我读出来的。
作者自己承认的
- 物体级外观漂移。换成黑色充电器,Charger 与 USB-Easy 都是 0/10。论文把它归为"改变接触区外观与几何的扰动"。
- 接触区出现分布外物体。插排里塞了别的东西时 Charger 0/10、USB 易 3/10。
- 长程未验证。结论段把"扩展到鲁棒的长程操作"列为未来工作。
- 代码与数据未放。NeurIPS checklist 第 5 项答的是 No,理由是接收后提供。
我读出来的
- 只有单臂、桌面、刚性件。六个任务全是插拔,两个移除任务(试管取出、硬盘取出)是补充实验,用了 diffusion policy 做基座,25 与 35 分钟、90% 与 100%。没有线缆、没有柔性件、没有双臂协同、没有擦拭这类连续接触任务——而论文开头的动机里恰恰提了擦拭。
- 没有触觉。观测里的力信息是六维力/力矩,来自腕部力传感器,不是指尖触觉阵列,也不是视触觉。这意味着接触位置和滑移不可直接观测,只能从力/力矩间接推断。对"插入时卡在哪一侧"这类问题,六维力给的信息有限。
- 训练时间的口径偏乐观。TT 只算学习器侧优化,真机采样时间不计。表 1 里 S2C 的 320 分钟是优化时间,实际墙钟要加上真机 rollout,论文没给这个数。
- 统计强度有限。主表每格 20 次,可扩展表每格 10 次,没有置信区间、没有多种子、没有重复实验。checklist 第 7 项答 Yes,理由是"每个任务在多种设置下评估多次后取平均",这是跨设置平均,不是重复实验的方差。
- 消融只覆盖两个任务。结论外推到六个任务上有风险,尤其"试管中"这种多步任务完全没进消融。
- 附录的图注有复制粘贴残留。图 3 到图 8 的英文图注全部写成 hardware setup for the motherboard assembly task,但对应的任务是试管与充电器;A.3.2 还把表号写成 Table 8(应为 Table 9)。这些不影响结论,但说明附录校对不严。
- 阶段切换判据缺失,且正文与算法 1 的口径不一致(前面已展开)。这是复现时第一个会卡住的地方。
落地判断
把这篇论文当成一份"真机接触任务怎么搭"的施工图来读,比当成一个新算法来读更有用。它真正的贡献不是某个模块,而是那条切分线:语义交给预训练模型,接触交给现场学习,中间只留一个点。
什么团队值得试
四个条件,满足三个以上再动手。
- 工位固定、相机固定。第三视角相机必须固定并做过 eye-to-hand 标定,因为整套流程依赖同一套外参。相机一动就要重标,这在产线换型时是隐形成本。
- 物体外观可枚举。这套方法对"同一类物体换颜色或换材质"极脆弱(0/10),但如果你的 SKU 是固定的几种白色连接器,提示词写死就能跑。
- 有遥操作能力和人在回路的预算。示教 30 到 40 条要人拖 SpaceMouse,训练期人要盯着接管。去掉 HIL 就是 0%,这一项没有替代方案。
- 能接受按任务调参。每个任务一套提示词、一套随机化范围、一套 xyz 与 rpy 边界,不是"训一个通用策略"的路子。
成本可以估:每任务 30 到 40 条示教、20 到 90 分钟学习器时间、一张 5090 跑 RL、一张 A800 跑 VLM(也可以换小卡,2 秒延迟的 8B 模型不算重)。相比 VLA 微调路线,前期投入低、单任务上限高,但换任务的边际成本高。
什么团队别碰
- 需要一套策略覆盖多 SKU、且外观经常变。探针 I 的 0/10 已经说明了。
- 需要长程多步装配。论文自己把长程列为未来工作,唯一的多步任务(连续插六根)也没有分步分析。
- 没有人在回路预算。这不是"少一层加速",是"少一层必要条件"。
- 需要触觉级精细判断。六维力/力矩给不了接触位置与滑移,插柔性件、插线缆这类任务不在覆盖范围内。
- 想要端到端可微、想要一个统一的大模型。这套框架明确放弃了这个方向,两段之间没有梯度,也没有共享表征。
一个中间判断:如果你的场景是"固定工位加少量固定 SKU 加刚性插拔",S2C 这类分阶段方案目前的性价比明显高于端到端 VLA——它用 30 到 40 条示教就能到 90% 以上,而且失败模式是可解释的(定位错、接触没收敛、背景过拟合)。反过来,如果你的场景是"开放环境加频繁换物体",分阶段方案的两条失效轴(物体外观、接触区几何)会同时亮红灯,这时候该看的是数据规模更大的端到端路线。
术语速查表
| 语义聚焦 | semantic focusing / semantic localization | 第一阶段:用 VLM 在第三视角里点出接触区,再由运动规划把夹爪送到位 |
| 接触精修 | contact refinement | 第二阶段:在接触区附近用真机残差 RL 学毫米级修正,靠力反馈闭环 |
| 接触前目标 | pre-contact goal ĝ / p_target | 第一阶段的输出,一个基座系下的三维点,不含姿态 |
| 语义算子 | Φ_VLM | 把第三视角图像与语言指令映射成基座系目标点的复合算子 |
| 残差 RL | residual RL | 不替换基座策略,只学一个加性修正量 Δa |
| 人在回路 | human-in-the-loop,HIL | 训练时人可随时接管,干预动作单独入离线池 |
| 对象中心增广 | object-centric visual augmentation,OC-Aug | 抠住前景、随机化背景与前景外观,抗视觉过拟合 |
| 行为克隆基座 | ACT | Action Chunking Transformer,出动作块,只负责走到位 |
| 提示式分割 | YOLOE | 支持文本与视觉提示的实时分割模型,用来产前景掩码 |
| 指认式定位 | MolmoPoint-8B | 直接选视觉 token 再精修位置的点选模型,单次约 2 秒 |
| 成功率 | SR | 限时内完成的比例,主表每格 20 次试验 |
| 训练时间 | TT | 在线学习器侧 actor-critic 优化分钟数,不含真机采样 |
| 双缓冲 | D_online / D_offline | 自主转移与干预转移分开存,每轮各采一半 |
| 阻抗控制 | impedance control | 机械臂底层控制方式,上层仍发送末端位姿指令 |




