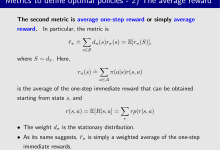
强化学习的数学原理 | 赵世钰 | 西湖大学 | 笔记 | Lecture 9 | Part 3 | 策略梯度方法(该方法的目标函数2-Average reward)
目录前言1. Metrics to define optimal policies - 2) The average reward2. Metrics to d...
目录前言1. Metrics to define optimal policies - 2) The average reward2. Metrics to d...
 admin