目录
-
- 前言
- 1. Metrics to define optimal policies – 2) The average reward
- 2. Metrics to define optimal policies – Remarks
- 3. Metrics to define optimal policies – Exercise
- 结语
- 参考
前言
学习赵老师讲授的强化学习的数学原理视频,本篇文章记录第九讲 Part 3:策略梯度方法(该方法的目标函数2-Average reward),记录个人学习笔记,和大家一起分享交流😄
video:https://www.bilibili.com/video/BV1sd4y167NS
1. Metrics to define optimal policies – 2) The average reward
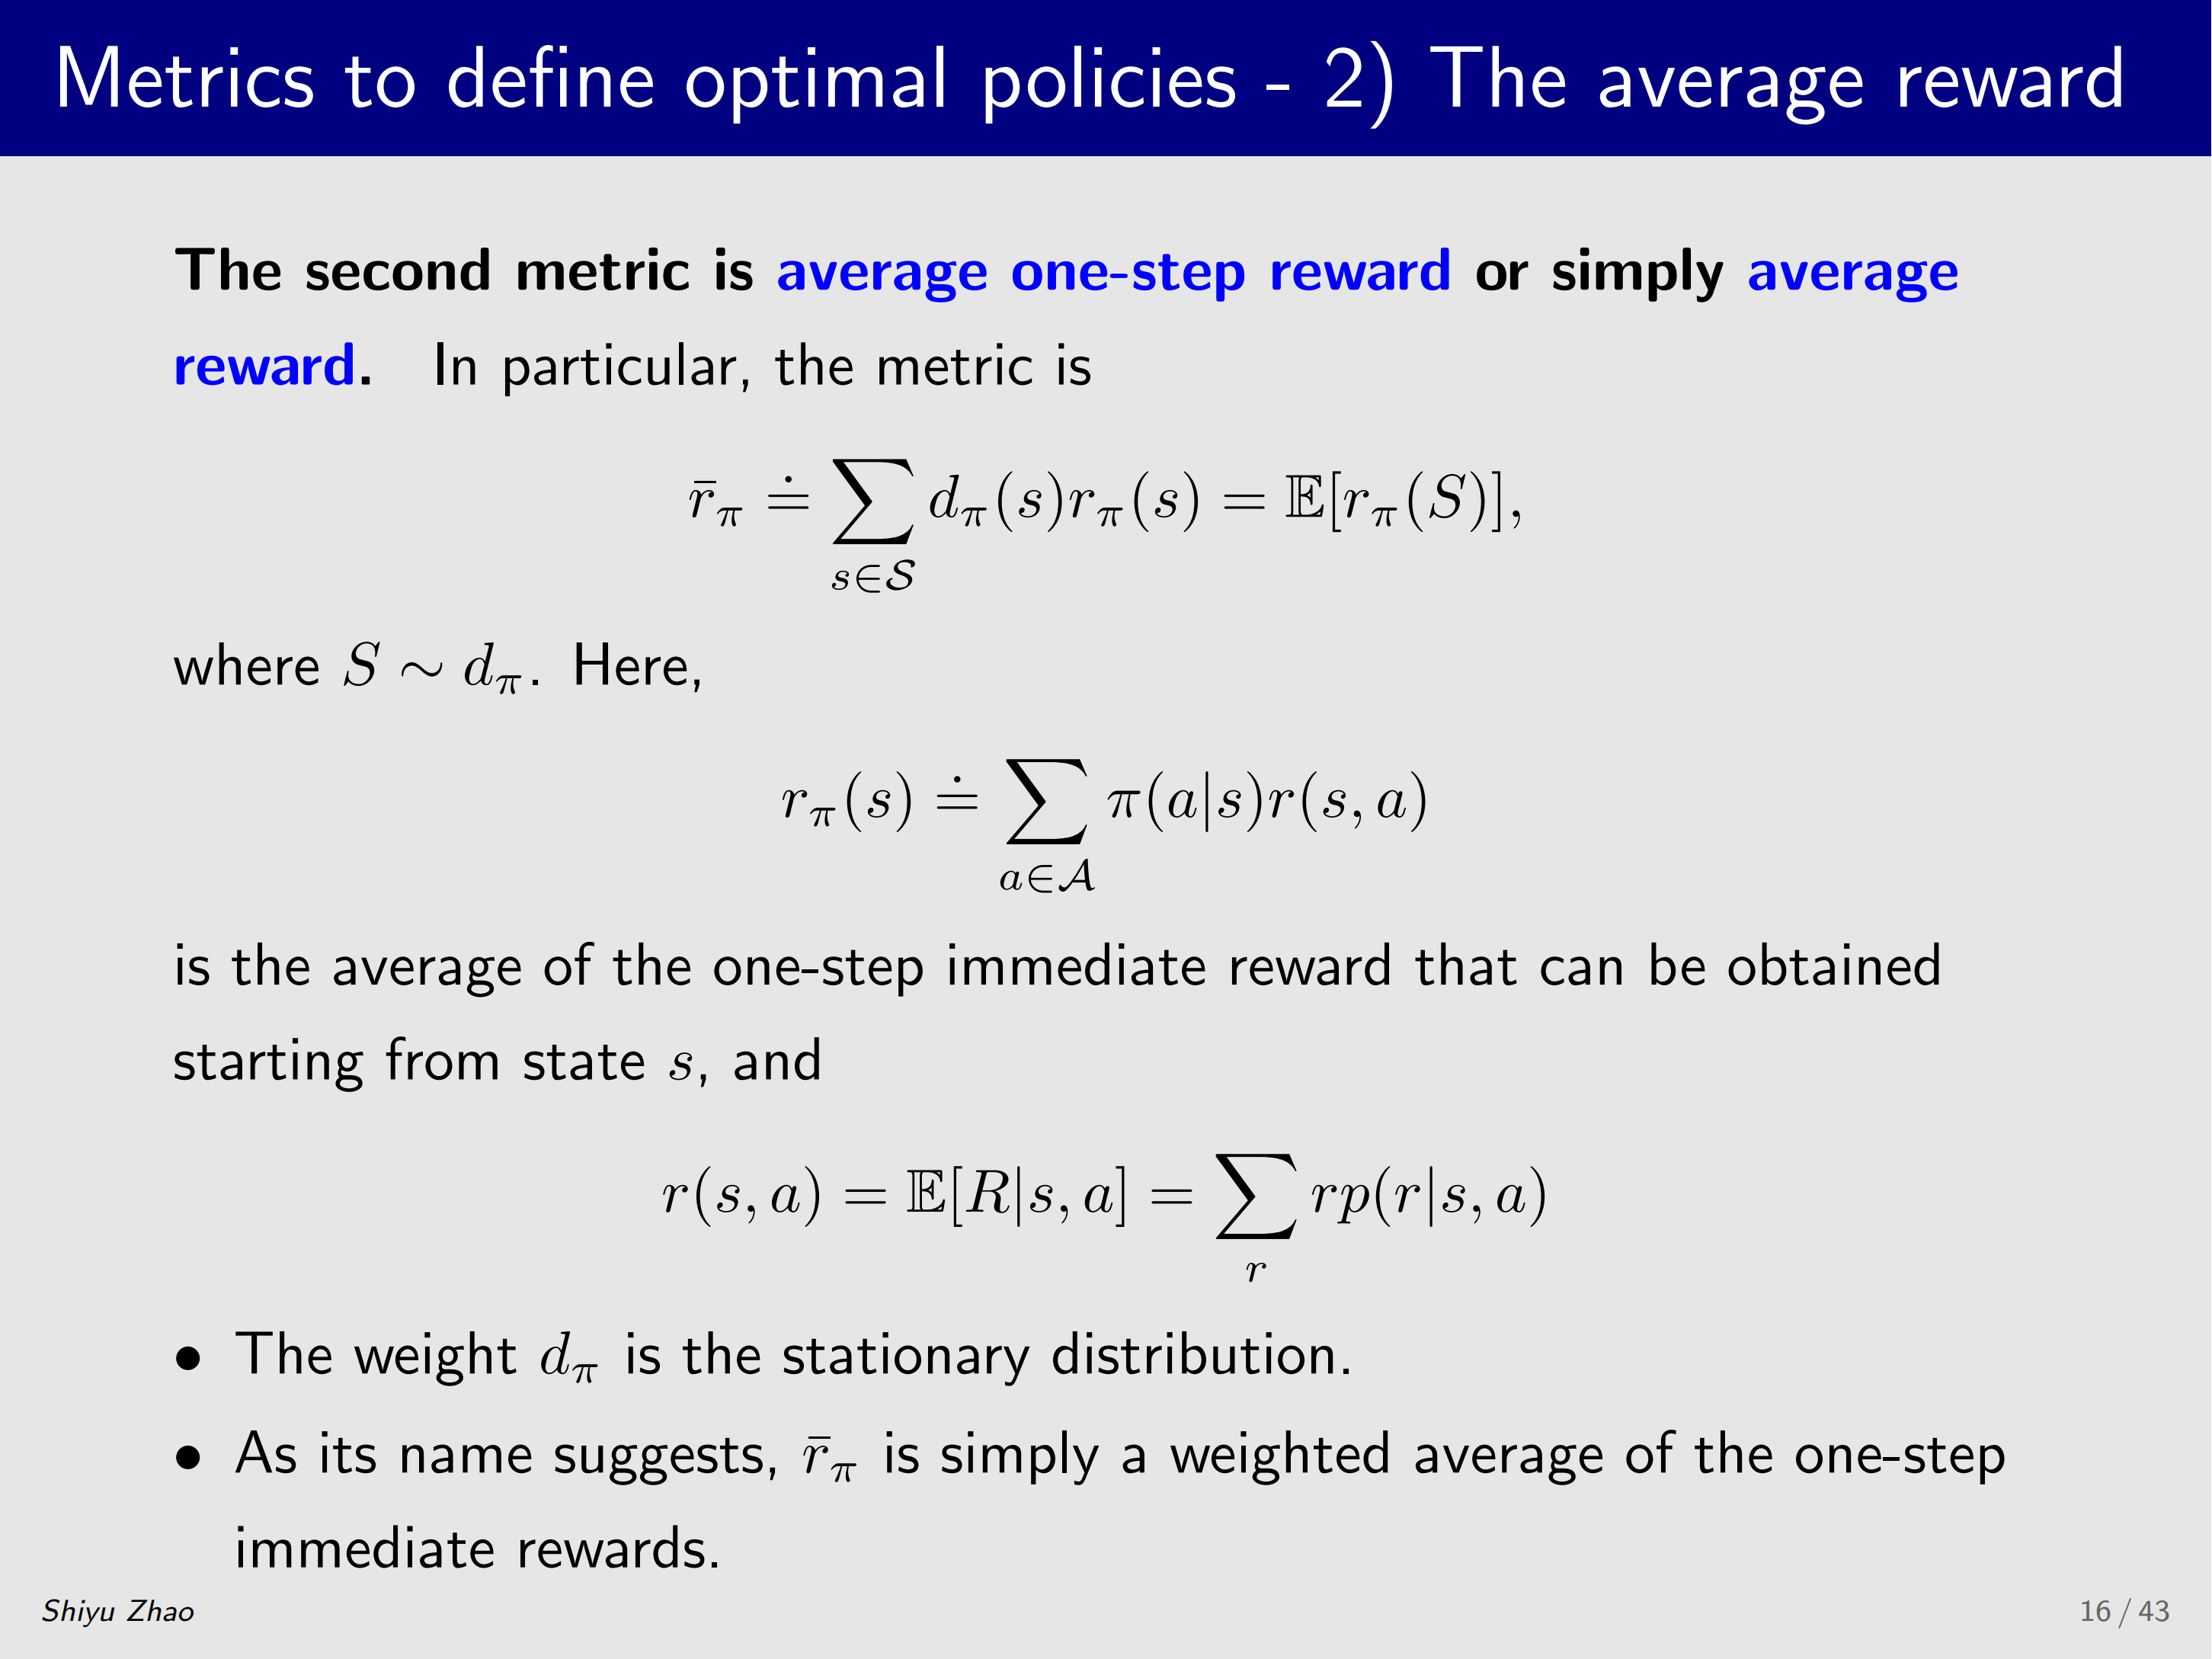
下面说第二个 metric。刚才是 average value,现在是 average reward(也叫 average one-step reward),具体是什么呢?
r
ˉ
π
≐
∑
s
∈
S
d
π
(
s
)
r
π
(
s
)
=
E
[
r
π
(
S
)
]
,
\\bar{r}_\\pi \\doteq \\sum_{s \\in \\mathcal{S}} d_\\pi(s) r_\\pi(s) = \\mathbb{E}[r_\\pi(S)],
rˉπ≐s∈S∑dπ(s)rπ(s)=E[rπ(S)],
就是上面这样一个表达式,下面来看一下,这边刚才是
v
π
(
s
)
v_{\\pi}(s)
vπ(s) 现在变成了
r
π
(
s
)
r_\\pi(s)
rπ(s) ,
r
π
(
s
)
r_\\pi(s)
rπ(s) 是从
s
s
s 出发所得单步 immediate reward 的平均值,具体表达式待会给出。
d
π
(
s
)
d_\\pi(s)
dπ(s) 是
s
s
s 所对应的权重,从下标大家可以看出,它实际上是 stationary distribution,它依赖于策略
π
\\pi
π 。
对
r
π
(
s
)
r_\\pi(s)
rπ(s) 加权平均,得到的 metric 就是第二个 metric
r
ˉ
π
\\bar{r}_\\pi
rˉπ ,上面的横线也代表平均,由于
d
π
(
s
)
d_\\pi(s)
dπ(s) 是概率分布,所以可以把和式写成 expectation 的形式。
那么我们刚才说的这个
r
π
(
s
)
r_\\pi(s)
rπ(s) 具体它表达式是什么呢?表达式如下:
r
π
(
s
)
≐
∑
a
∈
A
π
(
a
∣
s
)
r
(
s
,
a
)
r_\\pi(s) \\doteq \\sum_{a \\in \\mathcal{A}} \\pi(a \\mid s) r(s, a)
rπ(s)≐a∈A∑π(a∣s)r(s,a)
即:在
s
s
s 能得到的 immediate reward 的平均值是什么?在
s
s
s 有多个 action 可选,选择 action
a
a
a 的概率是
π
(
a
∣
s
)
\\pi(a|s)
π(a∣s) ,选择 action
a
a
a 之后得到的 reward 是
r
(
s
,
a
)
r(s,a)
r(s,a) ,把它们加权求和就得到
r
π
(
s
)
r_\\pi(s)
rπ(s) 。
r
(
s
,
a
)
r(s,a)
r(s,a) 又代表什么呢?它代表在
s
s
s 执行 action
a
a
a 后所得 immediate reward 的期望(平均),这个又可以写成下面这样一种期望形式:
r
(
s
,
a
)
=
E
[
R
∣
s
,
a
]
=
∑
r
r
p
(
r
∣
s
,
a
)
r(s,a) = \\mathbb{E}[R \\mid s,a] = \\sum_{r} r p(r \\mid s,a)
r(s,a)=E[R∣s,a]=r∑rp(r∣s,a)
即在
s
s
s 执行
a
a
a 后所得 reward 的平均,它也可以写成这样一种求和形式。
总之:
r
(
s
,
a
)
r(s,a)
r(s,a) 是
(
s
,
a
)
(s,a)
(s,a) 处的 immediate reward(期望),然后对
a
a
a 求加权平均(即求期望)得到
r
π
(
s
)
r_\\pi(s)
rπ(s) ,这个是在
s
s
s 处 immediate reward 的平均,再对
s
s
s 求期望(加权平均)就得到
r
ˉ
π
\\bar{r}_\\pi
rˉπ ,也就是第二个 metric,然后这里边
d
π
d_\\pi
dπ 是 stationary distribution。
这就是第二个 metric。下面给出它的另一种形式,大家在阅读论文和书籍时经常遇到,下面来看一下是什么。
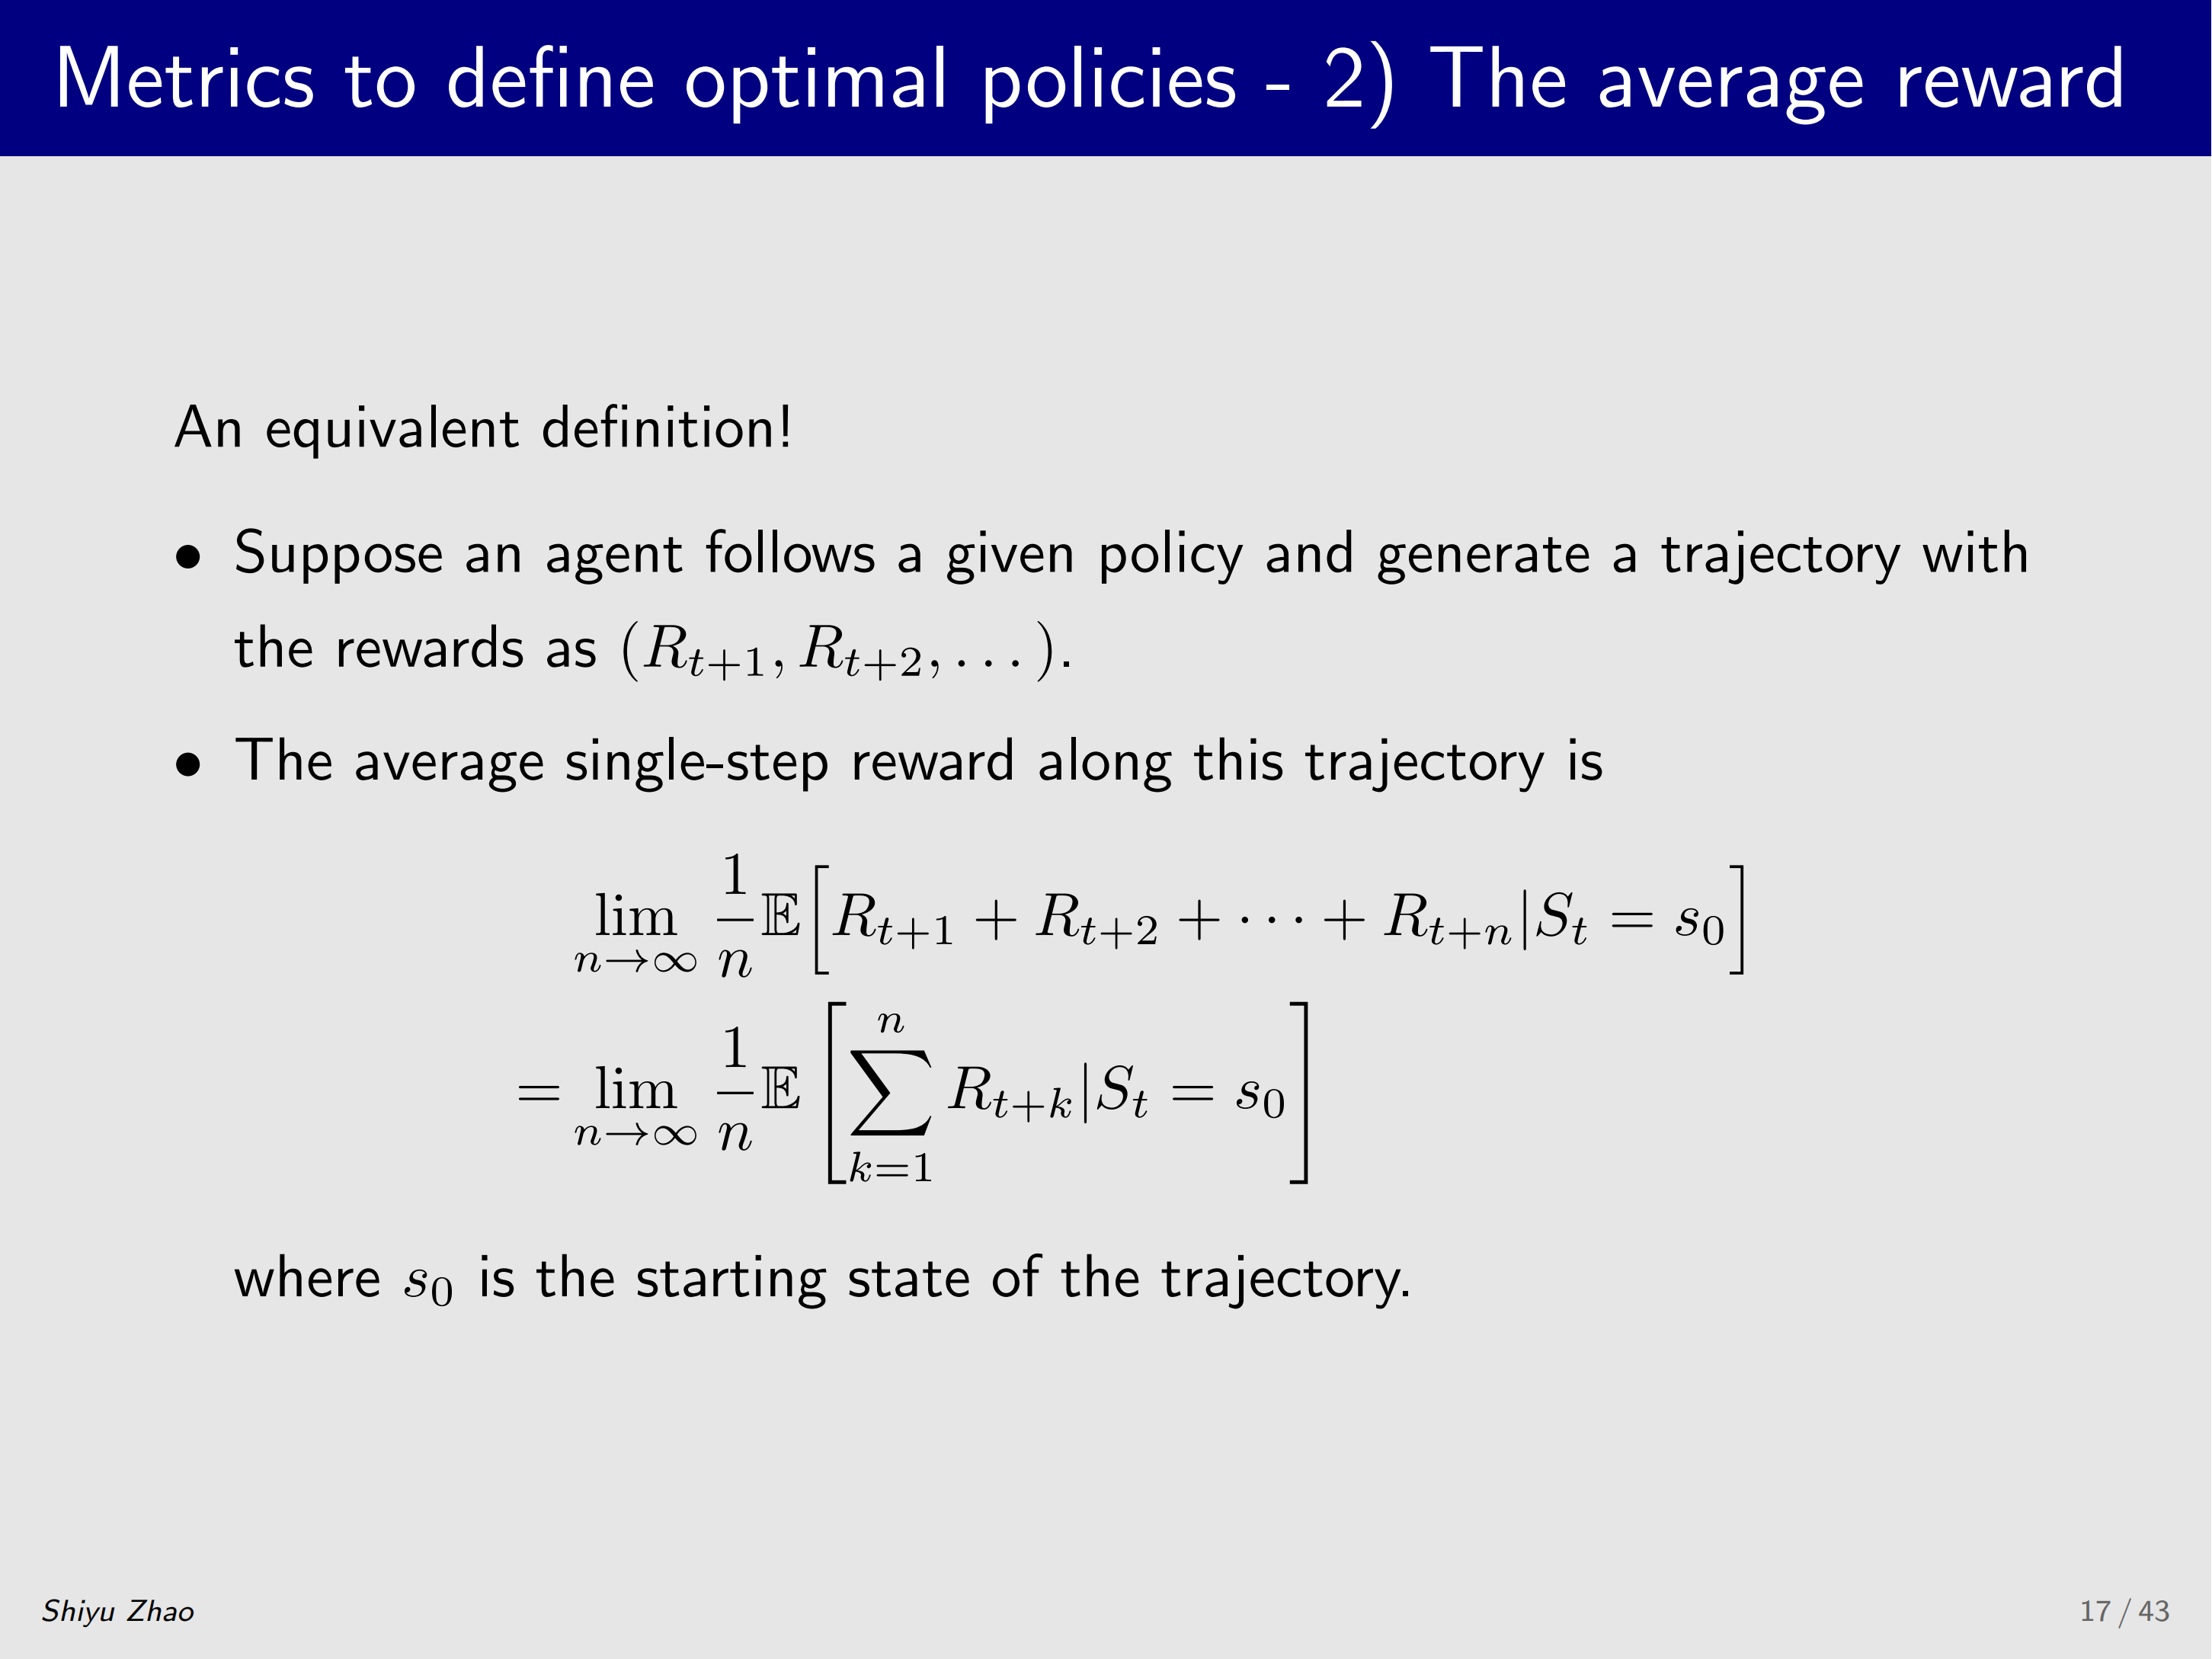
假设有一个策略,根据它形成了一个 trajectory,沿着这个 trajectory 得到了很多 reward,例如
(
R
t
+
1
,
R
t
+
2
,
…
)
(R_{t+1},R_{t+2},\\ldots)
(Rt+1,Rt+2,…) ,下面怎么做呢?把这些 reward 全部加起来:
lim
n
→
∞
1
n
E
[
R
t
+
1
+
R
t
+
2
+
⋯
+
R
t
+
n
∣
S
t
=
s
0
]
=
lim
n
→
∞
1
n
E
[
∑
k
=
1
n
R
t
+
k
∣
S
t
=
s
0
]
\\begin{align*} &\\lim_{n \\to \\infty} \\frac{1}{n} \\mathbb{E} \\left[ R_{t+1} + R_{t+2} + \\dots + R_{t+n} \\mid S_t = s_0 \\right] \\\\ = &\\lim_{n \\to \\infty} \\frac{1}{n} \\mathbb{E} \\left[ \\sum_{k=1}^{n} R_{t+k} \\mid S_t = s_0 \\right] \\end{align*}
=n→∞limn1E[Rt+1+Rt+2+⋯+Rt+n∣St=s0]n→∞limn1E[k=1∑nRt+k∣St=s0]
假设从状态
s
0
s_0
s0 出发,把 reward 加起来后求期望(这些都是随机变量),再除以
n
n
n 求平均,最后取
n
→
∞
n\\to\\infty
n→∞ 的极限。这个式子可以简化,我们把里面写成
∑
\\sum
∑ 的形式(如上所示),它代表什么呢?其实代表 从某个状态出发跑无穷多步,但这时不是求所有 reward 的和,而是求每步 reward 的平均。
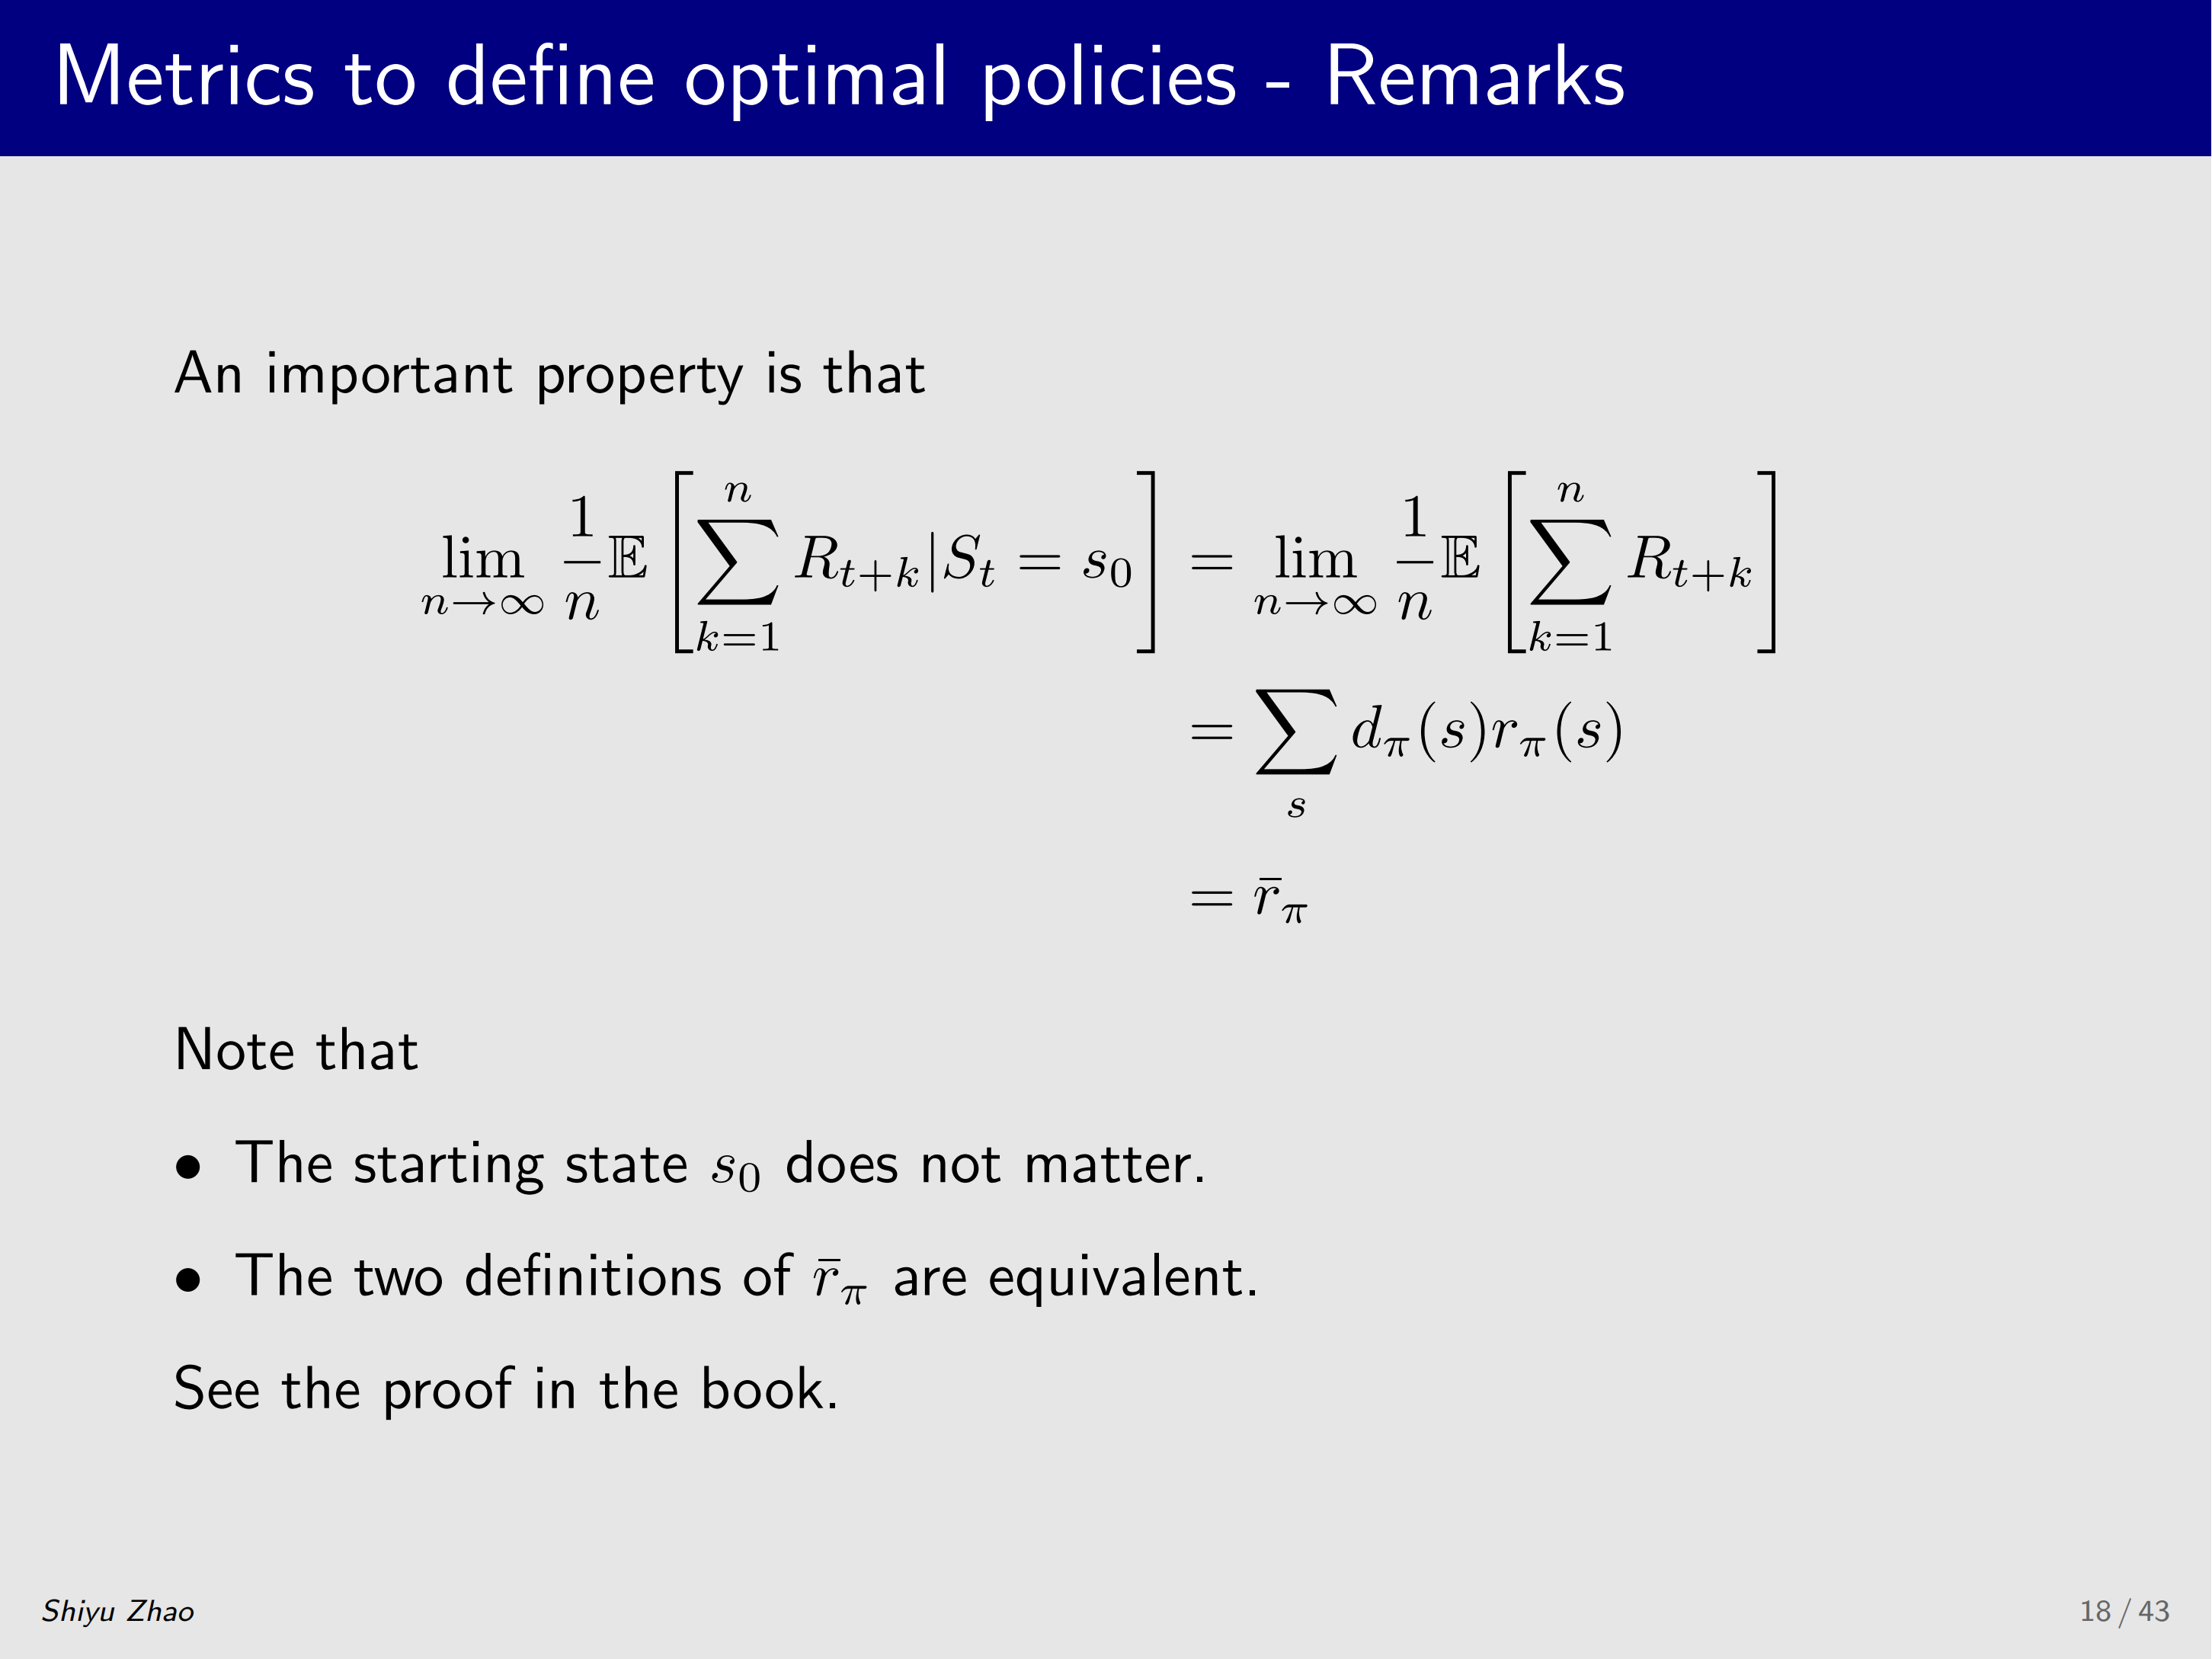
它又可以写成下面这种形式:
lim
n
→
∞
1
n
E
[
∑
k
=
1
n
R
t
+
k
∣
S
t
=
s
0
]
=
lim
n
→
∞
1
n
E
[
∑
k
=
1
n
R
t
+
k
]
=
∑
s
d
π
(
s
)
r
π
(
s
)
=
r
ˉ
π
\\begin{align*} \\lim_{n \\to \\infty} \\frac{1}{n} \\mathbb{E}\\left[\\sum_{k=1}^{n} R_{t+k} \\mid S_t = s_0\\right] &= \\lim_{n \\to \\infty} \\frac{1}{n} \\mathbb{E}\\left[\\sum_{k=1}^{n} R_{t+k}\\right] \\\\ &= \\sum_{s} d_\\pi(s) r_\\pi(s) \\\\ &= \\bar{r}_\\pi \\end{align*}
n→∞limn1E[k=1∑nRt+k∣St=s0]=n→∞limn1E[k=1∑nRt+k]=s∑dπ(s)rπ(s)=rˉπ
注意,刚才的式子里不是有从
s
0
s_0
s0 出发吗?这里
s
0
s_0
s0 不见了,为什么呢?因为
s
0
s_0
s0 不起作用,跑了无穷多步之后,最初从哪出发已经不重要了。于是得到
lim
n
→
∞
1
n
E
[
∑
k
=
1
n
R
t
+
k
]
\\lim_{n \\to \\infty} \\frac{1}{n} \\mathbb{E}\\left[\\sum_{k=1}^{n} R_{t+k}\\right]
limn→∞n1E[∑k=1nRt+k] 这个式子,这个式子是论文中常见的形式,看到它时,希望大家记得—课程里已经非常清晰地讲过。
这个式子是什么呢?它就是
r
ˉ
π
\\bar{r}_\\pi
rˉπ ,也就是它能写成对
d
π
(
s
)
r
π
(
s
)
d_\\pi(s)r_\\pi(s)
dπ(s)rπ(s) 的加权平均,为什么呢?具体细节这里就不再展开了,大家可以参考教材,涉及一些数学,但其实没那么复杂,总而言之,未来大家看到这个 metric 时,不要忘了课程中已经讲过。
2. Metrics to define optimal policies – Remarks
刚刚介绍了两个 metric,下面做进一步补充,之后有一个小例子。第一点补充是什么?
这些 metric 全都是策略的函数,无论是
v
ˉ
π
\\bar{v}_\\pi
vˉπ 还是
r
ˉ
π
\\bar{r}_\\pi
rˉπ ,而策略是参数为
θ
\\theta
θ 的函数,所以
v
ˉ
π
\\bar{v}_\\pi
vˉπ、
r
ˉ
π
\\bar{r}_\\pi
rˉπ 都是
θ
\\theta
θ 的函数,那么自然不同的
θ
\\theta
θ 就会得到不同的 metric 值,其中存在最优的。我们希望通过优化找到最优
θ
\\theta
θ 来最大化这些 metric—这就是 policy gradient 的基本思路。这是第一点。
第二个我们要说的是什么呢?
刚才的 metric 若仔细分析,还是有些麻烦的。麻烦在哪?它分两种情况:第一种是 discounted case,其中 discount rate
γ
\\gamma
γ 是小于 1 的数,另一个是 undiscounted case,其中
γ
\\gamma
γ 等于 1。
到目前为止(以及整本书中)我们只介绍了 discounted case(
γ
<
1
\\gamma < 1
γ<1),为什么会有 undiscounted case(
γ
=
1
\\gamma = 1
γ=1)呢?因为
r
ˉ
π
\\bar{r}_\\pi
rˉπ 是对 immediate reward 求平均,不是对 return 求平均,不求 return 就不需要考虑 discount rate,所以它对两种 case 都成立。
所以仔细分析,还存在 undiscounted case,当然它比较复杂,课程中就不再介绍了,感兴趣的话大家可以参考教材。
第三个我们要说明的是什么呢?
r
ˉ
π
\\bar{r}_\\pi
rˉπ 和
v
ˉ
π
\\bar{v}_\\pi
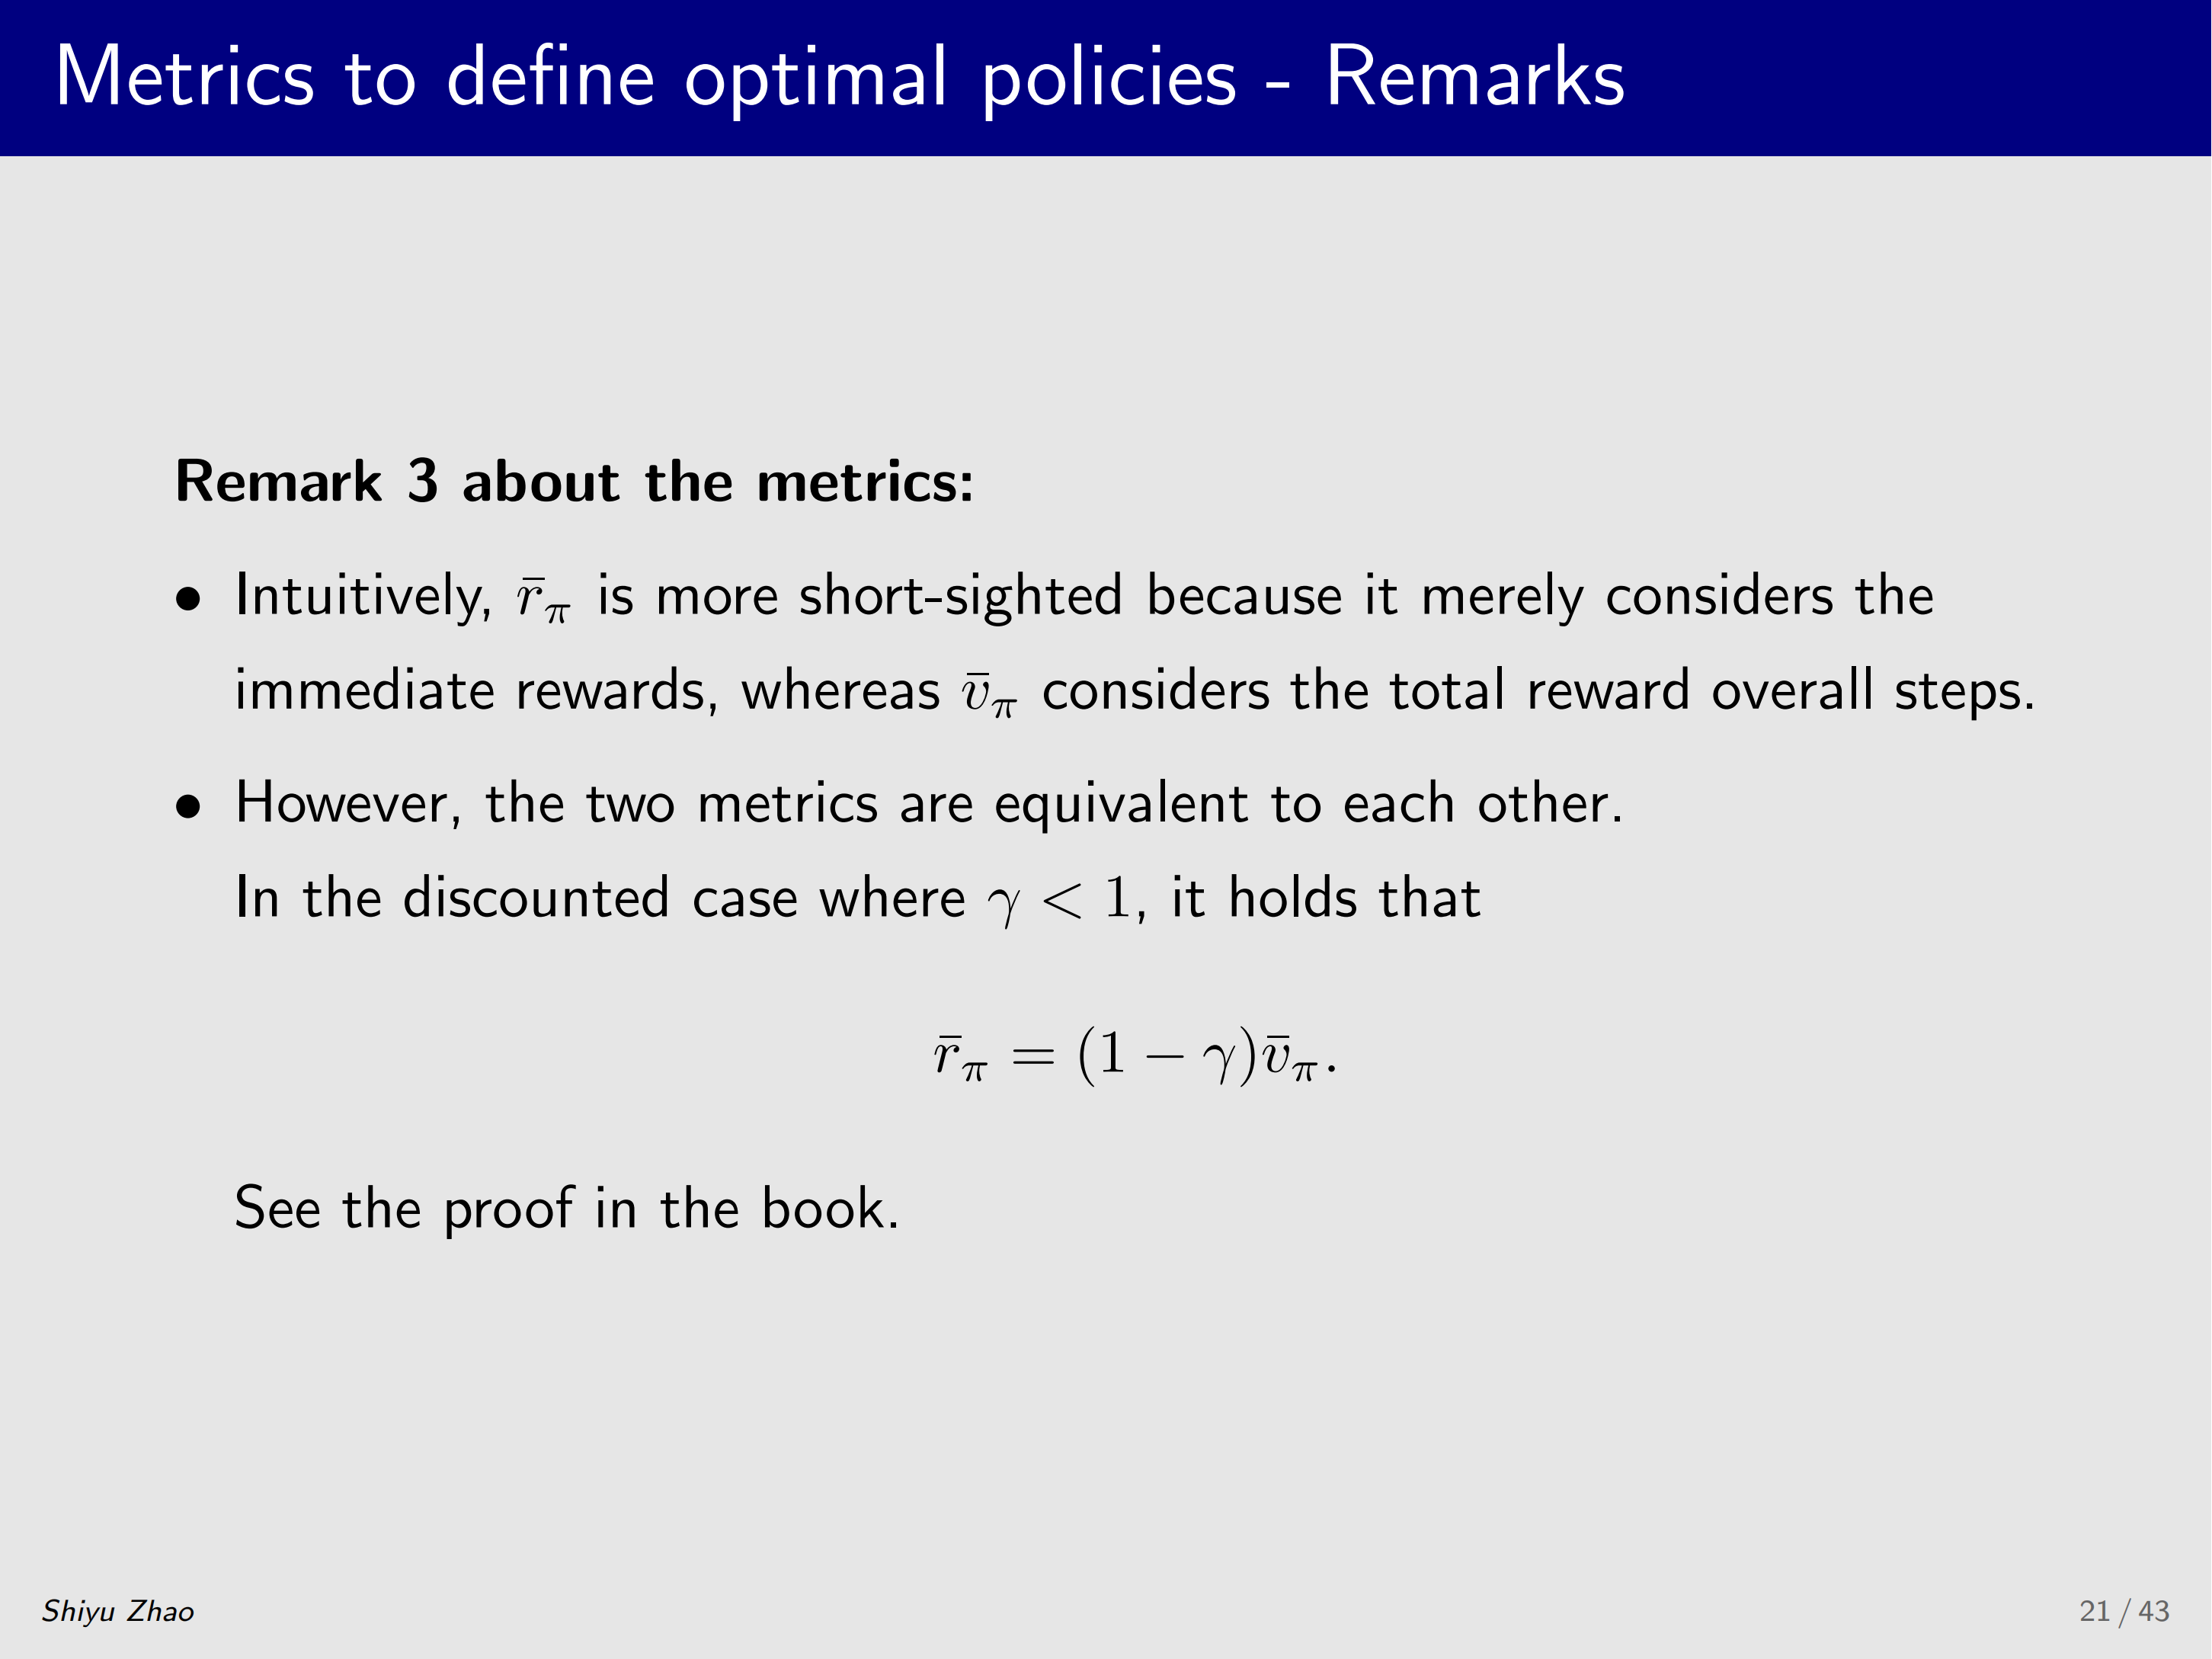
vˉπ 这两个 metric 是什么关系?先谈直观感受:
r
ˉ
π
\\bar{r}_\\pi
rˉπ 似乎比
v
ˉ
π
\\bar{v}_\\pi
vˉπ 更 “近视”(short-sighted)。为什么?
因为它似乎只关心 immediate reward,而
v
ˉ
π
\\bar{v}_\\pi
vˉπ 关心 return,是这样吗?实际上 这两个 metric 等价,具体来说就是在 discounted case 我们可以证明:
r
ˉ
π
=
(
1
−
γ
)
v
ˉ
π
.
\\bar{r}_\\pi = (1 – \\gamma) \\bar{v}_\\pi.
rˉπ=(1−γ)vˉπ.
注意, 等价不是说两者相等,而是满足这个等式,对其中一个做优化,另一个也随之达到极值,关于这个式子怎么得到,大家可以参考教材。
3. Metrics to define optimal policies – Exercise
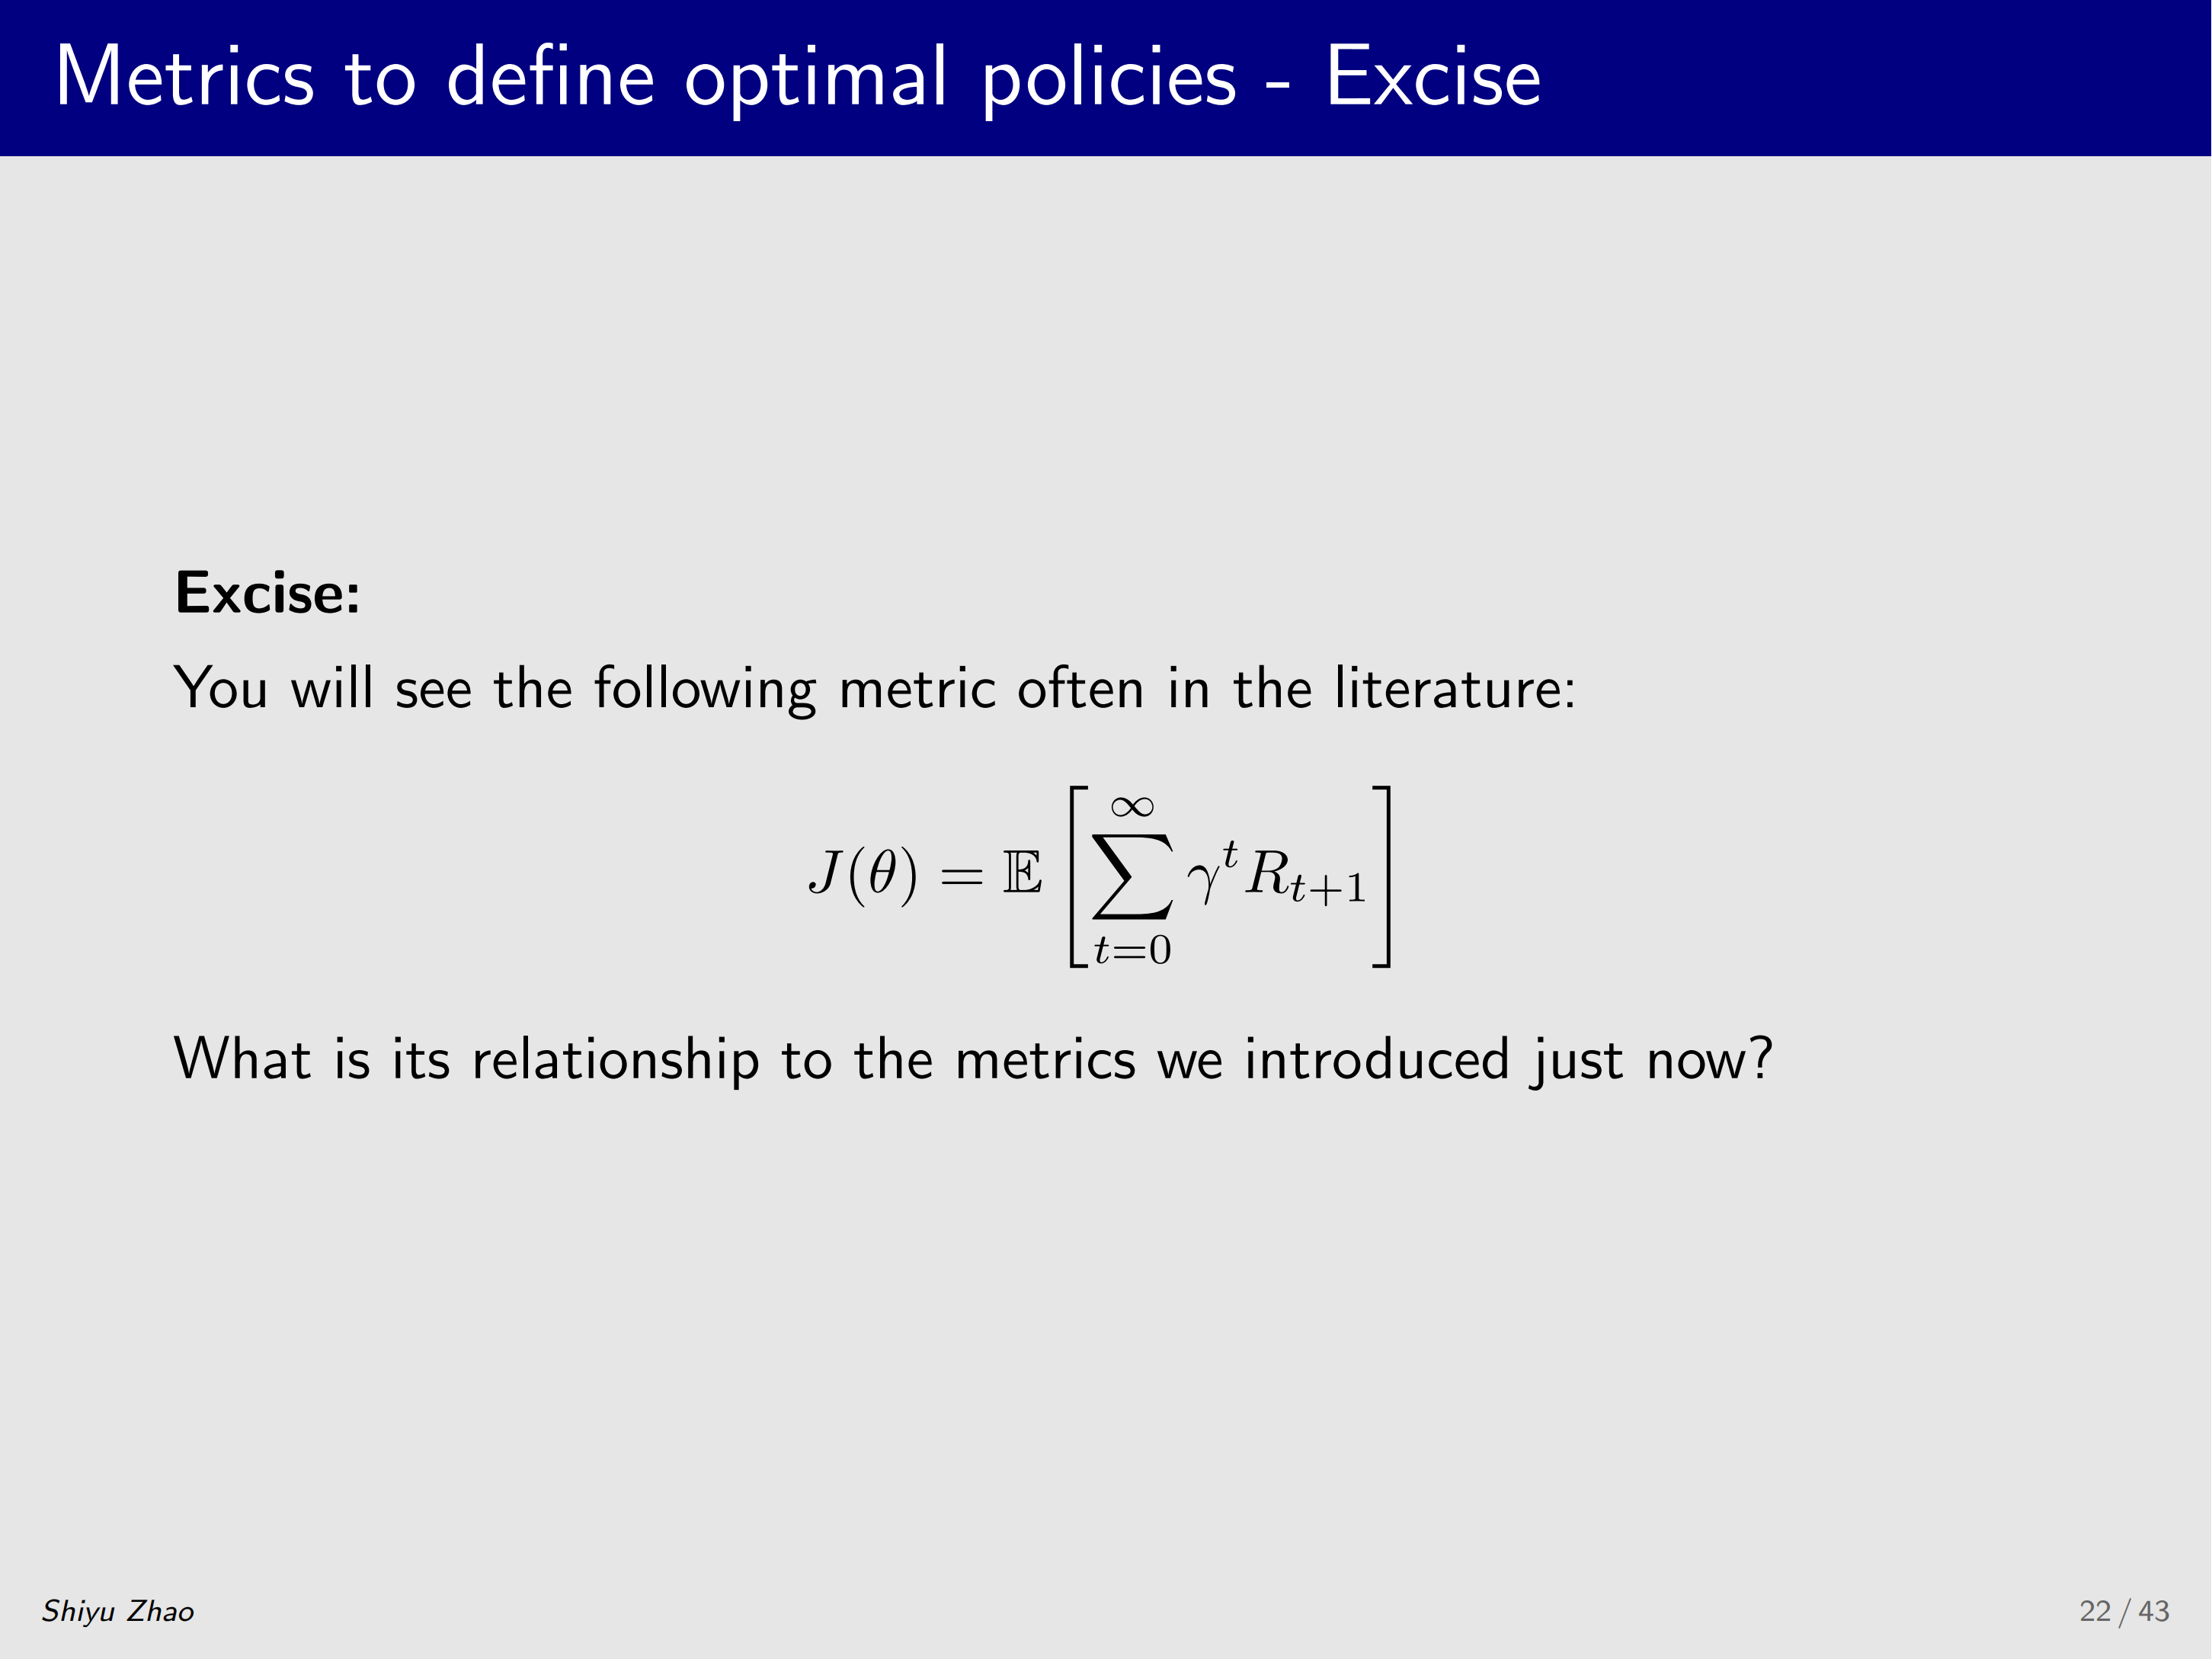
下面有一个小练习题,感兴趣的可以自己练练,这个题是什么呢?
J
(
θ
)
=
E
[
∑
t
=
0
∞
γ
t
R
t
+
1
]
J(\\theta) = \\mathbb{E}\\left[\\sum_{t=0}^{\\infty} \\gamma^t R_{t+1}\\right]
J(θ)=E[t=0∑∞γtRt+1]
读论文和参考资料时,会经常见到一个 metric—在 policy gradient 问题中,你会经常见到上面这个
J
(
θ
)
J(\\theta)
J(θ) ,它与刚才介绍的 metric 有什么联系?大家可以自己先想一想,这里直接告诉大家:
刚才说过
r
ˉ
π
\\bar{r}_\\pi
rˉπ 有两个定义,还记得吗?一个是
∑
s
d
π
(
s
)
r
π
(
s
)
\\sum_{s} d_\\pi(s) r_\\pi(s)
∑sdπ(s)rπ(s) ,另一个是
lim
n
→
∞
1
n
E
[
∑
k
=
1
n
R
t
+
k
]
\\lim_{n \\to \\infty} \\frac{1}{n} \\mathbb{E}\\left[\\sum_{k=1}^{n} R_{t+k}\\right]
limn→∞n1E[∑k=1nRt+k] ,实际上
v
ˉ
π
\\bar{v}_\\pi
vˉπ 也有两个定义,一个是
∑
s
d
(
s
)
v
π
(
s
)
\\sum_s d(s)v_\\pi(s)
∑sd(s)vπ(s) ,另一个就是上面的
E
[
∑
t
=
0
∞
γ
t
R
t
+
1
]
\\mathbb{E}\\left[\\sum_{t=0}^{\\infty} \\gamma^t R_{t+1}\\right]
E[∑t=0∞γtRt+1] 。
这四个 metric 形式,大家在阅读 policy gradient 或 actor-critic 论文时一定会遇到其中一个,希望大家见到时都能明白—课程里都讲过。直接说结论:
J
(
θ
)
J(\\theta)
J(θ) 实际上就是
v
ˉ
π
\\bar{v}_\\pi
vˉπ ,为什么呢?我们来看一下,其实非常简单:
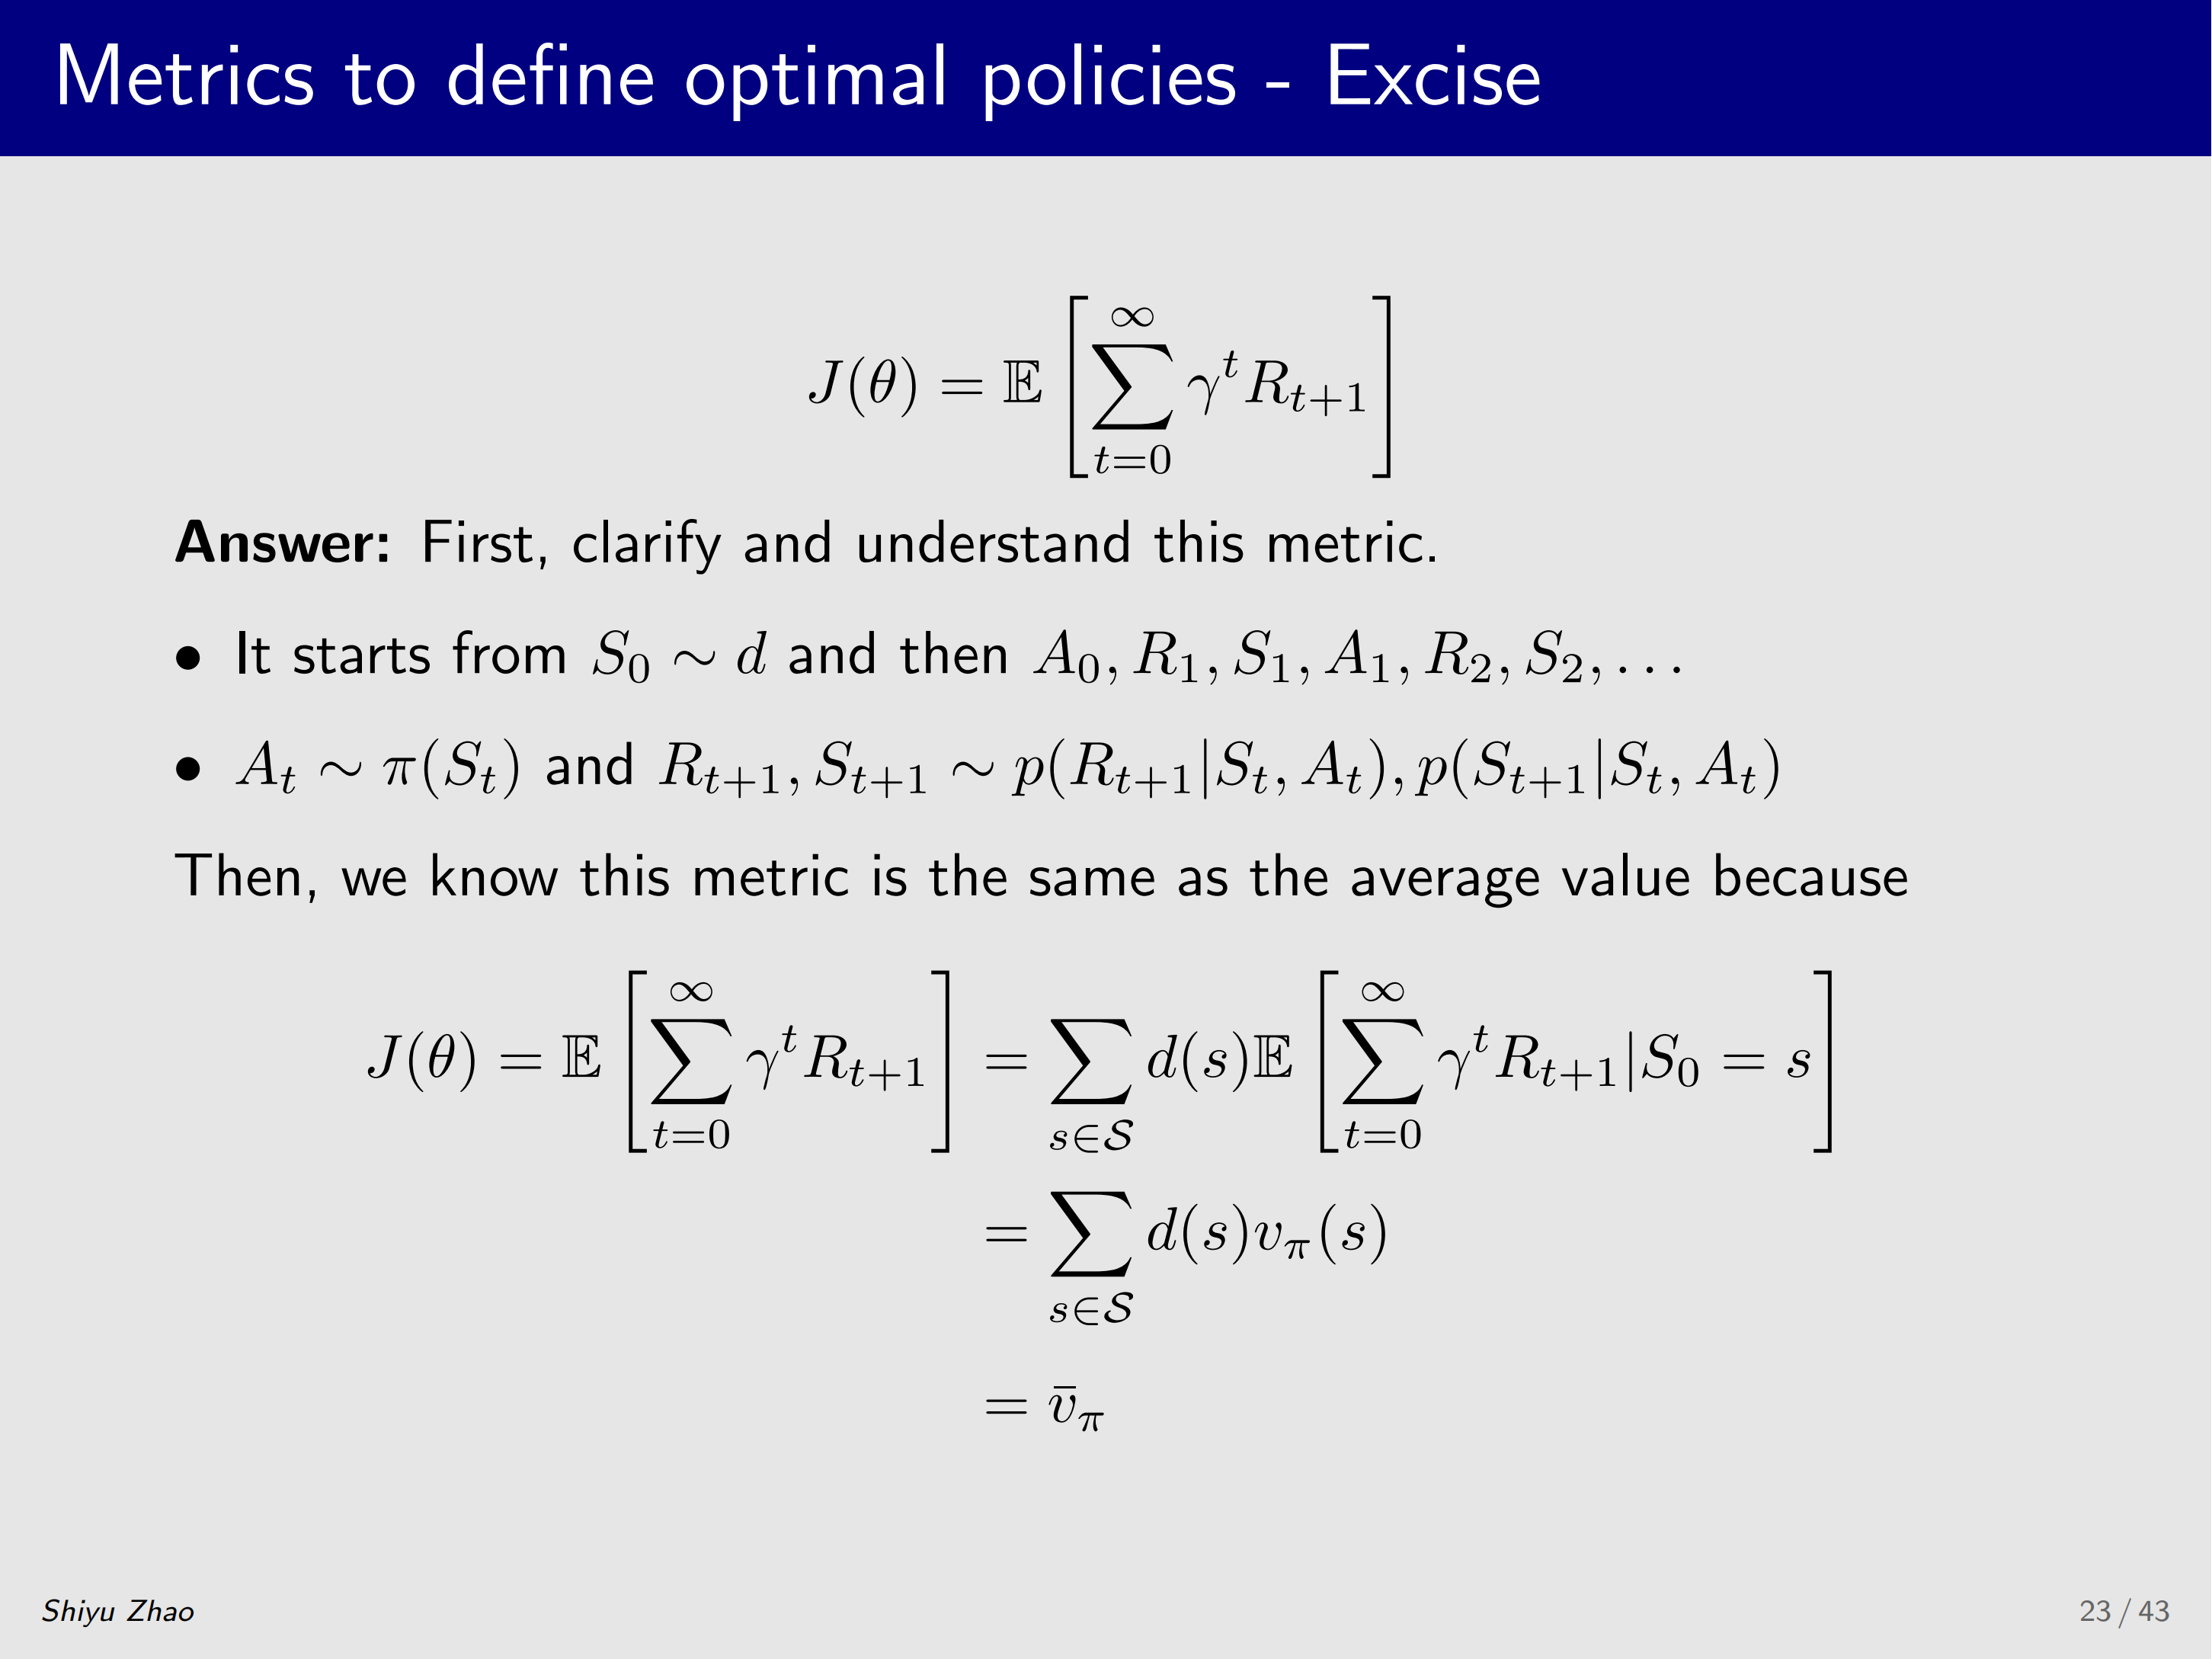
先分析一下:
J
(
θ
)
J(\\theta)
J(θ) 看起来是对一条 trajectory 的 reward 求和,假设 trajectory 从
S
0
S_0
S0 出发,
S
0
∼
d
S_0 \\sim d
S0∼d 。
然后从
S
0
S_0
S0 出发得到 trajectory
A
0
,
R
1
,
S
1
,
A
1
,
R
2
,
S
2
,
…
A_0, R_1, S_1, A_1, R_2, S_2, \\dots
A0,R1,S1,A1,R2,S2,… ,每个
S
S
S 处怎么采取动作呢?根据
π
(
S
)
\\pi(S)
π(S) 采取动作,采取动作之后,得到的
R
t
+
1
R_{t+1}
Rt+1、
S
t
+
1
S_{t+1}
St+1 都是由环境来决定的,知道了这些之后,就可以把
J
(
θ
)
J(\\theta)
J(θ) 进一步拆开:
J
(
θ
)
=
E
[
∑
t
=
0
∞
γ
t
R
t
+
1
]
=
∑
s
∈
S
d
(
s
)
E
[
∑
t
=
0
∞
γ
t
R
t
+
1
∣
S
0
=
s
]
=
∑
s
∈
S
d
(
s
)
v
π
(
s
)
=
v
ˉ
π
\\begin{align*} J(\\theta) = \\mathbb{E}\\left[\\sum_{t=0}^{\\infty} \\gamma^t R_{t+1}\\right] &= \\sum_{s \\in \\mathcal{S}} d(s)\\mathbb{E}\\left[\\sum_{t=0}^{\\infty} \\gamma^t R_{t+1} \\mid S_0 = s\\right] \\\\ &= \\sum_{s \\in \\mathcal{S}} d(s)v_\\pi(s) \\\\ &= \\bar{v}_\\pi \\end{align*}
J(θ)=E[t=0∑∞γtRt+1]=s∈S∑d(s)E[t=0∑∞γtRt+1∣S0=s]=s∈S∑d(s)vπ(s)=vˉπ
首先根据 全期望公式:trajectory 可以从不同的
s
s
s 出发,从
s
s
s 出发的概率是
d
(
s
)
d(s)
d(s) ,从
s
s
s 出发得到的值是上述条件期望,把它们相加就得到原式。然后条件期望这一项是什么?大家看得出来吗?
∑
t
=
0
∞
γ
t
R
t
+
1
\\sum_{t=0}^{\\infty} \\gamma^t R_{t+1}
∑t=0∞γtRt+1 这一项是从
s
s
s 出发得到的所有(折扣)reward,一个 discounted return,即
G
t
G_t
Gt 。所以它是什么?就是
v
π
(
s
)
v_\\pi(s)
vπ(s) ,于是原式等于
∑
s
d
(
s
)
v
π
(
s
)
\\sum_s d(s)v_\\pi(s)
∑sd(s)vπ(s) ,这就是
v
ˉ
π
\\bar{v}_\\pi
vˉπ—就这么简单。
结语
本讲第三部分介绍了第二类目标函数—average reward:
r
ˉ
π
=
∑
s
d
π
(
s
)
r
π
(
s
)
\\bar{r}_\\pi = \\sum_s d_\\pi(s)r_\\pi(s)
rˉπ=∑sdπ(s)rπ(s) ,即单步即时奖励的加权平均(权重为 stationary distribution)。它在论文中常以另一种面貌出现:
lim
n
→
∞
1
n
E
[
∑
k
=
1
n
R
t
+
k
]
\\lim_{n\\to\\infty}\\frac{1}{n}\\mathbb{E}[\\sum_{k=1}^n R_{t+k}]
limn→∞n1E[∑k=1nRt+k]—无穷长轨迹上每步平均获得的奖励,且极限与起始状态无关。
两种 metric 并非并列而是等价的:在 discounted case 下满足
r
ˉ
π
=
(
1
−
γ
)
v
ˉ
π
\\bar{r}_\\pi = (1-\\gamma)\\bar{v}_\\pi
rˉπ=(1−γ)vˉπ ,优化其中一个另一个也随之达到极值。因此论文中常见的四种 metric 形式(
v
ˉ
π
\\bar{v}_\\pi
vˉπ 的求和与期望形式、
r
ˉ
π
\\bar{r}_\\pi
rˉπ 的求和与极限平均形式)本质上是同一枚硬币的不同侧面—例如
J
(
θ
)
=
E
[
∑
t
=
0
∞
γ
t
R
t
+
1
]
J(\\theta) = \\mathbb{E}[\\sum_{t=0}^\\infty \\gamma^t R_{t+1}]
J(θ)=E[∑t=0∞γtRt+1] 看似是从轨迹奖励和出发的 “新” 定义,实则就是
v
ˉ
π
\\bar{v}_\\pi
vˉπ 的期望形式。掌握了这一等价性,阅读 policy gradient 与 actor-critic 文献时将不再被纷繁的符号所迷惑🤗。
参考
- https://www.bilibili.com/video/BV1sd4y167NS
- https://github.com/MathFoundationRL/Book-Mathmatical-Foundation-of-Reinforcement-Learning